动态切换拓扑下车队控制:观测器驱动的分布式模型预测方案
论文摘要
本文围绕 智能网联车辆(CAV)车队控制 中的关键难题:通信拓扑动态切换导致信息丢失和串行不稳定。传统方法多数假设固定或预定义切换规律,无法应对现实中通信拓扑随机变化的情况。此外,车队需要实现两类稳定性:车辆间状态收敛的 均方闭环稳定性 和扰动不放大的 串行稳定性。为此,作者提出一种 基于观测器的分布式模型预测控制(DMPC)框架。核心思想包括:用 连续时间 Markov 链 建模通信拓扑的随机切换;设计 全分布式自适应观测器,在未知拓扑下估计领车状态,确保观测误差均方收敛;在 DMPC 中引入 端点更新法 和 串行稳定性约束,保证车辆之间的预测误差不放大,并证明控制策略的递归可行性和闭环稳定性。仿真与实车数据验证表明,该方法在随机拓扑下显著提高跟踪精度、加速收敛,并降低控制输入波动。本文的研究为面向复杂通信环境的车队协同控制提供了新的理论和技术路径。
一、研究背景与问题阐述
1.1 智能网联车队的意义与挑战
CAV 车队 可以提高交通安全、缓解拥堵并提升能耗效率。 车队通过 V2V 通信拓扑 交换位置信息,常见拓扑有 前车–跟随(PF)、领车–前车–跟随(LPF) 等。 现实环境下,通信拓扑因车辆进出、信号阻断等随机变化,导致信息丢失和延迟,进而影响控制性能。 车队控制必须同时满足 闭环稳定性(跟踪误差收敛)和 串行稳定性(扰动不放大)。
1.2 现有研究的局限性
预定义拓扑切换:许多方法预设切换时刻,但实际网络切换往往随机,预设策略不适用。 缺乏串行稳定性保障:已有针对 Markov 切换拓扑的控制方法关注闭环稳定性,却忽视了串行稳定性。 依赖全球信息:部分观测器需要全局拓扑或领车状态,难以在随机拓扑下部署。
1.3 本文关注的问题
如何在随机切换的通信拓扑下,在没有全局信息的情况下估计领车状态并设计控制器? 如何在分布式框架中 同时保证均方闭环稳定性和串行稳定性? 如何利用 Markov 过程 建模拓扑切换并在模型预测控制中引入相应约束?
二、方法框架与关键技术
2.1 通信拓扑与随机切换建模
下图展示了两种拓扑切换方式:预定义切换与随机 Markov 切换。本文选用 连续时间 Markov 链 描述随机切换,用转移率矩阵定义不同拓扑间的跳变概率。
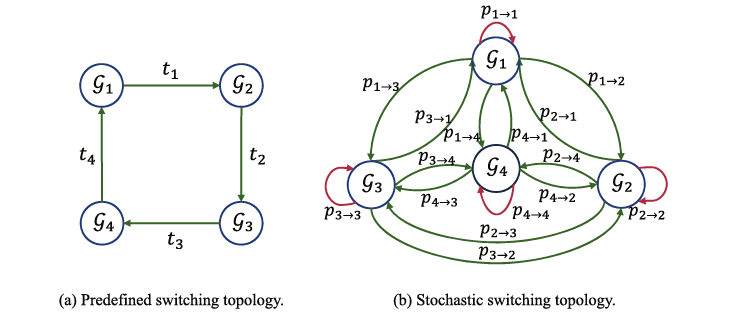
预定义切换:在固定停驻时间后按顺序在拓扑 之间切换,无法反映真实环境。 随机切换:拓扑间的转换由 转移概率 控制,满足概率和为 1,能更好刻画实际通信的不确定性。
2.2 全分布式自适应观测器
为在随机拓扑下估计领车状态,作者设计了 全分布式自适应观测器:
观测器状态 包括估计的位移、速度、加速度及自适应增益。 更新律为: 其中 和 为车辆线性模型矩阵, 为观测误差, 为非负增函数, 是耦合增益。 自适应增益更新:其中 与 为设计矩阵。 理论分析表明,只要存在正定矩阵 (P) 使 Riccati 方程成立,则观测误差和自适应增益均方收敛。
2.3 分布式模型预测控制(DMPC)设计
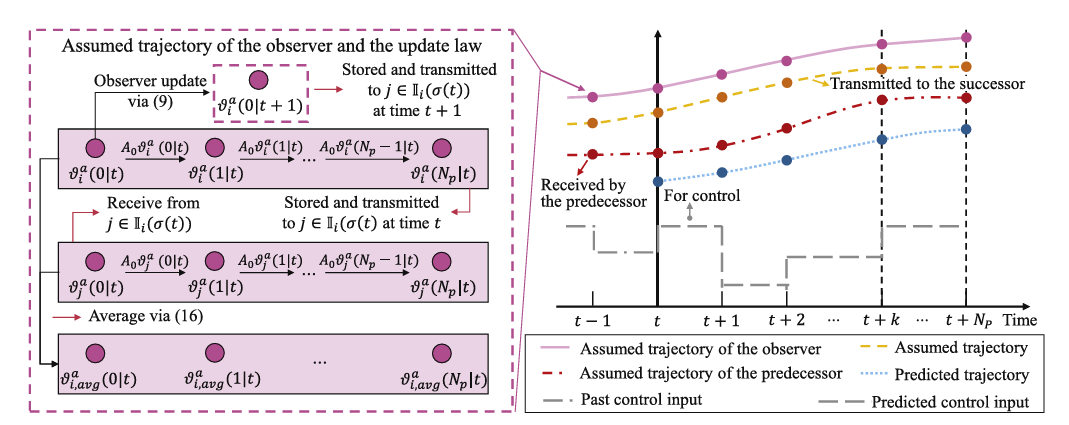
图中左侧为单车观测–预测流程,右侧为时间线关系。
系统模型:采用三阶线性模型描述从车的动力学 ;领车满足 。
预测变量:每辆车在时刻 预测未来 步的状态 和控制输入 ,并利用观测器估计的领车轨迹和前车预测轨迹作为参考。
目标函数:考虑三类误差——相对于观测器假设轨迹、相对于前车假设轨迹、相对于自身假设轨迹——并对控制输入变化加权,构建优化代价。
约束条件:
初始状态约束:预测序列起点为当前实际状态。 动力学约束:满足离散化后的状态方程 。 控制输入约束:加速度在物理范围内。 终端状态约束:采用 端点更新法,保证预测末端与下一时刻假设轨迹衔接。 串行稳定性约束:约束车辆 (i) 的最大预测误差不超过前车的最大误差,即防止跟踪误差沿队列放大。 求解流程:每个采样时刻,各车辆通过 V2V 通信收集邻车信息,求解有限时域优化问题,执行第一步控制,并更新假设轨迹供下一时刻使用。
2.4 理论分析
均方闭环稳定性:通过 Lyapunov 分析证明,只要 Riccati 方程可解且初始优化问题可行,系统的跟踪误差和观测误差都能在均方意义下收敛。 递归可行性:若初始时刻存在可行解,则通过端点更新法确保下一时刻仍有可行解,且满足串行稳定性约束。
三、数学模型与关键公式
3.1 车辆动力学
为刻画车辆运动,采用三阶线性化模型。
第i 辆从车的状态向量为 。
动力学方程为
领车的状态满足 。
该模型将位置、速度和加速度作为状态,实现了高阶动力学的线性化表示。
3.2 自适应观测器更新律
为了在随机拓扑下估计领车状态,设计了以下全分布式自适应观测器:
观测误差:。 观测器更新: 其中 为非负单调函数,用于调节增益。 耦合增益:适当设计矩阵 、 后,可证明观测误差均方收敛。
3.3 串行稳定性约束
为防止跟踪误差沿车队放大,DMPC 中引入如下约束:
其中 为车辆 在时刻 的预测误差, 表示前车最大预测误差。该约束确保若前车的估计误差有界,则后车的误差不会超过前车。
四、仿真与实证分析
4.1 仿真设置
仿真场景:使用 5 辆车队,在随机 Markov 切换拓扑下设置不同加速度工况及随机丢包率。 对比方法:选取 基于 DMPC 的方法 (Bian 等,2020) 和 自适应控制方法 (Ding 等,2024) 作为基准。 评价指标:最大位置误差(MPE)、最大速度误差(MVE)、平均位置误差(APE)、最大串行稳定性比(MSSR)及收敛时间。
4.2 跟踪性能与串行稳定性
下图给出了所提方法的跟踪轨迹。车辆 0 为领车,车辆 1–5 为从车。
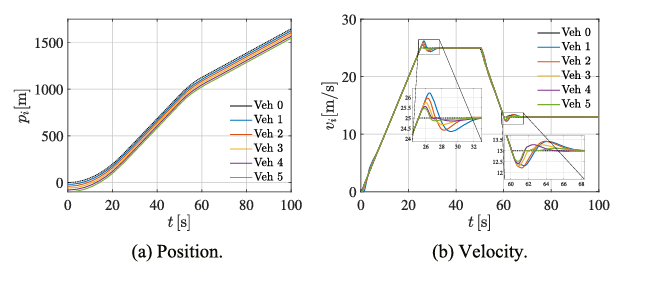
位置跟踪:所有从车的轨迹均紧跟领车曲线,体现了控制器在随机拓扑下的稳定性。 速度同步:速度曲线在加速与减速阶段无明显滞后,说明观测器能及时获取领车速度信息并调整控制输入。 串行稳定性:跟踪误差峰值不会沿车队放大,满足串行稳定性约束。
4.3 与基准方法比较
表 3 显示,所提方法在 MPE、MVE 和 APE 等指标上均取得最小值(分别为 1.83 m、1.21 m/s 和 0.13 m),明显优于基准方法。 收敛时间:该方法的收敛时间为 6.60 s,显著短于基准方法。 控制输入波动:本文方法的控制输入曲线更平滑,而基准方法在拓扑切换时出现较大振荡。 串行稳定性:本文方法的 MSSR 值为 0.98,小于基准方法的 1.45 和 1.56,显示更强的串行稳定性。
五、结论与展望
提出了针对随机通信拓扑的 基于观测器的 DMPC 框架,结合 Markov 切换模型、自适应观测器与串行稳定性约束,证明了系统的均方稳定性和递归可行性。 仿真与实车数据验证表明,所提方法在跟踪精度、收敛速度和控制输入平滑度方面均优于现有方法,特别在串行稳定性方面具有明显优势。 未来工作将进一步考虑通信延迟和故障,扩展到混合动力车队及人车混合的复杂场景。
文章须知
链上镖师团队:常文婕(AEIC)、张巧巧(AEIC)、王一航、夏子帆、张晓乐
原文链接:https://doi.org/10.1016/j.trc.2026.105641
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



