论文题目:Chain-of-Context Learning: Dynamic Constraint Understanding for Multi-Task VRPs
第一作者:Shuangchun Gui, Research Engineer, School of Computing and Information Systems, Singapore Management University. 研究聚集:人工智能与数据科学、决策与优化。E-mail:scgui@smu.edu.sg
通讯作者:Zhiguang Cao, Assistant Professor, School of Computing and Information Systems, Singapore Management University.担任《IEEE Transactions on Industrial Informatics》、《IET Collaborative Intelligent Manufacturing》副主编,《Journal of Advanced Transportation》客座编辑等职务。研究聚焦人工智能与不确定性推理、数据科学等。
E-mail:zhiguangcao@outlook.com
动态约束理解:面向多任务VRP的链式上下文框架
论文摘要
多任务车辆路径问题(VRP)同时面临多种操作约束,如回程需求、路线时长和时间窗限制。现有基于强化学习的求解器通常使用固定的节点嵌入和全局上下文来决策,忽略了解码过程中约束权重和节点状态随时间变化。本文提出的链式上下文学习(Chain-of-Context Learning, CCL) 针对这一痛点,通过在解码阶段引入相关性引导的上下文重构(RGCR) 和轨迹共享的节点再嵌入(TSNR) 两大模块,实现实时上下文构建和节点表示更新。RGCR根据当前节点与各约束的相似度,在每个决策步优先聚合关键约束信息。TSNR利用多头注意机制在多条轨迹间共享上下文,将历史节点嵌入与当前上下文联合编码,并加入距离偏置抑制模型对时间窗的过拟合。在48个VRP变体(包括16个训练内任务和32个训练外任务)上的实验表明,CCL在多数任务上显著降低了解析差距(Gap)并提高了解的泛化性能。作者进一步分析了组件重要性和计算开销,提出通过调整嵌入更新概率实现性能–效率的权衡。
一、研究背景与问题
1.1 多任务 VRP 的挑战
传统 VRP 聚焦车辆容量或路径长度等单一约束,但实际应用往往涉及多种约束组合,形成多任务 VRP。典型约束包括回程需求 B(Backhaul)、路线时长 L(Limit)、开放式路线 O(Open)和客户时间窗 TW(Time Window)等。现有强化学习求解器在解码阶段使用固定节点嵌入,使得节点优先级无法反映约束权重的动态变化,导致策略泛化性差。
1.2 待解决的问题
论文聚焦以下关键问题:
如何在解码过程中动态衡量不同约束的重要性,并将其融入决策上下文? 如何在多条解码轨迹之间共享上下文并高效更新节点嵌入,避免逐步重嵌入导致的开销? 如何在保证解质量的同时兼顾模型的推理效率和参数规模?
二、链式上下文学习方法
2.1 整体框架概述
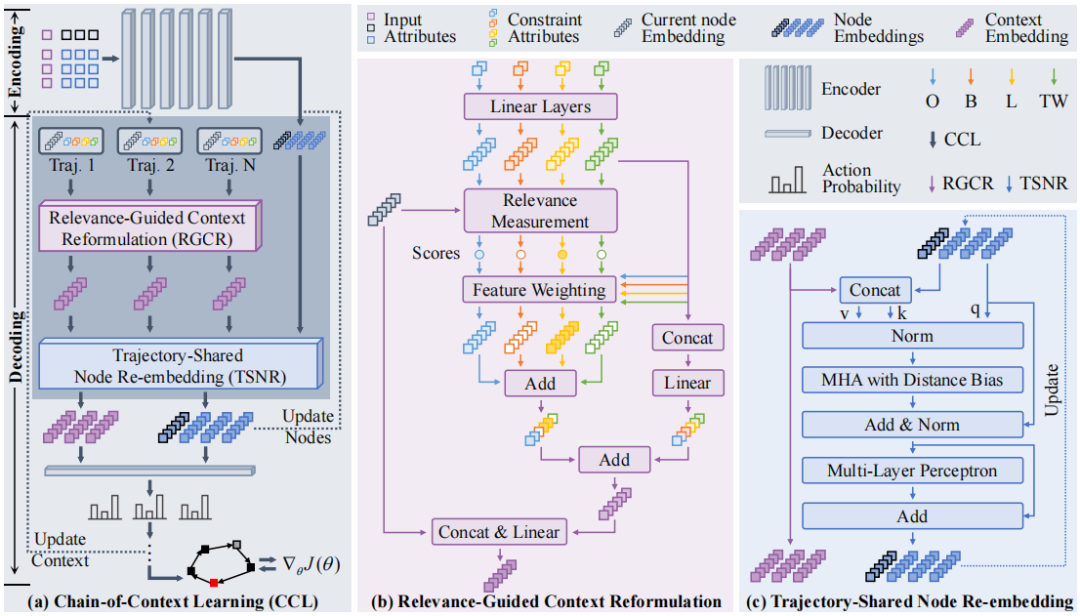
CCL采用编码器–解码器框架(见下图),编码器使用 Transformer 将约束标签 和节点属性 嵌入成初始节点表示 。解码阶段引入RGCR和TSNR模块,通过多条轨迹并行探索,构建连续的“链式上下文”。
2.2 相关性引导的上下文重构 (RGCR)
RGCR针对每个约束提取当前节点相关的属性,例如回程任务使用的 ,时间窗任务使用的 等。这些属性经线性映射得到约束嵌入 。随后计算当前节点嵌入 与各约束嵌入的相似度 。最终通过加权求和得到增强约束表示 :
其中 为四类约束嵌入的串接后映射,最终统一约束向量为 。最终上下文嵌入由 与当前节点嵌入拼接后再映射得到 。
关键点:
动态相关性学习:通过内积相似度自适应衡量各约束的重要性,优先聚焦影响大的约束。 统一上下文表达:将多个约束信息与节点状态融合成固定长度向量,便于后续处理。 高效重构:无需手工指定权重,模块自学习约束优先级。
2.3 轨迹共享的节点再嵌入 (TSNR)
为了让节点表示反映最新上下文,TSNR在多条轨迹间共享上下文并利用多头注意机制更新节点嵌入。将上一时刻节点表示 经RMS归一化后映射为查询向量 ,同时将 与所有轨迹的上下文 拼接并映射为键和值向量 :
注意力权重包含欧式距离偏置:
其中 包含节点间距离和节点–上下文距离矩阵,防止模型过度依赖时间窗结构。再嵌入表示由注意力加权求和得到:
关键点:
多轨迹共享:不同轨迹的上下文信息一起用于更新节点表示,增强稳定性。 距离偏置:利用几何距离引入先验,提升对时间窗任务的适应性。 频率控制:通过训练和测试阶段的更新概率 调节更新频率,权衡性能与效率。
2.4 步进式解码与强化学习训练
在每一步,根据新的节点表示 和上下文 通过解码器预测下一节点的选择概率 。如果所有约束均满足则选择概率最大的客户,否则回到仓库。N 条轨迹的决策序列构成样本,利用梯度强化学习目标优化参数。推理时采用多轨迹并行生成解决方案,测试阶段可调整更新概率减少计算。
三、实验设计与结果分析
3.1 数据集与评测指标
实验涉及48个VRP变体,包括16个训练内任务(组合四类约束)和32个训练外任务用于检验泛化能力。节点位置在 均匀采样,容量 ,最大路线长度 。时间窗、需求等参数也随机生成。评测指标包括总行驶距离、相对于强基线 HGS-PyVRP 的性能差距(Gap)和推理时间。在 N=50 和 N=100 两种规模下与现有SOTA模型 CaDA、RF-TE 等进行对比。
3.2 综合性能
在16个训练内任务中,CCL在两个规模下均明显优于 CaDA,尤其在时间窗任务上优势更大。结合ReLD模块后的 CCL† 进一步提升了无时间窗任务的性能,说明 ReLD 擅长抽取全局约束信号,而 CCL 更擅长细粒度的节点适应,二者互补。在32个训练外任务上,CCL† 依然取得多数任务的最好成绩,并在大规模任务中保持竞争优势。
3.3 模块消融
作者对 RGCR 和 TSNR 进行了详细的消融分析。与直接连接属性或嵌入相比,引入随机、余弦或点积相关性均能降低 Gap,其中使用点积计算的 RGCR 在时间窗任务上表现最好。对于 TSNR,只有同时包含注意力机制、嵌入更新和距离偏置时才能取得最低 Gap。这表明两模块对模型性能均至关重要。
3.4 复杂度与效率权衡
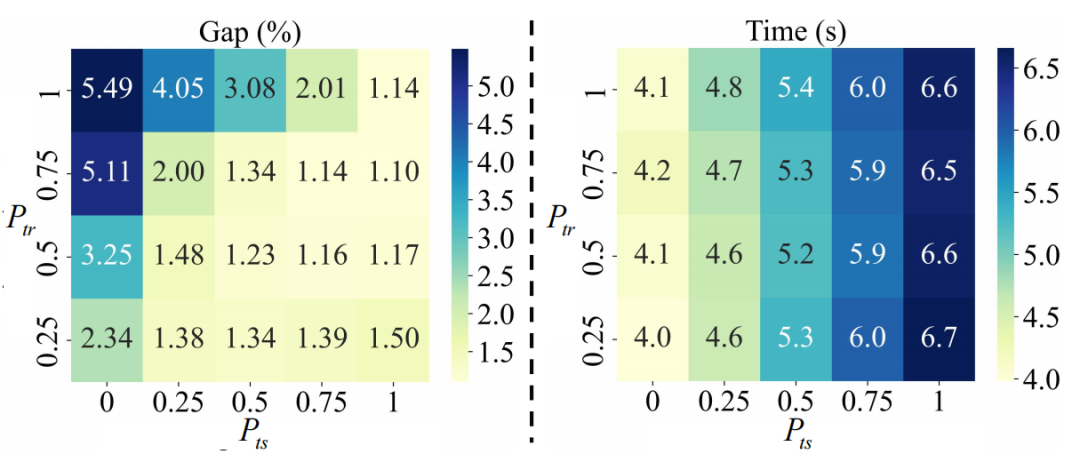
作者分析了 CCL 与基线模型的参数量、显存和推理时间。相比 CaDA,CCL在性能提升的同时仅增加了少量参数和显存开销,推理时间略长但可接受。为降低计算成本,论文通过控制更新概率 P_tr 和 P_ts 调节再嵌入的频率。热度图显示:在固定训练概率下,适当提高测试更新概率可减小 Gap;而降低测试更新概率则缩短推理时间,提供质量与效率的权衡。
3.5 泛化与拓展
CCL 还被验证在灵活流水线调度和图结构输入上的泛化能力,在这些非 VRP 任务上同样表现出色(详见附录)。这一结果表明链式上下文学习框架具备较好的迁移潜力。
四、挑战与处理策略
约束权重动态性:在多约束环境下,每种约束在不同阶段的重要性不同。RGCR 通过点积相似度自适应调整约束权重,避免固定注意机制难以聚焦重要信息。 多轨迹重嵌入的计算成本:逐条轨迹更新节点嵌入开销巨大。TSNR 采用共享上下文并联合更新节点表示,大幅降低了重嵌入的复杂度。 时间窗约束下的过拟合:模型可能过度依赖时间窗信息。TSNR 在注意力权重中加入基于坐标的距离偏置,引入几何先验以提高泛化能力。 性能–效率权衡:再嵌入频率影响解的质量与推理时间。论文提出通过概率参数 控制更新频率,用户可根据实际需求选择合适配置。
五、创新亮点与学术贡献
提出链式上下文学习框架:引入 RGCR 和 TSNR 模块,实现解码过程中对约束和节点的动态理解和更新,显著提升多任务 VRP 的求解质量。 相关性驱动的上下文重构:基于当前节点与各约束嵌入的相关性自适应聚合约束,解决了固定嵌入无法反映节点优先级变化的问题。 轨迹共享的节点再嵌入机制:在多轨迹间共享上下文,结合距离偏置的多头注意力更新节点表示,提高了模型泛化性并降低了计算开销。 性能–效率可调节:通过调节嵌入更新概率,实现解质量与推理速度的平衡,满足不同应用场景需求。 广泛实验验证:在48个 VRP 变体和其他调度任务上的实验表明,CCL 超越了现有 SOTA 模型,并在训练外任务中保持稳定优势。
结语
链式上下文学习针对多任务 VRP 中约束和节点的动态性问题,提出了兼顾精度与效率的新解法。其核心思想是通过相关性引导的上下文重构和轨迹共享的节点再嵌入,实现解码过程中细粒度且连贯的上下文建模。实验结果表明,该方法不仅在多个约束组合上明显超越现有模型,而且具有良好的泛化能力和可调节的效率。对于未来研究,CCL 提供了一种通用的动态约束理解框架,可扩展到其他复杂的组合优化和调度任务。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、汪朝杰、王一航、张仁义(EIC)、张晓乐、胡紫琪
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



