论文题目:Multi-agent deep reinforcement learning-based truck-drone collaborative routing with dynamic emergency response
第一作者:Wenhao Peng 四川大学学生,集中于智能物流与运筹优化。
通讯作者:殷允强 电子科技大学经济与管理学院教授,博士生导师,运作优化与智能决策研究所所长,研究方向:智能管理决策与优化,数智运营与供应链管理,商务智能与数据挖掘。
E-mail:yinyq@uestc.edu.cn
应急物流中的卡车一无人机协同调度:动态环境下的路径优化问题
论文摘要
本文关注发生灾害后的应急物流问题,核心任务是在需求不断变化的灾害区域内及时、均衡地配送救援物资。传统确定性模型难以适应实时变化的需求和道路状况。为此,论文将问题建模为 多智能体马尔科夫博弈(MG) ,引入一系列参与者:多辆卡车及其配套的无人机,卡车负责运输和作为移动基地,无人机可独立执行短途任务。模型中考虑节点的需求量、最后期限以及道路破损造成的可达性限制。研究通过设定决策时机、状态域、动作域和状态转移规则,构建了 动态决策框架 ,并设计了兼顾成本、迟到惩罚和公平性的即时奖励函数。为求解该MG模型,作者开发了 基于多智能体深度确定性策略梯度(MADDPG)的强化学习算法 ,并引入无效动作屏蔽(IAM)和优先经验回放(PER)技术,在集中训练与分布执行的框架下提升学习效率。实验结果表明,该方法在收敛速度和成本控制方面优于不含IAM或PER的变体,并显著降低了与静态模型和滚动启发式方法相比的总成本。通过汶川地震案例,论文验证了卡车‑无人机协同模式在实际场景中的优势,相比卡车/直升机模式能减少运输工具数量并节约约9%成本。
一、问题背景与研究意义
1.1 灾害情景及模型需求
灾害发生后,道路受损、需求不断变化且存在严格的时间窗口,如何在有限的资源下调度车辆和无人机高效完成救援配送成为难题。现有以整数规划为主的确定性模型无法实时捕捉新出现的节点和需求的不确定性。因此,需要构建面向动态环境的决策模型,能够根据实时信息调整路线并兼顾成本、时效和公平性。本文提出将问题视为多智能体博弈:各卡车‑无人机组合共享环境,彼此的决策互相影响,需要协调合作以获取最大整体奖励。
1.2 研究目标
论文旨在实现以下目标:
运营效率:通过合理调度以最小化车辆和无人机的行驶成本,成本系数分别记为 和 。 交付及时性:设置节点最后期限 ,延迟将产生惩罚 ,鼓励提前或准时送达。 服务公平性:对未服务节点设置惩罚 ,确保受灾区域得到公平救助。
二、MG模型构建
2.1 决策时机与决策框架
模型以时间步 为单位,当任一车辆或无人机完成服务或在会合节点等待时,触发决策时机。规划期为 ,系统在每个时间步仅记录当前时间 ;若 ,则博弈终止。对于在时间步 尚未完成任务的代理,其在时间步 必须继续执行原任务,直至完成,以保证任务执行的连续性与完整性。
2.2 状态域定义
系统状态 由两个部分组成:
运输组合状态:每个卡车‑无人机组合由八元组描述:
– 卡车状态(0:行驶,1:等待会合,2:刚访问节点,3:刚会合)。 – 无人机状态(0:飞行,1:等待会合,2:独立访问,3:在车上)。 、 – 当前卡车/无人机位置或剩余行驶/等待时间。 、 – 目标节点。 – 卡车剩余载重。 – 当前时间。 节点状态:节点 由三元组 表示。 为需求量, 为最后期限,表示尚未分配任务, 表示已分配但未服务。
2.3 动作域与约束
动作域按照代理所处状态分为五类:
不可用状态: 若卡车 或无人机 (或 且 ),则动作为 “pass”,即延续当前行动。
卡车刚访问节点: 当 时,卡车可选择服务一个可服务节点或在当前节点等待无人机。约束确保卡车至多执行一个动作:
卡车刚会合无人机: 当 时,只能选择前往一个服务节点 ,满足
无人机刚独立服务: 当 时,无人机选择一个会合节点,满足
无人机在车上: 当 时,可选择继续搭载或发射去服务节点,满足
这些约束确保每个代理在每个决策时刻至多执行一个可行动作,避免调度冲突。
2.4 状态转移与奖励函数
状态转移函数 根据联合动作 演化系统状态:
以卡车服务节点 为例,其状态更新为:
类似地,无人机在执行服务或会合动作时,分别更新其剩余飞行时间与目标节点。
奖励函数由三部分组成:
行驶成本,由行驶距离与单位成本 决定; 延迟成本; 服务收益,与未服务惩罚相对应。
每个代理 在时间步 的即时奖励定义为
系统总奖励为
通过在整个规划期内累积该奖励函数,模型引导多智能体在运营效率、交付及时性与服务公平性之间实现最优权衡。
三、强化学习算法设计
3.1 集中训练–分布执行框架
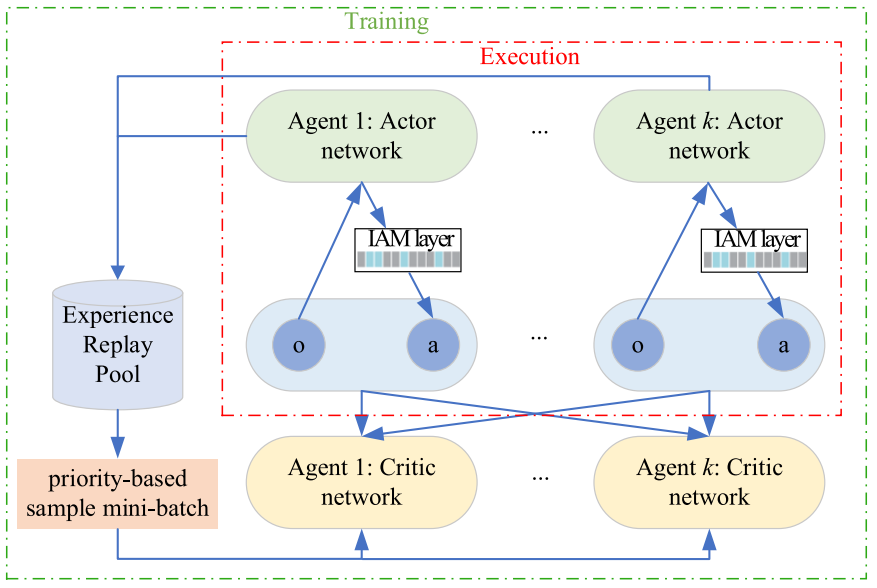
论文采用多智能体深度确定性策略梯度(MADDPG)作为基础算法,通过集中训练和分布执行实现协调学习。在集中训练阶段,各代理共享全局信息与策略网络,通过批量经验更新模型;在执行阶段,各代理根据本地观察独立选择动作。
3.2 IAM与PER机制
为解决动作空间巨大和经验利用效率低的问题,作者引入两项改进:
无效动作屏蔽(IAM):在决策时屏蔽不符合约束的动作,减少搜索空间,避免策略网络输出无效决策。 优先经验回放(PER):经验池按照时间差误差赋予不同优先级,训练时更频繁采样关键经验,加快收敛。
该算法被称为IAM‑PER‑MADDPG,其总体架构如图1所示。绿色框代表演员网络、黄色框代表评论员网络,蓝色箭头表示执行阶段的状态‑动作‑奖励流,红色箭头表示训练阶段的梯度更新。
3.3 算法流程
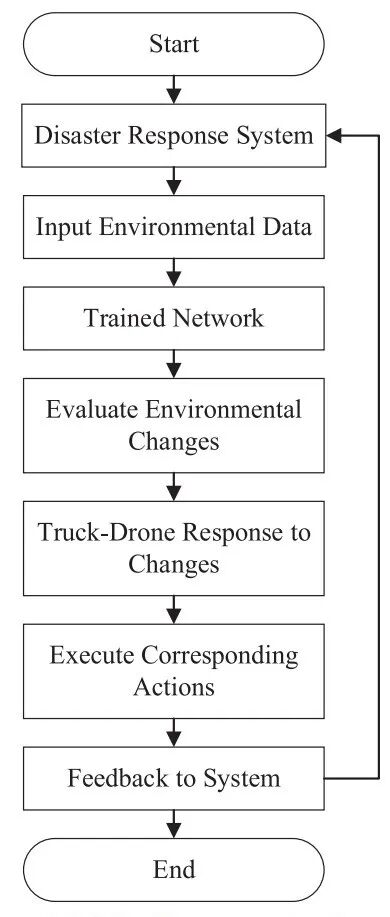
总体流程如图所示。系统在每一决策时刻获取灾区实时数据,经网络决策后输出每个代理的动作并实施。随后将经验存入回放池,通过优先采样和梯度下降更新网络。训练和执行交替进行直至收敛。
四、实验研究与结果分析
4.1 培训表现与消融实验
作者构建了多个模拟场景,考虑不同的受灾区域数量、无人机比例等,系统需求按区间随机生成。消融实验将 IAM‑PER‑MADDPG 与三个变体比较:仅含 IAM、不含 IAM、不含任何增强。结果显示完整算法在约390个训练回合内收敛,而仅含 IAM 与仅含 PER 的模型分别在 1000 和 1240 回合左右收敛。完全无增强的 MADDPG 需要超过 1400 回合,且表现波动大。这一结果证明 IAM 和 PER 协同加速了学习并提高稳定性。
4.2 与基准方法对比
作者以整数规划(MIP)模型求解低复杂度实例下的最优解作为下界,并与Gu启发式算法和 LNS 滚动算法进行比较。对比结果表明,IAM‑PER‑MADDPG 在多数场景下总成本比 Gu 算法低 3.29%~40.86%,比 LNS 方法低 1.31%~51.48%,且计算时间显著更短。即便在信息完备度较低的高动态场景,强化学习算法也能保持较低成本增长率。
4.3 参数敏感性分析
论文还考察了关键参数对绩效的影响,主要结论如下:
飞行时间比 :随着无人机相对速度提高,总成本、延迟和未服务节点数均下降,但当比值超过2时下降幅度变小。 运输成本比 :成本比增大导致总成本和运输成本先升后稳,延迟和未服务节点对成本变化不敏感。 延迟惩罚系数 :惩罚提高时,无人机优先分配到紧急节点,未服务节点减少,但惩罚过高会使系统接受部分节点不服务以避免巨额延迟罚金。 无人机载重与续航 :增加载重更能降低运输成本,延长续航则有助于减少延迟。
五、汶川地震案例研究
5.1 数据与场景设置
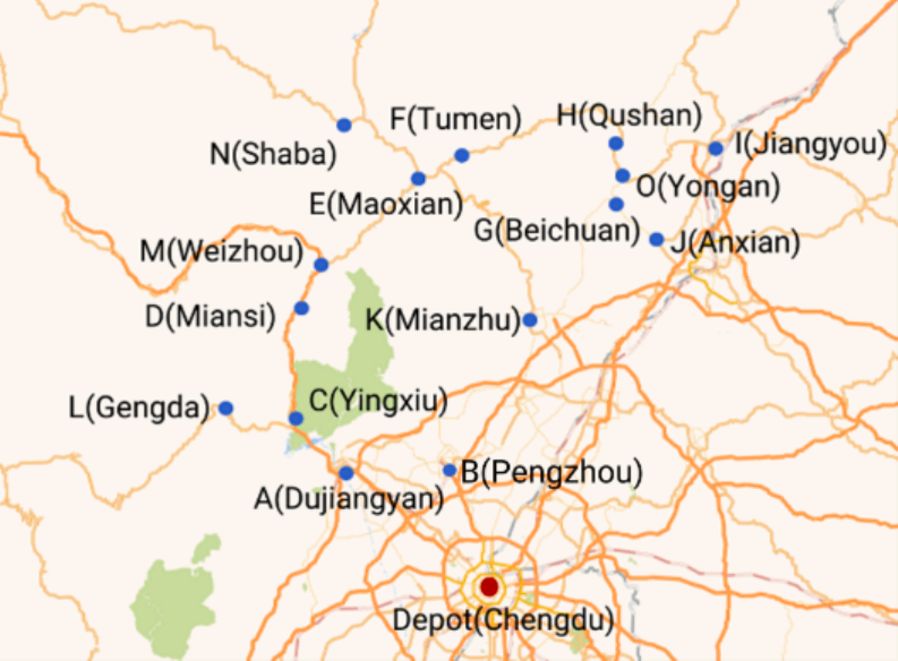
选取汶川地震中15个受灾地点作为节点,成都作为配送中心。4个节点因道路损毁,仅能由无人机或直升机服务。下图展示了配送中心及各受灾节点的地理分布,蓝色为需求节点,红色为配送中心。
5.2 协同模式对比
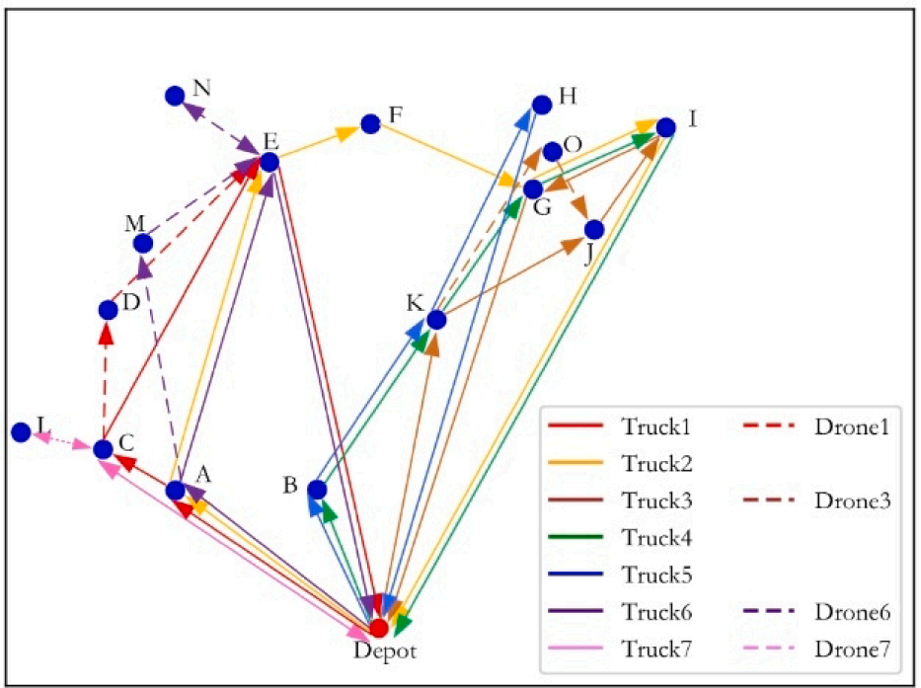
为比较卡车‑无人机协同与卡车/直升机模式,两种运输方式在相同需求和路径限制下运行。下图为卡车‑无人机模式的最优路径,每条颜色对应一个卡车‑无人机组合;虚线段为无人机子路径。
而下图为卡车/直升机模式,直升机代替无人机执行无人区任务,其线路更复杂且使用的运输工具更多。
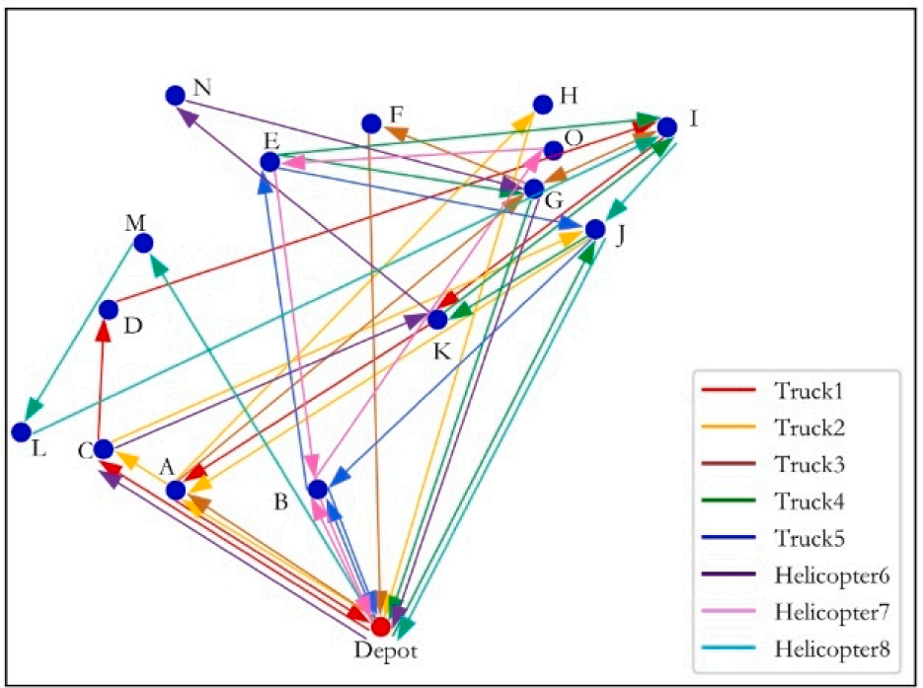
结果显示,在IAM‑PER‑MADDPG算法下,协同模式比直升机模式节约约9.69%的总成本,使用的运输组合少1~2个。滚动算法下也观察到类似的9%左右节约。由于无人机灵活迅速、运行成本低,在道路损毁严重的区域发挥了显著作用。
六、主要结论与创新点
问题建模:首次将灾害应急运输的卡车‑无人机联合调度问题抽象为多智能体马尔科夫博弈,考虑动态决策时机、更新节点状态和动作约束。 奖励设计:构建包含行驶成本、延迟惩罚和服务奖励的即时奖励函数(式2),促使代理在效率、时效与公平性之间权衡。 算法创新:提出IAM‑PER‑MADDPG算法,通过无效动作屏蔽减少搜索空间,优先经验回放提高学习效率,并采用集中训练与分布执行框架。 性能验证:通过消融实验和与静态或滚动启发式方法的对比,证明算法在收敛速度、总成本和计算时间上具有显著优势。 实际应用:汶川地震案例表明,卡车‑无人机协同模式能减少运输工具数量并降低约9%的总成本,对灾害救援具有实践价值。
七、未来研究方向
尽管本文取得了重要进展,但仍存在扩展空间:
多无人机与多任务:目前每辆卡车仅携带一架无人机且一次只能服务一个节点,可研究多无人机和无人机连线服务多个节点的情况。 能耗模型:假设能耗与距离成正比,未来可考虑与载荷相关的能耗模型,贴近实际电池消耗情况。 模型可解释性:DRL决策过程仍是“黑箱”,有必要结合可解释机器学习或混合优化方法,增加模型透明度。 场景推广:将模型推广到城市配送、医疗物资配送等场景,探索不同交通工具的组合和协同机制。
通过上述分析可以看出,多智能体深度强化学习结合卡车‑无人机协同模式为动态灾害救援提供了高效的决策工具,不仅能够应对不确定需求,还能兼顾效率与公平,具有广阔的应用前景。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、汪朝杰、王一航、张仁义(EIC)、张晓乐
原文链接:https://doi.org/10.1016/j.tre.2025.103974
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。