群智感知中的车辆分布优化:将优化层嵌入深度学习的车辆再定位算法
一、研究背景与问题提出
1.1 车辆众包感知的特点与挑战
移动群智感知(MCS)是一种利用移动终端收集环境信息的新范式。相比固定传感器网络,MCS成本低且覆盖范围广。
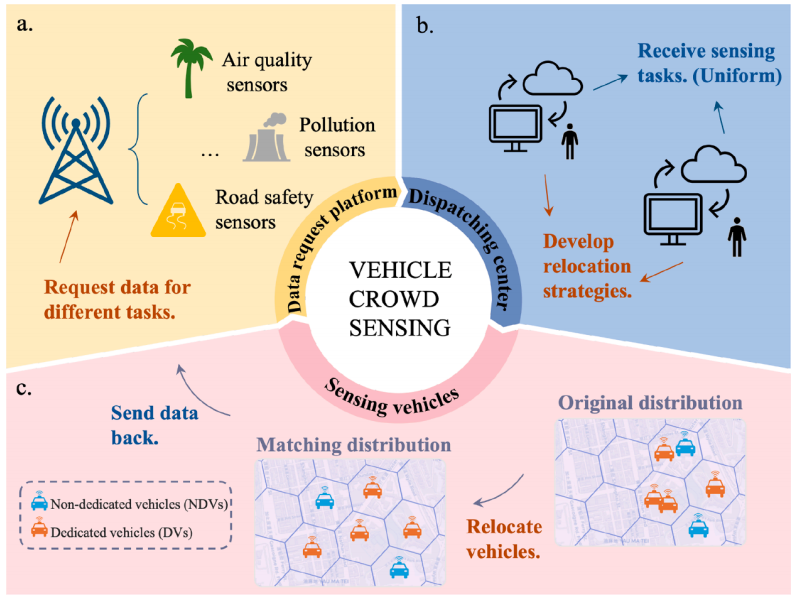
车辆众包感知(VCS)是MCS的重要分支,参与车辆分为两类:
专用车辆(DV):通过奖励或任务指派主动完成感知任务。 非专用车辆(NDV):利用日常出行被动收集数据。 不同感知任务对应不同的目标分布:如空气质量监测要求均匀覆盖,而道路拥堵监测可采用高斯分布等。然而现实中NDV的分布往往与目标分布不一致,这就需要对DV进行重定位。
1.2 传统预测-后优化方法的局限
传统的两阶段流程先预测 NDV 分布 ,再解车辆重定位模型以满足目标分布 。这种 预测-后优化 (PTO) 容易因上游预测误差累积而导致下游决策失效。
1.3 研究目标与主要贡献
本文提出SPO‑VCS(Smart Predict‑then‑Optimize for Vehicle Crowd Sensing),通过端到端方式联合训练预测与优化模块。主要贡献包括:
构建一种利用交替方向乘子法(ADMM)展开的预测-优化一体化框架,将二次规划重定位模型纳入深度网络端到端训练。 引入匹配损失,直接最小化车辆分布与目标分布之间的差异,而不仅是预测误差。 在香港(45/68单元)和成都两大出租车数据集上进行实验,验证SPO‑VCS在匹配准确度和运行效率上的优势。
下图展示了VCS的感知流程,平台、调度中心和车辆之间协调完成数据采集(取自Fig.1)。
二、SPO‑VCS模型与方法
2.1 变量关系与需求估计
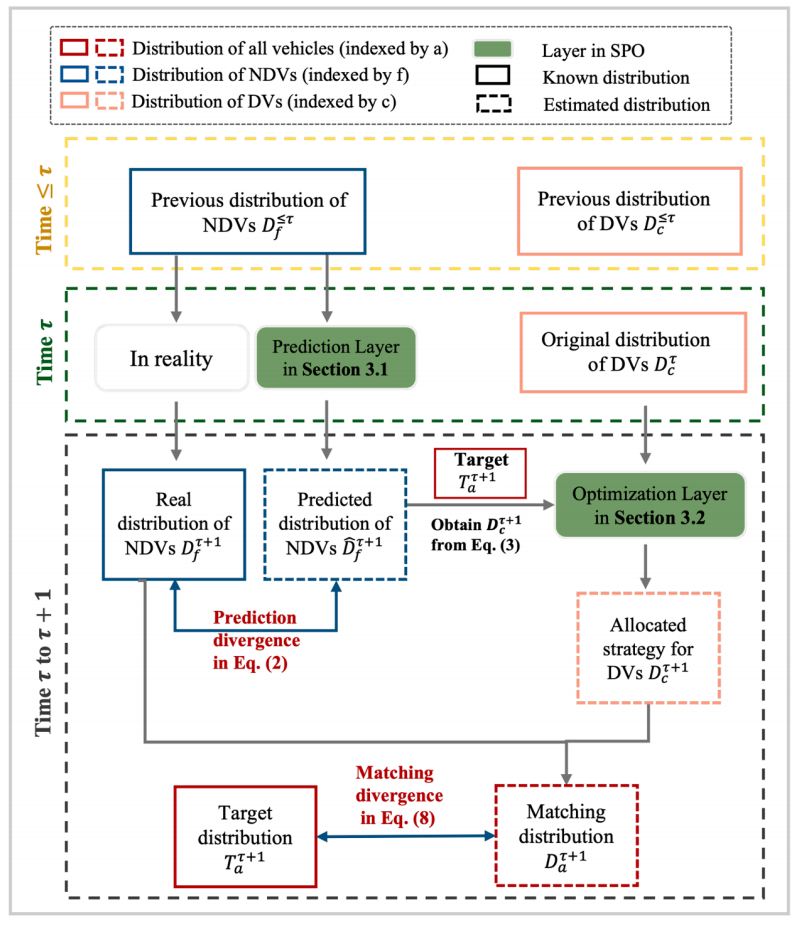
预测层输出NDV预测分布,而目标分布为。通过计算两者的差,得到DV需求估计:
下图展示了预测和优化模块间变量关系:目标分布、NDV分布、估计DV需求、匹配分布等(取自Fig.3)。
2.2 DV重定位二次规划模型
DV 重定位问题在每个时间周期 求解以下二次规划(QP):
s.t.
其中 表示在时间 从栅格 派遣到栅格 的 DV 数量, 为 DV 供应量, 为最大可行迁移时间, 为转移成本, 为总激励预算。
为融入深度学习架构,作者将上述QP向量化为标准二次形式:
其中、、、由交通约束构建。
2.3 预测与优化联合损失
SPO‑VCS采用匹配损失来衡量最终车辆分布与目标分布的一致性,整体损失函数为:
其中 为预测损失(如均方误差), 为匹配损失。通过选择合适的权重 ,模型倾向于提高最终车辆分布匹配精度而非单纯预测精度。
2.4 交替微分与ADMM展开
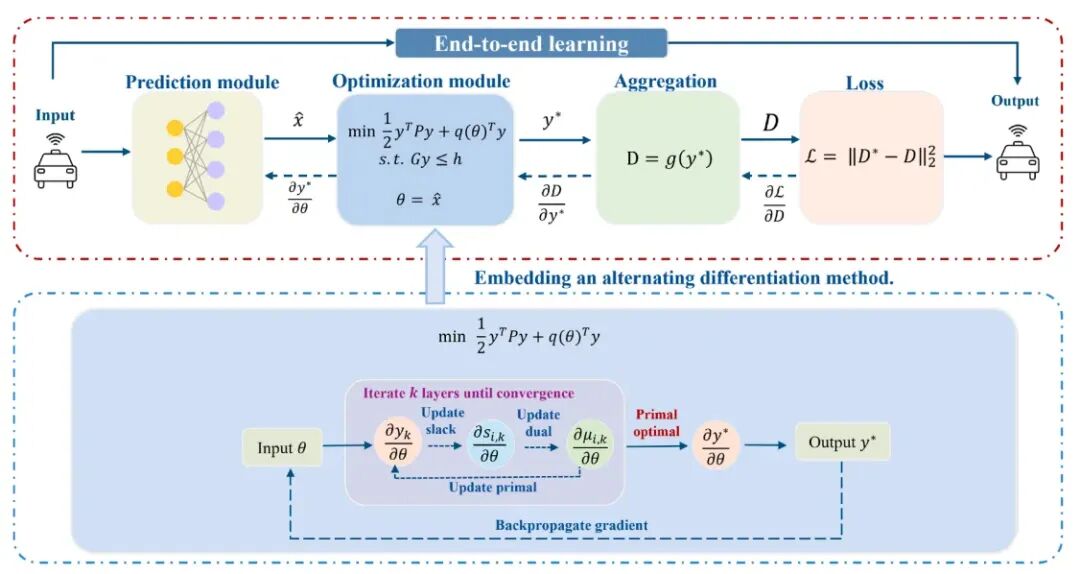
要在深度网络中反向传播QP的决策影响,作者采用交替方向乘子法(ADMM)展开显式求梯度。关键步骤如下:
构建带罚项的增广拉格朗日函数,引入辅助变量和拉格朗日乘子。 交替迭代更新:
其中为投影算子,为罚参数。
将上述迭代展开为一层层的神经网络结构,显式计算梯度并通过链式法则反向传播。
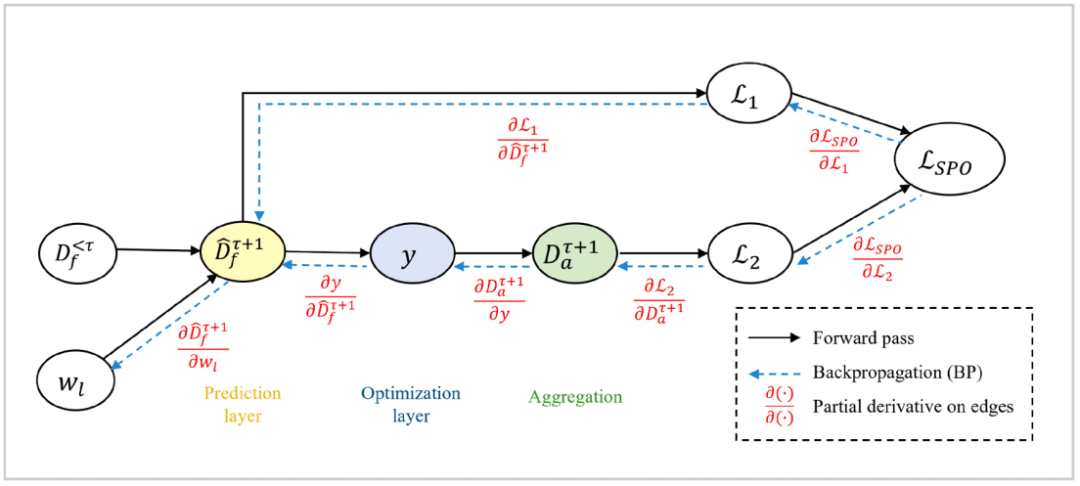
下图分别为SPO‑VCS框架示意和计算图结构,其中展示了数据流、预测输出、QP决策与梯度传播路径(取自Fig.2和Fig.4)。
2.5 显式与隐式微分比较
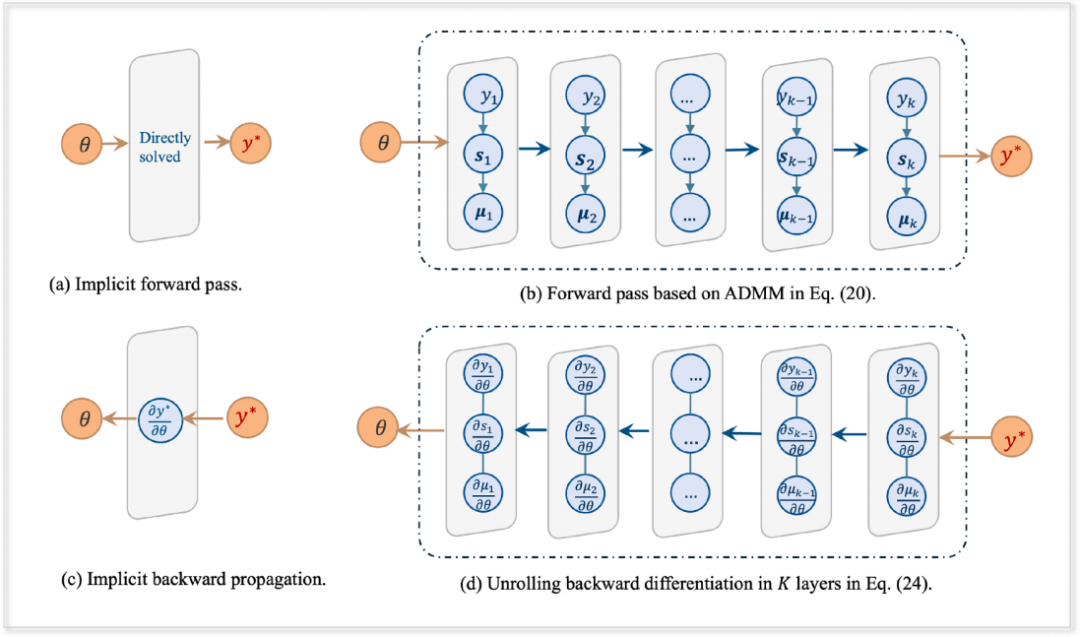
文中比较了显式展开和隐式求导两种梯度计算方式。显式展开通过 ADMM 迭代构建可微结构,避免求解 KKT 系统;隐式求导需计算矩阵逆,内存开销大且在大规模问题中不稳定。实验中显式方法表现更优。下图对比两种方法的求导路径和速度差异(取自Fig.5)。
三、数据与实验设计
3.1 数据集与案例
实验在两类案例中验证 SPO‑VCS:
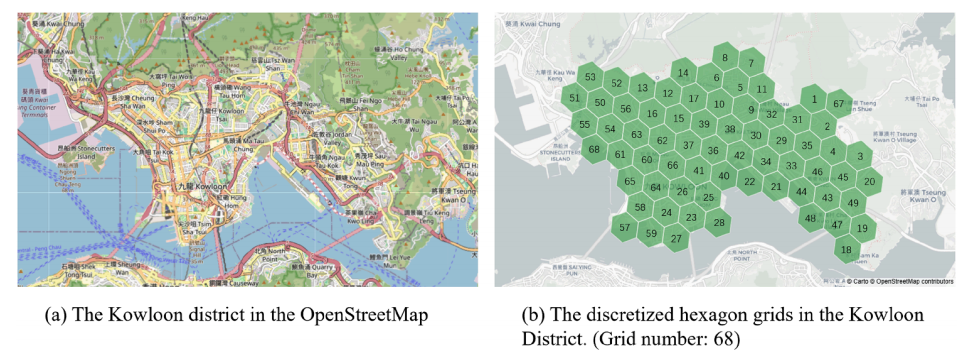
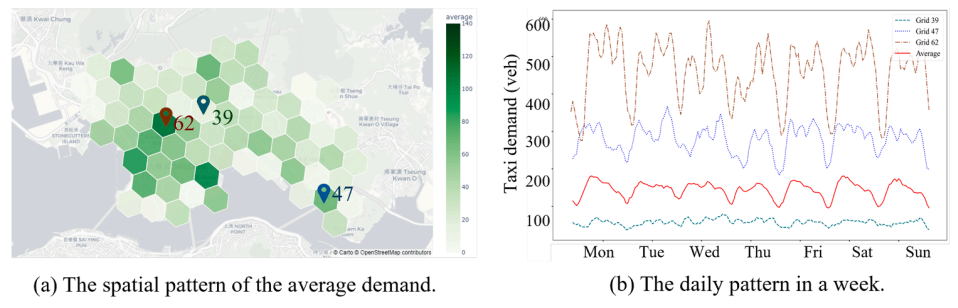
案例A(香港):选取九龙半岛的出租车运行数据,将研究区域划分为 45 个或 68 个六边形栅格,采样周期 min。输入特征包括历史NDV数量、天气、时间等。 案例B(成都):采用成都出租车数据,划分为 60 / 80 / 100个栅格,并生成相应的 DV / NDV 输入特征。下图展示了案例A地区及栅格划分(取自Fig.6)。
3.2 目标分布与评价指标
研究生成三种目标分布:均匀分布、单峰高斯分布、混合高斯分布。用以下指标评价算法性能:
RMSE:预测分布与真实分布的均方根误差。 SMAPE:对称平均绝对百分比误差。 匹配提升率:优化后匹配误差相较基准方案的改善比例,用于衡量重定位效果。
3.3 训练设置与模型比较
预测模块分别采用时间图卷积网络(TGCN)、注意力时空图卷积网络(ASTGCN)与扩散卷积循环网络(DCRNN)。优化模块对比三种策略:
PTO:先预测后优化,两者独立。 SPO‑C:端到端但采用隐式微分。 SPO‑A:端到端且显式ADMM展开。
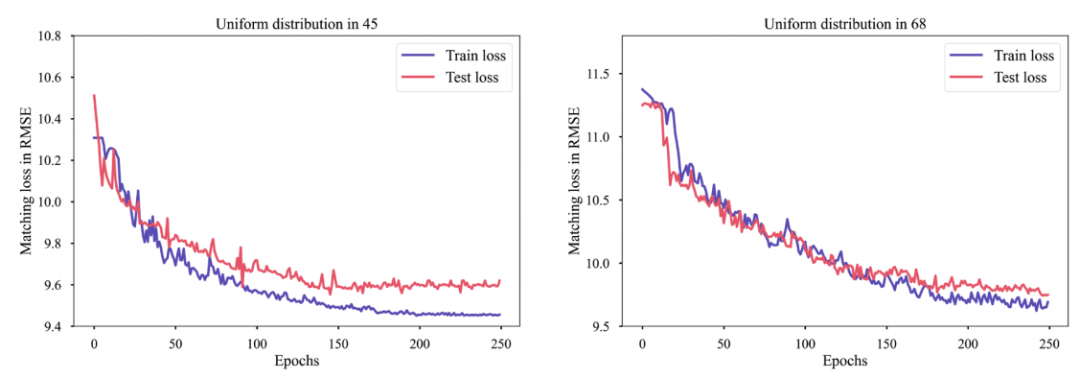
训练曲线(图8)显示SPO‑A收敛速度更快,在测试集上取得更低损失。
四、实验结果与分析
4.1 SPO‑A性能显著优于PTO和SPO‑C
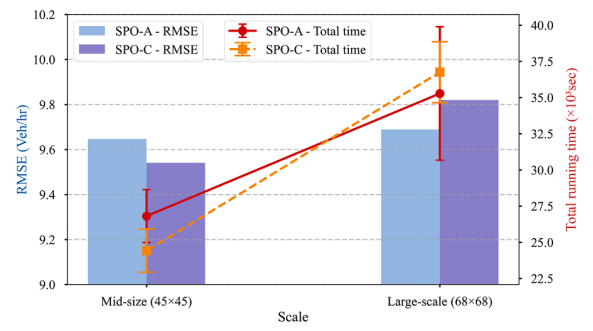
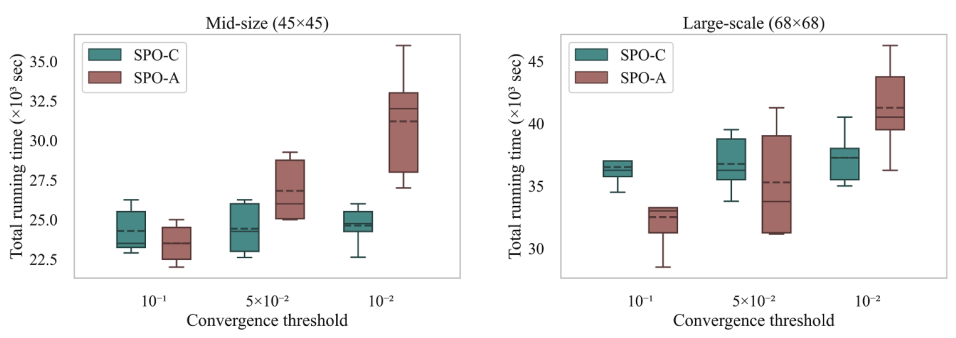
实验表明,在 45/68 栅格的案例 A 中,SPO‑A 在所有目标分布上均获得最低 RMSE,并且相较 PTO 平均提高约 7.9%,相较 SPO‑C 提高约 5%。下图比较了不同算法在 RMSE 和运行时间上的表现(取自Fig.9)。
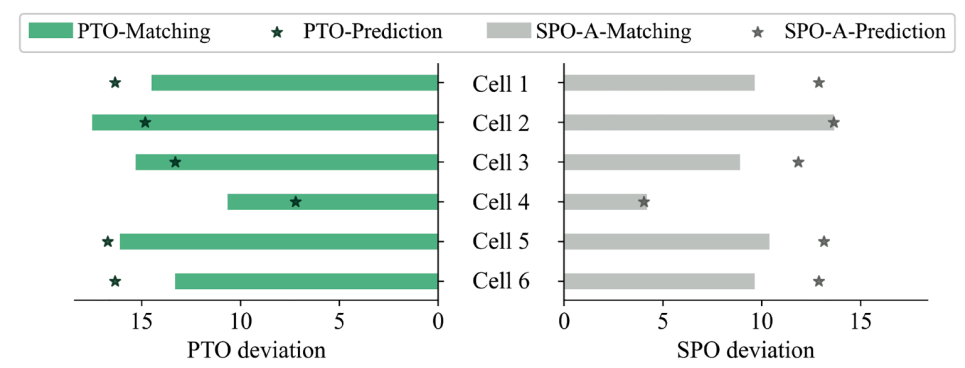
此外,图10显示SPO‑A在六个典型栅格上的匹配偏差显著小于PTO,说明端到端训练能有效减少决策偏差。
4.2 空间误差分布与匹配效果
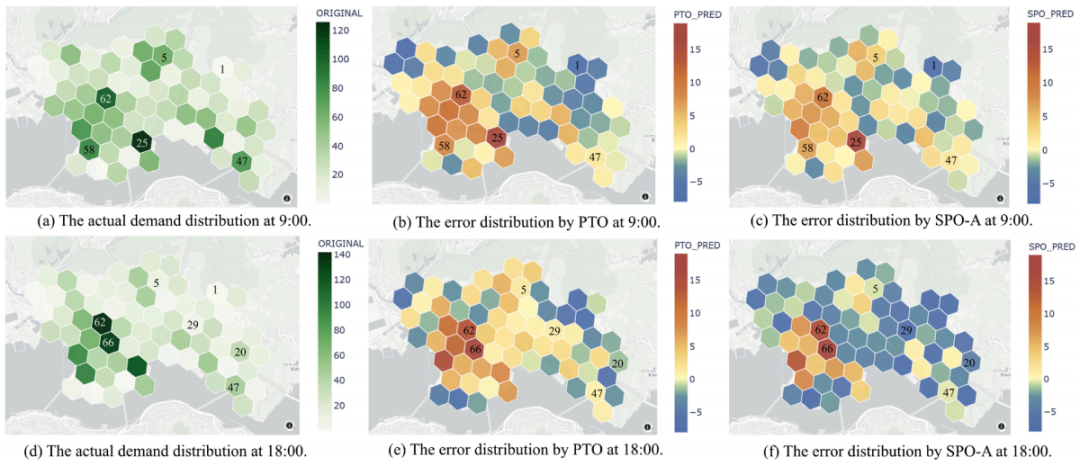
图11展示了实际需求、PTO和SPO‑A的误差分布,可见PTO在高需求区域(如旺角附近)有明显高估,而SPO‑A的误差更加均匀,体现了匹配损失的作用(取自Fig.11)。
4.3 参数敏感性与扩展分析
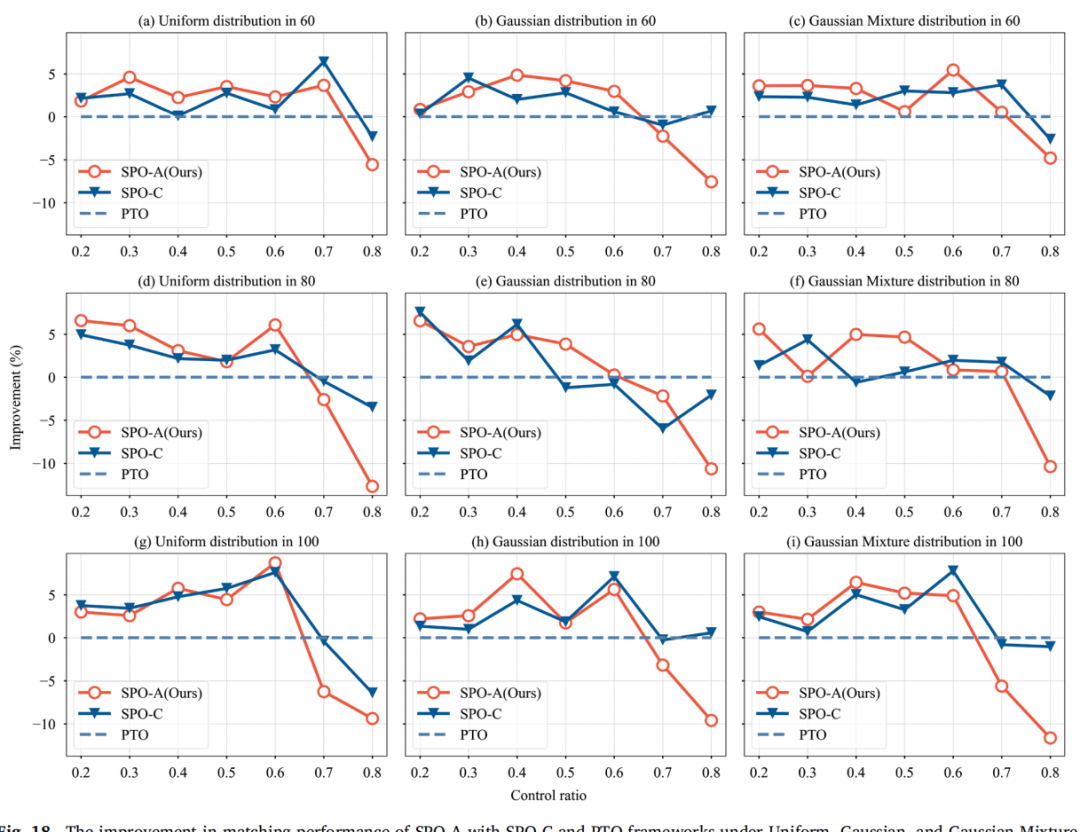
栅格数量:在60/80/100栅格的成都案例中,SPO‑A仍然表现稳健,随着规模增大,改进率略有下降但仍优于PTO。 目标分布类型:均匀分布易匹配,混合高斯最难;SPO‑A在各种分布下均优于PTO和SPO‑C。 罚参数:改变ADMM罚参数会影响运行时间与准确性,适当参数可在图12中看到改进与控制率的权衡(取自Fig.13)。
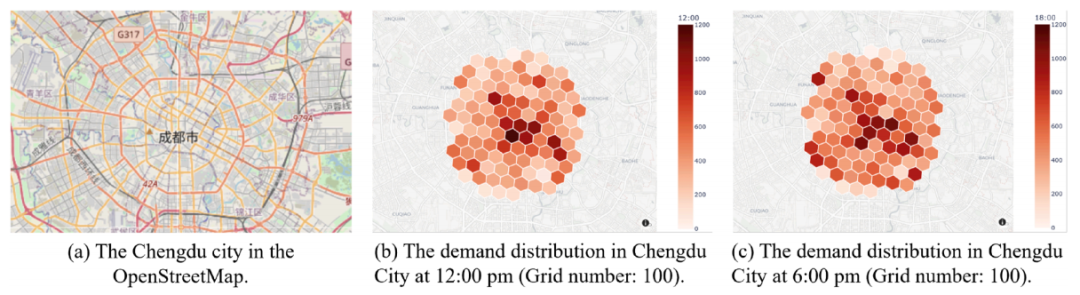
案例B的地图如图13所示,显示了成都栅格划分和不同目标分布下的需求示意(取自Fig.17)。
在成都案例中,不同栅格数下改进率如图14所示,体现了规模对匹配效果的影响(取自Fig.18)。
五、困难与解决方案
预测误差传递:PTO难以处理预测误差对优化的影响。SPO‑VCS通过匹配损失直接优化最终匹配效果,从根本上解决了此问题。 二次规划可微难题:QP解是优化层,梯度难以显式计算。作者用ADMM展开构建可微层并推导梯度,实现稳定训练。 大规模计算:在68栅格及成都百栅格的情况下,传统隐式求导不稳定。显式ADMM展开结合GPU并行使得训练和推理速度显著提升。
六、结论与管理启示
SPO‑VCS创新地将预测与优化融合,通过ADMM交替微分实现端到端训练,有效提升了匹配准确性并降低运行时间。 匹配损失的引入使模型关注最终目标而非仅重视预测精度,从而更加贴近实际运营需求。 实验表明,SPO‑A在多个场景下均优于PTO和SPO‑C,其改进幅度在大型网络中尤为显著。 管理启示:对于城市移动群智感知任务,建议采用端到端的预测-优化方法,合理设置目标分布和罚参数,并根据应用场景选择栅格划分尺度。此外,可将该框架推广到共享单车调度、外卖派单等需要联合预测与优化的领域。
通过本文的解读,相信读者对SPO‑VCS框架、ADMM展开方法以及在车辆重定位问题中的应用有了更深刻理解,为未来在大规模智能调度领域的研究与实践提供参考。
文章须知
推文编辑:单子叶
责任编辑:弓仪长
原文链接:https://doi.org/10.1016/j.tre.2025.104515


