多层级库存优化场景:多智能体深度强化学习算法解读
一、研究背景与问题提出
1.1 多层级库存管理的复杂性
多层级库存优化(MEIO) 问题涉及在供应链的多个阶段(采购、生产、运输、零售)协调库存水平。目标是通过合适的补货政策,最小化系统总成本。 商业软件例如 SmartOps 和 LogicTools 证明了该问题的工业价值。 在安装库存策略(IS-MEIO)下,各节点仅基于本地信息(库存、在途订单、到货订单)决策,具有通信要求低、易于实施的优势。
1.2 现有方法与不足
经典研究多在 简化假设 下推导最优补货策略。Clark 和 Scarf 在串行供应链中证明了基地存货(Base‑stock)策略的最优性,但要求需求独立同分布且缺货成本只在零售端发生。 当考虑随机需求、复杂成本结构和不确定提前期时,MEIO 问题难以解析求解。 多智能体深度强化学习(MADRL)能够在未知环境中通过交互学习策略,且适合处理高维状态空间。然而,许多研究依赖完全可观测或集中控制的假设,这在实际供应链中并不常见。
1.3 研究问题与贡献
本研究关注四阶段串行供应链(啤酒游戏),参与者包括零售商、仓库、分销商和制造商,各自独立决策但共享总成本。 将问题建模为 去中心化部分可观马尔可夫决策过程(Dec‑POMDP)。 提出一种 多智能体近端策略优化(MAPPO)算法,并通过共享参数和循环神经网络解决局部观测及非平稳问题。 引入 领域随机化(Domain Randomization, DR),在训练阶段随机环境参数,使策略对实际环境差异具有鲁棒性。 使用真实销售数据验证所提算法,比较基准策略(基地存货)、强化学习方法和线性规划方法的表现。
二、问题建模与理论基础
2.1 串行供应链与啤酒游戏模型
啤酒游戏模型包含四个串行阶段,每个阶段在时间步 拥有以下变量:
:阶段 收到的订单数量(来自下游); :阶段 收到的发运量(来自上游); :库存水平,正值表示库存,负值表示缺货; :在途(未到货)订单数量; :阶段 在时刻 向上游发出的订货量。
在每个时间步,参与者先接收来自下游的订单,据此决定订货量 向上游补货;上游会在给定运输提前期后发出并送达发运量 。发货给下游的数量 由下式确定:
其中 表示正库存, 表示缺货。该公式确保参与者在库存与到货约束下尽可能满足下游需求。
设 与 分别表示第 阶段的信息提前期和运输提前期,则:
下游订单在 步后到达; 上游发运在 步后送达。
库存与在途库存的动态更新为:
式中 为上游到货发运, 为本期收到的下游订单, 为当前发出的订货量。
2.2 目标函数与 Dec‑POMDP 表述
在给定时间范围 内,每个阶段承担库存持有成本 和缺货成本 。系统总成本为:
由于参与者决策互相影响且只有局部观测,问题建模为 Dec‑POMDP。模型元素包括:
参与者集合:四个阶段。 状态空间:所有阶段库存与在途状态的组合。 动作空间:阶段 的订货决策。 观测空间:阶段 可观测的变量(库存、在途订单、到货订单)。 状态转移函数:由库存动态方程决定。 公共奖励函数:系统总成本的相反数。 折扣因子:在本文实验中设为 0.99。
Dec‑POMDP 的目标是在保证局部观测的情况下,寻找联合策略 使得期望累计回报(成本的负值)最大。
2.3 去中心化强化学习的挑战
部分可观测:每个代理只能观察本地状态,导致历史信息维度随时间增长,需要记忆机制。 非稳定性:在多智能体环境中,其他代理策略变化会导致环境动态改变,训练不稳定。 动作空间大:订货量通常是非负整数,直接优化难度大。
三、优化算法设计
3.1 中心化训练与去中心化执行框架
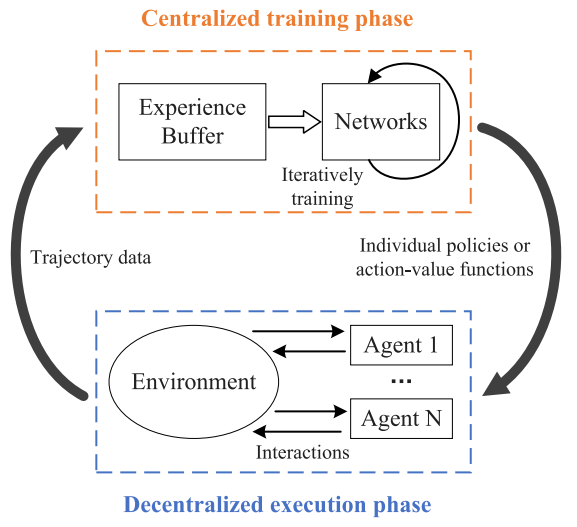
为了处理 Dec‑POMDP 的耦合性,作者采用 中心化训练–去中心化执行(CTDE) 框架。训练阶段,所有代理共享经验池和价值网络;执行阶段各代理独立行动。框架如下图所示:
下图展示了该框架的结构:训练时通过经验回放和集中评论者优化策略,执行时仅依赖本地信息。
3.2 多智能体近端策略优化 (MAPPO)
MAPPO 是一种在 PPO 基础上扩展到多智能体的策略梯度算法。主要特征包括共享参数和信任域约束。
共享参数:采用 参数共享 的方式用单个网络为所有代理表示策略,通过在观测中加入代理索引来区分各代理。 评论者-行动者架构:评论者网络估计值函数,行动者网络输出策略。网络结构包含 MLP+GRU+线性层。GRU 用于处理长时序依赖,适合部分可观环境。
3.2.1 损失函数与更新
为保证策略更新稳定性,MAPPO 采用剪切的信任域目标函数:
其中 为优势函数估计。优势通过 广义优势估计(GAE)计算:
动作约束:“ 规则”将订货量限定为 ,其中 为当期收到的订单(下游订单 ),而 为可调偏移。该规则在最优策略呈基地存货形式时可有效缩小动作空间,但当最优策略未知时可能限制策略探索。
3.2.2 神经网络结构
作者设计的网络包含一个带 ReLU 激活的全连接层(64 单元)、一个 GRU 层(64 单元)和一个线性层。行动者输出通过 Softmax 转化为概率分布,从中采样订货动作。
3.3 领域随机化 (Domain Randomization)
强化学习在仿真环境中训练,但现实环境参数(需求分布、提前期)往往未知。领域随机化通过随机化环境参数以提升策略泛化能力。
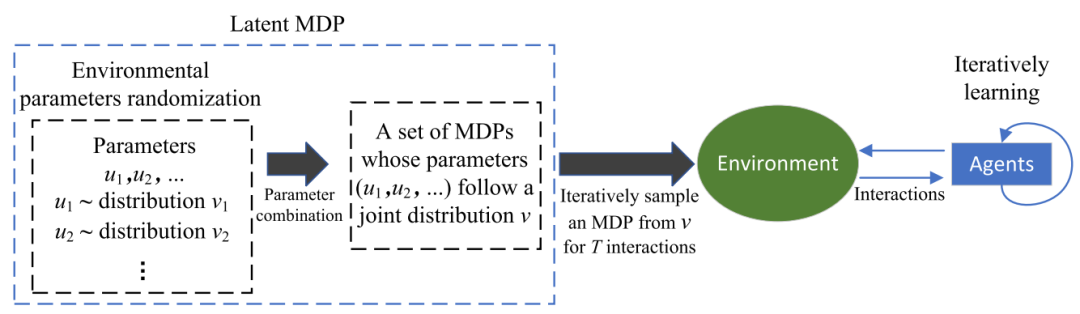
LMDP 表述:随机化后的环境集合 形成一个 潜在马尔可夫决策过程。每次训练从 中随机选择 MDP ,求解最优历史依赖策略:
DR-MADRL 算法流程:在每个训练回合中,按照随机化分布 采样环境参数;在随机生成的环境中收集轨迹、更新策略。伪代码见 Algorithm 2。
下面的图展示了领域随机化框架:
四、实验设计与结果分析
4.1 实验设置
作者在四种经典啤酒游戏场景下比较 MADRL 与基准策略:
基本案例:需求服从 ,动作空间 。 正态案例:需求服从 ,动作空间 。 均匀案例:需求服从 ,动作空间 。 冲击案例:需求前四期为 4,之后为 8,动作空间 。
对应成本系数、提前期和基地存货水平见表 3 和表 4。训练采用 100 个并行环境、总步数 1000 万,折扣因子 0.99 等超参数。
4.2 训练表现与对比结果
训练曲线如图 3 所示,四个案例的总成本随着训练步数迅速下降,显示出良好的收敛性。
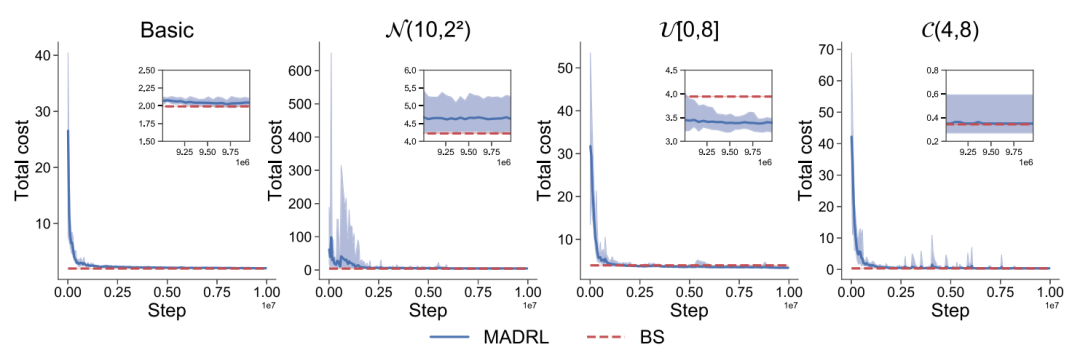
表 6 报告了 MADRL、基地存货(BS)、SRDQN 和 MILP 等策略在四种案例中的平均成本及方差,括号为 95% 置信区间。主要发现:
在 基本案例 和 正态案例 中,MADRL 的平均成本接近最优 BS 策略,最佳策略几乎达到基准水平,而 MILP 成本最高。 在 均匀案例 和 冲击案例 中,MADRL 显著优于 BS 策略。均匀案例的平均成本降低 13.96%,最佳策略降低 18.53%;在冲击案例中,最佳 MADRL 成本低于 BS 策略 20.59%,接近不可实现的 Oracle 策略。
4.3 策略行为分析与启发式政策
作者分析了 MADRL 策略的行为特征,用以解释为什么模型优越并提出启发式政策。
4.3.1 正态案例:基地存货结构
下图展示正态案例下各阶段的订货量和订货上限(OUTL)轨迹。
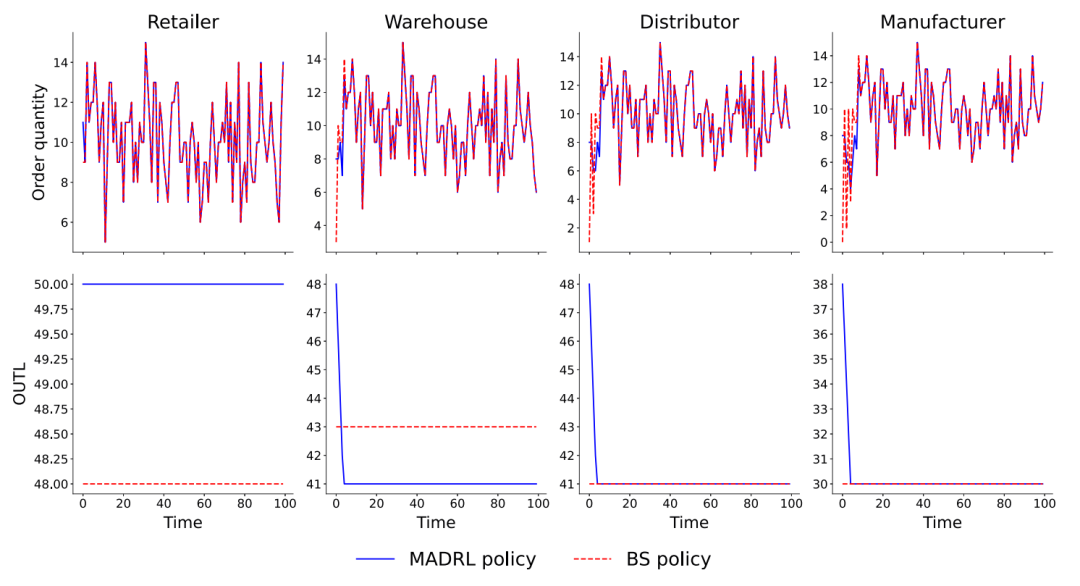
可以看到,除了初期,代理学会了与基地存货相似的结构,OUTL 稳定在 [50, 41, 41, 30] 附近。表明 MADRL 能在数据驱动下逼近解析最优的基地存货策略。
4.3.2 均匀案例:团队协作与启发式规则
图 5 为均匀案例中各阶段的订货量、在途库存(OO)、库存水平(IL)、订货上限(OUTL)和到货订单(AO)轨迹。
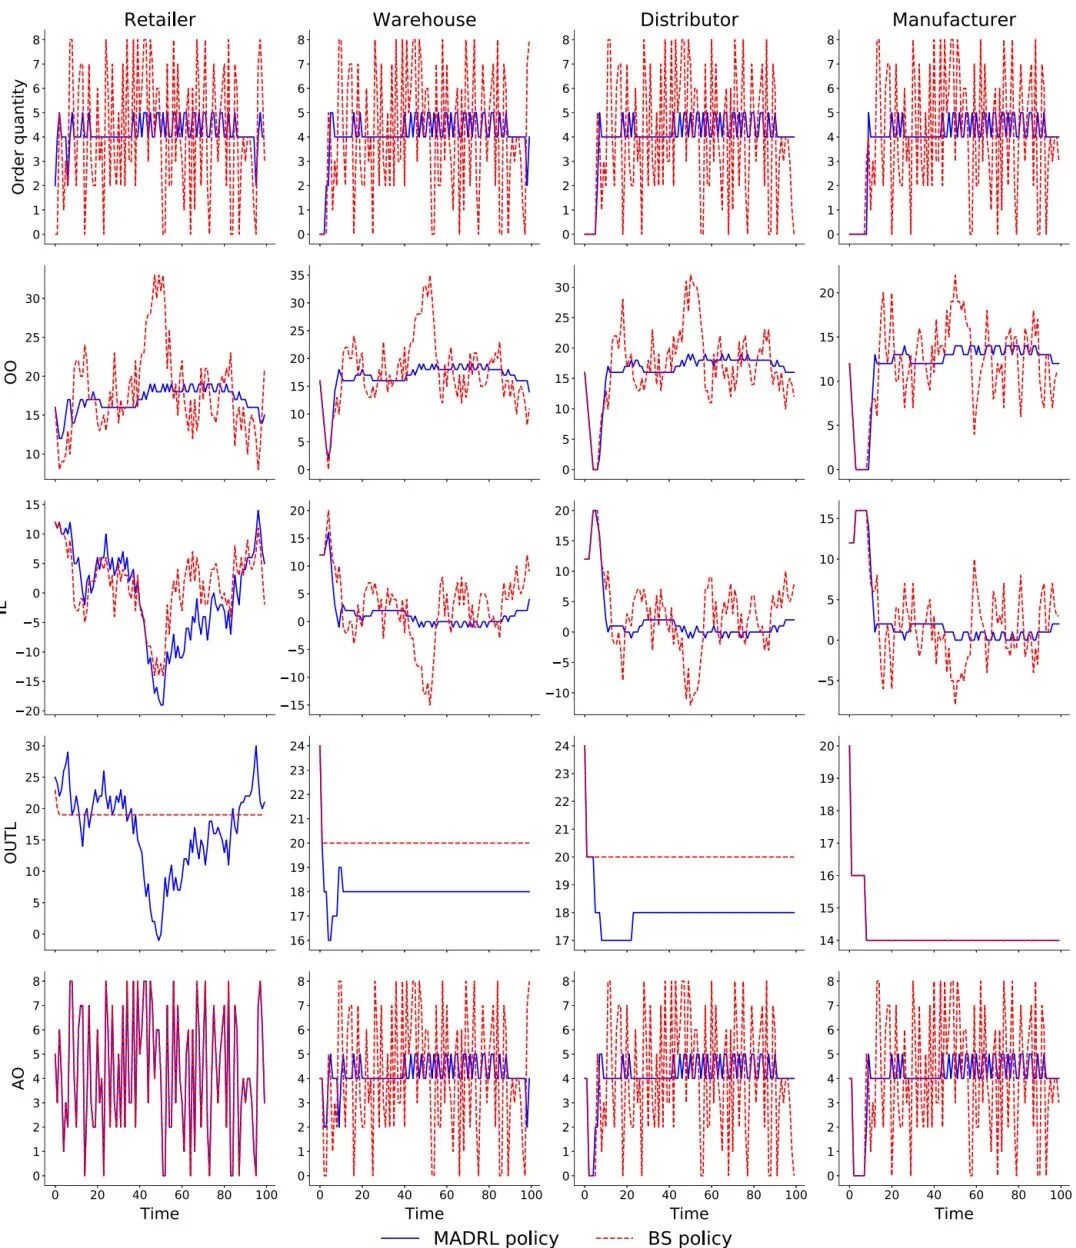
观察发现:
各阶段协同订货,订货量约为 4 单位,即需求均值。 仓库、分销商和制造商的 OUTL 曲线表现为基地存货水平 [18, 18, 14],而零售商更保守。 随着时间推移,OO 和 IL 曲线趋于稳定,表明各阶段承担的库存风险不同。
基于此,作者提出一种 启发式策略:上游三阶段采用基地存货水平 [18, 18, 14],零售商根据 OUTL 和库存水平采用动态订货规则。该策略在 500 组实验中的平均成本为 3.07,较 BS 策略下降 22.7%,体现了 MADRL 在未知最优策略情景下为策略设计提供了洞见。
4.4 领域随机化实验:鲁棒性分析
为评估 DR-MADRL 的鲁棒性,作者使用一组真实销售数据(Kaggle 数据集),选取某商品 2013–2017 年每日销量(图 6),统计均值和方差。
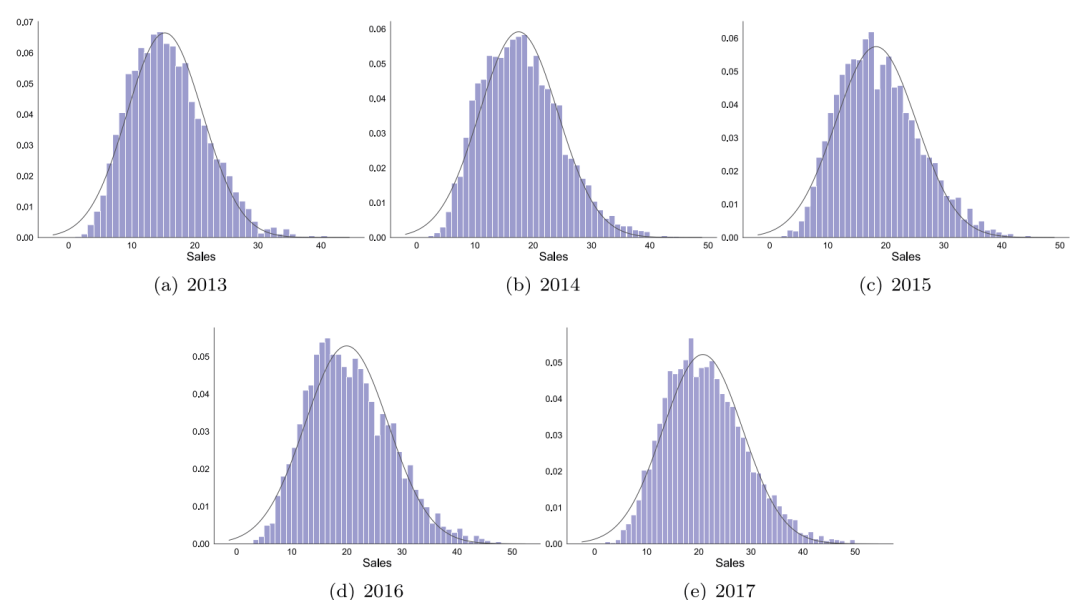
实验设定从理想环境出发(需求服从 ,BS 水平 [83, 69, 68, 45]),在训练阶段随机化需求均值、方差以及提前期偏差,随机范围见表 7。测试阶段分别考虑需求变化、提前期变化以及两者同时变化。
4.4.1 需求分布变化
图 7 展示了在不同需求均值或方差环境中各策略的总成本。
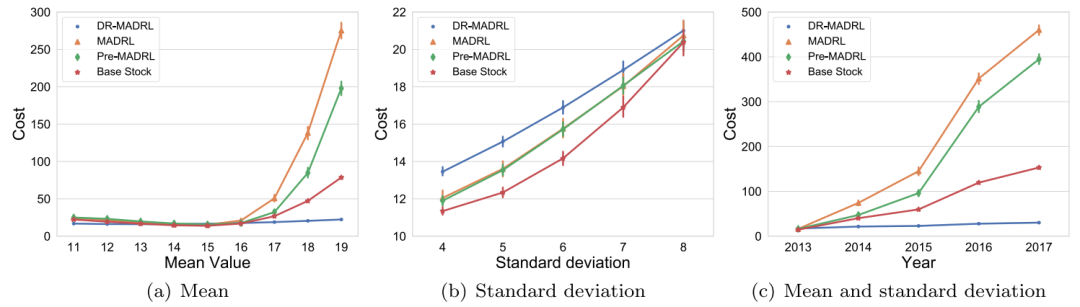
关键发现:
MADRL 和 BS 策略在需求均值增加时成本迅速上升,DR-MADRL 在全范围内保持稳定。 需求方差增大对成本影响较小,主要误差来源于有限的仿真长度。 将策略应用于 2013–2017 年真实需求数据时,MADRL 和 BS 的成本分别增长到 452.15 和 152.10,而 DR-MADRL 保持在 [16.84, 29.40]。
4.4.2 提前期与需求同时变化
图 8 绘制了提前期变化(a)以及提前期与需求共同变化(b)情况下的成本。
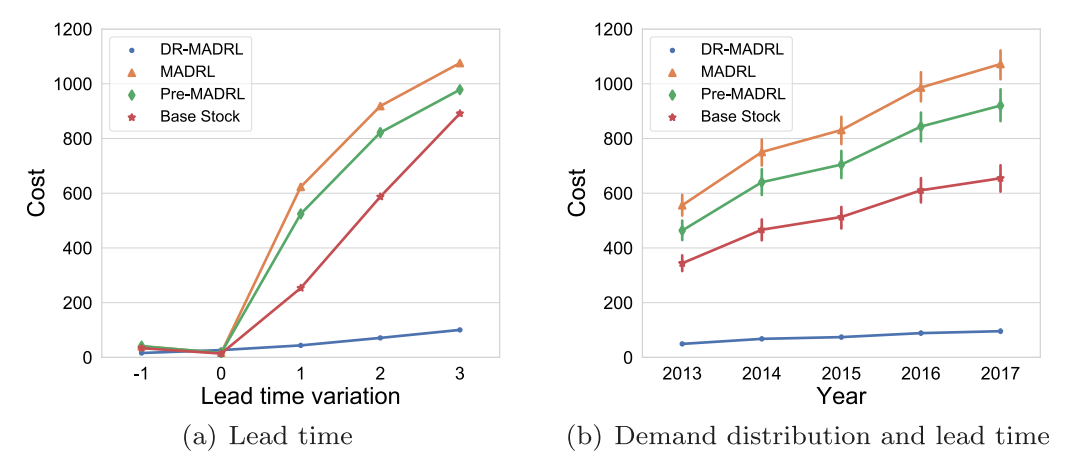
当提前期增加时,MADRL 和 BS 策略成本快速上升,而 DR-MADRL 增幅有限。 在提前期和需求分布同时变化的复杂环境下,DR-MADRL 的平均成本保持在 49.28–95.71 范围内,远低于其它策略。
这些结果表明领域随机化能够显著增强策略的泛化能力,即使在与训练环境差异较大的真实环境中,也能维持较低成本。
五、管理启示与局限
5.1 管理启示
作者总结了以下实践建议:
策略发现工具:MADRL 可用于发现或逼近最优补货策略。当最优政策已知时,MADRL 能逼近基地存货形式;当最优未知时,它可辅助开发有效的启发式政策。 动作空间设计重要:在已知最佳策略为基地存货时,采用 “ 规则” 可以提高学习效率;但在最优策略未知或不呈基地存货形式的情况下,应直接优化订货量。 鲁棒性要求:实际应用中,采用领域随机化提升策略对需求和提前期不确定性的鲁棒性。DR-MADRL 在理想环境下略有性能损失,但在偏差环境中表现更稳定。
5.2 局限与未来研究
本文仅研究串行供应链。未来可扩展至树状或网络结构,需调整观察与动作空间。 随着参与者数量增加,Dec‑POMDP 的状态与动作空间呈指数增长,CTDE 框架计算成本高。未来应探索完全分布式的学习算法。
六、结论与展望
本文将多层级库存优化问题建模为 Dec‑POMDP,通过 MAPPO 提供去中心化深度强化学习解法,并引入 领域随机化 提升策略的鲁棒性。数值实验表明,MADRL 在已知最优政策下可逼近基地存货策略,在未知情形下显著优于现有启发式方法;领域随机化在需求和提前期发生偏差时表现出较强的适应性和泛化性。这些成果为基于强化学习的供应链管理提供了新的视角。未来研究可探索更复杂网络拓扑、分布式学习框架以及与实际企业系统的结合。
文章须知
推文编辑:单子叶
责任编辑:弓仪长
原文链接:https://doi.org/10.1016/j.tre.2025.104367
忽略之前的


