基于截断扩散模型的实时端到端自动驾驶解决方案:DiffusionDrive的技术解析与实验结果
原文源代码链接见文末
一、研究背景与问题
1.1 端到端自动驾驶的挑战
端到端自动驾驶系统直接从传感器输入预测车辆未来轨迹,是近年来自动驾驶研究的重要方向。这类系统比基于规则或规划字典的传统方法更具灵活性,但也带来了一系列挑战:
复杂场景与多模态行为:真实道路中的驾驶行为并非单一模式,而是具有高度多样性(例如直行、左转、右转、并道等)。现有的一些端到端规划器往往只能回归单一的轨迹或从有限的轨迹词典中采样,难以覆盖复杂驾驶模式。 扩散模型在机器人决策的局限:近年扩散模型因能够刻画多模态分布而引入机器人决策领域,但直接将标准扩散模型用于自动驾驶会面临大量去噪步骤(20 步左右),导致推理速度慢,不适合实时驾驶。 模式坍塌(mode collapse)问题:标准扩散模型采样的噪声在去噪过程中易收敛到相似的轨迹,生成的多样性不足。
1.2 现有方法局限
论文将现有端到端方法按照生成策略分为四类,如图1所示。传统的单模回归方法利用MLP直接生成一条轨迹;从轨迹词典采样的方法利用有限的大字典,每次从其中选择轨迹;标准扩散策略通过对高斯噪声逐步去噪生成多模态轨迹,但速度较慢;而论文提出的截断扩散策略则通过嵌入先验并截断去噪步骤提升效率和多样性。
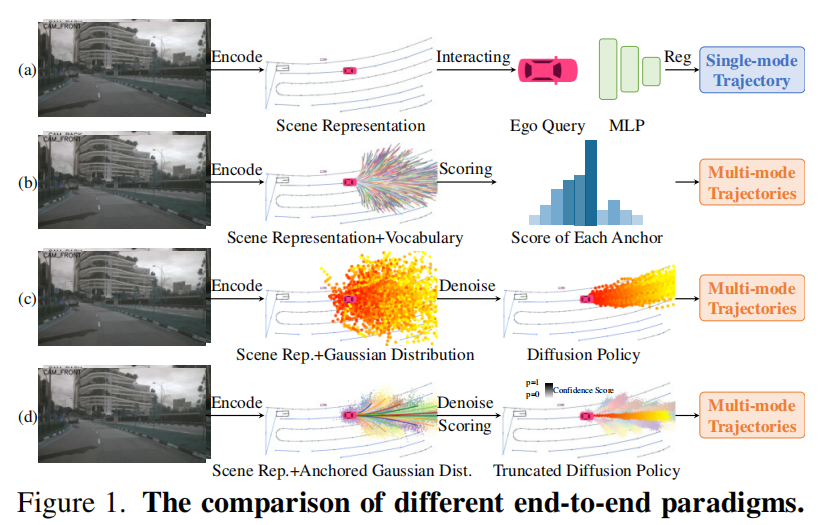
图1 取自论文图1,展示了单模回归、有限词典采样、标准扩散策略和论文提出的截断扩散策略的对比。
二、DiffusionDrive的核心思想
论文提出了一种截断扩散模型 DiffusionDrive,通过两项关键创新解决上述问题:
截断扩散策略(Truncated Diffusion Policy):以人类驾驶的固定模式为启发,引入多模态先验 anchor 轨迹,利用“Anchored Gaussian Distribution”作为扩散的起点,并截断扩散调度,仅需很少的去噪步骤即可生成高质量轨迹。 高效级联扩散解码器(Cascade Diffusion Decoder):设计了基于Transformer的解码器,使用空间交互和时间步调制,使条件场景信息更有效融入去噪过程,并通过级联机制逐步细化轨迹。
2.1 截断扩散策略
2.1.1 条件扩散模型预备知识
给定轨迹序列 ,标准条件扩散模型定义前向扩散过程为:在第 步,将干净轨迹 加噪得到 ,其分布为正态分布
其中 表示噪声调度系数。逆过程使用参数化网络 逐步去噪,最终得到重建轨迹 ,其生成分布为
其中 为条件信息,例如感知特征。
2.1.2 Anchored Gaussian Distribution 与截断扩散
标准扩散模型从纯高斯噪声开始逐步去噪,不同噪声样本会在迭代后趋同,导致模式坍塌。为避免这一问题,论文提出使用 Anchored Gaussian Distribution:首先对训练集轨迹进行 K-means 聚类得到 个 anchor ;然后从以 anchor 为均值、方差与扩散噪声调度相同的高斯分布中采样初始噪声 :
其中 表示训练时截断的扩散步数。由于起点更接近真实轨迹,多模态表达能力增强,且不需要过大固定字典。
随后在训练过程中,模型只执行 步扩散(例如20 步),而在推理时只需 2 步去噪即可得到高质量轨迹。这在带有 ResNet-34 backbone 的情况下,使去噪步骤从20步减少到2步,推理速度提升10倍。
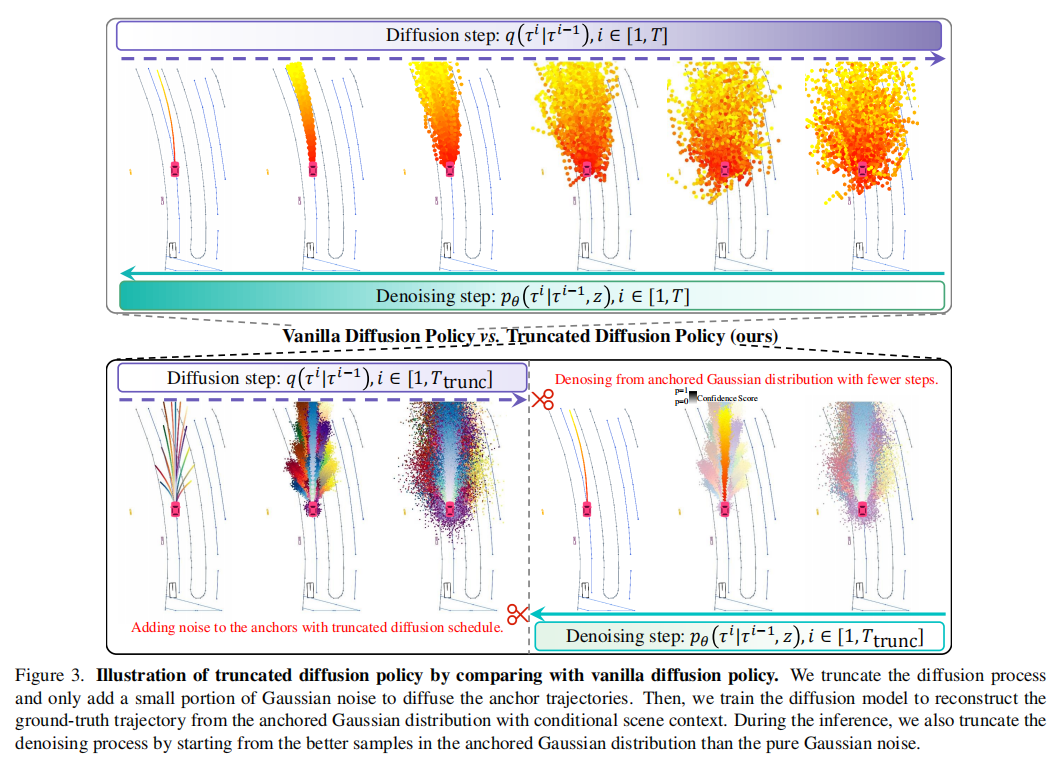
图3 由论文图3截取,展示了Anchored Gaussian Distribution抽样并融入多模态轨迹的示意。
2.1.3 模型训练与目标函数
对于每个 anchor,对应的 noisy trajectory 输入条件扩散解码器,网络 输出 denoised trajectory 和分类置信度 (越靠近真实轨迹得分越高)。论文将最接近 ground truth 的轨迹标为正样本,其余作为负样本,联合重建损失和二元交叉熵损失训练网络:
其中 为正样本, 权衡重建与分类损失。
2.2 高效级联扩散解码器
文章设计了一个基于 Transformer 的 diffusion decoder,其整体架构见图4(a),由两部分组成:感知模块和扩散解码器。感知模块可以使用现有的视觉/激光感知网络输出特征图。在扩散解码器中,作者提出以下技术:
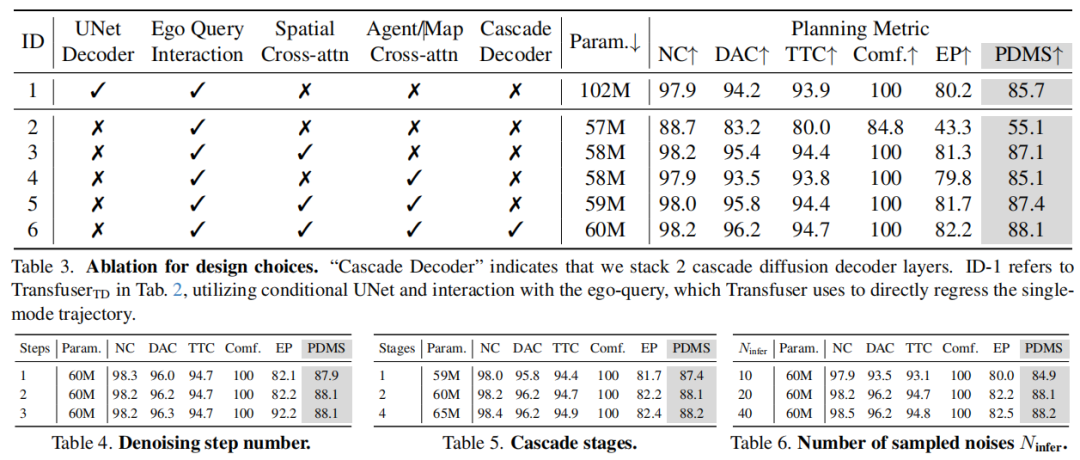
空间跨注意力(Spatial Cross-Attention):利用 deformable cross-attention,在 BEV/PV 特征与轨迹查询之间建模细粒度关联,以便准确捕捉周围环境和地图约束。 Agent/Map Cross-Attention:以车道边界和动态目标为单位,进一步聚合 agent 与环境的交互。 时间步调制(Timestep Modulation)层:通过将扩散时间步编码并调制网络,使模型更好地区分不同去噪阶段。 级联机制:堆叠两层 diffusion decoder,将上一步的输出作为下一层输入,从 coarse 到 fine 逐步细化轨迹。文章表明增加到两层可显著提升规划质量,而更多层带来较大开销。
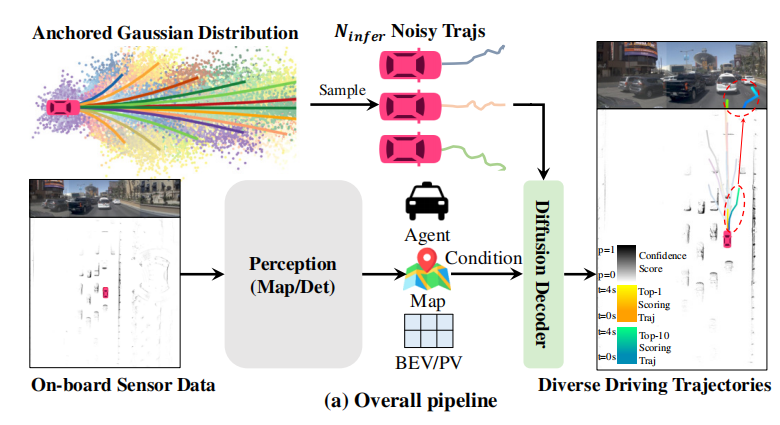
图4a 取自论文图4 (a),展示DiffusionDrive整体管线:从传感器感知模块提取特征,利用 Anchored Gaussian Distribution 采样的噪声轨迹输入扩散解码器,最后生成高质量多模态轨迹。
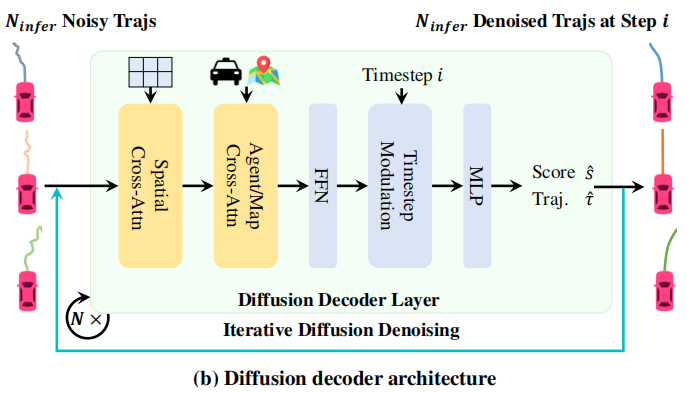
图4b 取自论文图4 (b),展示级联扩散解码器的内部结构。包含空间跨注意力、Agent/Map跨注意力、前馈网络(FFN)、时间步调制层和MLP头,用以预测轨迹评分和微调偏差。
三、难点分析及解决方法
3.1 模式坍塌与多样性不足
难点:标准扩散模型在去噪过程中由于从纯高斯噪声开始,多个噪声样本最终趋向相似轨迹,导致模式坍塌,缺乏多样性。作者通过定义 模式多样性分数 来定量度量这一现象:
其中 为第 条去噪轨迹,N 为采样轨迹数。 越大表明多样性越好。
解决:通过 Anchored Gaussian Distribution 和截断扩散,从 anchor 轨迹附近出发,噪声样本更能覆盖多模态分布;同时在训练中添加 anchor 分类标签,引导模型生成更分散的轨迹,从而大幅提升 分数。
3.2 推理效率与实时要求
难点:标准扩散策略需要20步以上的去噪,推理过程耗时,难以满足实时自动驾驶应用。
解决:截断扩散将训练时的去噪步数截断为20步左右,推理阶段只需2步。论文在 Table 2 中统计了从 Transfuser 到 DiffusionDrive 的路标(roadmap)变化:TransfuserDP(使用vanilla扩散)需要20步去噪,FPS从60下降至7;而加入截断扩散后,TransfuserTD 在改进 PDMS 的同时把步数缩减到2步,整体运行时间下降6倍。最终DiffusionDrive 仅用2步去噪即可实现 45 FPS 的实时性能。
3.3 大词典方法的计算开销
难点:像 VAD V2 – V8192 等基于大词典的采样方法会预定义8192条 anchor 轨迹,虽然能够生成多模轨迹,但计算量大,难以扩展到实时系统。作者指出该方法在复杂场景下仍存在 out‑of‑vocabulary 轨迹问题。
解决:DiffusionDrive 仅需要20个 anchor,通过截断扩散和分类损失学习将 anchor 视为先验,并允许模型在推理阶段动态调整采样数 ,根据硬件或场景需要决定采样轨迹数量。这种灵活性使得 DiffusionDrive 能够在保证多样性的同时控制计算开销。
四、实验与结果分析
4.1 实验设置
数据集:主要在 NAVSIM 数据集上进行规划和闭环评估。NAVSIM 使用开源场景并提供高分辨率地图和激光点云,同时引入 PDMS(Planning Driven Metric Score) 作为综合指标。同时在 nuScenes 数据集 ST-P3 设置下进行开放循环评估。 基线:使用 Transfuser 感知模块和 ResNet‑34 backbone 作为基线;与 UniAD、VADv2‑V8192 以及 Hydra‑MDP 等方法比较。 实现细节:训练100个 epoch,采用 AdamW 优化器,批次大小512,学习率 6e‑4;训练时扩散步数截断为20步,推理时2步;级联解码器层数为2。
4.2 闭环规划性能
根据论文表 1~2 的比较,DiffusionDrive 在 NAVSIM navtest 拆分上取得 88.1 PDMS 和 74% 的模式多样性得分 D。相较于转化后的 TransfuserDP(vanilla 扩散)提高了 3.5 PDMS 和 64% 的多样性分数,同时将去噪步数从20降至2步,FPS 加速约6倍。
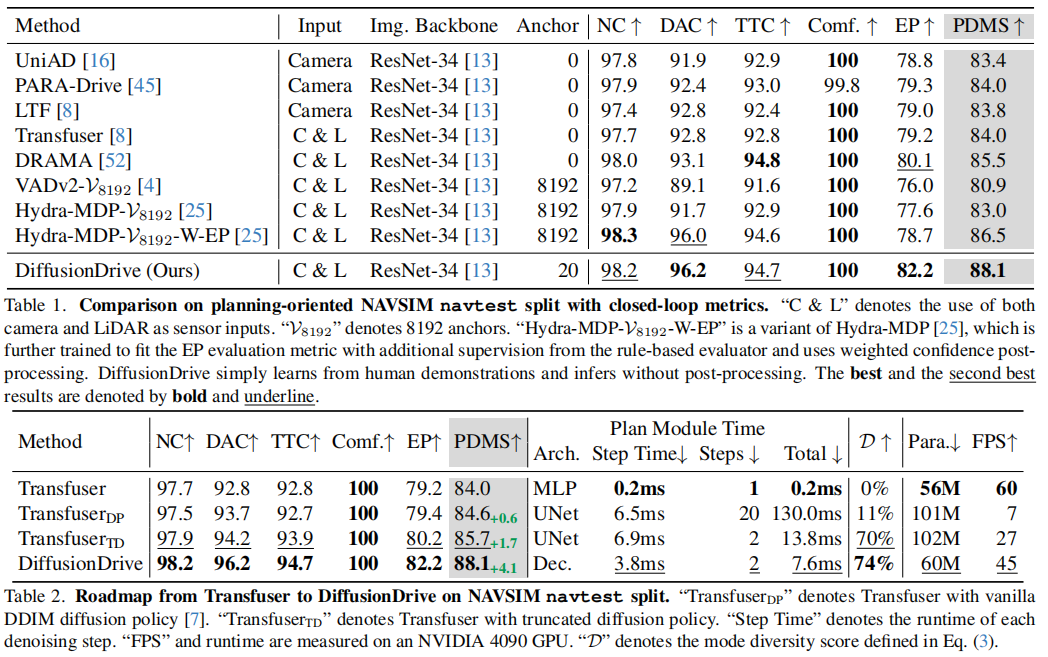
将 Transfuser 逐步改造成 DiffusionDrive 的过程(从 deterministic 回归 → vanilla 扩散 → 截断扩散 → 级联解码)表明:vanilla 扩散能提升 PDMS 和多样性,但代价是运行时间大幅下降;加入截断扩散显著降低去噪步数,并进一步提升性能;级联解码则在不显著增加参数的情况下提升 2.4 PDMS。
4.3 与基于字典的规划方法比较
与 VADv2-V8192-W-EP 比较:DiffusionDrive 在使用相同感知模块且无需额外监督和后处理的情况下,以仅20个 anchor 实现更高的 PDMS 分数和多样性分数。 与 Hydra‑MDP-V8192-W-EP 比较:虽然 Hydra‑MDP 通过评分机制提升 EP 分数,但 DiffusionDrive 仍在 PDMS、EP 等指标上领先。
4.4 在 nuScenes 数据集上的开放循环评估
在 nuScenes 数据集 ST-P3 (nuScenes Planning Task) 下,DiffusionDrive 将图像作为输入并使用截断扩散、级联解码,获得平均 L2 误差 0.27 m、碰撞率 0.54%,PDMS 8.2 分,在不使用 LiDAR 情况下超过众多方法。相比 SparseDrive,其平均 L2 误差降低 0.04 m,碰撞率降低 59%,同时运行速度快 59%;相比 VAD 提高了 20.8% 的 L2 精度和 63.6% 的碰撞率表现,并且运行速度提高 1.8 倍。
4.5 消融实验
论文还进行了大量消融分析:
去噪步数:Table 4 显示不同去噪步数对指标影响。1 步时 PDMS 和多样性较低;2 步大幅提升并接近 3 步;3 步以上提升不明显但开销增大。因此作者选择 2 步以平衡速度与质量。 级联层数:Table 5 比较不同级联解码器层数(N Infer等)。两个级联层最优;更多层在开销大幅增加的情况下性能提升有限。 采样噪声数量:Table 6 研究采样轨迹数对性能的影响。增加采样数量可略微提升 PDMS,但计算量也增加;因此实际部署可根据硬件资源动态调整。
五、结论与展望
论文针对端到端自动驾驶领域中多模态轨迹生成与实时推理的难题,提出了DiffusionDrive框架,其主要贡献包括:
首个将截断扩散模型引入实时端到端自动驾驶。通过 Anchored Gaussian Distribution 和截断扩散策略,摆脱了庞大词典依赖,并显著减少去噪步数。 设计高效级联扩散解码器,使用跨注意力和时间步调制,有效融合场景条件信息,并通过级联细化提升轨迹质量。 优异的规划性能和实时性:在 NAVSIM 数据集上创下新的 PDMS 记录 88.1 分,并在 nuScenes ST-P3 设置上实现更低的 L2 误差和碰撞率,比 VAD 等强基线更快、更安全。 灵活的推理配置:可根据计算资源调整去噪步数和采样数量,实现速度‑质量权衡。
DiffusionDrive 充分发挥了扩散模型的多模态生成能力,通过引入人类驾驶先验和高效解码策略解决了扩散模型在自动驾驶领域的模式坍塌和实时性问题。未来工作可以探索将更高级的语义信息或语音指令与截断扩散结合,提升自动驾驶系统的可解释性与交互性,同时进一步研究在更复杂场景(例如复杂交通规则、混合交通环境)下的泛化能力。


