链上镖师 / Chain Biaoshi
TRC|固定站与移动卡车协同配送:从全局优化专家轨迹到强化学习实时调度
混合配送架构结合MIP、行为克隆与TD3,在九类网络压力场景中实现约2毫秒级决策
论文构建固定无人机站、移动卡车与补给卡车协同的末端配送系统,先用全时域MIP生成专家轨迹,再通过行为克隆和TD3强化学习形成可适应动态订单的分布式决策策略。
- 01:固定站覆盖需求密集的核心区域,移动卡车动态服务外围区域和站点溢出订单。
- 02:实验覆盖稀疏、中等、密集三种网络与三档订单压力,共九类环境配置。
- 03:TD3-Finetuned平均订单完成率达到79.25%,单步推理时间约为2毫秒。
固定站与移动卡车如何共同接住波动订单
末端无人机配送面临明显的空间差异:核心区域订单密集,固定站可以依靠专属无人机和库存快速响应;外围区域需求分散,移动卡车需要沿道路网络重新定位并派出无人机。论文将两类单元纳入同一架构,并设置补给卡车连接仓库、固定站和移动卡车,形成持续补货与动态覆盖机制。
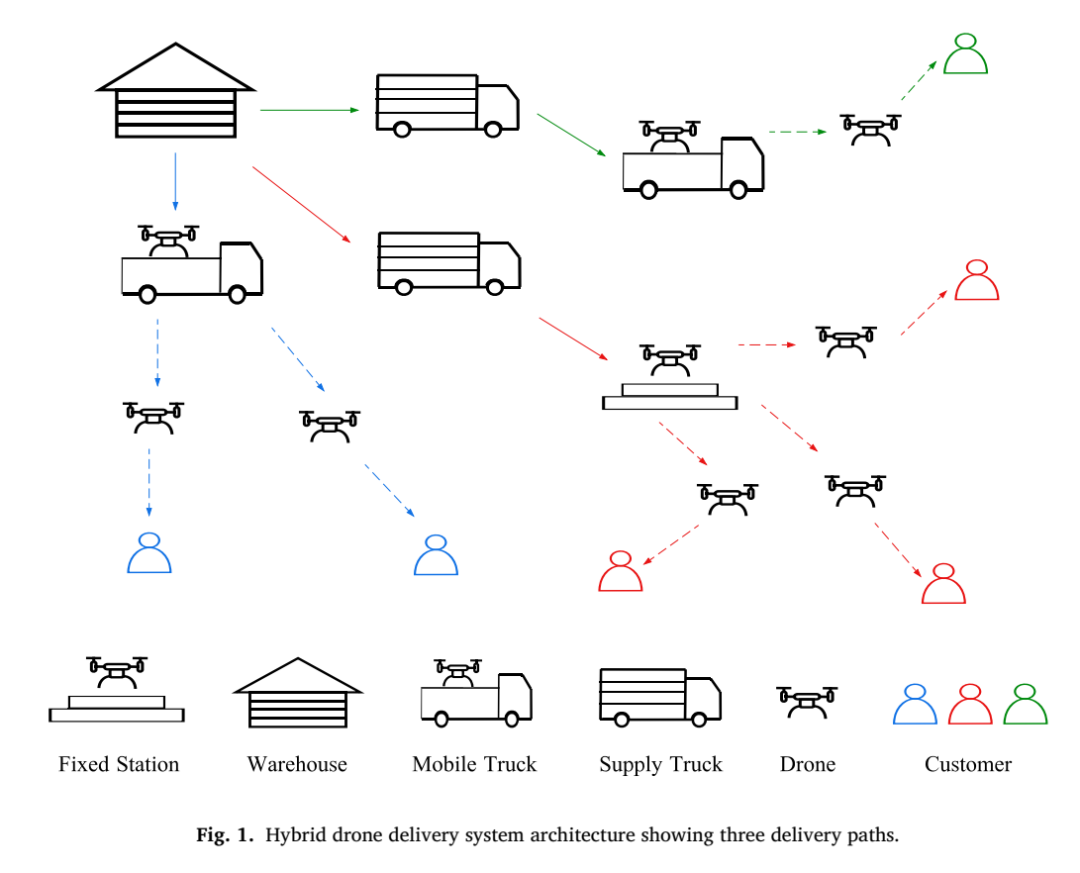
混合无人机配送系统架构与三类配送路径(来源:Fig. 1)
三条配送路径对应三类资源边界
系统包含三条互补路径。固定站在服务半径内直接配送,仓库通过补给卡车定期补充站点库存;移动卡车在外围区域移动,并在自身服务半径内派出无人机;靠近仓库的移动卡车可以直接装载货物并自主执行配送。订单进入固定站与移动卡车的重叠服务区时,资源分配、无人机可用数量、库存和移动路径需要同时协调。
01固定站:关注库存、可用无人机、订单队列和当前任务。
02移动卡车:关注位置、移动状态、无人机数量、订单队列和燃料。
03补给卡车:关注位置、运动状态、服务对象和货物载荷。
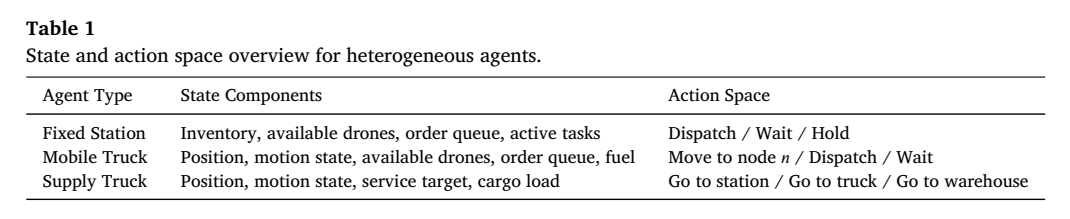
异构智能体状态与动作空间概览(来源:Table 1)
从订单分配到路径连续性的统一建模
论文把系统表示为多智能体马尔可夫决策过程,目标是在整个运营周期内最大化订单收入与运营成本之差。约束覆盖无人机、库存和货物容量,订单服务半径,智能体资源可用性,以及订单时间窗和卡车路径连续性。决策周期设为15分钟,订单按照泊松过程动态到达,模型需要在有限资源下平衡完成订单、等待时间、移动成本和未配送惩罚。
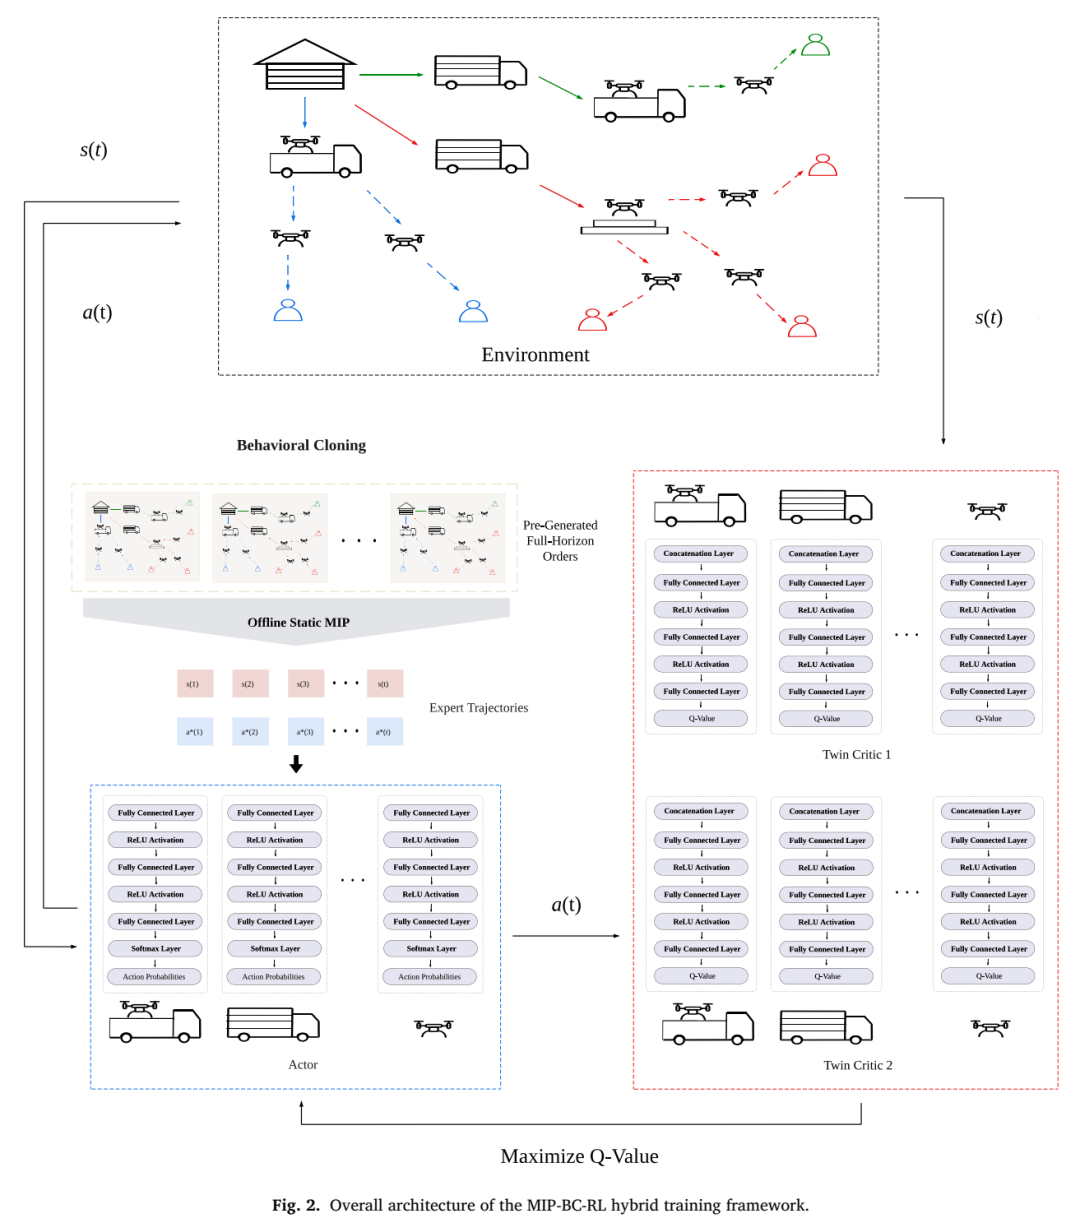
MIP-BC-RL混合训练框架总体架构(来源:Fig. 2)
把全时域最优解变成在线策略
方法分为三个阶段。第一阶段使用完整订单时间 horizon 的静态MIP求解全局协调方案,输出每个时间步的状态—动作专家轨迹。第二阶段用行为克隆学习固定站、移动卡车和补给卡车的初始策略,将集中式优化结果转化为分布式神经网络决策。第三阶段以行为克隆参数作为初始化,通过TD3与环境交互,在动态订单分布中继续优化长期收益。
1MIP:利用完整时间范围订单信息生成全局专家轨迹。
2BC:从专家状态—动作样本学习各类智能体的初始策略。
3TD3:通过经验回放、双评论家和延迟更新完成在线微调。
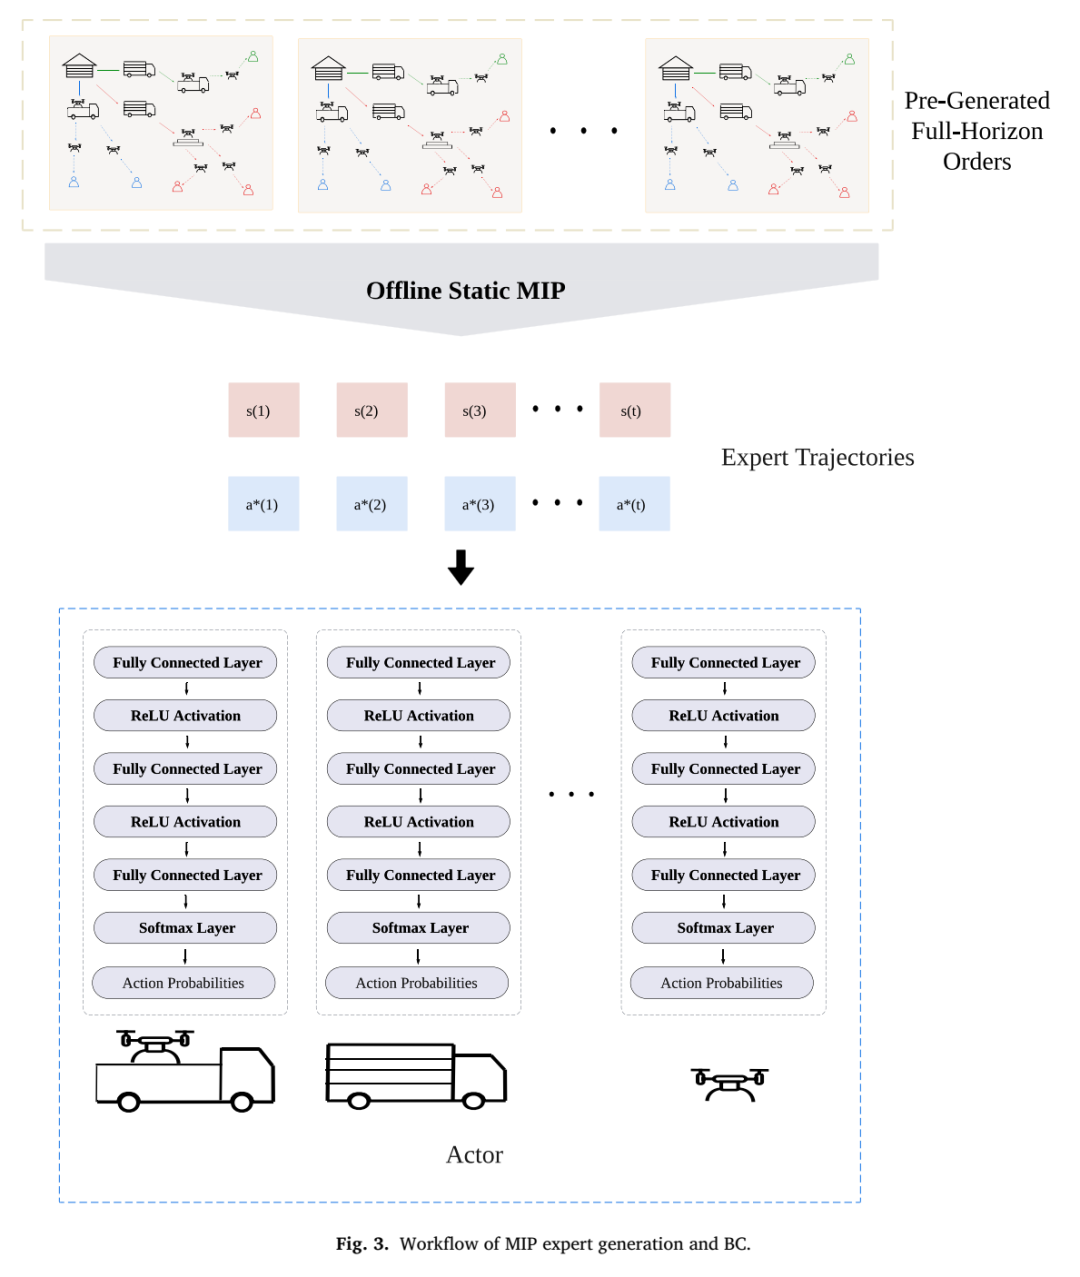
MIP专家轨迹生成与行为克隆流程(来源:Fig. 3)
九类网络压力场景检验策略迁移能力
实验在15公里乘15公里的城市配送区域展开,配置2个固定无人机站、3辆移动卡车和1辆补给卡车。每个固定站配备8架无人机,每辆移动卡车配备4架无人机,运营时间为8:00至20:00,共48个决策步。场景组合覆盖100、225和400个网络节点,以及低、中、高三档订单压力,单回合观测订单量约为306.1至387.1单。
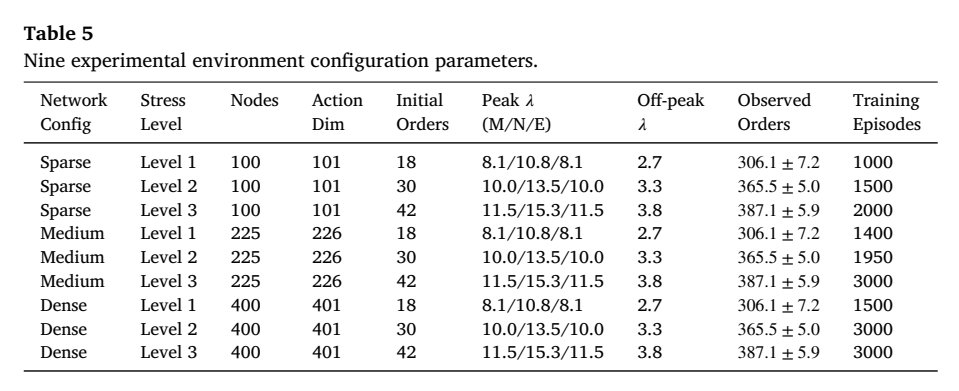
九类实验环境配置参数(来源:Table 5)
TD3微调同时改善完成率与实时性
综合结果显示,TD3-Finetuned在稀疏、中等和密集网络中的完成率分别为87.97%、78.82%和70.95%,总体完成率为79.25%±9.02%。与Rolling Horizon MIP的68.9%总体完成率相比,平均提升10.3个百分点。其单步推理时间约为2毫秒,Rolling Horizon MIP的单步求解时间为7.7×10⁴至1.7×10⁵毫秒,实时决策延迟降低约38,500至85,000倍。
总体完成率
79.25%±9.02%
单步推理时间
约2 ms
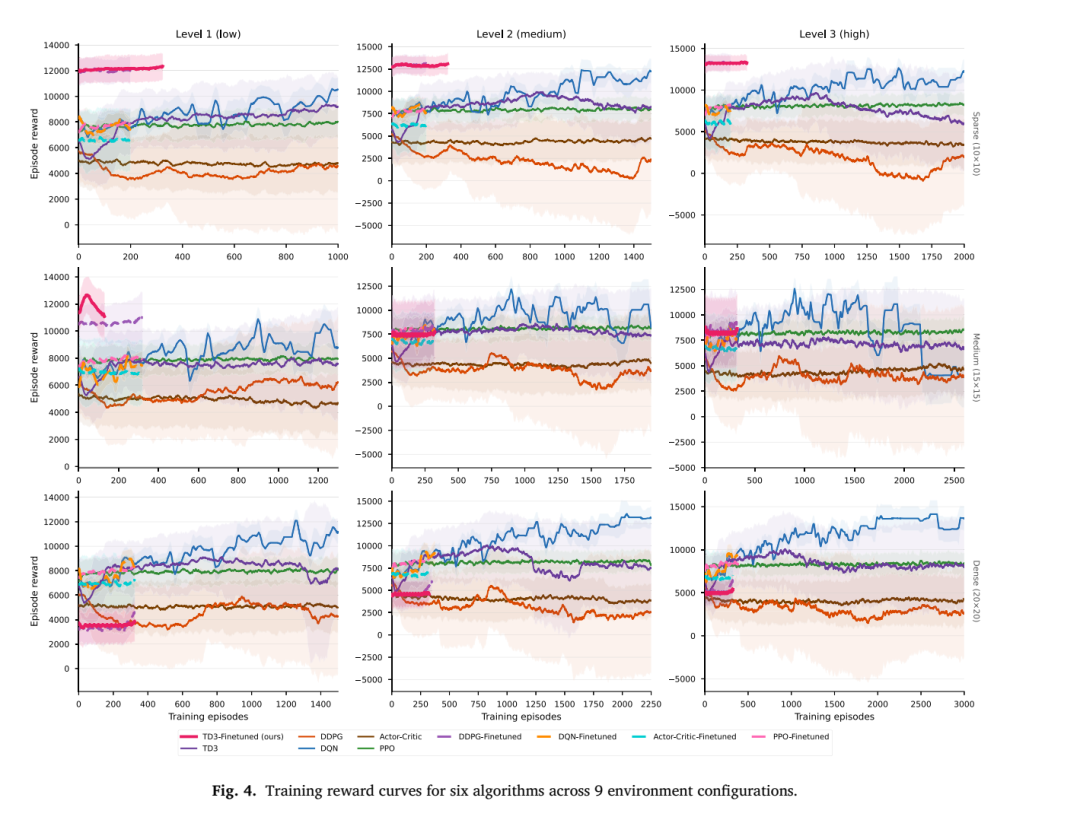
六种算法在九类环境配置中的训练奖励曲线(来源:Fig. 4)
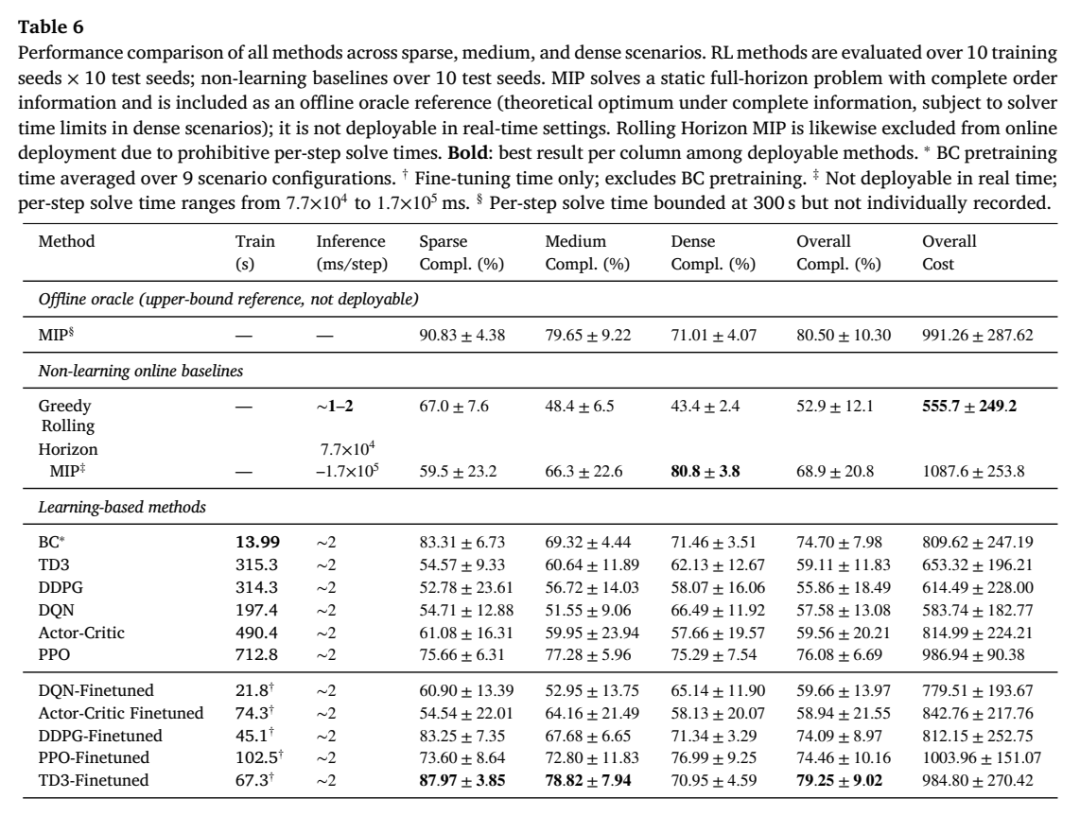
稀疏、中等与密集场景下各方法性能比较(来源:Table 6)
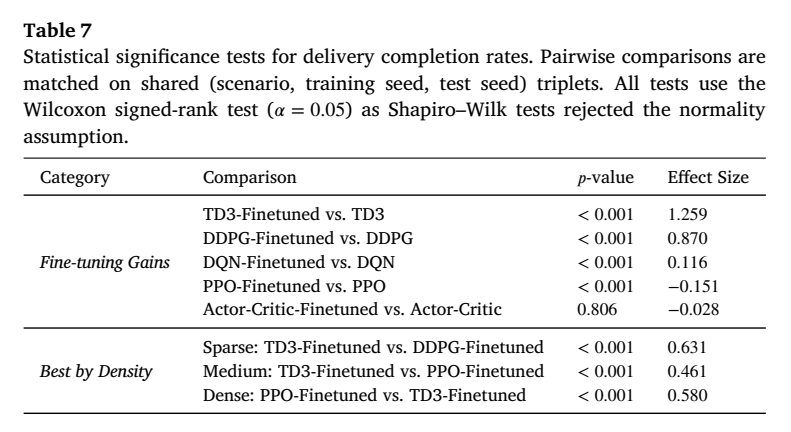
配送完成率统计显著性检验结果(来源:Table 7)
成本参数与学习率决定模型适用条件
附录敏感性分析显示,TD3-Finetuned在无人机成本和卡车成本参数变化下仍需结合完成率与运营成本共同判断部署方案。学习率实验比较了1×10⁻⁵、3×10⁻⁵、1×10⁻⁴和3×10⁻⁴四档设置,DQN、Actor-Critic和TD3的完成率变化低于5个百分点;PPO和DDPG对学习率更敏感,主实验采用的3×10⁻⁵共享学习率表现出更稳健的跨算法收敛特征。
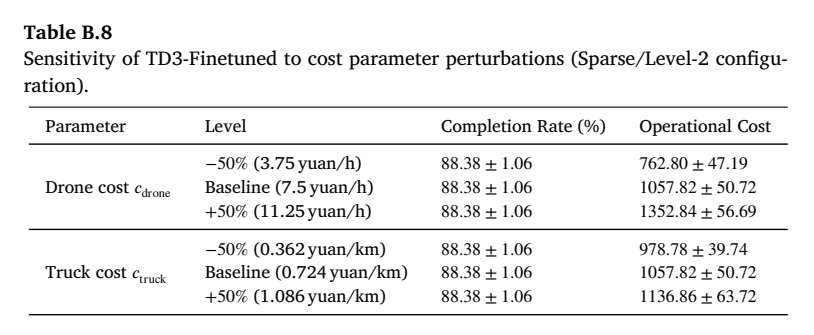
TD3-Finetuned成本参数扰动敏感性(来源:Table B.8)
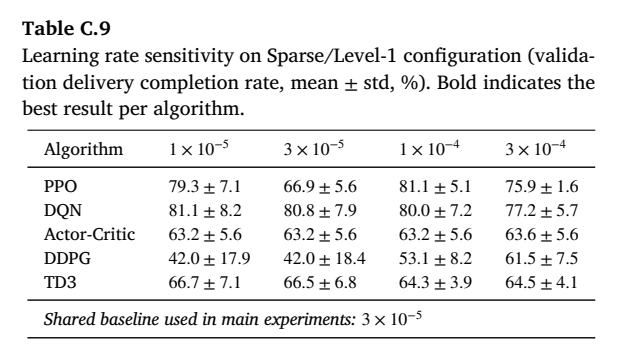
稀疏一级配置下的学习率敏感性分析(来源:Table C.9)
论文当前证据来自仿真环境,场景包含规则化网络、动态订单和既定成本参数。作者提出的后续方向包括天气变化、动态空域限制、需求预测、真实试点、非规则网络拓扑和DAgger式迭代标注。论文未报告真实运营数据下的部署效果,模型外推需要满足相近的资源配置、订单机制、服务半径和时间窗条件。
论文:Coordinated drone delivery via hybrid training: From optimization to reinforcement learning
作者:Lizhi Bi,Bin Shuai,Zhanru Liu,Yichen Sun
期刊:Transportation Research Part C
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


