链上镖师 / Chain Biaoshi
TRC|港口拖运卡车能源策略:多智能体强化学习协调电动、氢能与混合动力选择
COMA如何在动态能源价格与充换能设施排队约束下改善港口车队运营
论文将港口拖运卡车的电池电动、氢燃料电池和柴油电动混合动力选择建模为共享设施约束下的协同决策问题,并用COMA多智能体强化学习协调车队能源策略。
- 01:COMA平均奖励为-0.532,奖励标准差为0.359,三种算法中表现最稳定。
- 02:COMA将平均等待时间降至9.333小时,服务完成率提升至0.72。
- 03:基准价格下电池电动策略占COMA决策的43.3%,氢燃料电池与混合动力仍保留一定配置比例。
- 04:氢价降至约1.8美元/千克,或电价显著上升时,氢能策略才具备成本竞争力。
港口车队能源选择的协同决策对象
论文关注港口拖运卡车在动态电价、氢价、车辆能源状态、剩余工作量和充换能设施排队条件下的策略选择。模型设置100个模拟卡车智能体,每个回合包含60个决策步,每步对应一个运营日。每个智能体从电池电动、氢燃料电池和柴油电动混合动力三类策略中进行选择,所有智能体共享车队层面的奖励。
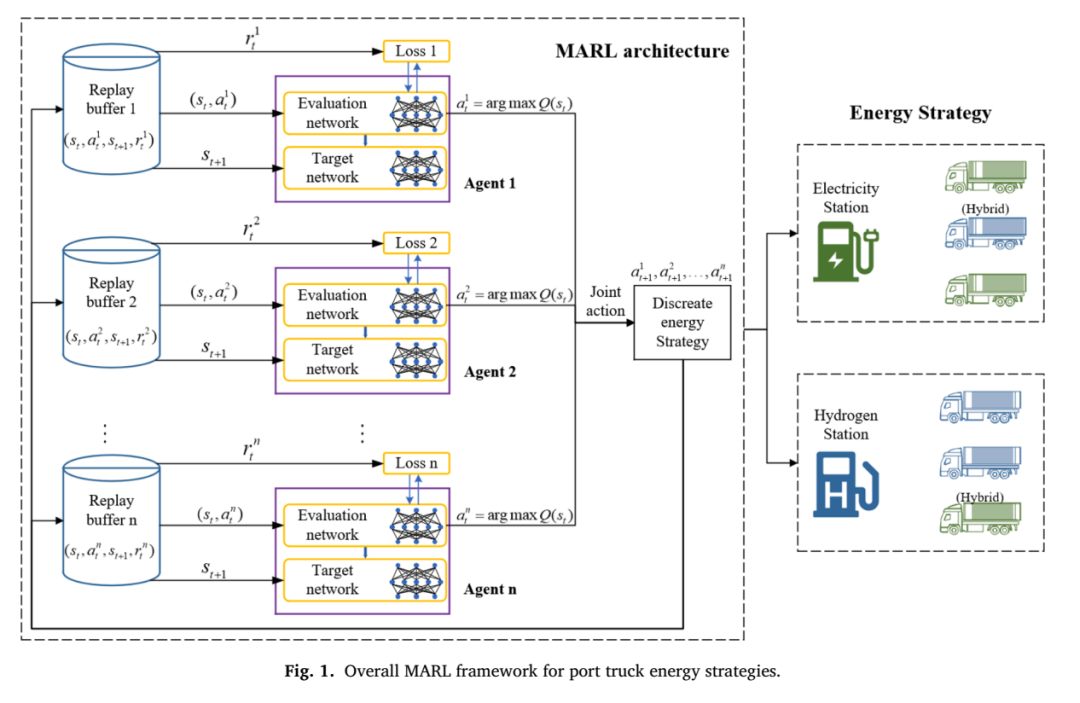
图1 港口卡车能源策略的总体多智能体强化学习框架。来源:Fig. 1
COMA如何分配车队协同决策贡献
模型采用集中式训练、分散式执行的多智能体强化学习结构。训练阶段的评论家接收全局状态和联合动作,执行阶段每辆卡车依据本地观测独立选择策略。COMA通过反事实基线固定其他智能体动作,比较当前动作与替代动作的价值差异,从而识别单辆卡车对总成本、设施拥堵和服务结果的边际贡献。
1本地观测:电量、氢量、工作量、队列、能源价格与设施状态
2联合动作:车队共同形成能源策略配置与设施需求
3集中式评论家:评估全局状态、联合动作和共享奖励
4反事实优势:替换单个智能体动作,计算边际贡献
5分散式执行:各卡车依据本地观测输出能源策略
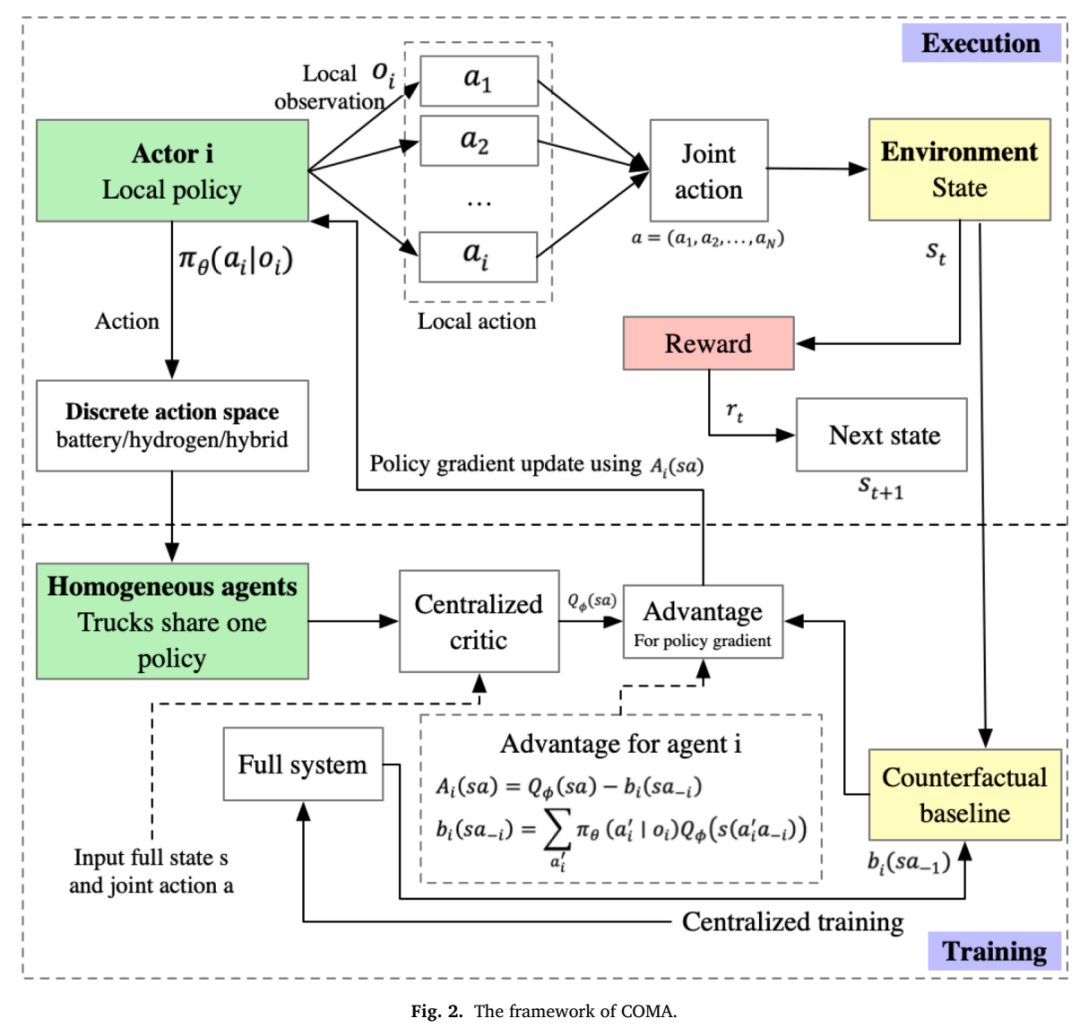
图2 COMA算法框架及反事实基线训练流程。来源:Fig. 2
洛杉矶长滩港案例的实验边界与参数
案例参数参考洛杉矶—长滩港拖运运营背景,约17,000辆卡车用于现实规模参照,直接进入仿真环境的车队规模为100辆。充电设施每天服务10次,加氢设施每天服务5次,超出容量的需求形成等待。基准电价为0.14美元/千瓦时,氢价为7美元/千克,短途与长途异质性实验分别设置100公里和300公里日行驶里程。
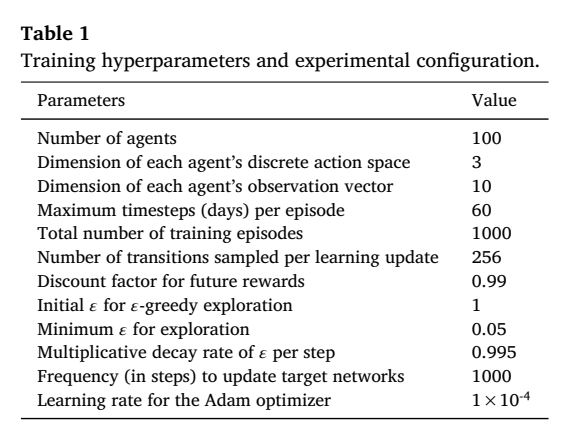
表1 训练超参数与实验配置。来源:Table 1
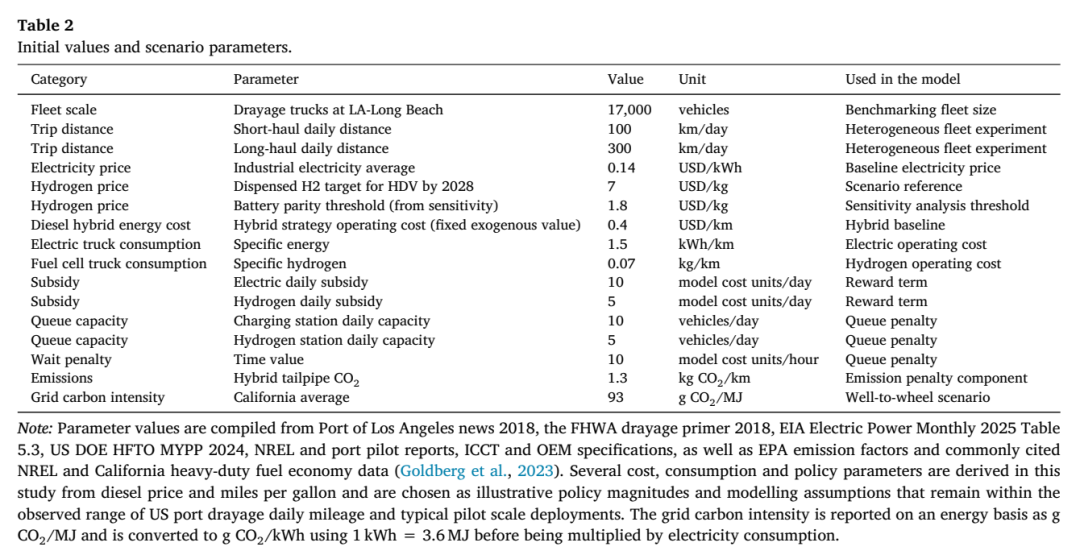
表2 初始值与案例场景参数。来源:Table 2
COMA的收敛稳定性与经济表现
COMA、QMIX和VDN均能在训练中接近高奖励区域,三者的波动程度存在差异。COMA更早接近稳定奖励区间,训练后期波动较小。QMIX出现较多向下波动,VDN出现多次明显下降和较长低奖励区间。平均奖励方面,COMA为-0.532,QMIX为-0.599,VDN为-1.208;奖励标准差分别为0.359、0.423和0.606。
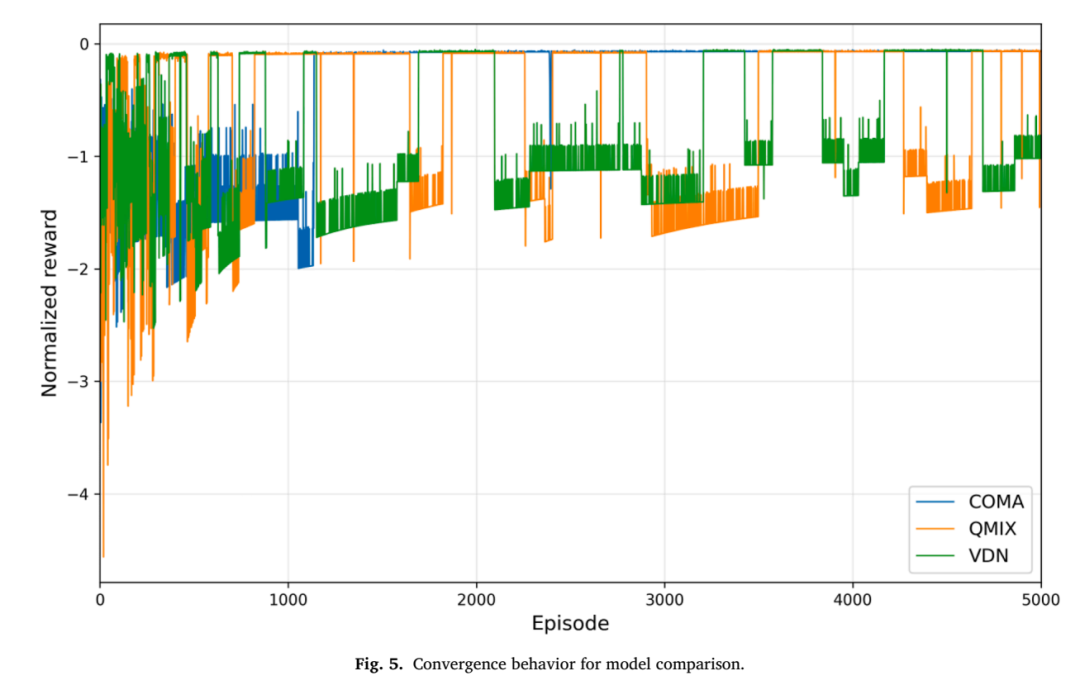
图5 不同模型的训练收敛行为比较。来源:Fig. 5
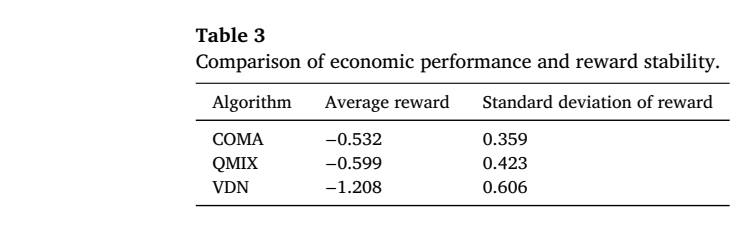
表3 经济表现与奖励稳定性比较。来源:Table 3
从算法得分到港口运营绩效
队列指标显示,COMA的平均等待时间和95分位等待时间均为9.333小时,服务完成率为0.72,充电设施利用率为0.3,加氢设施利用率为0。QMIX平均等待时间达到52小时,服务完成率降至0.48,加氢设施利用率为0.2,结果对应氢能设施的集中拥堵。COMA在基准情景下形成以电池电动为主的策略组合,并保持对设施容量的协调使用。
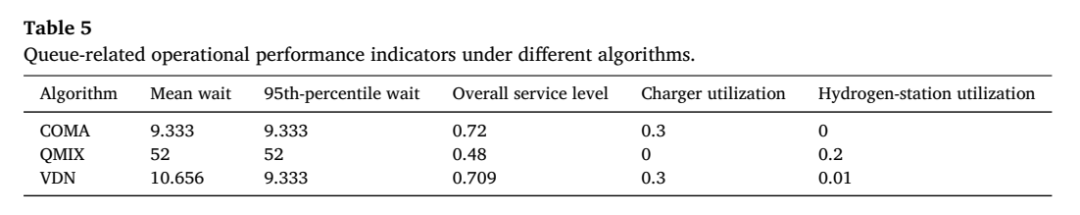
表5 不同算法下的队列相关运营绩效指标。来源:Table 5
论文结果支持优先建设高容量充电基础设施,并将电池电动拖运作为基准价格条件下的近期策略方向。
能源价格变化下的策略平价边界
能源价格敏感性分析显示,氢燃料电池与电池电动的每公里能源成本在氢价约1.80美元/千克处达到平价。当前研究设定的氢价参考值为7美元/千克,电池电动在多数基准价格情景下具备成本优势。电价升高后,混合动力策略的相对成本优势扩大;氢价大幅下降后,氢燃料电池策略进入更具吸引力的区域。
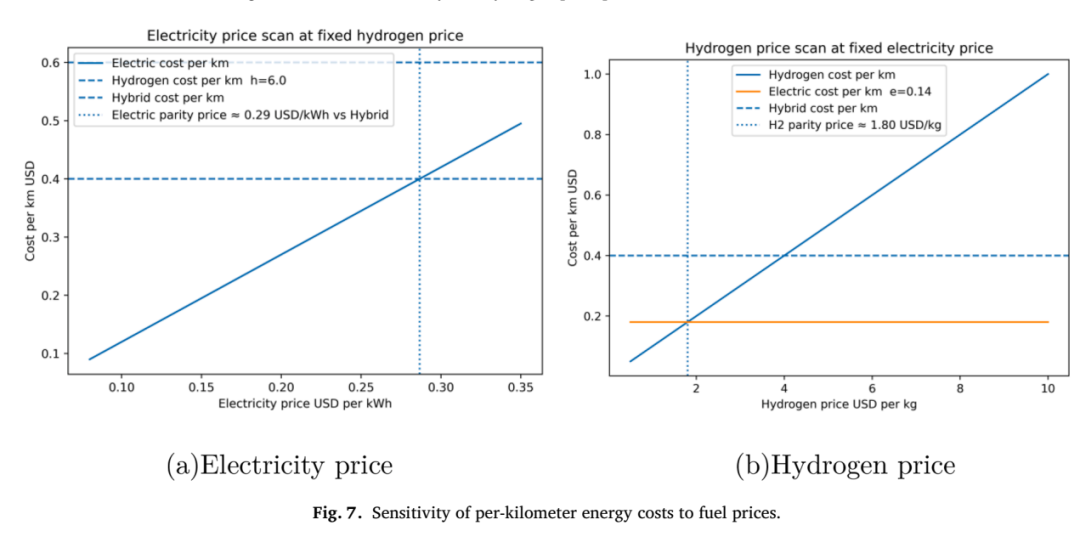
图7 能源价格对每公里能源成本的敏感性。来源:Fig. 7
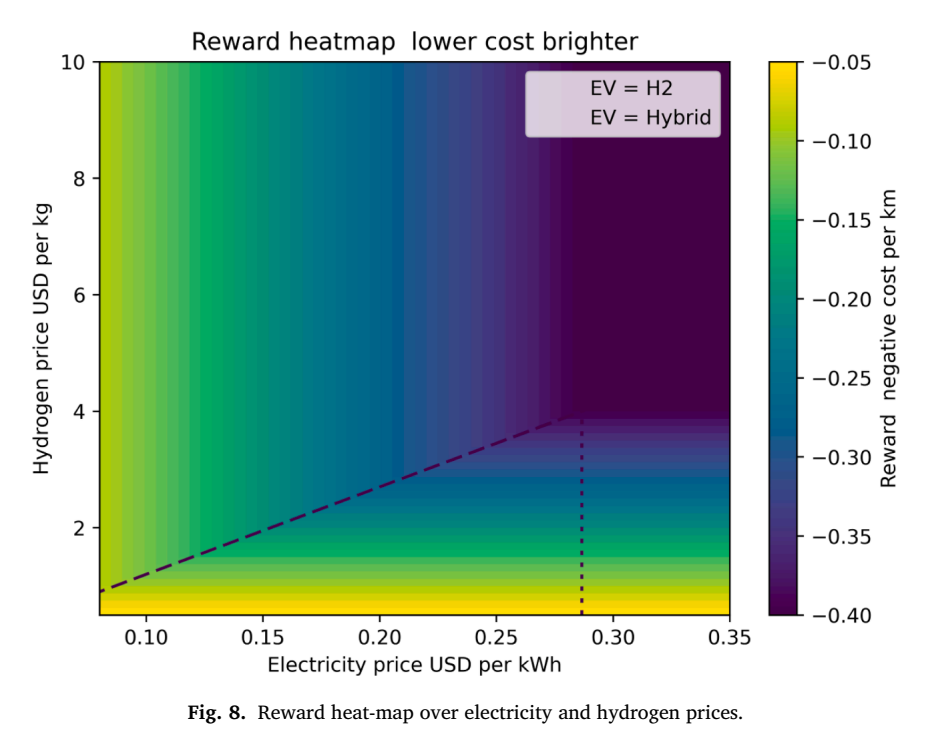
图8 电价与氢价组合下的奖励热力图。来源:Fig. 8
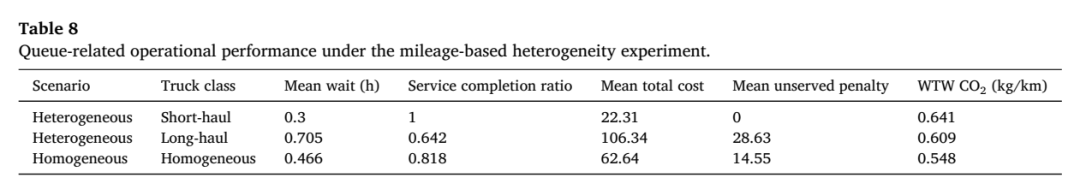
表8 里程异质性实验中的队列相关运营绩效。来源:Table 8
模型适用条件与研究边界
论文将短期决策步抽象为运营日,能源策略动作用于车队配置或情景评估,单辆卡车在短期内切换动力技术的现实过程未被模拟。基础实验采用同质车队,异质性分析只区分100公里和300公里两类日行驶里程。模型使用100辆智能体、60天回合和有限容量设施,参数部分属于示意性建模假设。
队列等待时间、服务完成率和设施利用率反映模型时域内的能源服务绩效,完整的卡车周转时间、准时率、下游调度联动和延误传播需要更长时间耦合的物流仿真。排放分析依赖电网碳强度、灰氢排放因子和柴油混合动力参数,其他能源供应路径与更广泛基础设施投资方案,论文未报告。
论文:Multi-agent reinforcement learning for port drayage truck energy strategies: Impacts on cost, emissions and queue-related operational performance
作者:Zekun Zhang,Wuyue Rong,Yang Liu,Ying Yang,Xiaobo Qu
期刊:Transportation Research Part C
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


