链上镖师 / Chain Biaoshi
TRD|船舶排放无人机监测:交叉效率社会奖励驱动的协同采样优化
把AIS航迹、ERA5风场、排放反演和多无人机强化学习放进同一套协同监测框架
这篇论文把船舶尾气无人机监测建模为多智能体协同优化问题,用DEA交叉效率生成社会奖励,让无人机在能耗、覆盖、有效检测和排放反演之间形成更稳定的分工。
- 01:研究对象是沿海和港口水域的船舶排放监测,重点解决高密度船舶、动态风场和有限无人机电量下的协同采样问题。
- 02:方法核心是MAPPO-DEA-CESR:MAPPO负责多无人机策略学习,DEA交叉效率负责评价各无人机在资源消耗和任务产出上的相对效率,并转化为社会奖励。
- 03:实验同时包含数值仿真和哥本哈根港附近真实AIS航迹、ERA5风场驱动的实证场景,比较MAPPO、DEA-Self和DEA-CESR等方法在反演误差、有效检测和空间误差上的表现。
研究背景
船舶在港口和近岸水域排放的NOx、SOx、颗粒物和二氧化碳,会直接影响区域空气质量、公众健康和气候系统。随着国际海事组织持续收紧排放控制区燃油含硫量和发动机排放要求,监管端需要更高时空分辨率、更低运行成本、更适合动态海况的监测技术。
岸基固定站、船载监测和遥感方法在特定区域能够提供较高精度,空间覆盖、部署维护成本和气象敏感性仍然限制了大规模应用。搭载气体传感器的无人机具备机动性和低成本优势,问题进一步转向多架无人机如何围绕移动船舶尾流完成协同采样。
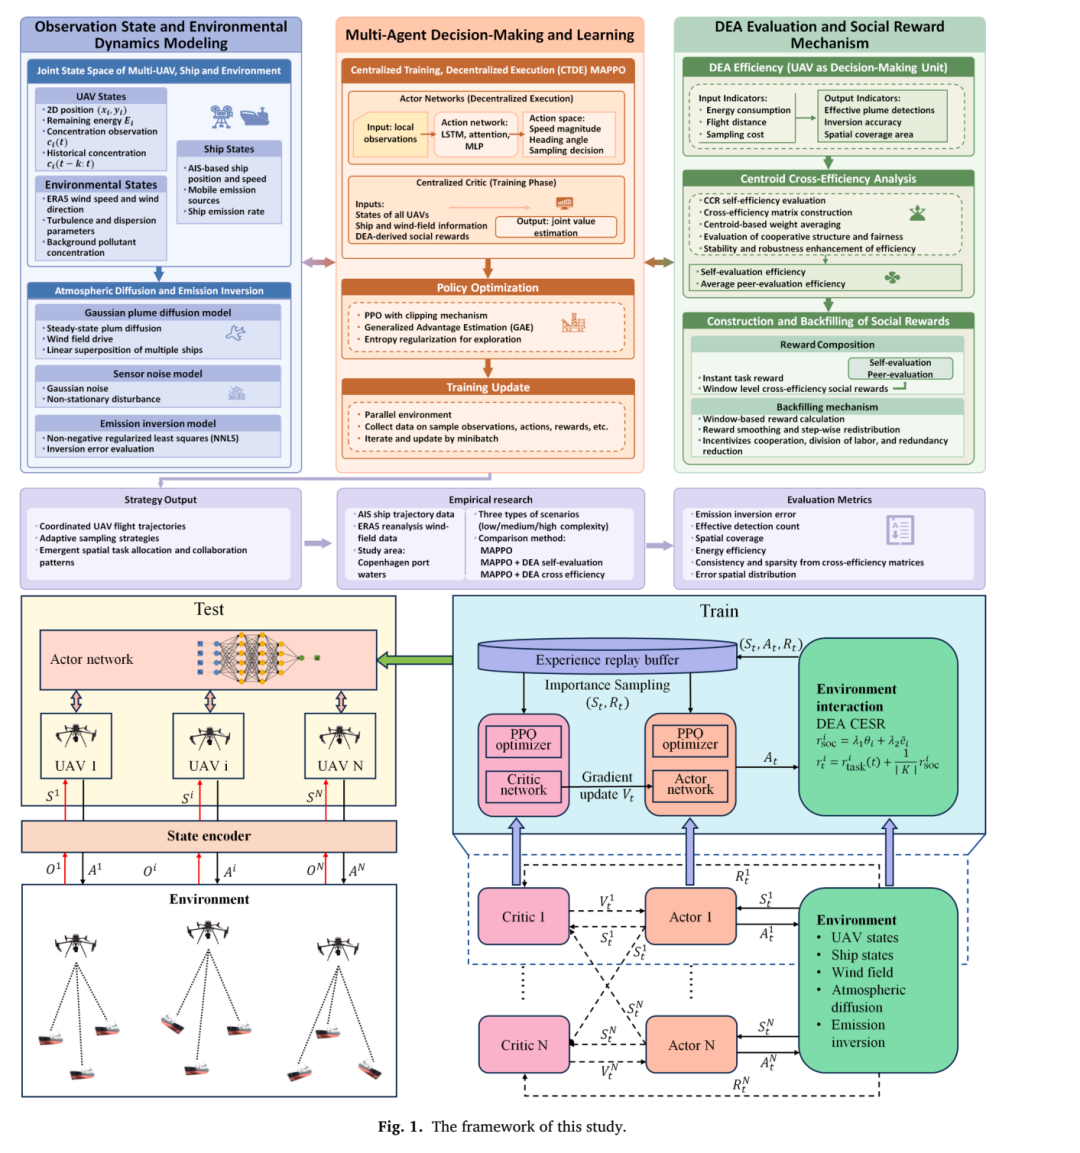
来源:Fig. 1,研究框架展示MAPPO-DEA-CESR用于多无人机船舶排放监测的整体流程,连接排放监测问题、方法设计、数值实验和真实数据验证。
论文的切入点很明确:单架无人机和规则航线难以适应密集船流与快速变化风场,多智能体强化学习需要一个能同时反映能耗、覆盖、检测和反演质量的协同奖励。
核心问题
作者把多无人机船舶排放监测定义为去中心化部分可观测马尔可夫决策过程。全局状态包括无人机位置、电量和浓度观测,船舶位置、速度和排放率,以及ERA5风速风向;单架无人机执行时只能依据自身局部观测、浓度历史、风场信息和船舶状态估计来决策。
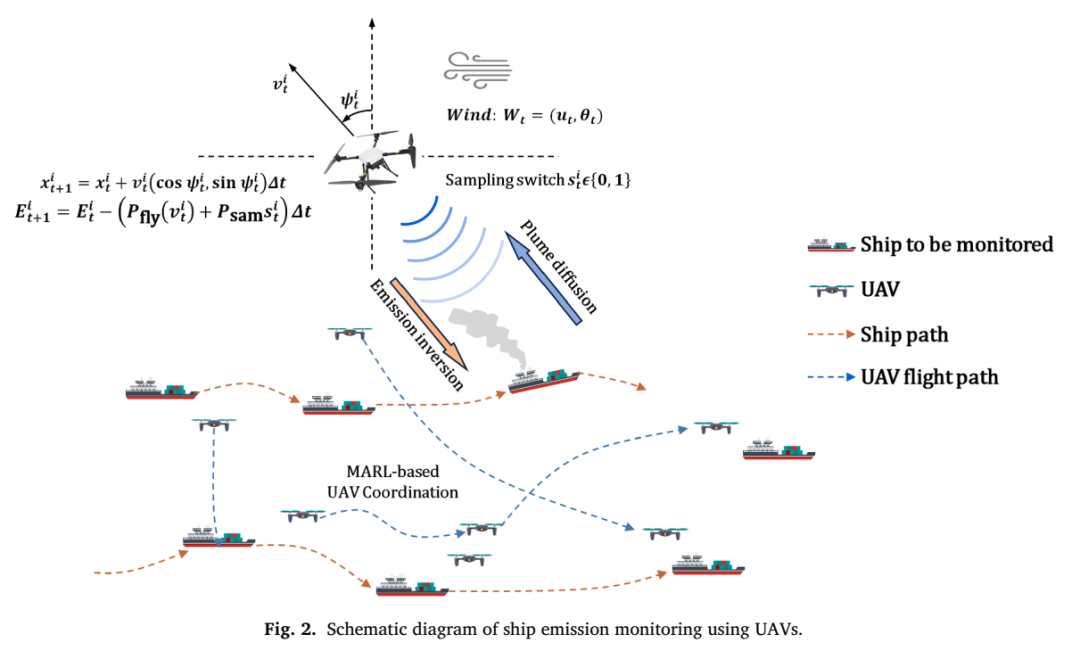
来源:Fig. 2,UAV船舶排放监测示意图说明尾流、风场、航迹和采样路径关系。
- 状态维度:无人机能量、位置、传感器浓度读数,船舶AIS位置速度,风速风向和污染物浓度场。
- 动作维度:无人机速度、航向和采样开关,采样动作会增加传感器与数据处理耗电。
- 任务目标:提高有效检测、扩大有价值覆盖、降低排放反演误差,并控制飞行距离、采样次数和能量消耗。
排放反演部分采用由风场驱动的高斯羽流模型生成浓度场,再用带正则项的非负最小二乘估计船舶排放率。真实排放率只作为仿真训练和误差计算中的参考信号,训练后的执行策略不需要在线访问真实排放率、真实反演误差或DEA奖励。
方法框架
方法的核心是把DEA从传统效率评价工具改造成强化学习训练中的协同奖励发生器。每个DEA时间窗口内,无人机的能耗、飞行距离和采样成本作为输入,有效检测、反演质量和覆盖面积作为输出,CCR模型给出自评价效率和交叉效率矩阵。
1用MAPPO在集中训练、分散执行框架下学习多无人机策略。
2在DEA窗口内累计每架无人机的资源消耗与监测产出。
3计算自评价效率、平均同伴评价效率,并组合成CESR社会奖励。
4将窗口级社会奖励回填到窗口内各时间步,参与优势估计和PPO策略更新。
5部署阶段只保留基于局部观测的actor前向推理。
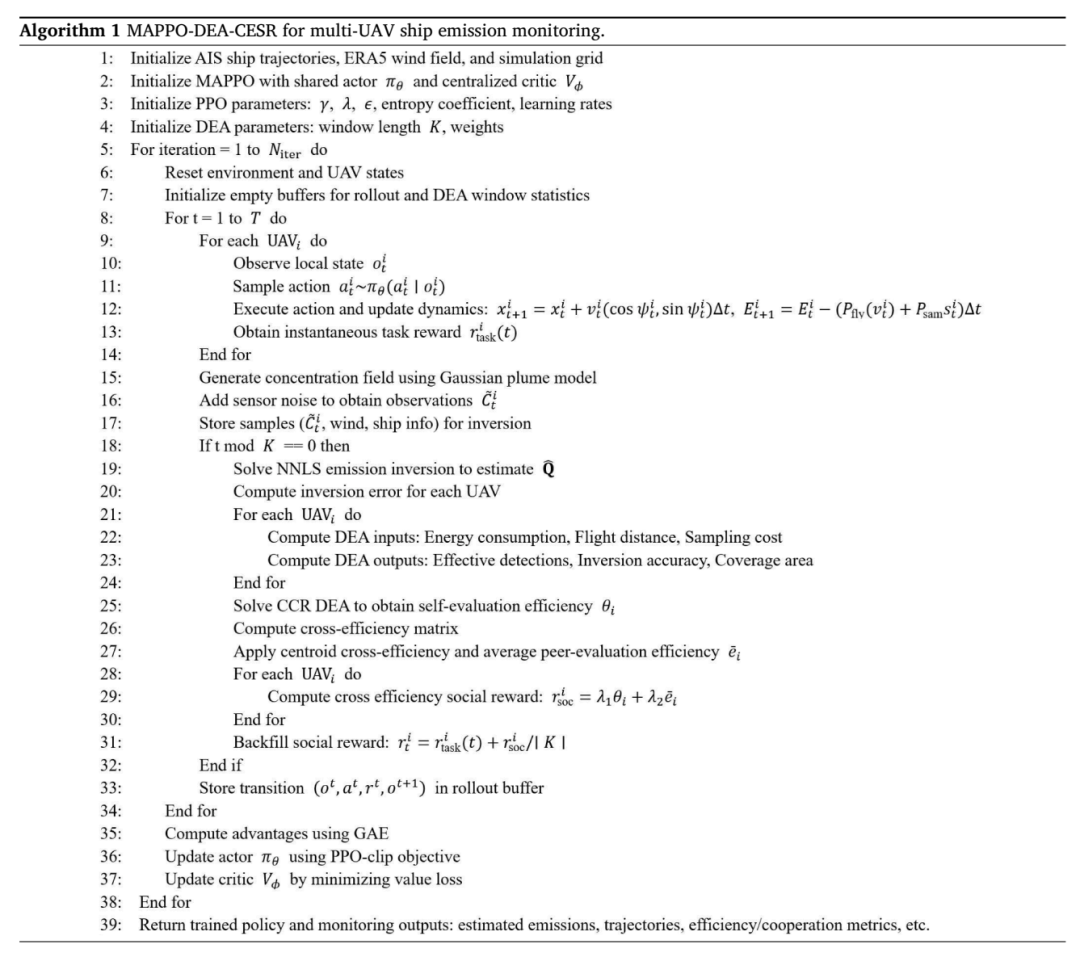
来源:Algorithm 1,MAPPO-DEA-CESR多无人机船舶排放监测训练流程,展示DEA窗口计算、社会奖励回填和策略更新。
CESR奖励由自评价效率和平均同伴评价效率组成,强调个体资源效率和群体协作贡献。论文把DEA输出作为训练端的外部协同反馈信号,避免在执行端频繁计算交叉效率矩阵,使额外复杂度集中在离线训练阶段。
案例或实验设置
数值实验先构建一个可控的近海矩形区域,用8艘船、6架无人机和动态风场检验机制有效性。区域经纬度范围为[12.62, 12.80]与[55.62, 55.78],每个episode持续1800秒,时间步为10秒,训练120个episode。
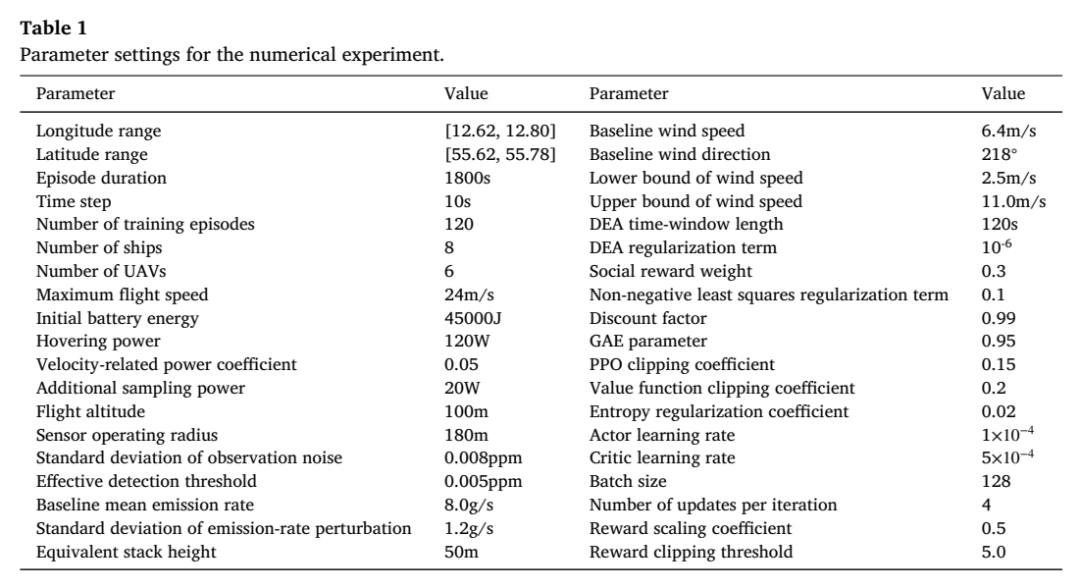
来源:Table 1,数值实验的区域、船舶、无人机、风场与训练参数设置,包括DEA窗口120秒、社会奖励权重0.3、折扣因子0.99和PPO裁剪系数0.15。
实证研究选取丹麦哥本哈根港附近水域,范围为经度12.51-13.11、纬度55.40-56.05。论文使用2025年11月20日丹麦约104.8万条AIS记录,去重、轨迹合并、异常速度和航向过滤后保留约200个有效船舶对象。
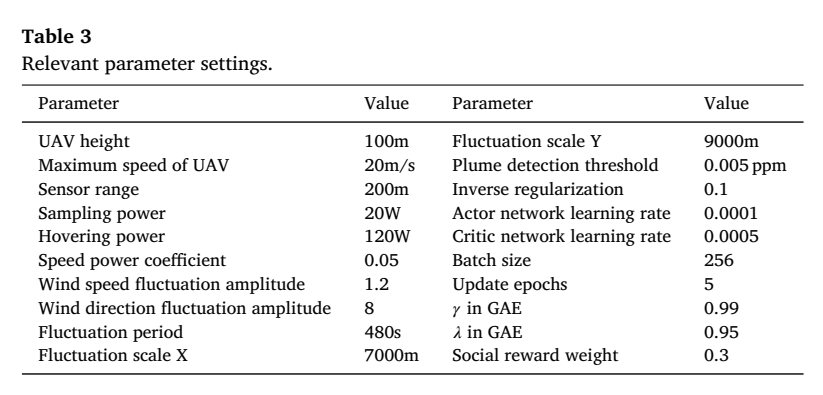
来源:Table 3,真实场景实验的无人机、风场、反演与训练参数,默认部署20架多旋翼无人机,并将DEA窗口固定为600秒。
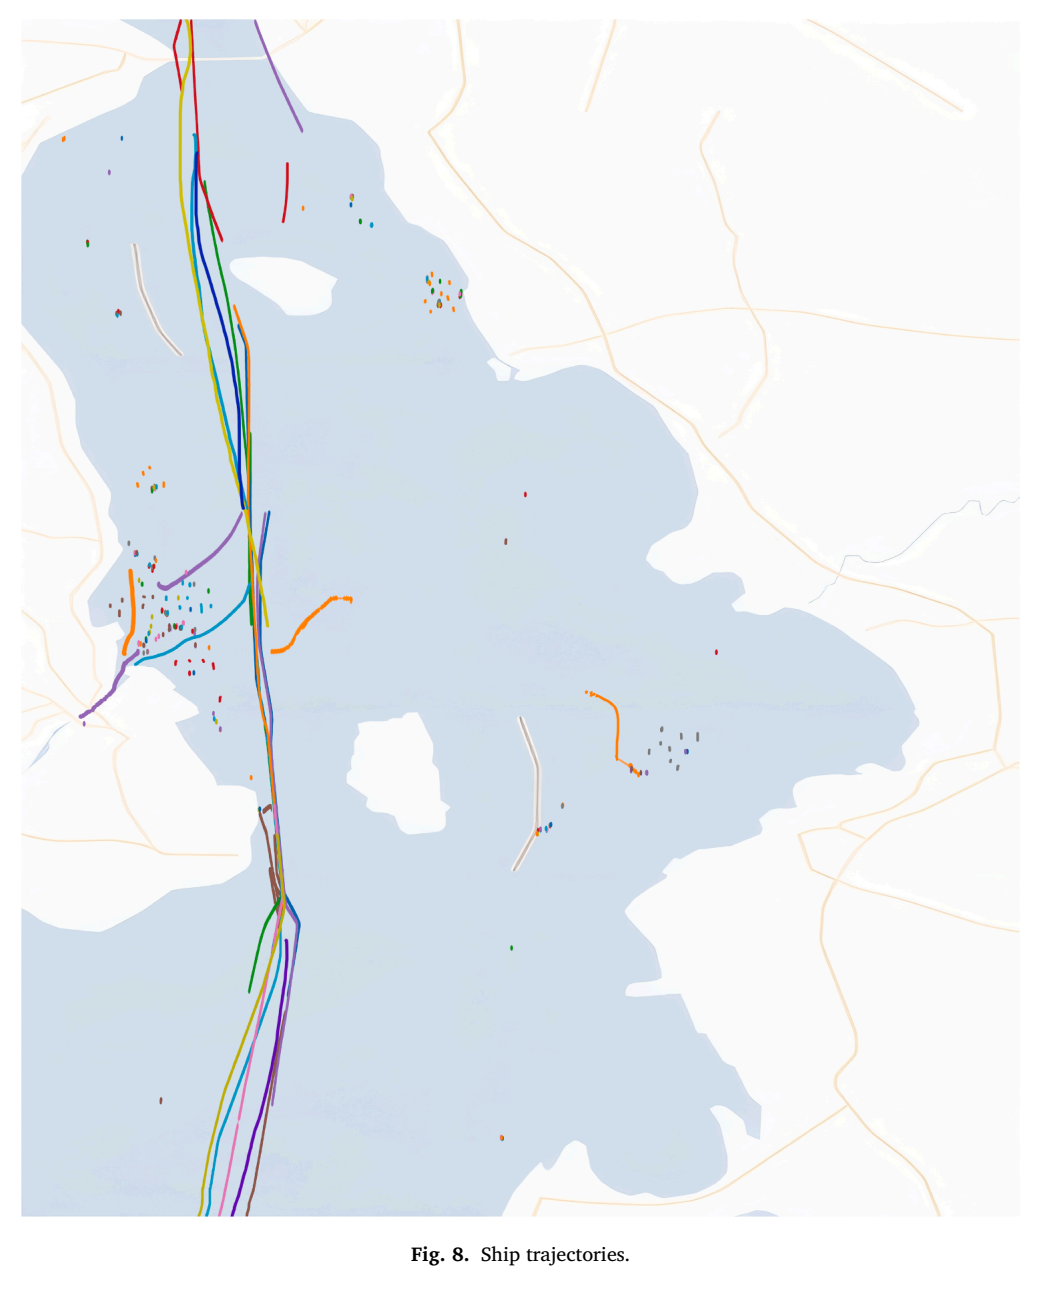
来源:Fig. 8,哥本哈根港附近用于实证研究的船舶轨迹,展示真实验证场景中的交通空间结构。
结果分析
数值实验中,所提方法与逐步计算DEA奖励的baseline 1在有效检测、单位能耗检测率和累计奖励上走势接近。论文据此说明,时间窗口回填在保持学习性能的同时降低了每个时间步重复计算DEA交叉效率的成本。
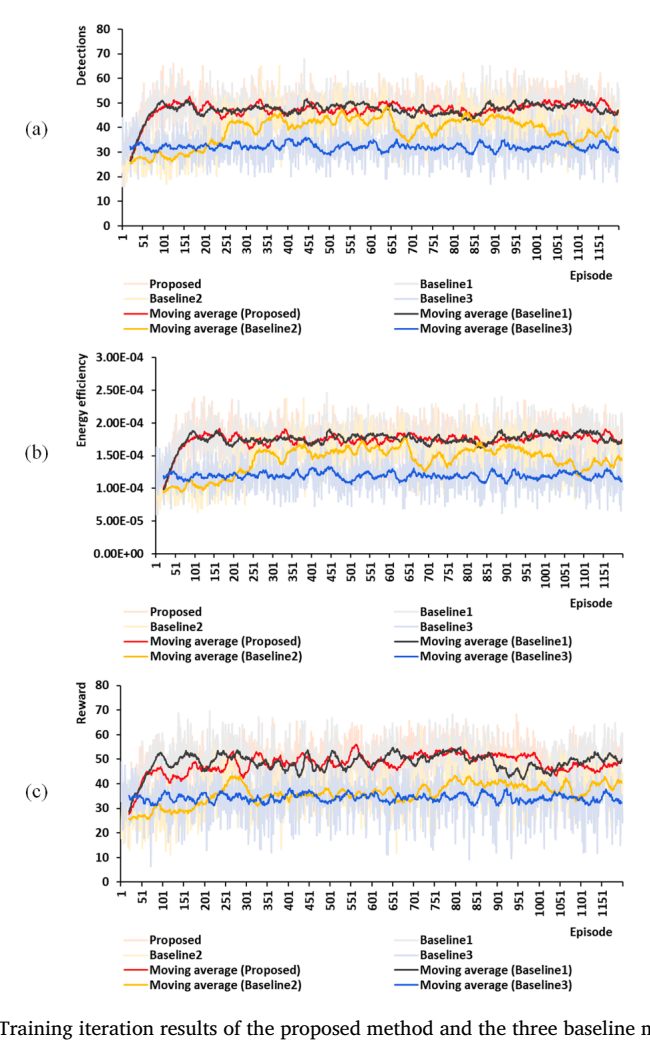
来源:Fig. 3,所提方法与三类基线方法的数值实验训练迭代结果,覆盖有效检测、单位能耗检测率和累计奖励。
在真实场景实验中,论文设置低流量、真实流量和复杂风场三类场景,对比MAPPO、DEA-Self和DEA-CESR。视觉资产说明显示,CESR方案在三个场景中的整体反演误差水平最低,有效检测次数也更有优势,说明交叉效率社会奖励能改善采样位置与协同分工。
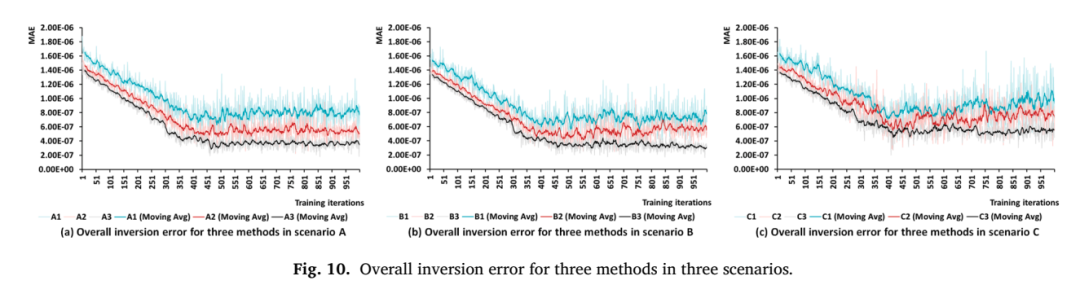
来源:Fig. 10,三种方法在三个场景中的整体反演误差,CESR方案在MAE指标上表现更低。
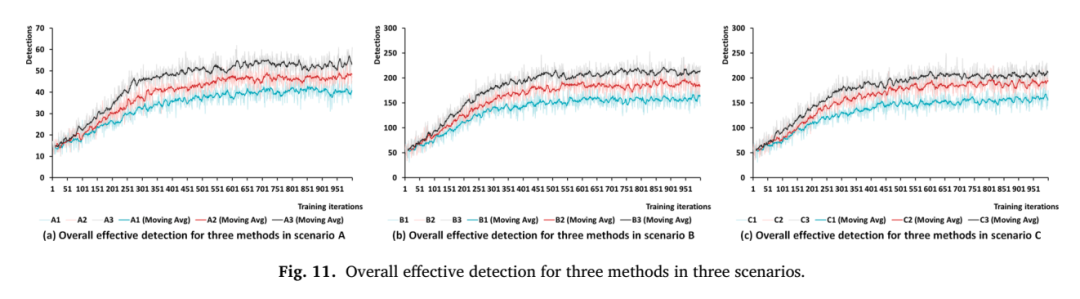
来源:Fig. 11,三种方法在三个场景中的整体有效检测次数,反映无人机群对有信息量羽流样本的捕捉能力。
管理启示
对港口排放监管而言,论文提供的价值不只在于无人机路径更优,还在于把协同监测的成效拆成可解释指标:能耗、飞行距离、采样成本、有效检测、反演质量和覆盖面积。监管方可以据此评估无人机群是否在重点羽流区域形成有效分工。
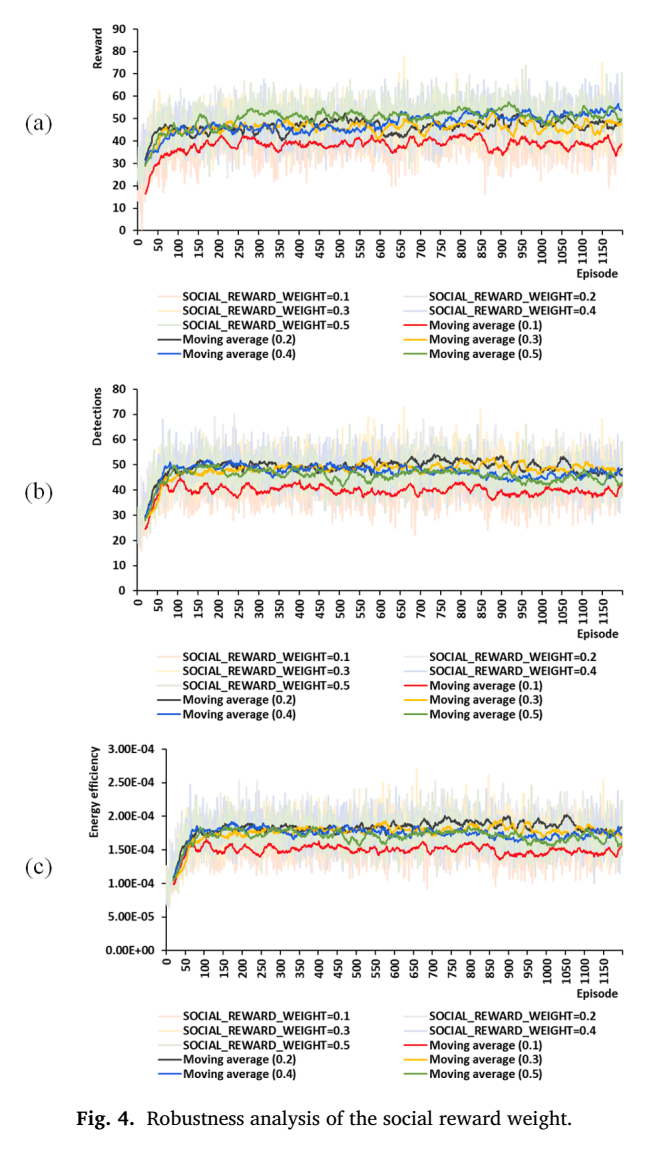
来源:Fig. 4,社会奖励权重的鲁棒性分析,显示权重过低会削弱协同奖励效果,其余合理设置下训练表现保持在相近区间。
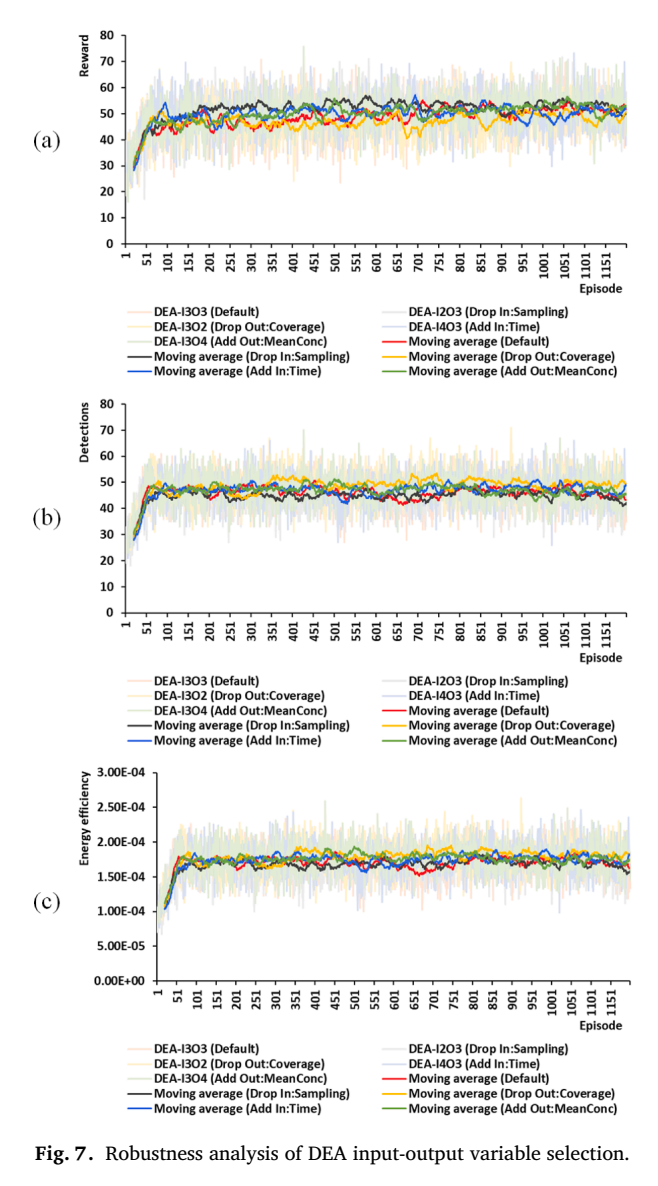
来源:Fig. 7,DEA输入输出变量选择的鲁棒性分析,说明不同指标组合下协同奖励机制仍能维持训练收益。
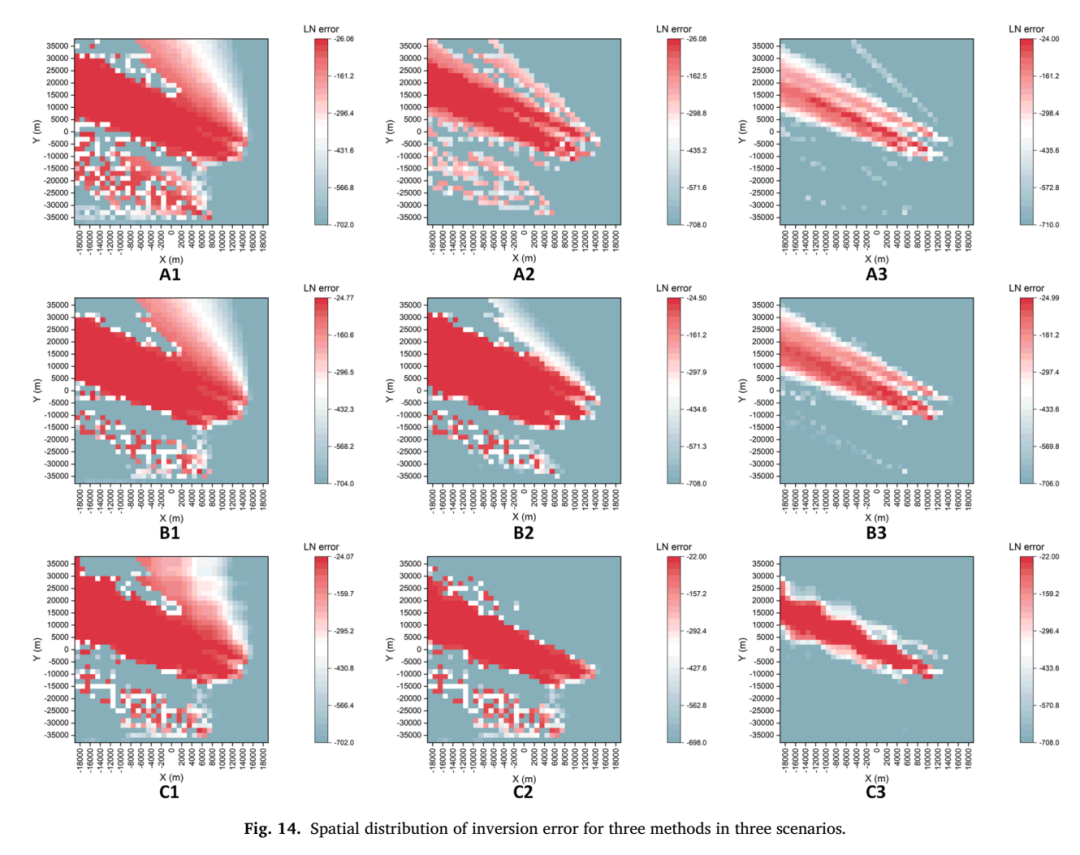
来源:Fig. 14,三种方法在三个场景中的空间反演误差分布,可用于识别羽流中心线和下风向扩散区等误差热区。
这篇论文适合关注港口低空巡检、船舶排放监管和多无人机调度的读者阅读:它把无人机采样从单纯追踪高浓度点推进到群体效率评价与训练奖励设计,并用真实AIS航迹和ERA5风场验证了复杂海况下的可用性。
论文:Multi-agent deep reinforcement learning with cross efficiency social rewards for unmanned aerial vehicle collaborative optimization in ship emission monitoring
作者:Weipan Zhang,Jihong Chen,Kui Yi,Li Dong,Xianhua Wu
期刊:Transportation Research Part D
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


