链上镖师 / Chain Biaoshi
TRC|海铁联运集装箱吞吐量:特征优化注意力预测
用相关性筛选、时间上采样、特征加权与自注意力模型提升港口吞吐量预测精度
这篇 TRC 论文把港口海铁联运集装箱吞吐量预测拆成指标筛选、时间上采样、权重分配、CNN-LSTM-SA 建模和贝叶斯优化五个环节,目标是在低频、稀疏、多因素交互的数据条件下提升预测精度。
- 01:研究对象是营口港海铁联运集装箱吞吐量,并扩展到上海港、深圳港做迁移验证。
- 02:方法核心是 BO-WACNN-LSTM-SA:相关性驱动的权重分配增强输入特征,CNN 抽取局部模式,LSTM 建模时序依赖,双层自注意力补充全局信息。
- 03:实验结果显示,该模型在对比基线中取得最低预测误差,并通过迁移测试、消融实验、权重稳定性分析和时间序列交叉验证检验稳健性。
研究背景
海铁联运连接内陆、沿海和国际市场,具备长距离、低成本和低碳排放等优势。港口吞吐量预测越准确,越有利于提前安排运输计划、减少货物周转时间和能源消耗,并缓解港口拥堵、设备闲置和运输能力错配。
论文指出,海铁联运集装箱吞吐量预测面临低频采样、数据稀疏、季节性、长尾分布和多因素非线性交互。影响因素覆盖运输网络、区域经济和贸易政策,传统统计模型、机器学习模型和常规深度学习结构都存在各自的建模边界。
这项研究的切入点是把输入数据质量和模型结构放在同一条链路里处理:先筛掉弱相关或干扰指标,再让深度模型集中学习关键特征和长期依赖。
核心问题
既有港口吞吐量预测研究已经从统计模型扩展到机器学习和混合深度学习模型,仍存在三个关键空缺:缺少系统的数据驱动指标优化,缺少适配深度学习的数据增强方式,混合模型尚未把输入优化、局部特征抽取和全局依赖建模形成闭环。
01输入侧:多维外部因素进入模型前需要做缺失值、异常值、相关性和冗余控制。
02特征侧:月度指标难以满足复杂深度模型对时间密度的需求,需要通过时间上采样提升数据粒度。
03模型侧:CNN 擅长局部特征,LSTM 擅长时序依赖,自注意力用于捕捉更长范围的动态关系。
04优化侧:超参数直接影响模型收敛和泛化,论文采用贝叶斯优化减少人工调参。
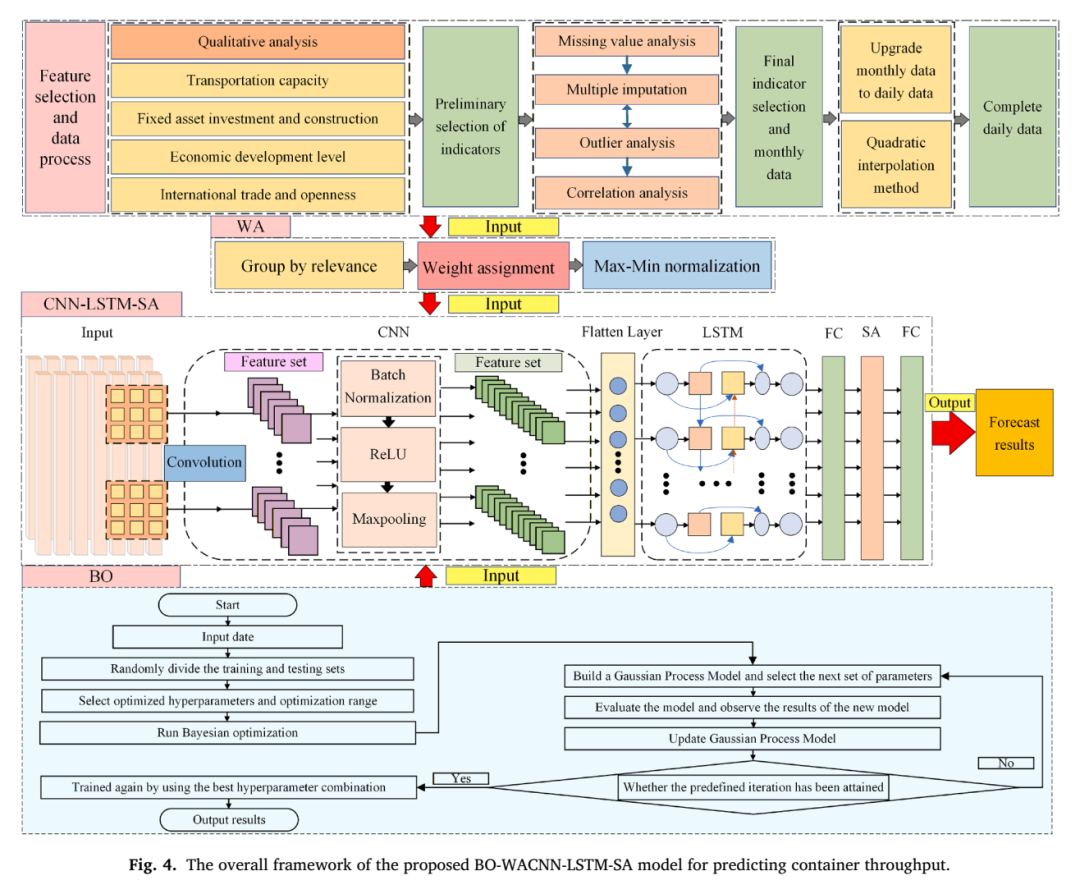
来源:Fig. 4。该框架把指标处理、权重分配、CNN-LSTM-SA 建模、贝叶斯优化和结果评价串联起来,构成全文方法主线。
方法框架
论文先从运输能力、固定资产投资与建设、经济发展水平、国际贸易与开放四类维度收集候选指标。缺失率超过 30% 的指标被剔除,其余缺失值通过多重插补补齐,异常值用 IQR 方法识别后继续插补,随后用 Pearson 和 Spearman 相关系数筛选特征。
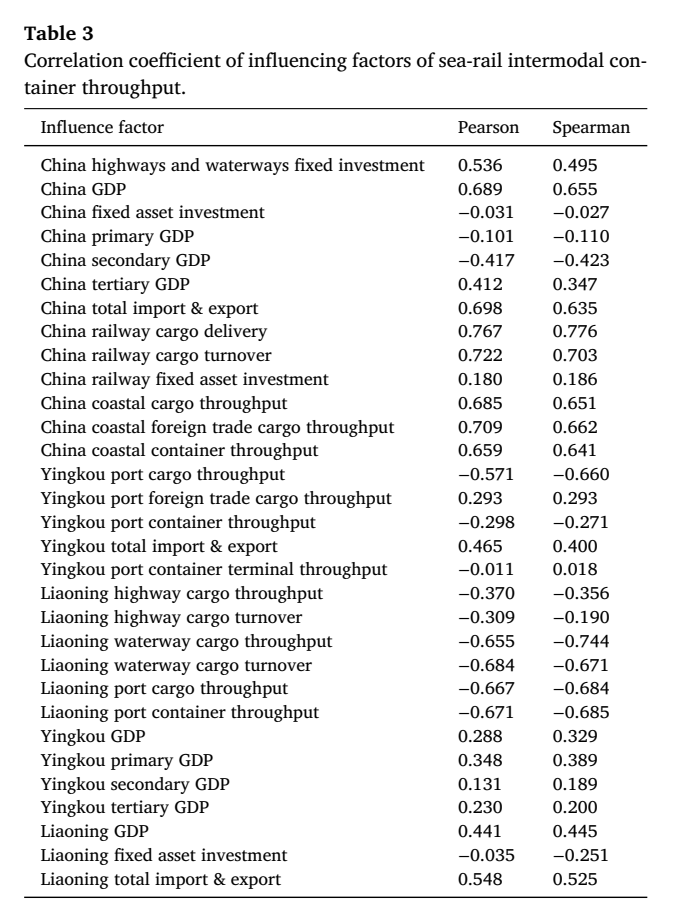
来源:Table 3。论文用 Pearson 和 Spearman 系数判断变量与营口港海铁联运集装箱吞吐量的相关强度,并据此删除弱相关指标。
1收集四类候选指标,并进行缺失值与异常值处理。
2用 Pearson 和 Spearman 相关系数筛选变量,最终得到 28 组输入特征。
3用二次插值把月度数据上采样到日度数据,形成 3834 天、29 个评价指标的数据集,其中包含预测目标。
4按相关性把特征分为强相关组和弱相关组,强相关组与弱相关组采用 3:1 的权重比例。
5将加权输入送入 CNN-LSTM-SA,并通过贝叶斯优化选择关键训练超参数。
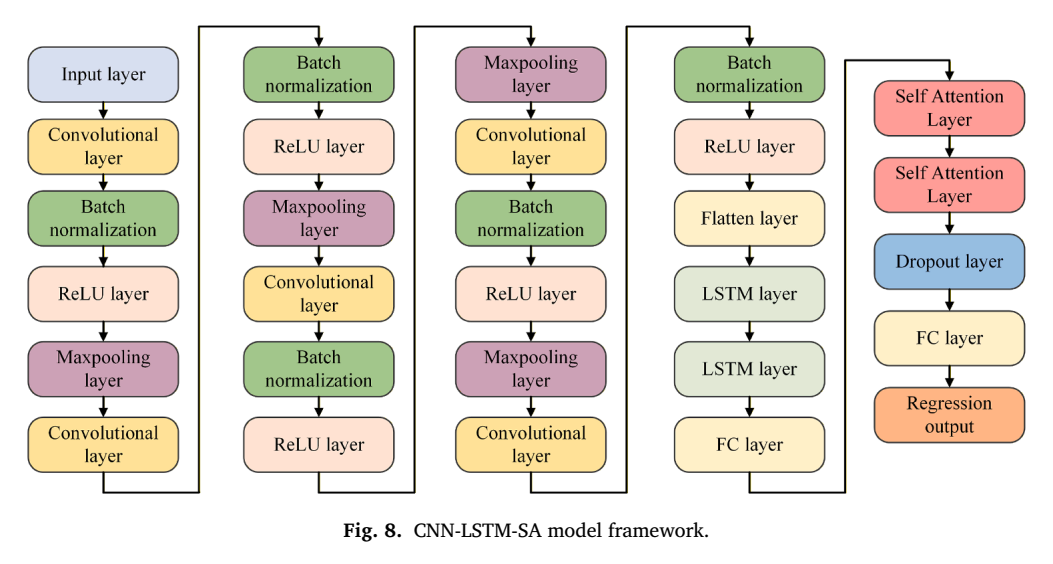
来源:Fig. 8。CNN 负责局部特征抽取,LSTM 负责序列依赖建模,SA 模块在 LSTM 后补充全局交互信息。
模型结构中,CNN 使用 5 个卷积层,卷积核尺寸依次覆盖较长窗口和局部细节;LSTM 采用两层结构,第一层和第二层神经元数分别为 39 和 32;自注意力模块采用 2 层、8 个注意力头和 256 维嵌入,输出端接全连接层和回归层。
案例或实验设置
案例选择中国辽宁省营口港。论文认为,营口港每天承担大量集装箱集疏运任务,海铁联运吞吐量预测直接关系到港口运输资源配置。研究根据公开网站和统计年鉴收集月度数据,并围绕营口市、辽宁省和全国层面的相关指标建立输入体系。
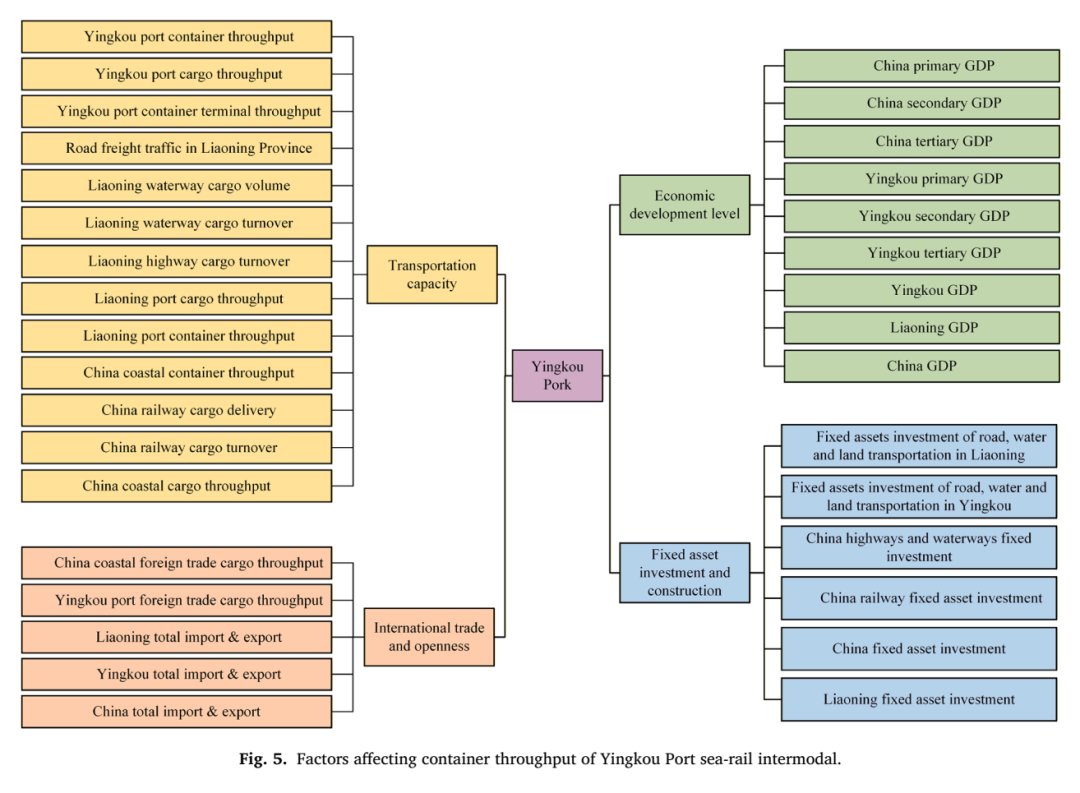
来源:Fig. 5。候选指标来自运输能力、固定资产投资与建设、经济发展水平、国际贸易与开放四类因素,共形成 33 个初始评价指标。
筛选后,论文删除中国固定资产投资、辽宁固定资产投资、营口港集装箱码头吞吐量等相关性较低或可能干扰训练的指标。最终 28 组特征进入模型,其中 14 个指标相关性指数大于 0.5,另有 14 个指标低于 0.5。
训练集
2800
CNN-LSTM-SA 参数表中的训练样本规模
测试集
1034
CNN-LSTM-SA 参数表中的测试样本规模
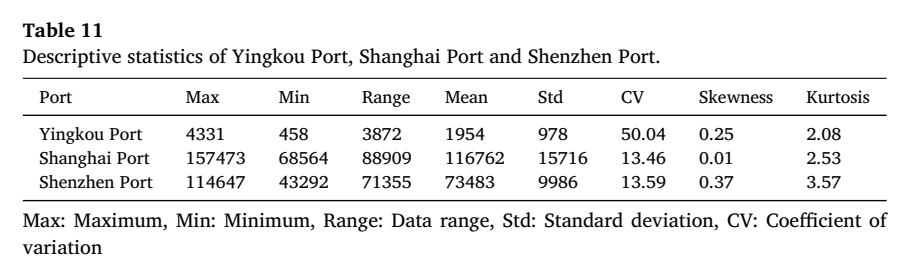
来源:Table 11。论文用营口港、上海港和深圳港的吞吐量描述统计交代不同港口样本差异,为后续迁移验证提供背景。
结果分析
论文将 BO-WACNN-LSTM-SA 与统计模型、机器学习模型、单一深度学习模型和其他混合深度学习模型进行比较。摘要和实验部分均指出,本文模型在对比基线中取得最低预测误差,说明输入权重分配、自注意力增强和贝叶斯优化组合有效。
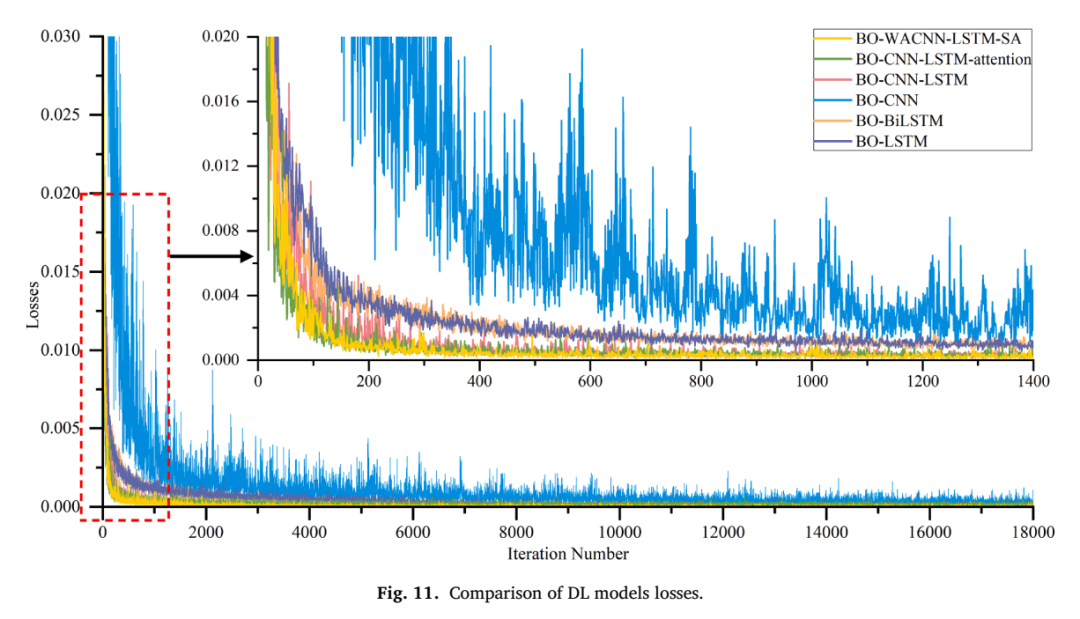
来源:Fig. 11。训练损失曲线用于比较不同深度学习模型的收敛过程,支撑核心模型在收敛速度和稳定性上的表现。
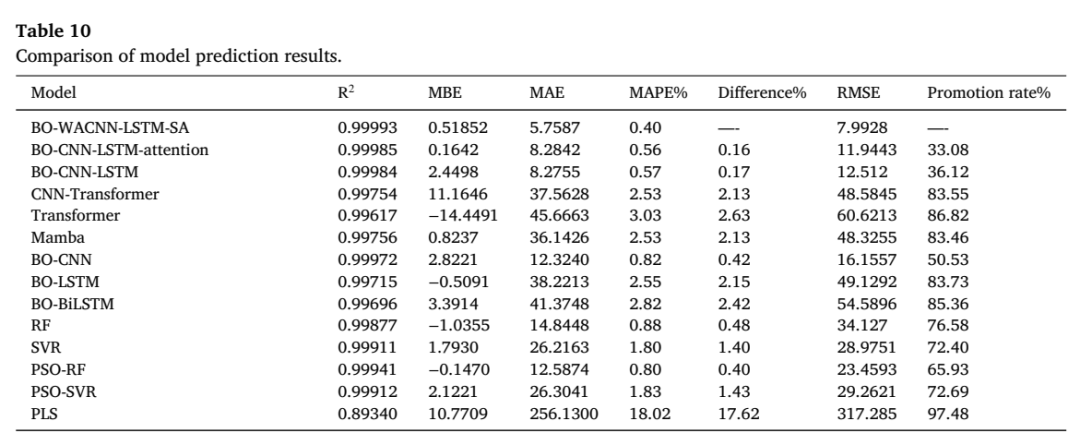
来源:Table 10。该表汇总营口港预测任务中的 R2、MBE、MAE、MAPE 和 RMSE,是判断模型预测精度的主结果证据。
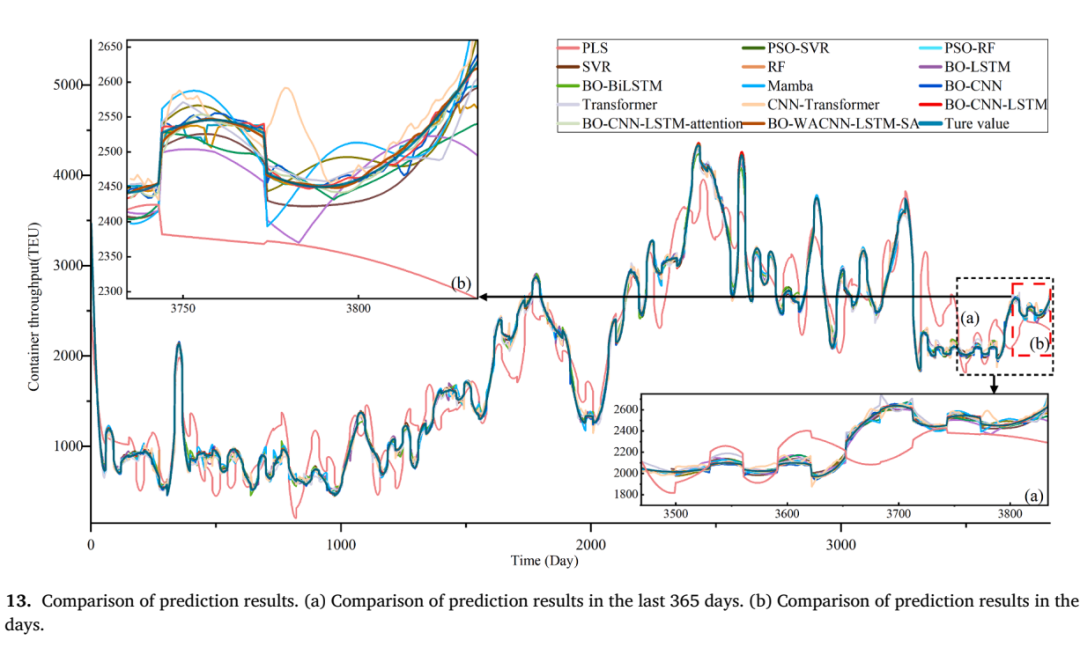
来源:Fig. 13。真实吞吐量曲线与预测曲线的对比展示模型对测试期走势的跟踪能力。
机制上,WA 和 SA 分别作用在不同阶段:WA 在输入端按特征重要性放大强相关变量、压低弱相关变量,SA 在模型内部强化长期依赖和变量间动态关系。两者共同构成多层信息过滤机制,论文据此解释回归预测精度提升。
管理启示
对港口运营管理而言,这类预测框架的价值在于把吞吐量预测从单一历史序列延伸到多维外部因素。运输能力、区域经济、贸易开放和相关港口指标进入模型后,管理者可以更早识别吞吐量变化方向,安排堆场、铁路班列和集疏运资源。
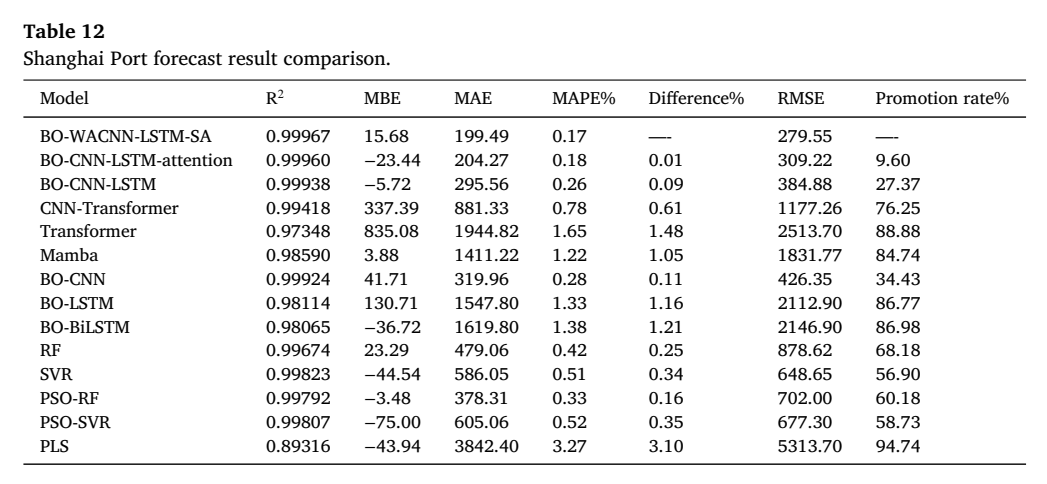
来源:Table 12。上海港预测结果用于检验模型在更大吞吐量规模港口上的迁移效果,支撑跨港口应用讨论。
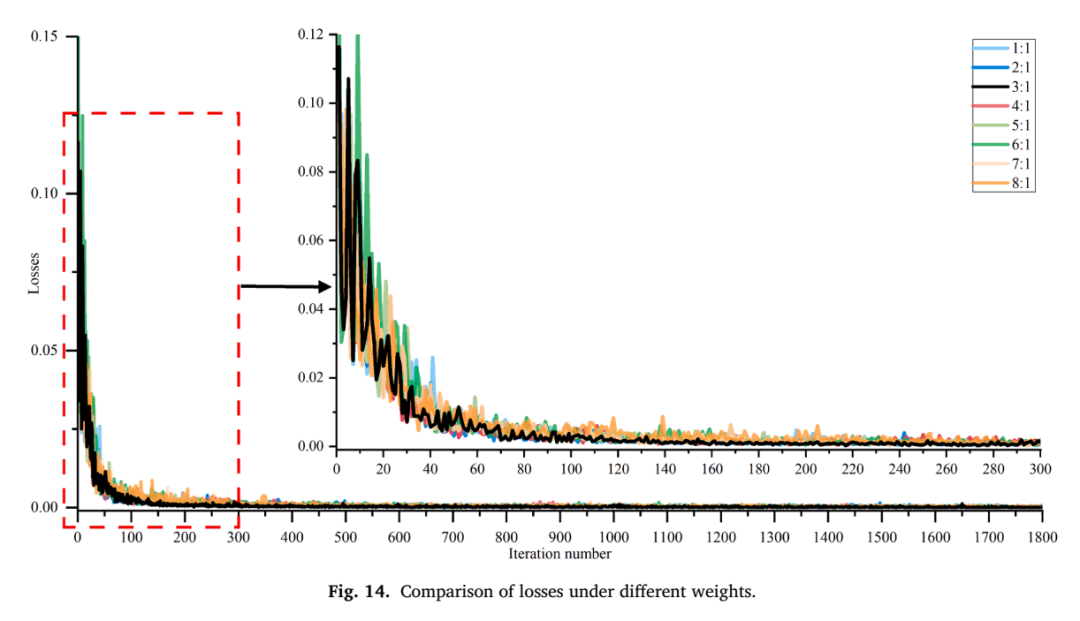
来源:Fig. 14。不同权重设置下的损失曲线用于检验 WA 权重分配的稳定性,说明强弱相关特征分组对模型训练具有实际影响。
✓预测系统建设时,应同步维护运输、经济、贸易和港口运行指标,避免只依赖单一吞吐量历史序列。
✓低频月度指标用于日度预测前,需要做时间粒度增强,并保留原月度总量约束。
✓港口间迁移应用前,应先比较样本规模、波动范围和吞吐量分布,再判断模型是否需要重新校准。
✓深度模型服务于运输资源提前布局和调度,输出结果应接入班列计划、堆场能力和设备排班等具体决策。
这篇论文给港口预测任务提供了一条可复用路线:先把多源指标整理成更适合深度学习的输入,再用特征加权和自注意力模型提高对复杂吞吐量波动的刻画能力。
论文:A multi-dimensional feature-optimized deep learning framework with self-adaptive attention for container throughput forecasting in sea-rail intermodal systems
作者:Wenxin Li,Yuhonghao Wang,Jingwei Guo,Der-Horng Lee
期刊:Transportation Research Part C
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


