链上镖师 / Chain Biaoshi
IJPE|库存订货点优化:把概率预测交给强化学习
两家批发商真实数据中的 DeepAR、ETS 与 DRL 组合实验
这篇论文用概率需求预测加深度强化学习优化批发库存订货点,在 95% 服务水平场景下能降低库存成本,在 99% 高服务水平场景下收益边界明显。
- 01:研究对象是周期盘点下的固定订货量库存系统,核心决策是每个 SKU 是否触发补货。
- 02:作者把需求预测与订货点优化拆成两步,先生成概率预测,再由 PPO 强化学习智能体学习再订货策略。
- 03:实验使用奥地利和德国两家批发商真实数据,并与分位数订货点方法和企业现行方法对照。
研究背景
批发库存规划同时受到需求不确定、供应链扰动和资本成本上升的影响。疫情冲击增加了安全库存需求,俄乌战争等地缘危机又推高资金占用成本,使企业更难在库存成本和客户可得率之间维持平衡。
论文指出,很多企业仍依赖历史平均值和计划员经验做需求预测与安全库存判断。随着欧洲劳动力老龄化、资深计划员退休,库存规划流程需要更系统的数据驱动方法承接经验判断。
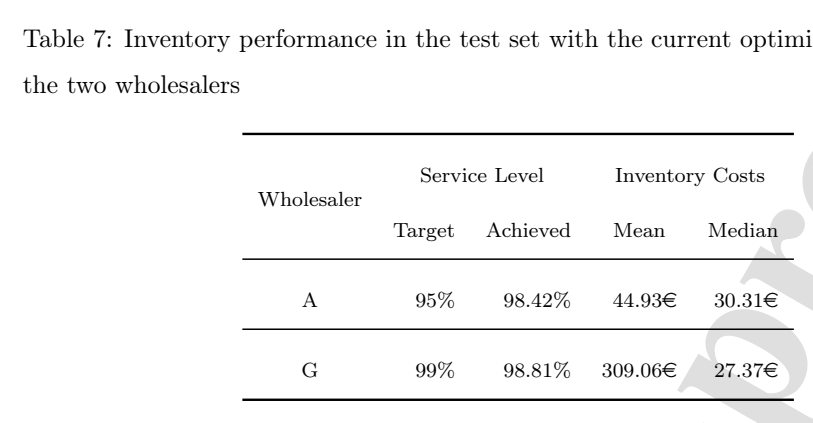
来源:Table 7。企业现行优化方法提供了服务水平与库存成本基线,用于衡量新方法是否具备实际改进空间。
核心问题
论文的研究问题是:在什么条件下,基于深度强化学习的订货点优化能比标准基准策略更好地平衡库存成本与服务水平约束。
作者把服务水平定义为所有客户需求被满足的时期占比,并把目标服务水平作为外生管理输入。优化目标是在满足企业预设可得率策略的同时降低库存水平和库存持有成本。
01预测侧比较 ETS、全局 DeepAR 和分群 DeepAR。
02优化侧比较基础分位数订货点、服务水平修正分位数订货点和 DRL 策略。
03评估侧同时观察预测误差、服务水平、平均库存成本和中位库存成本。
方法框架
框架采用两步设计:第一步用概率模型预测未来需求分布,第二步让强化学习智能体根据预测分位数、库存状态、在途订单、提前期、订货量和目标服务水平决定是否补货。
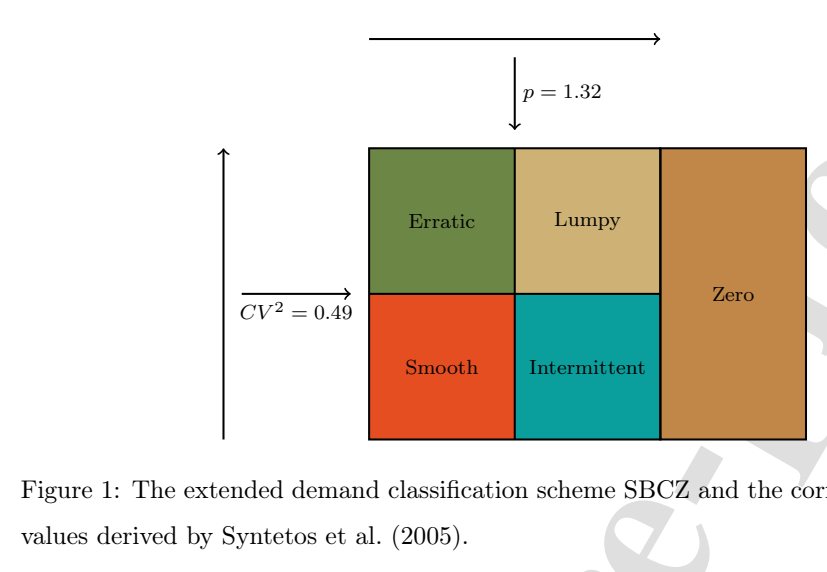
来源:Fig. 1。SBCZ 分类用平均需求间隔 p=1.32 与需求波动度 CV²=0.49 划分 smooth、erratic、lumpy、intermittent,并加入 zero 类 SKU。
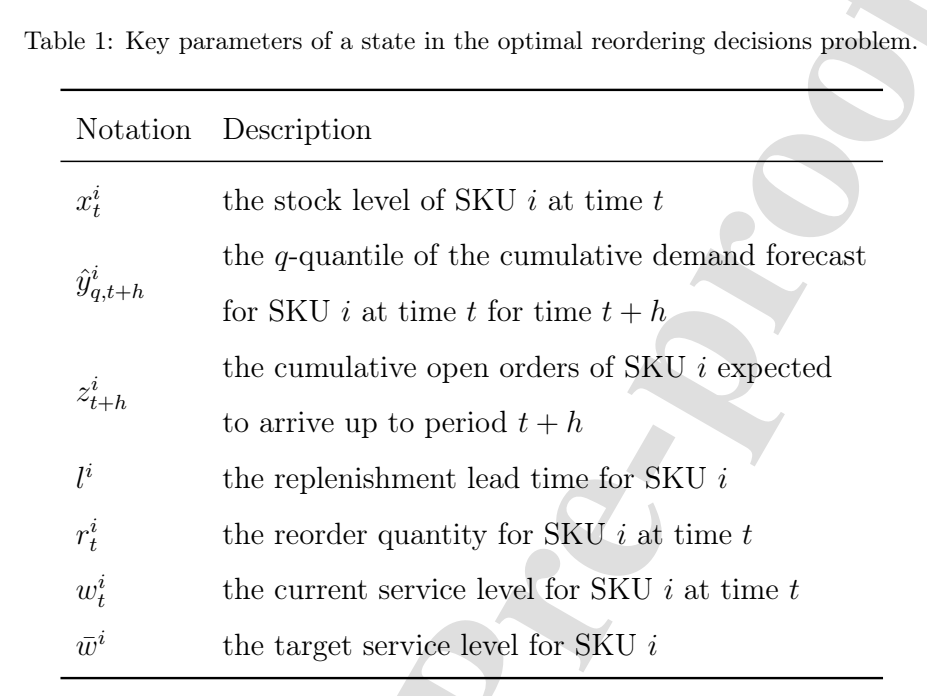
来源:Table 1。DRL 状态包含库存水平、预测分位数、在途订单、提前期、订货量和服务水平等关键参数。
1按 SKU 历史需求计算间歇性和波动度,并形成 SBCZ 需求簇。
2分别训练 ETS、全局 DeepAR 和分群 DeepAR,输出需求分布与分位数。
3把预测分布与库存状态输入 PPO 智能体,学习周期盘点下的补货动作。
4在测试集上模拟库存演化,比较服务水平和库存成本。
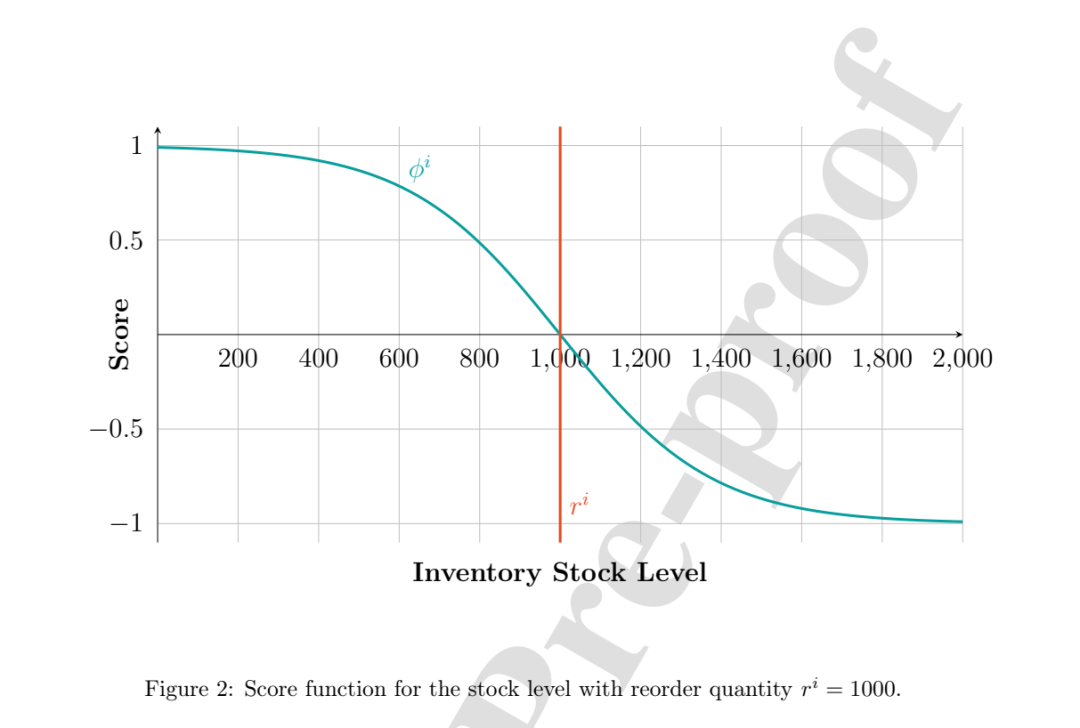
来源:Fig. 2。库存水平评分函数把低在手库存映射为较高得分,并在库存超过两倍订货量附近给出低分。
案例或实验设置
实验数据来自两家真实批发商:奥地利批发商 A 和德国批发商 G。A 覆盖 6 个仓库、94,972 个唯一商品和 147,895 个 SKU,时间从 2017 年 4 月到 2023 年 10 月;G 覆盖 4 个仓库、40,615 个唯一商品和 76,675 个 SKU,时间从 2012 年 7 月到 2024 年 2 月。
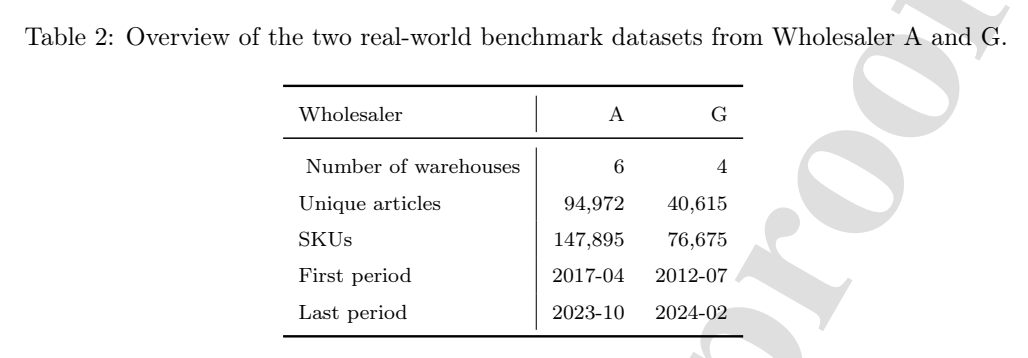
来源:Table 2。表中列出两家批发商的仓库数、唯一商品数、SKU 数和样本时间跨度。
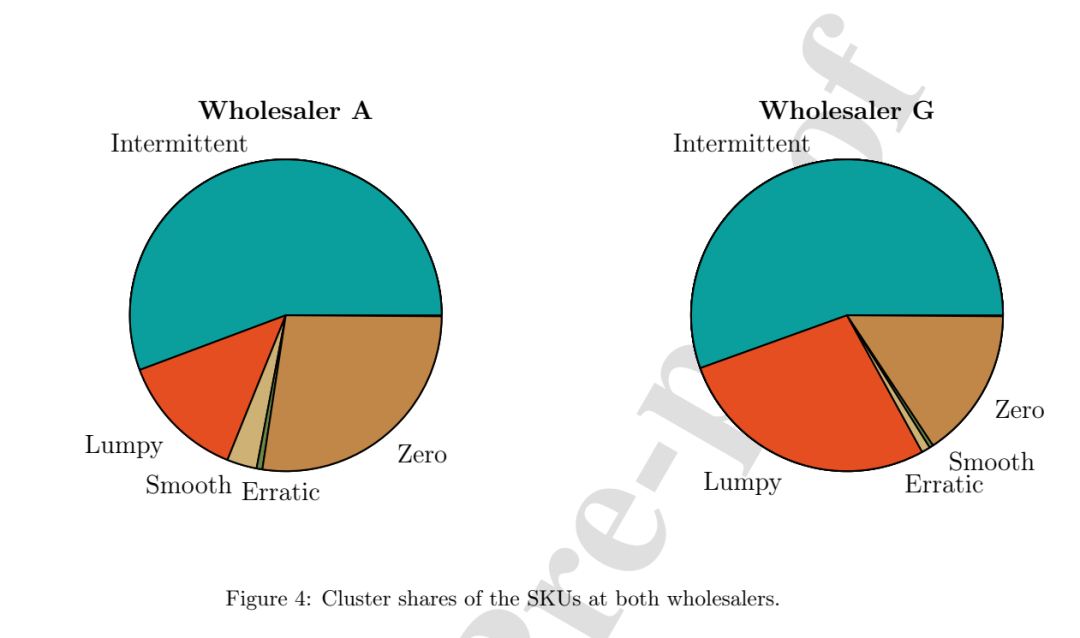
来源:Fig. 4。两家批发商均有大量间歇性、零需求和 lumpy SKU,解释了论文为何关注概率预测与分群建模。
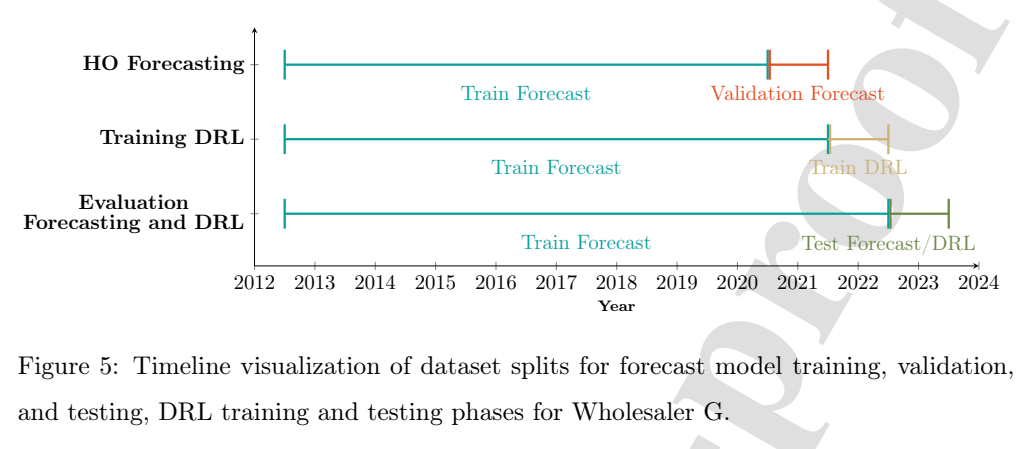
来源:Fig. 5。实验将预测调参、DRL 训练和测试阶段拆分,避免信息泄漏。
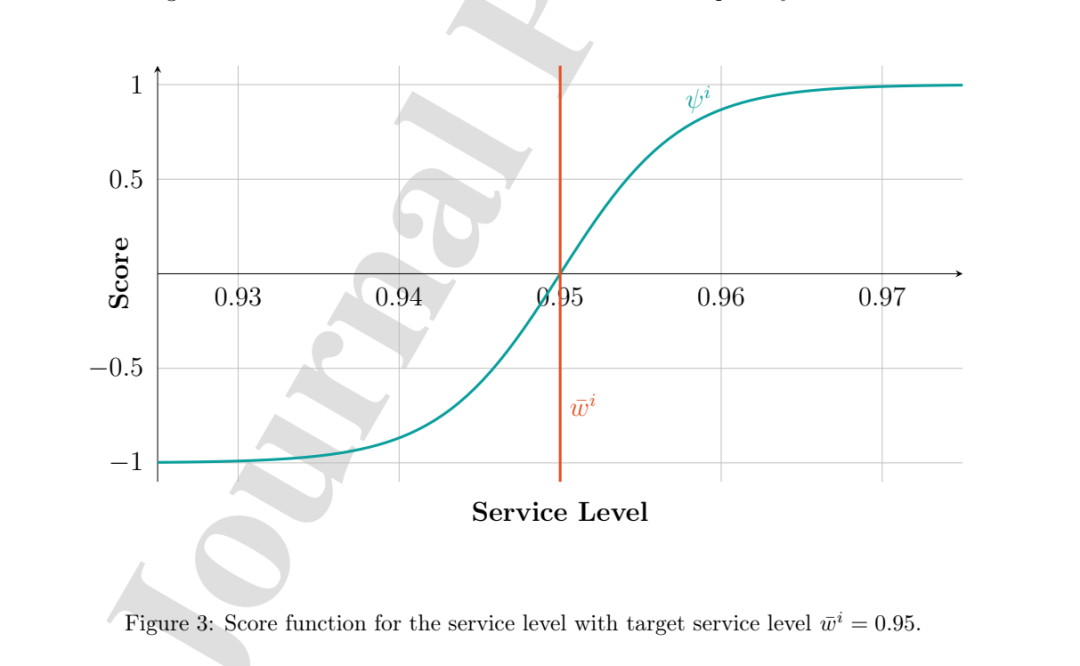
来源:Fig. 3。服务水平评分函数围绕目标服务水平设置奖惩区间,示例中目标服务水平为 0.95。
结果分析
预测精度结果显示,按 AvgRelRMSE 和 Quantile Loss 评价时,ETS 在两家批发商整体上表现最好;按 MASE 评价时,分群 DeepAR 整体表现最好。论文强调,预测误差领先并不会自动转化为库存绩效领先。
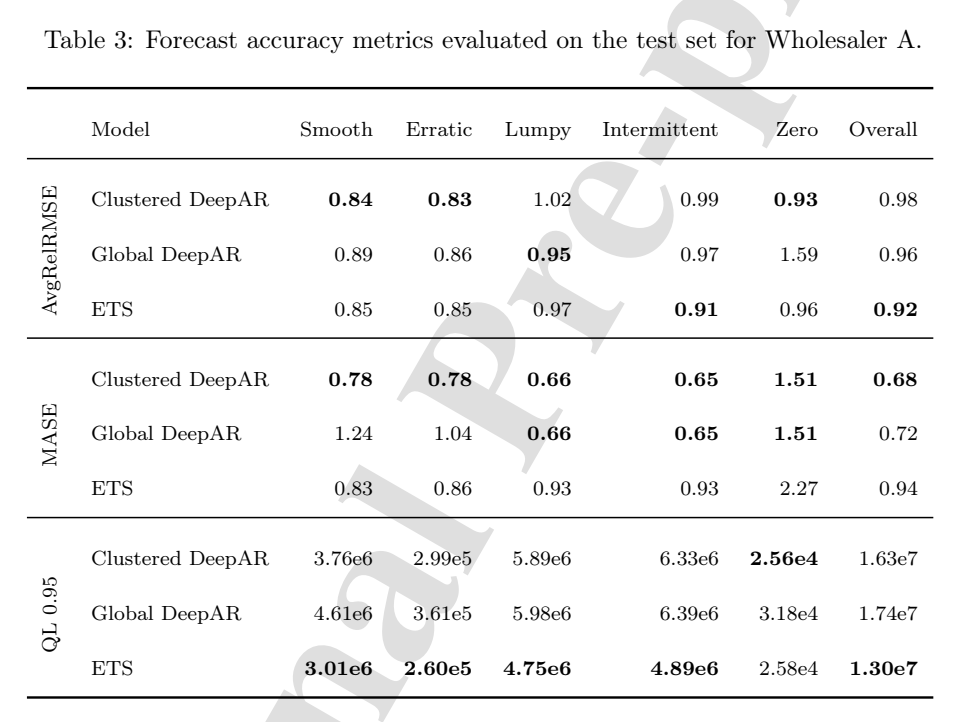
来源:Table 3。批发商 A 中,ETS 的整体 AvgRelRMSE 为 0.92,整体 QL0.95 为 1.30e7;分群 DeepAR 的整体 MASE 为 0.68。
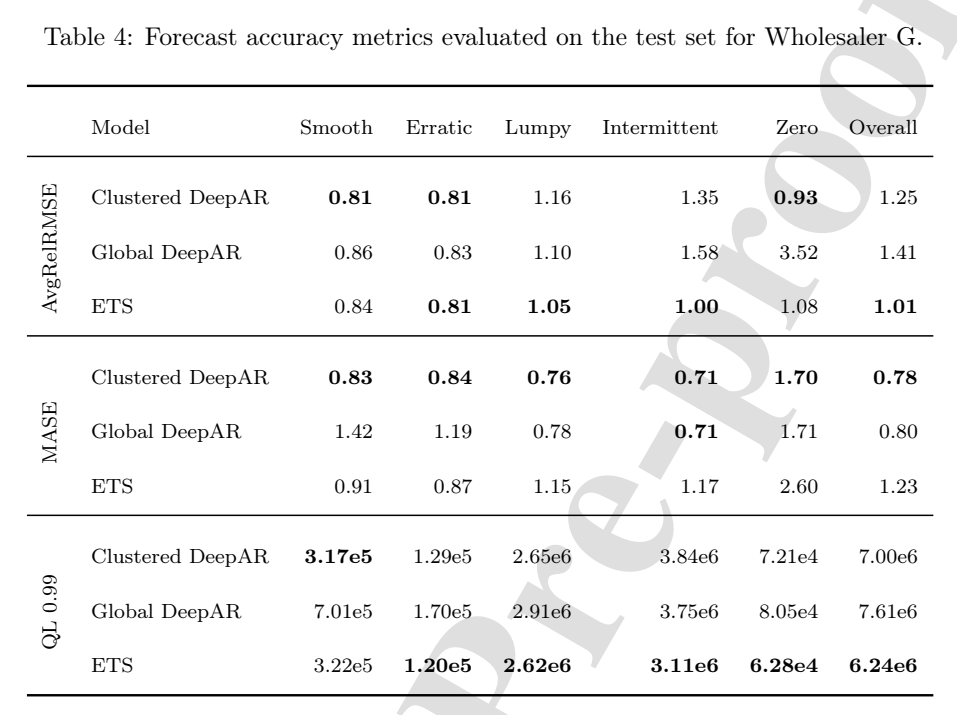
来源:Table 4。批发商 G 中,ETS 的整体 AvgRelRMSE 为 1.01,整体 QL0.99 为 6.24e6;分群 DeepAR 的整体 MASE 为 0.78。
库存绩效是论文的核心判断依据。批发商 A 的目标服务水平为 95%,DRL 与 ETS 预测组合在超过目标服务水平的同时,相比基础 QRP 将平均库存成本降低 8.2%,相比服务水平修正 QRP 降低 11.7%。
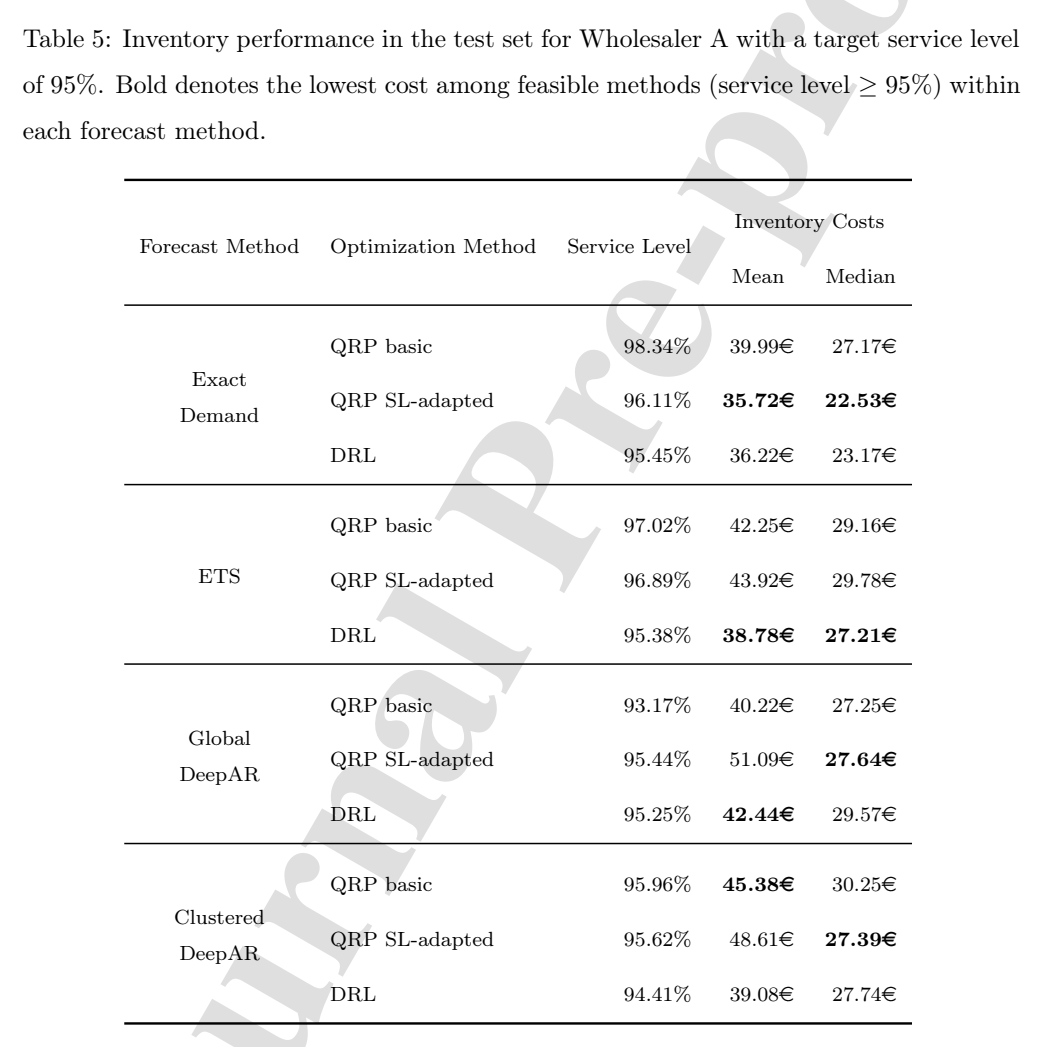
来源:Table 5。批发商 A 的结果显示,DRL 在 ETS 预测输入下实现服务水平达标和库存成本下降。
管理启示
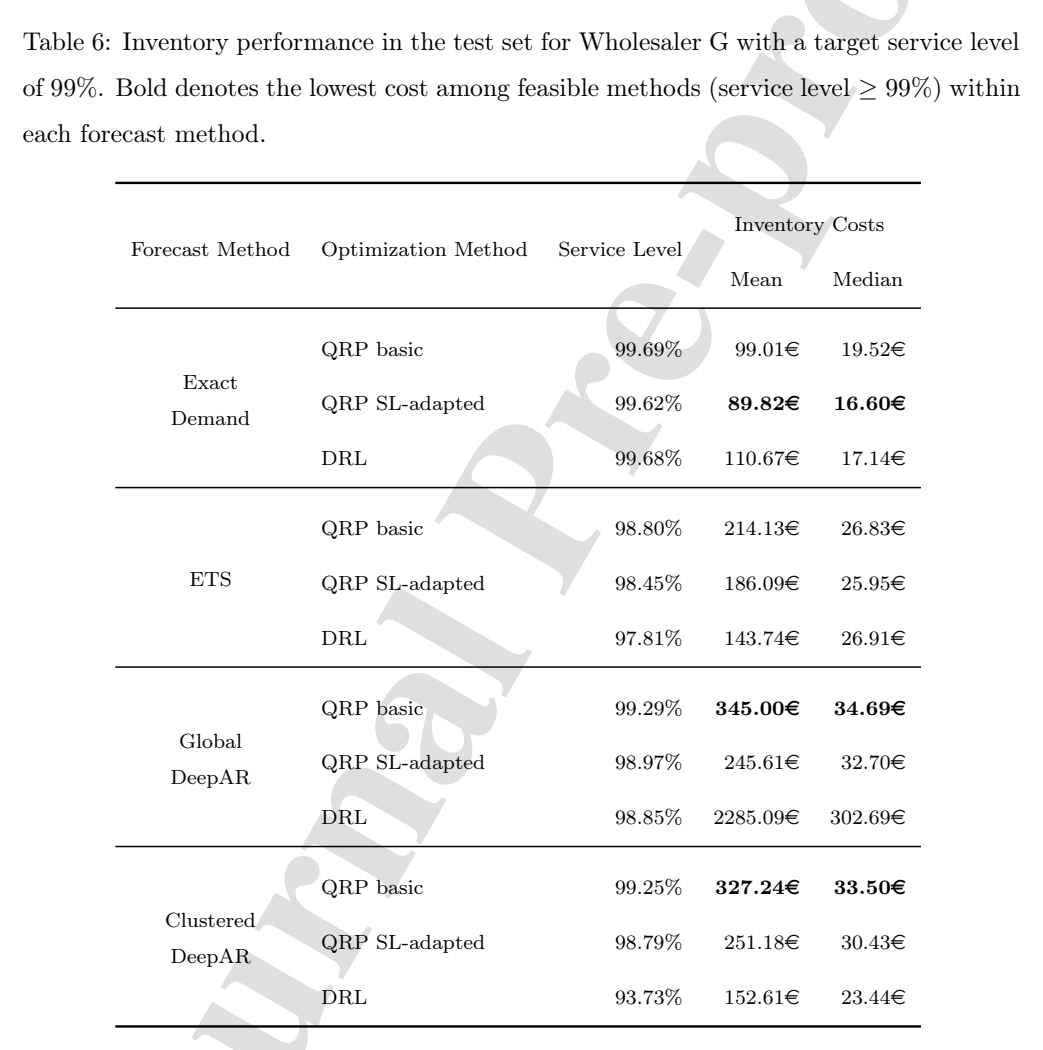
来源:Table 6。批发商 G 的 99% 目标服务水平场景中,DRL 未能稳定达到目标,显示高可得率约束下的适用边界。
论文给出的管理含义是,概率预测加 DRL 更适合目标服务水平适中、允许策略从历史仿真中学习补货权衡的场景。面对 99% 这类严格可得率要求,单次错误补货会显著拉低实现服务水平,奖励信号也更难稳定收敛。
批发商 A 目标服务水平
95%
DRL 与 ETS 组合在该场景下实现服务水平达标并降低库存成本。
批发商 G 目标服务水平
99%
DRL 在该场景下未能稳定达到目标服务水平。
对企业落地而言,最有价值的设计选择是保留可检查的预测中间产物。计划员可以先审视需求分布,再让优化器把预测信号转化为补货动作,这种结构更容易接入已有预测系统。
✓先在目标服务水平适中的 SKU 组合上验证库存成本收益。
✓把预测模型与优化策略作为绑定组合评估,避免只看预测误差排序。
✓对高服务水平、高价值或长覆盖订单保留人工检查预测分布的节点。
✓在奖励函数中继续改进服务水平约束,降低高可得率场景下的训练不稳定性。
论文:Integrated Demand Forecasting and Reinforcement Learning for Order Point Optimization in Inventory Planning
作者:Georg Schett,Claudia Ehrig,Benjamin Schwendinger,Ursula Neumann,Nico Beck,Florian Stadler,Fazel Ansari
期刊:International Journal of Production Economics
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


