链上镖师 / Chain Biaoshi
TRE 2026.8|认知不确定下无人机充电站选址与巡逻路径规划
西安交通大学与香港理工大学联合研究提出两阶段框架,融合分布式多智能体强化学习与时空网络模型,在信息缺失条件下实现无人机充电站选址与巡逻调度,并通过自适应加权轮询策略平衡系统效率与公平。
- 核心方法:
分布式多智能体强化学习(DMARL)与时空网络模型组合的两阶段决策框架 - 关键创新:
自适应加权轮询策略(AWRRS),以可调函数控制效率与公平的连续权衡谱系 - 实验验证:
真实城市基站数据上,DMARL 无先验信息达近优效用 770.74,远超集中式 RL 的 299.96
研究背景与动机
无人机在城市巡逻、环境监测和灾害响应中展现出显著的降本增效潜力,但其大规模部署受制于两大瓶颈:信号覆盖范围的有限性以及电池续航的约束。信号基站作为远程控制中继站,是维持无人机连续作业的关键基础设施。其中塔式基站可以安装充电坞,为无人机提供电力补充,而杆式基站仅承担信号转发功能。充电坞选址与巡逻路径规划由此构成紧密耦合的设施选址-路径问题,属于经典的 NP-hard 问题。
现有研究要么假设异常事件概率和损失量级等关键参数已知,从而依赖混合整数规划、遗传算法或模拟退火等传统优化方法;要么仅处理单方面的路径规划或选址问题,未将两者置于认知不确定——即连基本概率分布都无法获取——的条件下统一求解。该论文的研究动机正是填补这一方法论缺口。
问题定义与两阶段框架
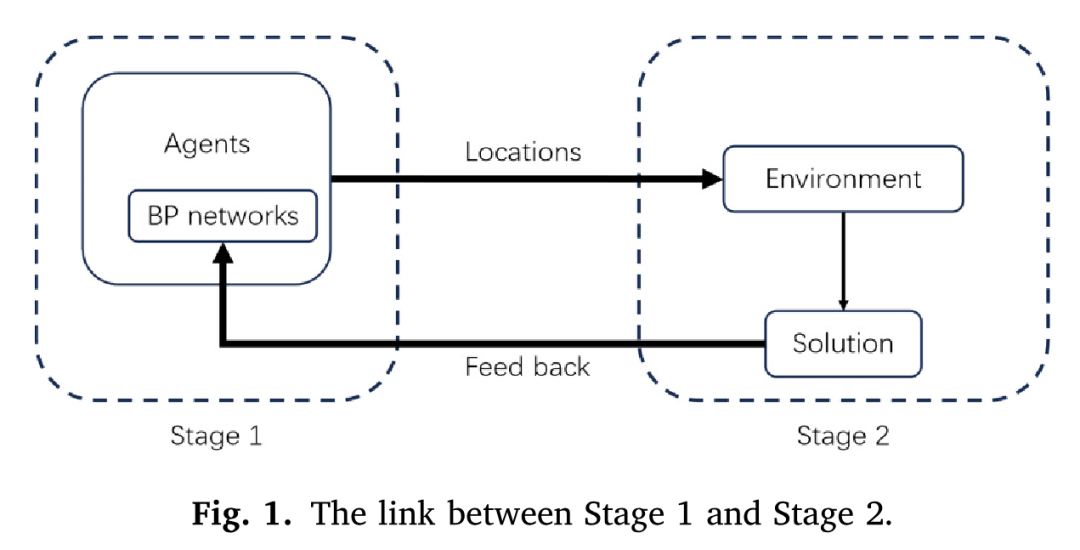
两阶段框架的连接关系,第一阶段确定充电坞位置,第二阶段基于选址结果进行巡逻调度规划。(取自 Fig.1)
研究将巡逻区域按信号基站分布划分,确保每个区域对应一个基站。每个区域 i 在每个周期内以未知概率 p_i 发生异常事件,造成未知分布的损失。无人机若在周期内发现异常,系统获得与损失量相当的奖励,异常随即被清除;未被发现的异常遗留至下一周期。系统效用定义为总奖励减去四类成本:充电坞维护成本、无人机维护成本、飞行距离成本与巡逻时间成本。目标是在认知不确定下最大化未来累计折现效用。
论文提出两阶段解决方案。第一阶段通过分布式多智能体强化学习确定充电坞在塔式基站上的部署位置;第二阶段基于选址结果,使用时空网络模型对无人机的飞行、巡逻和充电操作进行调度优化。为兼顾效率与公平,引入自适应加权轮询策略 AWRRS 动态调整各区域的巡逻频率。两个阶段的交互通过共享效用信号形成闭环:第一阶段的选址输出约束第二阶段的可行域和目标函数,第二阶段产生的效用反馈回第一阶段用于 Q 值更新。
1步骤1:各智能体基于局部观察与 BP 神经网络估计 Q 值,做出充电坞选址决策
2步骤2:选址结果输入时空网络模型,在约束条件下求解最大效用巡逻调度方案
3步骤3:无人机按调度执行任务,系统收集各区域奖励并计算总效用
4步骤4:效用反馈更新各智能体 Q 网络参数,同时更新区域权重 w_i 与未巡逻计数 n_i
5步骤5:AWRRS 根据 w_i 与 n_i 动态调整下一周期的目标函数,平衡效率与公平
第一阶段:分布式强化学习选址
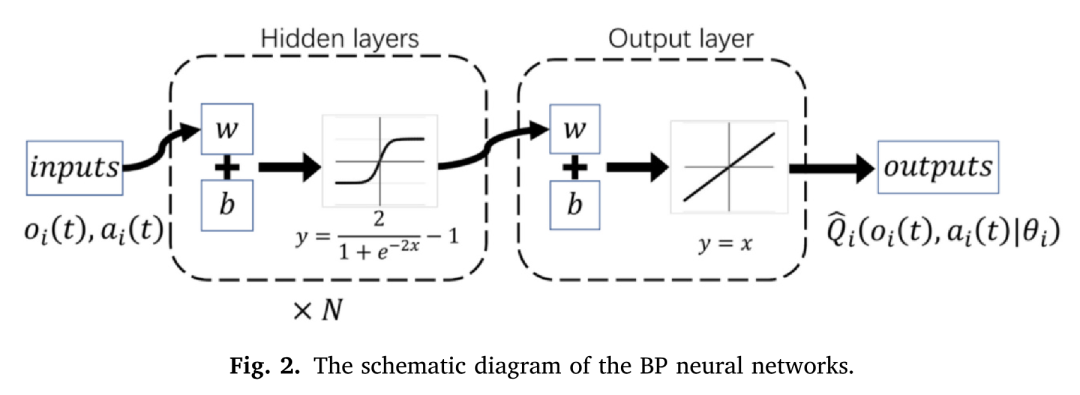
用于近似 Q 值的 BP 神经网络结构示意图,每个智能体独立维护一个网络。(取自 Fig.2)
在第一阶段,每个塔式基站区域分配一个独立智能体。智能体的观察范围限定于其信号覆盖可达的相邻区域——仅感知这些区域内是否已安装充电坞,而非全局状态。基于局部观察 o_i(t),智能体通过 BP 神经网络估算各行动对应的 Q 值,并按 ε-贪婪策略做出二值或多值决策 a_i(t),决定本区域安装充电坞的数量。
Q 值的更新采用 SARSA 时序差分规则。所有智能体共享同一全局效用 u(t),因此形成合作博弈。由于每个智能体仅需处理 2^h 量级的状态空间(h 为相邻区域数),而集中式强化学习需应对 2^{|I|} 的指数级状态空间,DMARL 在计算复杂度上具有线性可扩展性优势。参数更新时间复杂度方面,DMARL 为 O(|I|·H·h²),集中式 RL 则为 O(|I|²·H·h),其中 h ≪ |I|。
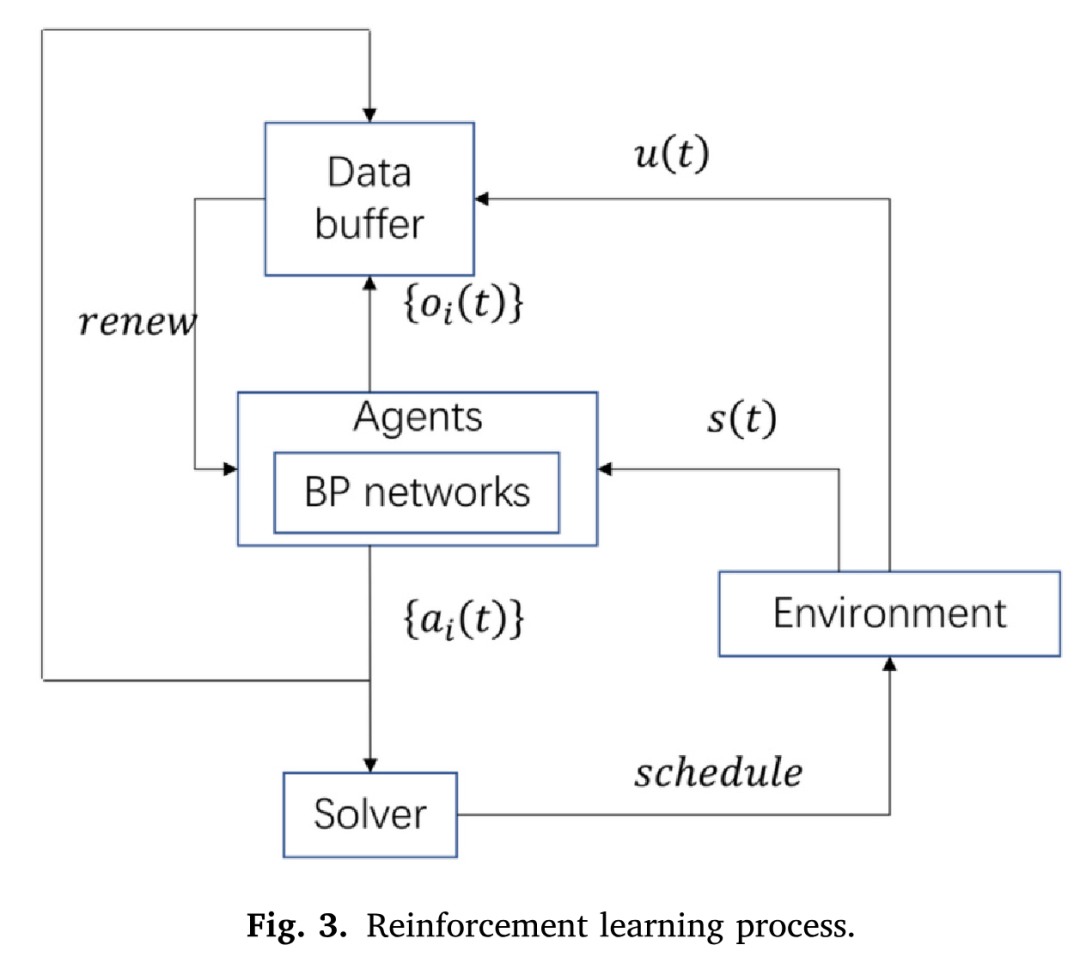
多智能体强化学习的交互与训练流程。(取自 Fig.3)
DMARL 的核心优势:当网络拓扑发生变化时,仅需重训练观察范围受影响的智能体,未受影响的智能体可直接复用已有策略,无需像集中式方法那样重建整个模型。
第二阶段:时空网络模型与自适应轮询
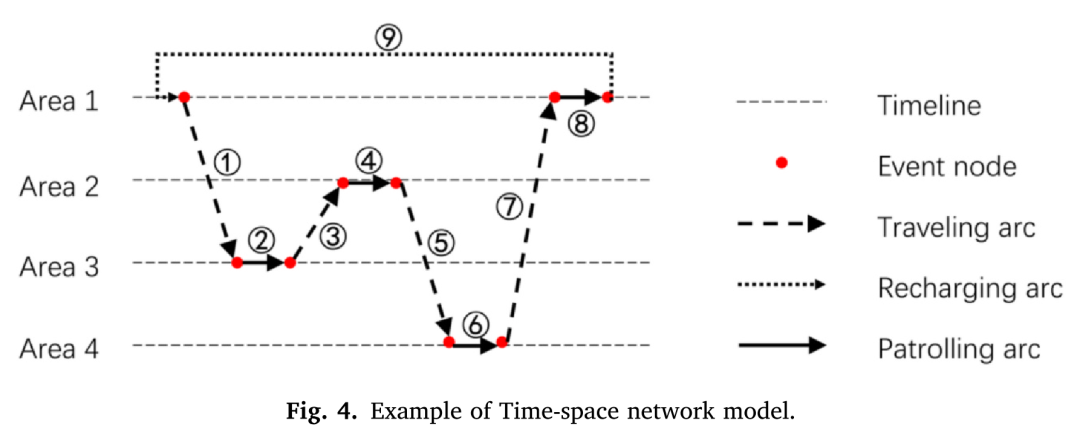
时空网络模型示例,展示三种弧类型的闭环结构:旅行弧、巡逻弧与充电弧。充电弧时间方向与旅行弧、巡逻弧相反,从而使三种弧构成闭环,实现无人机的连续不间断运行。(取自 Fig.4)
第二阶段在给定充电坞位置后,采用时空网络模型优化调度。模型将每个区域映射为一条时间线,时间线上的事件节点 (i, τ) 表示无人机在区域 i 于时刻 τ 完成上一操作并启动下一操作。三类弧对应三种操作:旅行弧(跨区域转移)、巡逻弧(同区域值守)和充电弧(本区域充电,时间方向与另两类相反)。模型约束包括:各事件节点进出弧数平衡、充电坞数量上限、无人机总数上限以及信号覆盖范围对直接转移的限制。
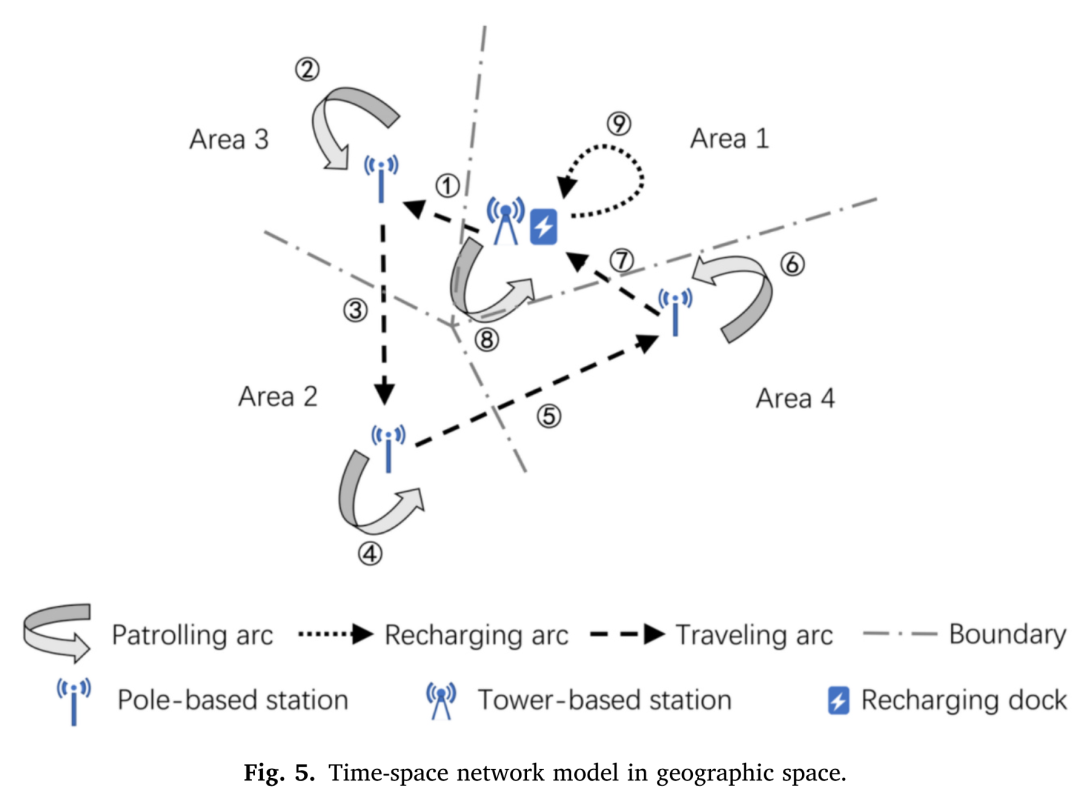
时空网络模型在地理空间中的实际运行映射,展示无人机一个周期内的完整操作序列。(取自 Fig.5)
当参数 w_i 收敛后,各区域的预计边际巡逻成本固定。如果 f(n_i)w_i/F 超过边际成本,该区域便会在当前周期获得巡逻资源。这一机制无需逐场景显式计算边际成本,却能在调度中隐式完成成本-收益权衡。
由于认知不确定性下无法直接获取各区域期望奖励 er_i,研究引入可学习权重 w_i 作为代理指标。w_i 通过迭代更新公式逐步逼近真实期望奖励,其中 β_i 初始为 1 并递减,满足随机逼近收敛条件。
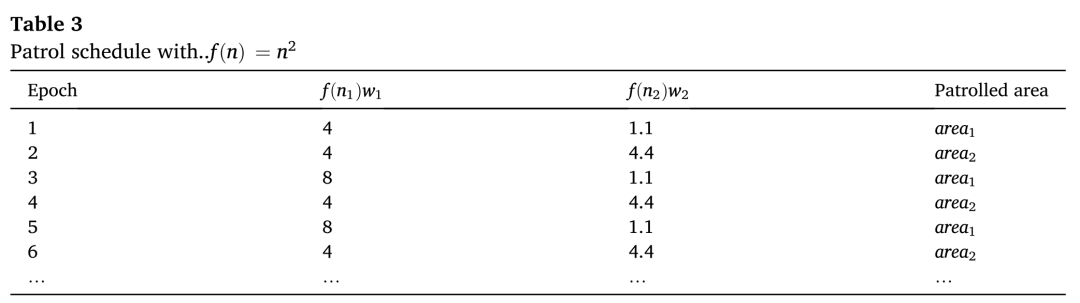
AWRRS 的核心在于引入函数 f(n_i) 作为 w_i 的乘数,其中 n_i 是区域 i 距上次被巡逻经历的周期数。目标函数修订为最大化各区域加权预期奖励并减去各项成本。论文通过理论分析证明:f(n) 的增长速率决定了系统在效率与公平之间的具体位置。以 f(n)=n^k 为例,k 越大则函数增长越快、预期巡逻间隔越小、区域间巡逻频率差异越收敛——公平性提高但总效用降低。此外,研究证明 AWRRS 在稳态下生成的调度方案是双目标优化问题(最大化效用与最小化巡逻延迟)的局部 Pareto 最优解。
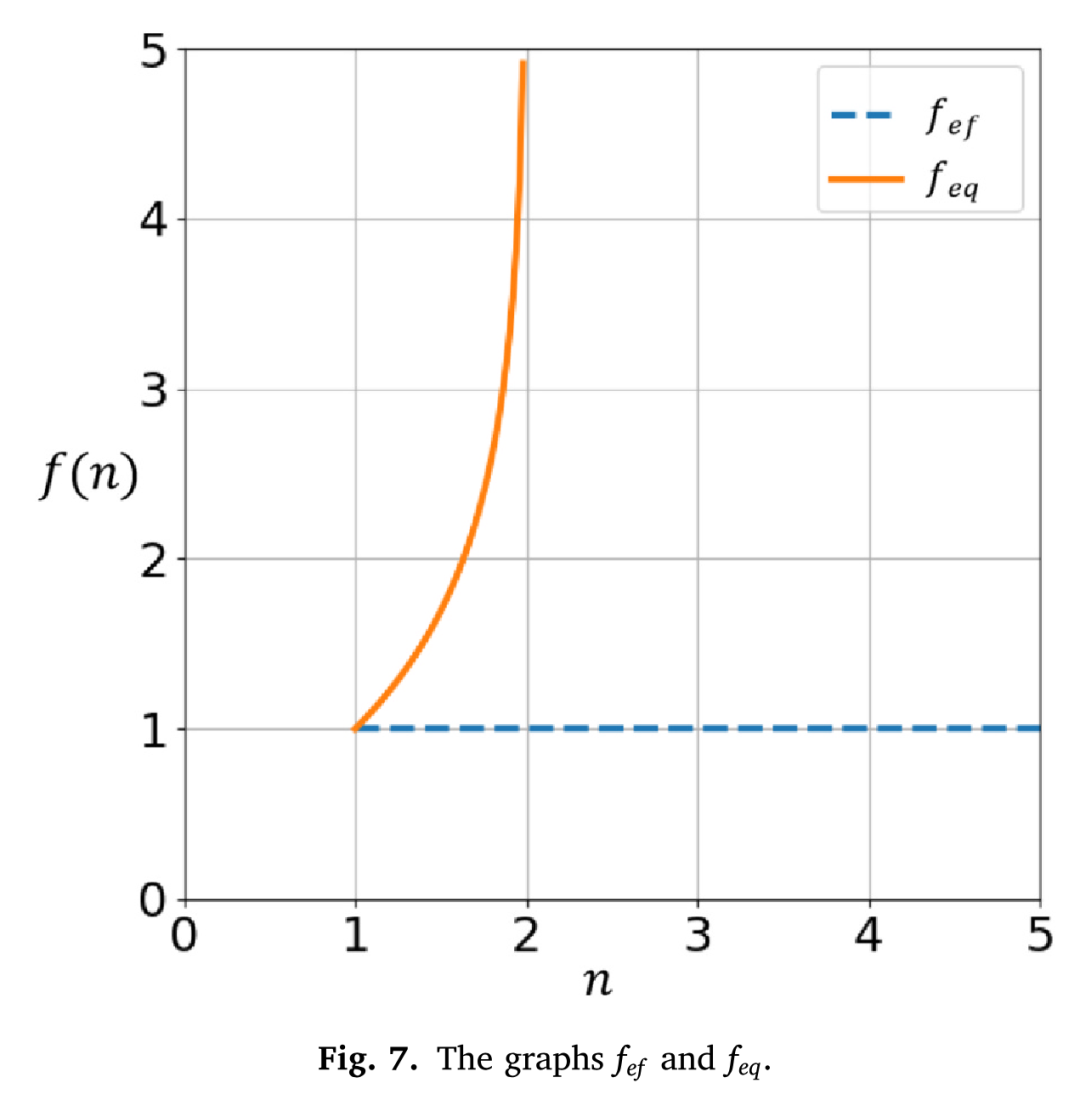
两种极端策略的函数图像:f_ef(n)=1(纯效率)与 f_eq(n) 趋于无穷(纯公平)。所有折中策略的函数斜率介于两者之间。(取自 Fig.7)
实验设计与参数设置
实验基于某城市真实的信号基站分布数据(经脱敏处理)进行数值仿真。为每个区域指派了异常发生概率 p_i 和异常发生时的平均奖励 π_i。实验监控两个核心指标:系统稳定后的每周期效用(取 200 个周期的均值、最大值和最小值),以及各区域巡逻频率 freq_i。同时引入协方差指标 cov,度量期望奖励与巡逻频率之间的正相关性——cov 越高表示系统越偏向效率导向的资源分配。
实验设置了一个控制组和五个实验组。控制组 G1 拥有完整的 p_i 和 π_i 先验信息,使用混合整数规划求解最优选址与调度,作为性能上界。实验组 GE1、GE2、GE3 分别使用三种不同增长速率的 AWRRS 函数:f_1(n)=1(纯效率导向)、f_2(n)=1+log(n)(适度平衡)、f_3(n)=n(公平导向)。GE4 使用集中式单智能体强化学习(神经元总数与 DMARL 可比)。所有 BP 神经网络设有 10 个隐藏层,每累积 10 条新训练数据更新一次网络参数。MATLAB 调用 CPLEX 12.6.1 求解每周期巡逻规划问题,单次求解时限 15 秒。
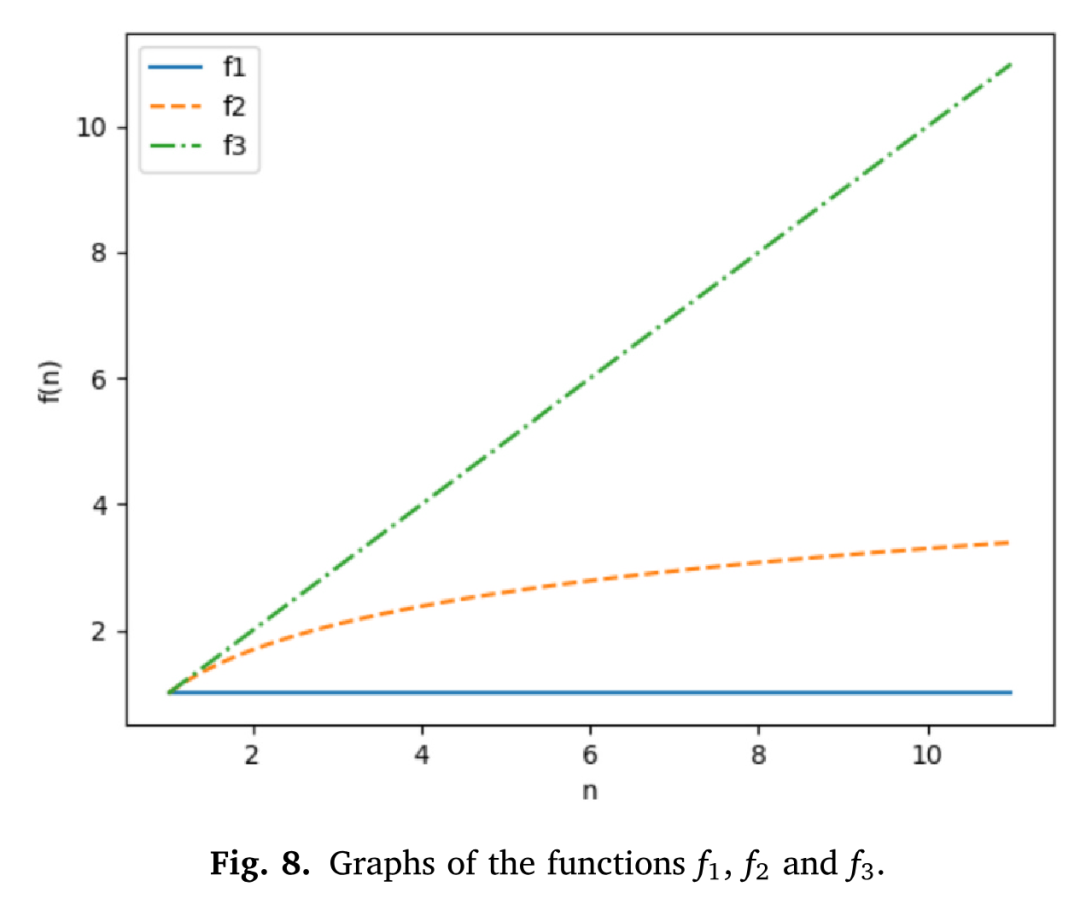
实验使用的三种轮询函数曲线:f1(n)=1、f2(n)=1+log(n)、f3(n)=n,增长速率逐级递增。(取自 Fig.8)
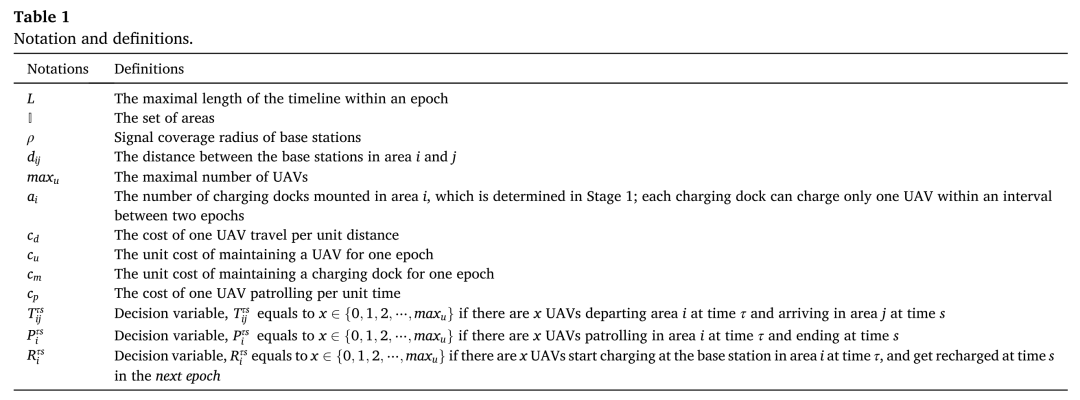
模型参数、决策变量与集合元素的定义汇总。(取自 Table 1)
核心实验结果
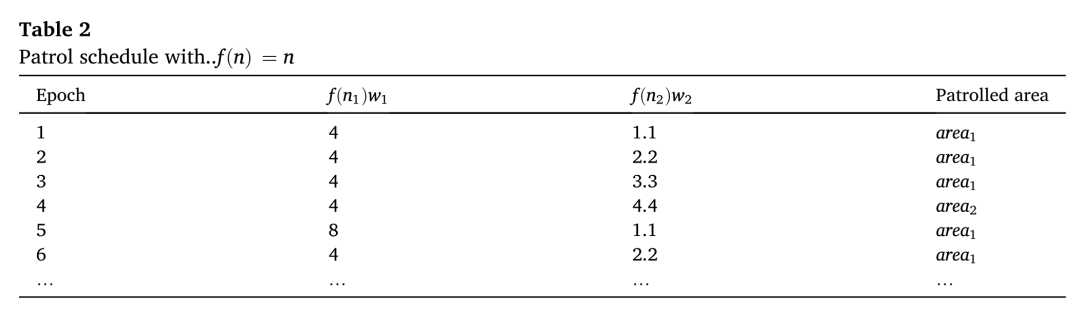
以 f(n)=n 和 f(n)=n² 为例的 AWRRS 巡逻调度过程对比。前者每 4 周期巡逻区域 1 三次、区域 2 一次;后者两区域交替巡逻,频率相等。(取自 Table 2 与 Table 3)
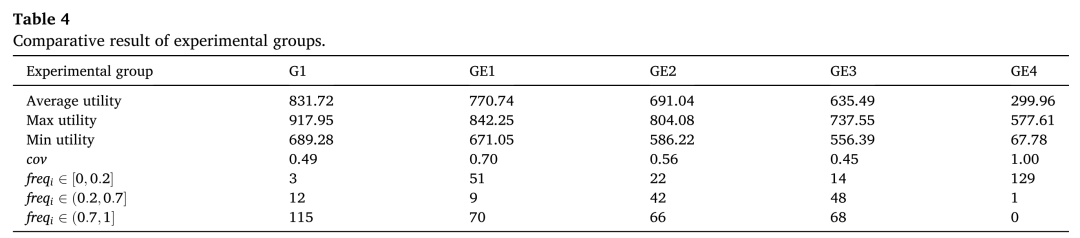
经过 2000 个周期的训练后,各组策略与 Q 值趋于稳定。控制组 G1 平均效用 831.72,代表理想信息条件下的近似最优值。DMARL 组 GE1(纯效率)平均效用 770.74,达到 G1 的约 92.7%,且无需任何先验信息。集中式 RL 组 GE4 平均效用仅为 299.96,显著低于所有 DMARL 组,验证了分布式方法在同等计算资源下的显著优势。
DMARL 平均效用(GE1)
770.74
无先验信息,达理想上界 G1(831.72)的 92.7%
集中式 RL 平均效用(GE4)
299.96
同等神经元总量下,仅为 DMARL 的 38.9%
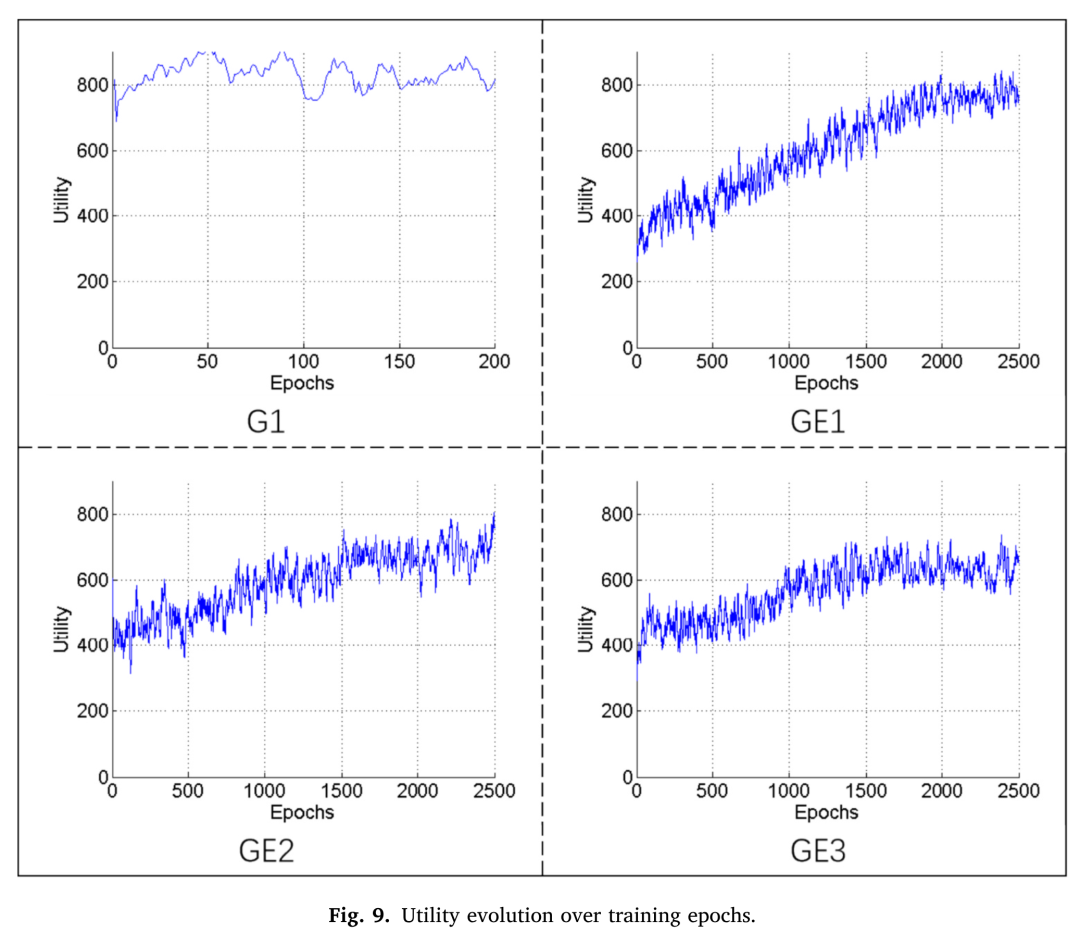
控制组 G1 与实验组 GE1-GE3 的效用演化曲线。G1 全程维持高水平,实验组经 2000 周期训练后效用显著提升并趋于稳定。(取自 Fig.9)
各实验组综合结果对比:GE1 效率最高但公平性最弱(51 个区域低频巡逻),GE3 公平性最强但效用最低(635.49),GE2 居中。cov 值清晰反映效率倾向梯度。(取自 Table 4)
AWRRS 的效率-公平权衡在数据中表现清晰。GE1(f_1(n)=1)追求纯效率,cov 最高达 0.70,但有 51 个区域在 80% 以上的周期未曾被巡逻,资源高度集中在少数高价值区域。GE3(f_3(n)=n)以公平为导向,cov 降至 0.45,低频巡逻区域减少至 14 个,巡逻覆盖显著改善,但平均效用降至 635.49。GE2(f_2(n)=1+log(n))的各项指标均介于两者之间,cov 为 0.56,低频巡逻区域 22 个,体现了温和的折中方案。
f(n) 的增长速率是一种连续可调的关键参数:增长越慢越偏向高效集中,增长越快越偏向广泛覆盖。系统设计者可根据任务属性——例如常规巡逻优先效率、灾害应急优先覆盖——选择适当的 f(n) 参数。
扩展实验与鲁棒性验证
研究通过四项扩展实验全面验证了方法的有效性。第一项是规模缩放实验:在 10、30 和 130 个区域三种规模下对比 DMARL 与集中式 RL。结果表明集中式 RL 在极小规模(10 区域)下劣势不明显,但当规模增至 30 区域时差距已然显现,130 区域时差距更加悬殊(770.74 vs 299.96)。这一趋势验证了 DMARL 在大规模问题中的可扩展性优势。
不同问题规模下 DMARL 与集中式 RL 的效用对比:规模越大,分布式优势越显著。(取自 Table 5)
第二项是拓扑扩展实验:在原 130 区域基础上新增 70 区域,DMARL 仅需初始化观察范围改变的新智能体网络,其余智能体复用预训练参数,最终平均效用 1598.60 接近该规模下的标杆 1743.60。而集中式 RL 在同等条件下仅达 955.86,差距进一步扩大。
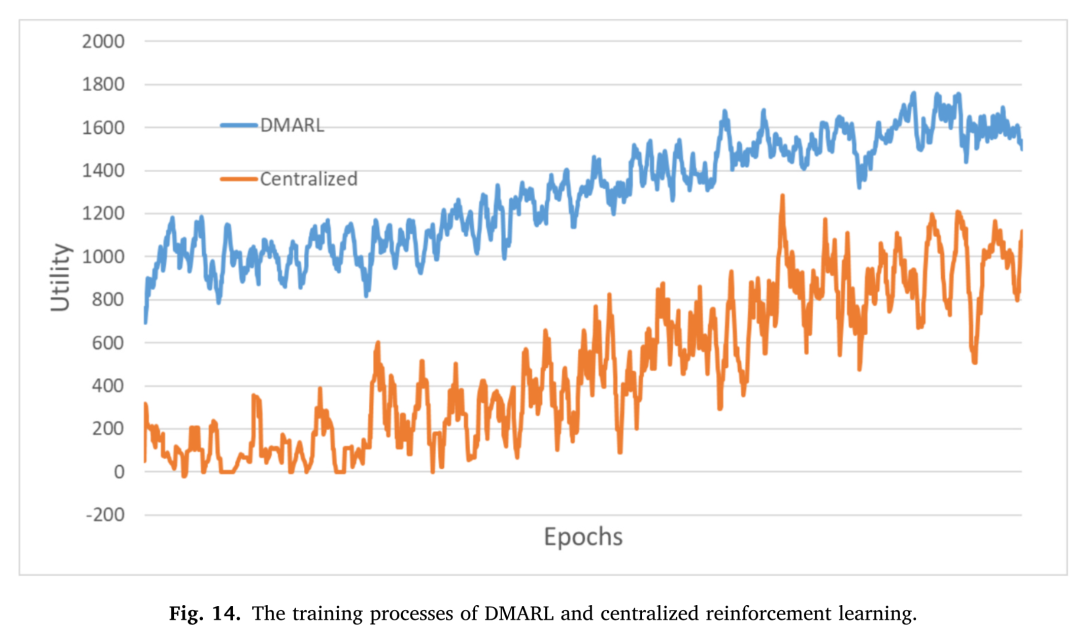
拓扑扩展实验中 DMARL 与集中式 RL 的训练过程对比,DMARL 收敛更快且效用水平更高。(取自 Fig.14)
第三项验证了与基于先验规则的 MIP 选址方法的对比:采用贪婪全覆盖策略的 GE6 平均效用 608.42,采用成本最小化策略的 GE7 仅 165.94,均远低于 DMARL 的 770.74。即便在第二阶段采用完整先验信息,DMARL 选址方案仍以 783.55 显著领先,证明信息缺失下 DMARL 的学习能力是不可替代的。
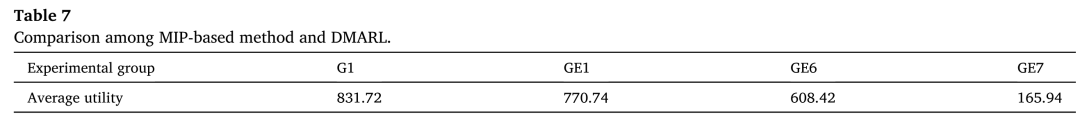
DMARL 与基于先验规则的 MIP 选址方法对比,DMARL 在无先验信息条件下显著优于两种确定性策略。(取自 Table 7 与 Table 8)
第四项验证了环境动态变化下的适应性:后 100 个周期将各区域异常概率和损失量级降至原来的 80%,实验组 GE5 通过监测长期权重与短期权重的偏差自动触发权重替换。结果显示 GE5 的效用曲线紧密追踪控制组 G2,验证了模型对动态环境的自适应能力。
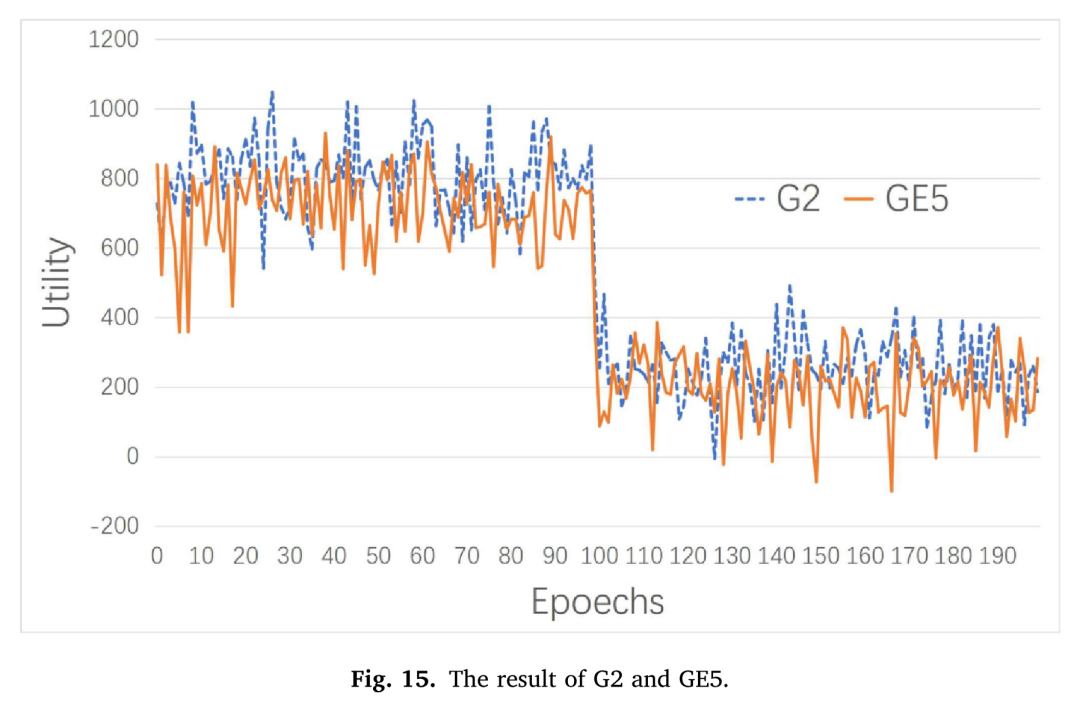
动态环境实验中控制组与实验组的效用曲线,GE5 在没有先验信息的条件下紧密追踪 G2 的性能。(取自 Fig.15)
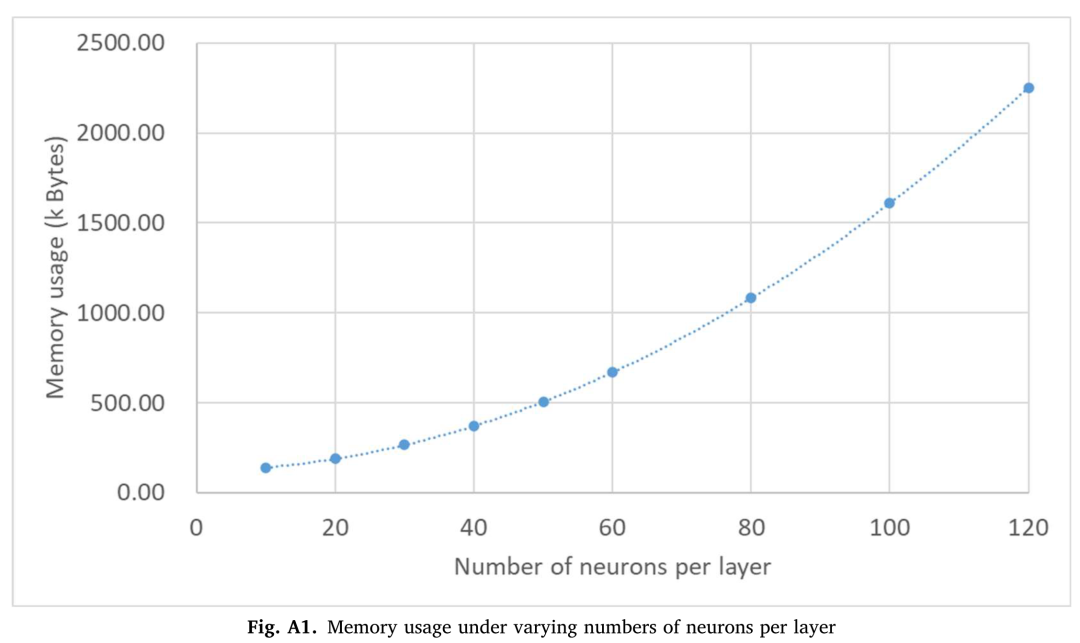
附录实验:集中式 RL 所需神经网络的内存占用与训练时间随输入维度非线性增长,而 DMARL 由于各智能体网络大小固定,总开销线性增长。(取自 Fig.A1 与 Fig.A2)
结论与实践启示
✓DMARL 在信息缺失条件下可达近似最优效用,无需先验知识即可通过学习逼近完备信息最优解
✓分布式架构在计算复杂度和可扩展性上显著优于集中式强化学习,参数更新时间复杂度为线性而非二次
✓AWRRS 通过 f(n) 的增长速率提供连续可调的效率-公平权衡空间,系统设计者可按任务属性灵活配置
✓两阶段框架具有模块化通用性,可推广至物流配送中心选址、灾后应急部署、分布式存储节点选址等其他资源受限多智能体系统
研究同时坦诚讨论了方法的适用边界。DMARL 要求所有智能体共享全局效用函数且能观察相邻智能体动作,这依赖节点间通信的可靠性。AWRRS 的稳态收敛以环境参数相对稳定为前提,若异常概率和损失量级变化剧烈,权重 w_i 的收敛将难以保证。f(n) 函数的选择目前具有一定经验性,实际部署中需要根据公平性需求迭代调试参数 k。此外,研究未纳入信号延迟、非视距链路等实际通信约束,这些是后续向工程化推进的必要方向。
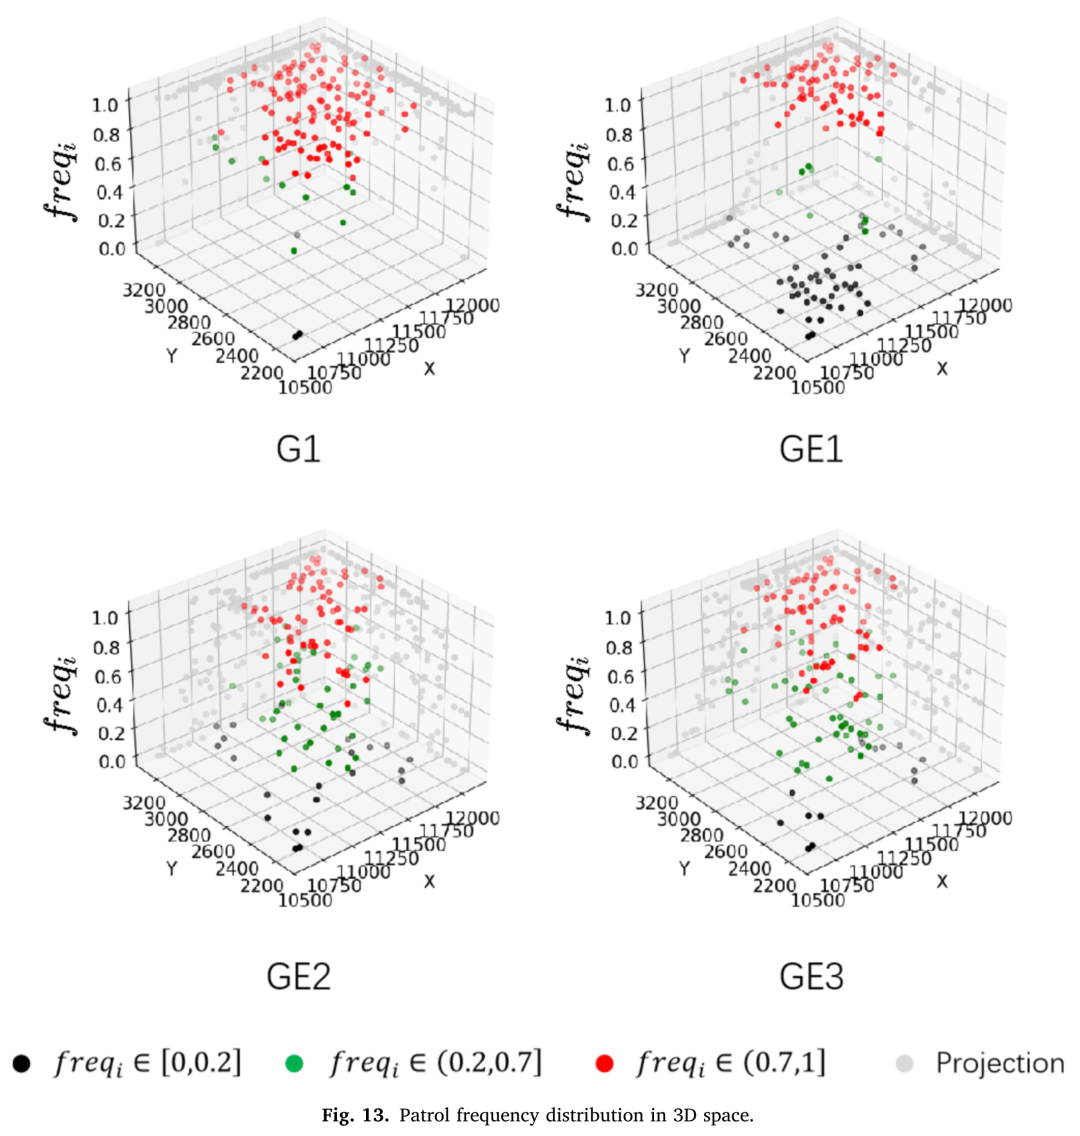
各实验组巡逻频率在三维空间中的分布散点图:G1 总体巡逻频率最高,GE1 分布差异最大,GE2 与 GE3 分布更为均匀。颜色编码区分高频(红)、中频(绿)和低频(黑)区域。(取自 Fig.13)
该框架的核心架构——分布式学习用于战略性基础设施规划,时空网络用于运营性调度——具备跨领域迁移潜力。在物流领域,可优化配送中心选址与车辆路径;在灾害响应中,可指导临时设施的部署与救援车辆派遣;在安全监控中,可按动态评估的风险等级分配移动巡逻资源。论文为资源受限多智能体系统在信息稀缺环境中的协调部署与运营提供了可推广的方法论方案。
论文:UAV charging dock location and patrol path planning under epistemic uncertainty using distributed reinforcement learning
作者:Yang Gao,Heng-Qing Ye,Zhili Zhou
期刊:Transportation Research Part E: Logistics and Transportation Review,2026
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


