论文题目:A dynamic prompting and scenario generation method for autonomous driving perception via large-model optimization
通讯作者:Bangyang Wei 清华大学车辆与运载学院博士后,研究涉及大规模复杂城市道路网络中交通拥堵与治理的仿真、建模与优化;电力配电网络和交通网络的耦合与协调优化(考虑拥堵效应);数字孪生驱动的实时反馈优化与车辆-电网整合控制。
E-mail:bangyangwei@tsinghua.edu.cn
复杂交通感知:大模型动态提示与场景构建方法
论文摘要
多模态大模型为自动驾驶带来通用语义理解能力,但其在真实道路上部署时依旧面临三大难题:提示泛化性差、长尾数据稀缺以及模型运算开销高。本文提出一套统一框架,通过动态提示优化、混合场景生成和模型轻量化训练,系统性地提升感知性能并降低部署成本。核心思路是冻结大模型权重,利用模型反馈迭代更新提示模板,结合自采集数据与合成场景构建多样化数据集,并通过知识蒸馏、LoRA微调和AWQ量化实现高效推理。实验证明,该框架在锥桶检测、交通灯识别和限速推荐等任务上显著提升精度,量化后模型依然保持强大的性能。通过混合数据集训练,模型在复杂长尾场景下的泛化能力进一步增强。
一、研究背景与待解决问题
1.1 背景概述
过去二十年自动驾驶发展迅速,但大规模落地仍受困于 场景理解狭窄与泛化性差。传统感知系统依赖车辆采集的监督数据,种类有限,难以覆盖罕见交通信号、极端天气等长尾场景。近期,大语言模型(LLM)和视觉‑语言模型(VLM)在自然语言理解和视觉任务中表现出色。然而将它们用于自动驾驶仍面临三大挑战:
提示适应性不足:现有多模态模型对提示设计高度敏感,难以在不同任务间复用。 长尾数据采集困难:罕见场景昂贵且难以获取,人工标注成本高。 模型部署开销大:庞大的模型难以在车载硬件上实时运行。
1.2 核心问题
针对上述背景,本文聚焦于以下问题:
如何在不调整权重的情况下自适应优化提示,使大模型在多任务、多场景中保持稳定输出? 如何构建兼顾真实多样性和长尾事件覆盖的训练数据集,缓解数据稀缺问题? 如何在保证感知精度的同时,通过轻量化技术降低模型推理延迟和内存占用?
二、方法框架与关键技术
2.1 整体架构
作者提出的统一框架如图1所示,整体分为三大模块:动态提示优化、混合数据集生成和模型优化与部署。框架流程如下:
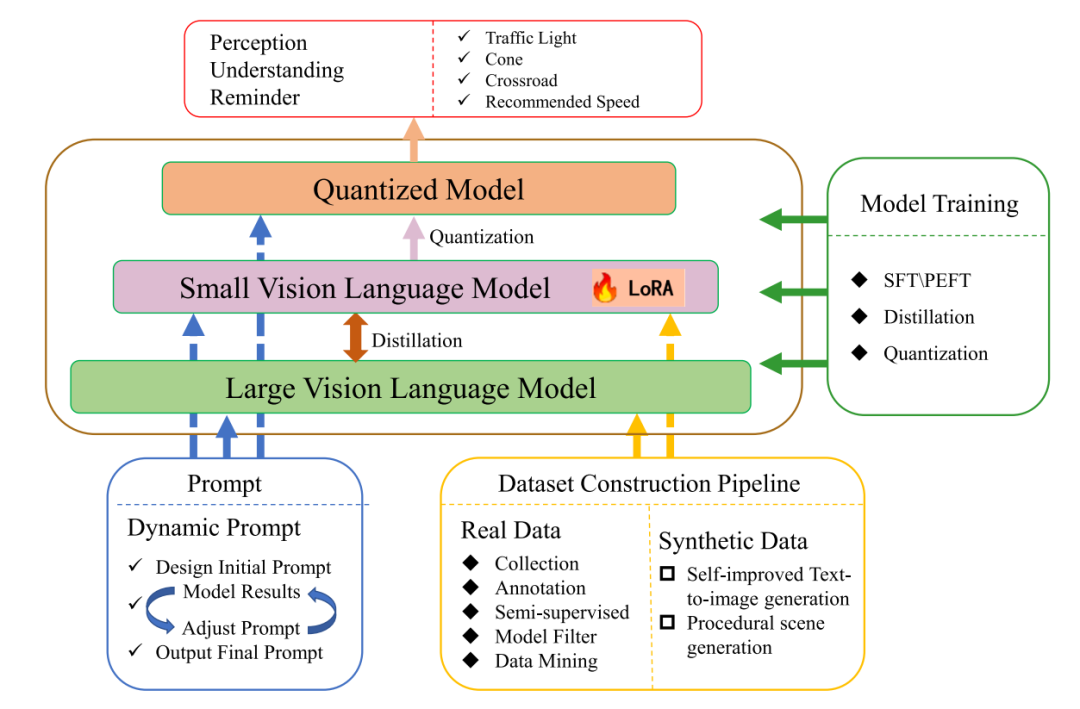
动态提示优化:针对每个任务设计初始提示,通过模型输出反馈不断迭代,使提示更加精准。 混合数据集生成:融合自采集数据与合成场景,构建覆盖广泛环境与稀有事件的训练集。 模型优化与部署:采用知识蒸馏、LoRA 微调和 AWQ 量化,压缩模型规模,满足车载部署需求。
2.2 动态提示优化
动态提示优化通过 多轮循环迭代 改进提示模板,而无需调整模型权重。具体步骤如下:
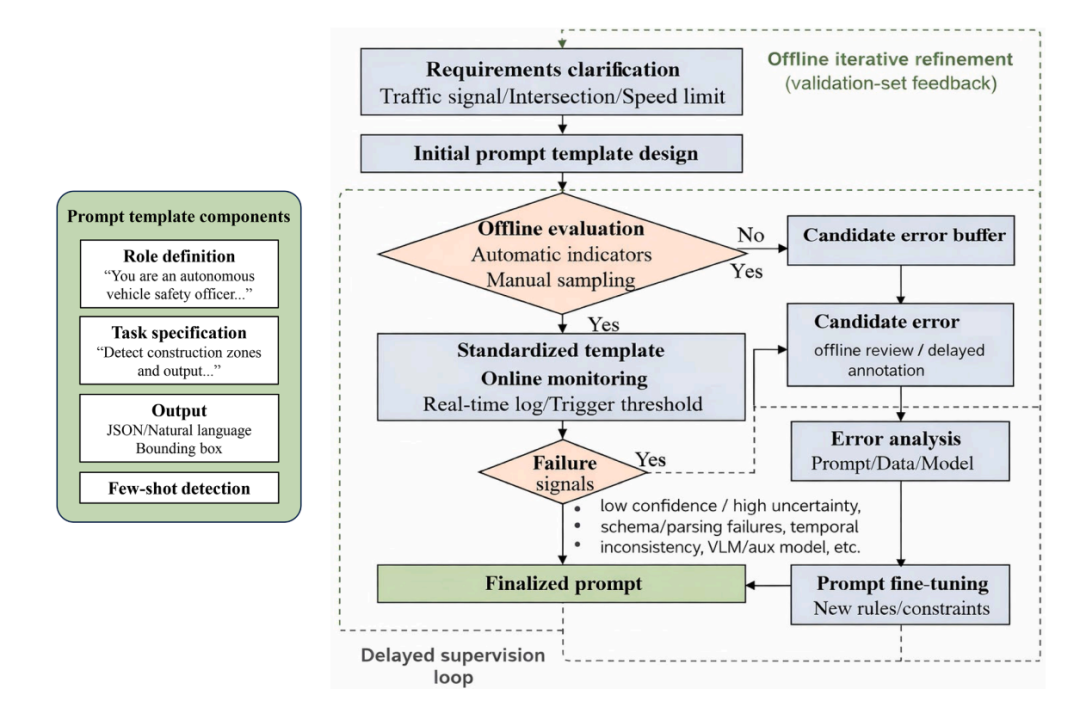
初始化提示模板 ,在验证集上运行模型获得初始输出。 收集并聚类失败样本:将预测错误或约束违背的样本集合 根据错误类型(如低光漏检、解析失败)聚类。 应用更新规则:针对不同错误类别采用预定义的模板修改策略(补充任务说明、示例等),生成新的提示 。 迭代停止条件:若连续改进不足阈值或达到最大迭代次数,停止优化并输出最优提示 。
动态提示关注任务相关性与场景特征,例如在交通灯识别任务中加入视觉元素描述,提高模型对多车道信号的理解。
2.3 混合数据集构建
为了缓解长尾场景稀缺,作者设计了 自采集数据挖掘+合成数据生成 的混合策略。
2.3.1 自采集数据挖掘与标注
自采集数据覆盖丰富真实驾驶环境,但包含噪声和偏差。作者提出结合大模型辅助标注与专家模型交叉验证的流程:
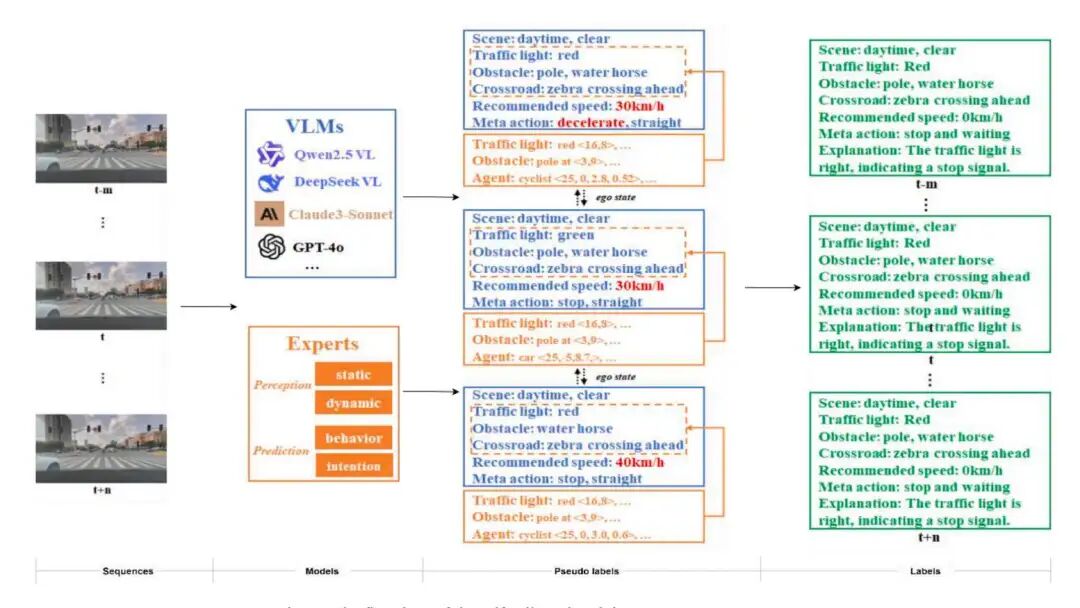
利用 VLM(Qwen2.5‑VL)按任务提示生成初始标签,并使用专家模型生成第二组伪标签。 通过滑动窗口约束时间一致性并进行语义检查,如检查车辆状态和地图信息。 对模型间不一致或不确定的样本进行人工审核,纠正标签并完善属性。 融合自动标签和人工修订形成最终训练集,并保留少量校准集进行质量抽样。
该流程实现了高效率、高质量的标注,减少了人工工作量,并形成长期可扩展的标注系统。
2.3.2 驾驶场景生成
为补充长尾事件,作者采用两种场景生成方式:
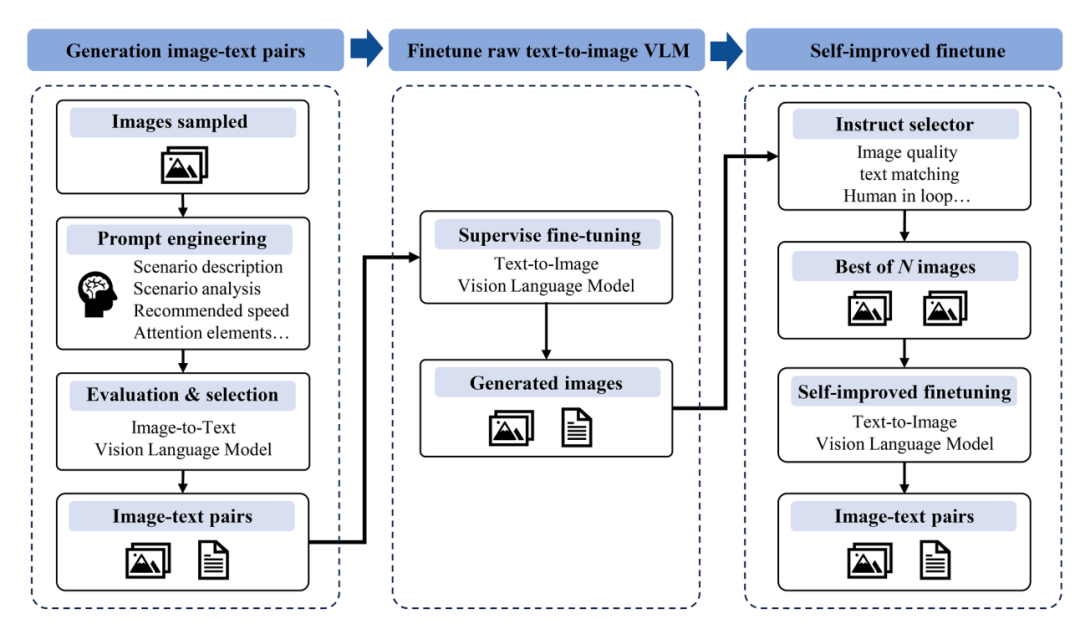
文本生成图像(T2I):通过初始图文对微调生成模型,利用 LoRA 增强模型能力。模型在自举阶段生成多个候选图像并筛选质量最佳者,再用于进一步微调。
纯渲染方法:使用 Blender 与 SUMO/CARLA 等模拟平台创建3D道路布局并模拟动态元素(车辆、行人),配置摄像机与光照生成高精度合成场景,同时生成与任务对齐的描述。
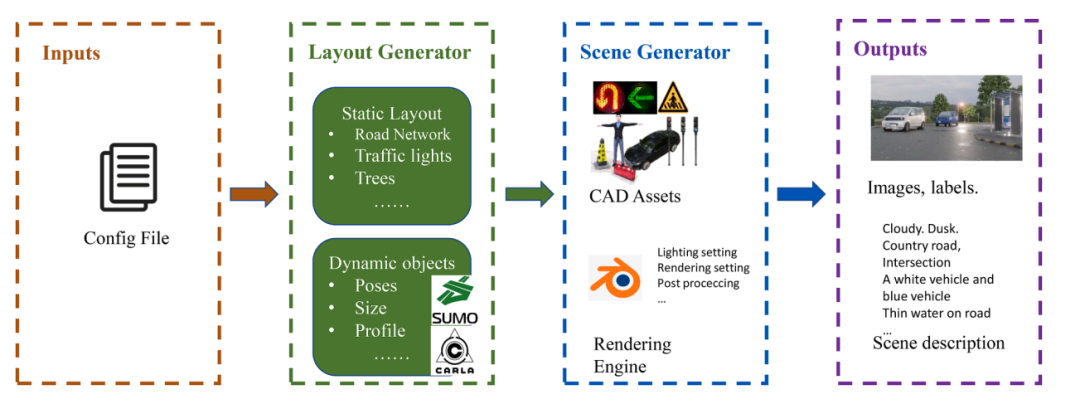
两类合成数据互补:T2I 生成多样化外观,渲染方法提供可控制的几何结构与视角,使得训练集同时拥有真实感和结构准确性。实验证明,两类数据结合能显著提升模型在长尾场景下的识别能力。
2.4 模型优化与部署
为了在车载环境中实现高效推理,作者设计了三阶段模型优化策略:
知识蒸馏的软标签损失(KL 散度):其中 为教师模型输出概率, 为学生模型输出概率。
LoRA 微调:在蒸馏后的学生模型中,引入低秩矩阵 Δ ,仅更新一小部分参数,优化目标为最大化条件对数似然: 这种 参数高效微调 能在少量数据下实现性能提升,且训练成本远低于全量参数微调。
激活感知量化 (AWQ) :将权重量化为4比特,并依据激活分布调整量化范围,最大限度减少精度损失。最终模型在8×A100 GPU上训练并量化后可在嵌入式设备上实时运行。
三、实验设计与结果分析
3.1 数据集与设置
训练集由 19,360 张自采集数据、11,486 张 T2I 合成数据和 11,486 张纯渲染数据构成;测试集包含 2,885、2,332 和 2,332 张对应数据。天气分布、光照条件与道路类型均衡,显式包含应急车辆与动物等稀有类别。自动标注整体接受率达 88%,随机抽查显示错误率约 6.4%。动态提示优化迭代 5 次以内即可收敛,平均人工投入约 4.2 小时/迭代。
3.2 评价指标与基线
模型在 推荐速度、交通灯识别、障碍物检测和交叉路口识别 四项任务上评估。指标包括精度 、召回率 、 值、对称平均百分比误差 和评分。
3.3 实验结果
整体性能提升:使用真实数据训练的 7B 模型及其量化版本的平均精度分别为 0.580 和 0.542;结合完整优化策略(动态提示+混合数据+模型优化)后,平均精度提升到 0.894,同时推理帧率从 8 FPS 提升至 11 FPS。 提示优化效果:应用动态提示后平均精度提升约 10%,限速推荐的 得分提升 16% 以上,施工区检测的精度、召回率和 F1 值分别提高 0.254、0.171 和 0.222。 合成数据贡献:仅用自采集数据训练的模型与加入 T2I 合成或纯渲染数据训练的模型比较,平均精度分别提升 1.16% 和 2.23%;两类合成数据结合时提升 3.2%,说明两者互补。 长尾场景表现:在复杂交通灯场景中,加入合成数据后模型能区分正常红绿灯与收费站灯,且能准确判断影响车辆行驶的信号。
四、结论与创新点
本文工作从整体流程出发,提出将动态提示优化、混合数据生成和模型轻量化训练整合的系统框架,重点创新如下:
无梯度动态提示优化:通过模型输出反馈迭代提示模板,在保持权重冻结的前提下显著提升性能。 混合数据构建策略:融合自采集数据与两种合成场景生成方法,覆盖更多长尾事件,解决数据稀缺问题。 参数高效模型适配:将知识蒸馏、LoRA 微调与激活感知量化结合,兼顾精度与部署效率。 实证分析完备:在多个感知任务和复杂场景下验证方法有效性,实验统计全面,结论可靠。
五、局限与未来工作
作者指出,本研究仍存在一些局限:
合成数据与真实数据之间存在域差异,尤其在复杂光照和动态交互场景下,模型泛化能力仍需提升。 动态提示优化依赖预设规则,如何通过自动方法发现高效的提示修改策略有待研究。 模型压缩在极端长尾条件下的稳健性尚未充分验证。
未来工作可探索自监督合成数据生成、自动提示搜索算法及跨模态知识协同训练,进一步提升大模型在真实交通中的可靠性。
文章须知
链上镖师团队:常文婕(AEIC)、张巧巧(AEIC)、王一航、夏子帆、张晓乐
原文链接:10.1016/j.trc.2026.105672
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



