论文题目:Bridging prediction and decision: Advances and challenges in data-driven optimization
第一作者:Yanzhi Wang 北京大学博士生,研究兴趣包括数据中心人工智能、数据驱动优化、能源系统和不确定性估计。
E-mail:yanzhiwang@pku.edu.cn
通讯作者:宋洁 北京大学先进制造与机器人学院党委书记,长江学者特聘教授,主要研究领域为在线学习、仿真优化及在系统工程领域的应用。
E-mail:jie.song@pku.edu.cn
智能调度与控制领域:序贯、端到端与直接学习方法综述
论文摘要
本文对数据驱动优化这一新兴研究领域进行了系统综述。作者指出,传统方法常将预测与决策割裂,而在大数据环境下,两者之间的耦合对决策效果至关重要。论文围绕三类主要框架——序贯优化(SO)、端到端学习(E2E)和直接学习(DL)展开,梳理其理论基础、适用场景及各自优缺点。作者首先回顾 SO 的凸约束优化原理,分析预测误差导致的决策偏差问题;随后重点介绍 E2E 框架如何在训练过程中嵌入优化结构,通过决策损失反向传播梯度;最后讨论 DL 通过强化学习或模仿学习直接输出决策策略的方法。文中通过表格与案例比较三种方法,指出 E2E 在决策准确性方面的优势、SO 在计算效率上的适用性及 DL 对复杂场景的适应能力。文章还提出数据质量、优化方法和应用解释性等方面的挑战,并展望未来研究方向。
一、数据驱动优化的基础与序贯优化(SO)
1.1 理论背景
问题定义:数据驱动优化旨在将预测模型产生的不确定参数 应用于后续决策,以最小化目标函数 并满足约束 。其中 为决策变量, 由预测模型 给出。 两阶段流程:SO 在“预测→优化”两个阶段顺序进行。预测模型先以统计损失(如 MSE、MAE)训练生成 ,然后将其作为输入,通过优化求解决策 。 优点与缺点:该方法具有模块化和灵活性,可独立提升预测与优化性能;但因预测目标与决策目标不一致,降低了整体决策效用。
1.2 SO 中的模型与挑战
预测与决策不匹配:统计损失函数往往对过预测和欠预测给予对称惩罚,而决策成本在实际应用中具有非对称特征。例如电力负荷预测过高导致额外储备成本,预测过低则需昂贵的平衡调度。 方法创新:提升预测精度的同时,研究者采用混合模型(如 LSTM、Transformer 等)处理多时域数据,提高预测在复杂场景下的可靠性。
二、端到端学习(E2E):决策驱动的预测训练
2.1 框架概述
E2E 将优化问题直接嵌入预测模型训练中,使模型参数通过决策损失进行更新。决策损失通常以“遗憾(regret)”形式衡量由预测偏差引起的最优决策偏离:
其中 表示将预测值映射为最优决策的优化器。
为了最小化该决策损失,需计算其对模型参数 的梯度:
其中第一项与损失定义有关,最后一项可通过常规反向传播获得,而关键难点在于中间项 的求解。
2.2 隐式微分法
基本思想:利用 KKT 条件建立拉格朗日函数 ,对最优决策 满足的函数 应用隐函数定理得到
2.3 代理损失法与近似法
代理损失:通过构造易于求导的代理目标,如 SPO+ 损失,可避免显式求解雅可比。对于线性目标 ,SPO+ 定义为 ,其梯度可以通过两次优化求解得到,从而大幅降低计算量。 随机扰动近似:针对具有多面体可行域的线性优化问题,研究者向 添加噪声 ,用期望决策 替代原映射,使得梯度近似连续,从而缓解梯度不稳定问题。
2.4 E2E 的局限性
虽然 E2E 能提升决策精度,但其对预测模型的统计性能和可迁移性要求较高。文中通过图5展示了当预测模型过度适应特定决策任务时,虽然决策准确度提升,但预测数值已难以解释并难以迁移到其他任务。此外,整数约束等问题使 E2E 计算成本昂贵,需借助神经网络近似或强化学习辅助求解。
三、直接学习(DL):舍弃显式优化的策略
直接学习框架不依赖显式优化结构,而是通过强化学习(RL)或模仿学习(IL)直接从数据中学习决策。
3.1 强化学习(RL)
问题形式:RL 将决策任务视作马尔可夫决策过程,优化累计奖励 。其中 为折扣因子, 表征即时收益。 优势:RL 能在未知或隐式环境中通过试验‑反馈优化策略,被广泛用于电力调度、能源管理等场景。算法如 PPO、DDPG 等改进了高维动作空间下的稳定性和效率。 挑战:RL 面临探索‑利用权衡及稀疏奖励等问题,训练成本高;针对复杂系统,通常需要预训练或分布式算法提升样本效率。
3.2 模仿学习(IL)
基本思想:通过专家示范数据直接拟合输入 与决策 的映射,无需显式优化。常用方法包括行为克隆、逆强化学习和生成对抗模仿学习,它们在自动驾驶等任务中取得良好效果。 黑盒近似:文章提出用深度模型 近似决策损失,通过最小化 实现梯度传递。该方法效率高,但可能陷入局部最优,需要对模型架构和正则项进行调整以保证可行性。
四、三类方法的比较与应用案例
4.1 方法比较
作者通过表格总结了 SO、E2E 和 DL 在训练目标、预测‑决策关系、理论适用性及透明度等方面的差异。以下表展示了不同框架的综合比较。
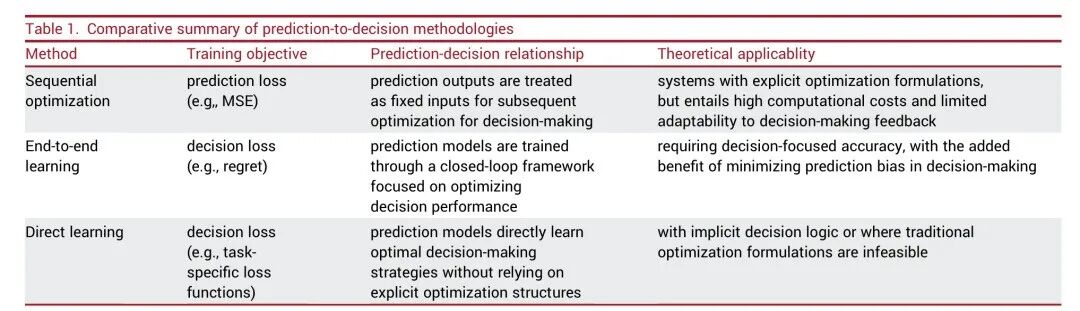
表1显示了三种框架的关键区别:SO 使用预测损失,决策模型作为后续模块;E2E 采用决策损失,在闭环中训练预测模型;DL 则直接输出决策,适用于无显式优化结构的场景。
4.2 应用案例
电网调度:在风电渗透率高的系统中,E2E 框架通过隐式梯度将预测与最优潮流计算结合,使拥塞率和过载率下降 8.5%,误差方差降低 70%。结合 LSTM 和混合整数规划的两阶段 E2E 方法在多能系统中实现了约 0.4% 的运营成本下降和超过 12 万元人民币的年节省。 运营管理:在最后一公里配送中,E2E 与 SPO+ 和启发式算法结合,降低约 5% 的行驶成本;在港口状态控制中,树集成 E2E 方法将船舶运营费用减少 1%,缓解了拥堵。对于库存补货问题,DL 框架直接输出补货策略,将持有成本降低 26.1%,缺货成本降低 51.7%。 智能控制:DL 尤其适用于无人驾驶和无人机控制等复杂环境。在自驾驶车辆中,引入动态置信度的强化学习策略能在极端情况下提高稳定性;无人机控制系统利用 RL 综合机翼应变、姿态和风速数据优化飞行高度,实验表明系统鲁棒性随训练提升。模仿学习通过专家示范训练策略,在机器人控制中表现稳定。
4.3 多维评价
下面的表格从目标一致性、效率和透明度等多维度对三种方法进行了对比。
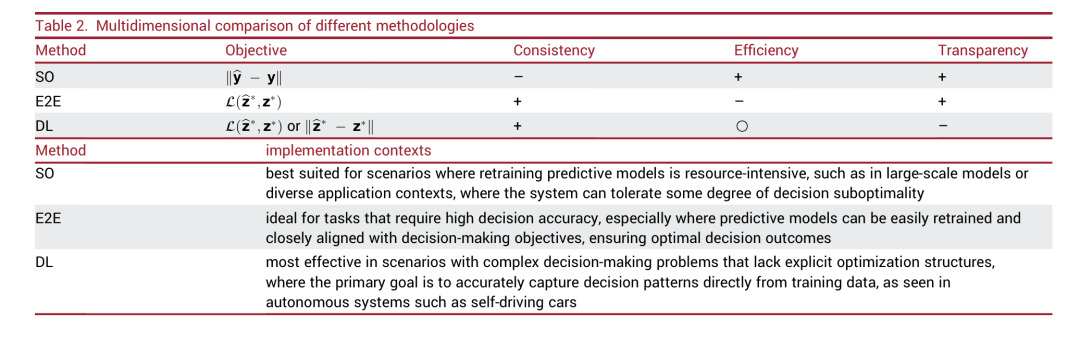
表2指出,SO 目标一致性差但效率和透明度高;E2E 在一致性上优越,但计算成本高;DL 在复杂场景中具有适应性,但透明度较低且依赖大量示范数据。
五、面临的挑战与未来研究方向
5.1 数据层面
数据质量与价值:数据量激增不一定带来决策提升,低质量数据会干扰模型训练。需要结合无监督清洗(如熵值、异常检测)和监督估值方法,为决策导向的数据赋予权重。 数据规模:过少数据导致过拟合,过多数据则增加 E2E 训练开销。研究显示,实际所需数据量通常比理论上小两个数量级即可达到高决策精度。少样本学习和数据增强有望进一步提升效率。
5.2 优化与建模层面
不确定性建模:现实问题往往涉及随机性,需引入概率约束、鲁棒优化和分布鲁棒优化等方法来处理随机变量。 可行性保证:由于预测误差,训练过程中得到的决策可能不满足真实约束。可通过增加违反约束的惩罚、投影修正或嵌入可行性映射等手段提高结果可行性。
5.3 应用层面
解释性:黑盒模型难以被决策者信任,需要使用特征重要性、局部模型解释、积分梯度、Shapley 值及物理约束网络等方法解释预测与决策依据。 可扩展性与适应性:在金融和环境监测等非平稳环境中,模型需要快速适应数据分布变化,可通过迁移学习、元学习和在线学习提高适应性。
六、总结与创新点
本文以综述视角梳理了预测与决策紧密耦合的三种方法,揭示了各自的理论基础与应用前景。主要贡献包括:
提出SO–E2E–DL三分法,将现有数据驱动优化方法按预测‑决策耦合程度系统归类。 系统介绍了 E2E 中隐式微分、代理损失和随机近似等关键技术,阐明了如何通过梯度传递实现决策导向训练。 总结 RL 和 IL 在直接学习中的角色,说明其在没有显式优化模型时直接输出决策的优势和挑战。 通过案例分析展示三种框架在电网调度、运营管理和智能控制中的成效及适用条件。 提出了数据质量、模型优化和应用解释性等多维度挑战,为未来研究指明方向。
论文强调,随着大数据和智能技术的发展,预测与决策融合已成为提升决策效率的关键。今后的研究需要在高质量数据获取、可解释性模型设计和动态环境适应性方面深入探索,以全面提升数据驱动优化的理论深度与实际应用价值。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、王一航、张仁义(EIC)、张晓乐、张巧巧
原文链接:https://doi.org/10.1016/j.ynexs.2025.100057
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



