论文题目:Combination-of-expert with knowledge sharing for cross-task vehicle routing problems
第一作者:余紫康 中山大学计算机学院博士生,师从王甲海教授,研究聚焦车辆路径规划、智能优化方法。
通讯作者:王甲海 中山大学计算机学院教授,博士生导师,IEEE高级会员,CCF杰出会员。大数据与计算智能研究所所长,大数据分析与应用技术国家工程实验室大数据高性能分析处理中心主任。入选人工智能领域全球前2%顶尖科学家榜单。致力于智能优化与学习的融通共进,形成从大数据到知识、从知识到决策的能力,以通向可解释、可通用的下一代人工智能。研究兴趣包括:大模型与深度学习,智能优化方法,和知识图谱及其在自然语言处理,城市大数据(智慧出行,智慧物流)和社交网络大数据等领域中的应用。最近主要聚焦大模型的能力增强与利用。
E-mail:wangjiah@mail.sysu.edu.cn
面向复杂约束的VRP求解:共享知识驱动的组合专家框架
论文摘要
在现代物流与配送领域,车辆路径问题(VRP)是调度优化的核心。然而,现实任务往往包含多种约束,如车辆容量限制、时间窗要求、路径是否封闭等,致使传统基于单任务的深度模型难以适应组合约束,容易出现过拟合或“专家碎片化”问题。本文作者基于组合约束的复杂性,提出了一种结合组合专家(Combination-of-Experts,CoE)与多视角知识共享(Multi-View Knowledge Sharing)的新型深度求解框架 —— CoEKS。该框架通过任务约束激活对应专家并动态组合,利用共享变换层和多路蒸馏机制实现不同专家间的互补协同,从而同时提升同分布任务和未见组合任务的性能。实验在包含48类VRP任务的基准集上开展,与传统求解器以及多任务神经模型比较,CoEKS在大多数场景下取得最小的求解差距,并在未见约束组合上实现18.3%及13%的相对提升。研究最后还讨论了模型在引入新约束时的扩展策略,并指出未来可探索更高效的专家共享机制。
一、研究背景与问题定位
1.1 复杂车辆路径问题的挑战
多约束叠加:现实世界中的VRP不仅考虑降低运输成本,还需满足车辆容量、时间窗、行程时限等多种限制。 任务泛化难:现有神经网络模型要么采用“单模型多任务”,难以捕捉不同约束的细节;要么为每种约束设计“多个专家”,导致专家数量随着约束组合呈指数增长。 新约束接入难:在面对新的约束类别时,如何在保持已有知识的同时快速适配,成为实际部署的关键。
1.2 论文目标
本研究旨在解决以下问题:
约束组合的爆炸性增长带来的模型参数急剧膨胀。 专家间知识隔离导致的泛化性能下降。 新约束快速迁移与旧知识保持的矛盾。
二、模型框架与关键技术
2.1 组合专家框架
CoEKS的核心在于基于组合专家(CoE) 的模型结构。设定每种基本约束(如容量、开放路线等)都对应一个专家网络;当任务包含多种约束时,激活对应专家并通过组合器输出最终策略。具体而言,假设一共 个专家,每个专家输出局部策略 ,组合器根据任务特征分配权重 ,最终策略为:
这种方式有效地缓解了“组合爆炸”问题,使模型能够灵活适配不同约束组合。
2.2 多视角知识共享机制
为了避免各专家“各自为政”,作者引入多视角知识共享(MDis),主要包括两种机制:
互蒸馏(Mutual Distillation):当多个专家同时激活时,构建“虚拟专家”作为目标,促使不同专家通过蒸馏损失共享策略信息。 共享变换层:在多层Transformer编码器的早期插入共享的全连接层,将各专家的隐藏状态映射到公共空间,促进上下文的交互融合。
这种设计使得不同约束专家能在低层共享基础知识,在高层保持个性,既提高模型数据效率又增强对未见组合的泛化。
2.3 推理策略与扩展
在推理阶段,模型根据输入任务的约束集合动态激活对应专家,通过组合器输出策略。面对全新约束,作者提出新专家插入方案:固定已有参数,只对新专家进行微调,保证旧知识不被遗忘。
三、实验设计与结果分析
3.1 实验设置
数据集:48种VRP任务,包括不同规模、不同约束组合的实例。 基线模型:包括传统求解器(如PyVRP、OR-Tools)和多任务神经模型(POMO-MTL、MVMoE等)。 训练策略:混合批次训练、共享批量归一化;互蒸馏主要作用于编码器的第一层。
3.2 主结果:同分布与跨分布表现
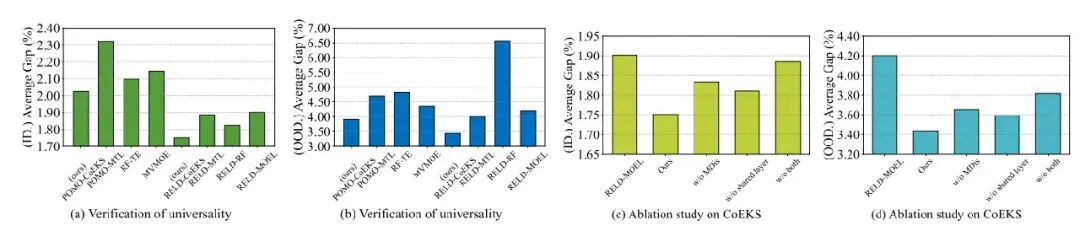
下图展示了CoEKS与各基线在同分布任务与未见组合任务上的平均差距。图中横轴为不同约束组合的任务,纵轴为相对误差百分比。
从图1可见:
在同分布任务上,CoEKS在大多数组合中取得最小或次小的求解差距,整体平均误差最低。 在未见组合任务中,传统多任务模型性能大幅下降,而CoEKS凭借组合专家和知识共享,仍维持较高性能,平均提升18.3%(规模20)及13%(规模50)。
3.3 新约束适应
作者进一步测试在加入混合返程(MB) 约束后模型的适应能力。实验设置为:使用已有训练好的模型,固定旧专家参数,只训练新专家。结果显示:
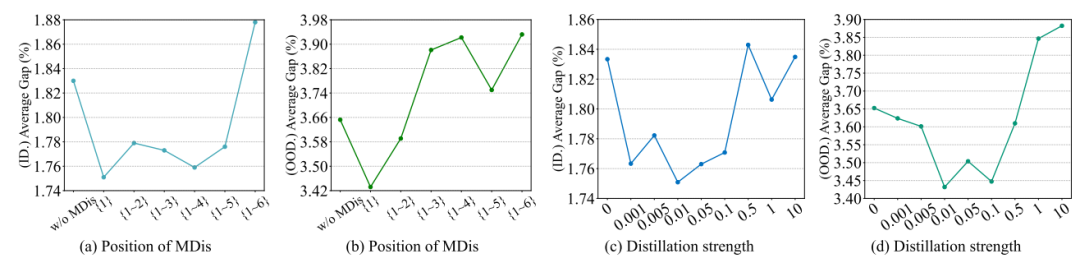
如图2所示,新专家插入后,CoEKS在多个任务上的性能明显优于从零训练的基线模型和增量学习的RF-TE等方法。这表明该框架易于扩展且不影响已有知识。
3.4 通用性与消融研究
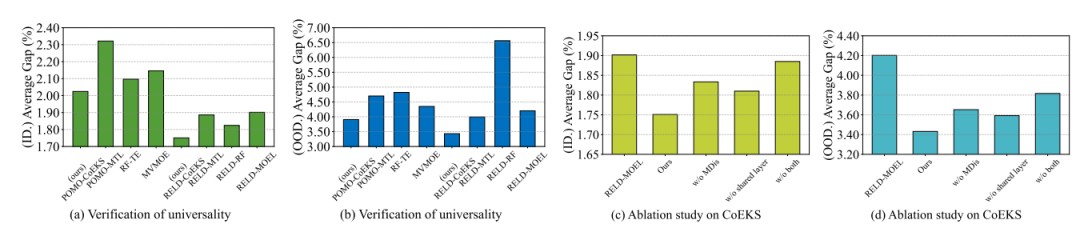
作者将CoEKS集成到不同Transformer骨干(POMO、ReLD)中,验证模型的通用性。结果表明,不论采用何种骨干,CoEKS均能维持最好的平均误差。在消融实验中去除互蒸馏或共享变换层,性能明显下降,证明知识共享对泛化的关键作用。
四、技术亮点与创新贡献
组合专家减缓参数爆炸:通过动态激活并线性组合约束专家,实现无需为每种约束组合训练独立模型。 多视角知识共享:互蒸馏 + 共享变换层的设计促进专家间知识交流,同时保持个性化。 零样本泛化与快速迁移:在未见组合任务上显著优于基线,实现真正的“零样本”泛化;新约束插入策略有效应对快速迭代的场景。 实践价值:该框架可以集成到现有VRP求解器中,在规模较大的实例上仍具有较快的推理速度。
五、结论与展望
本文提出的CoEKS模型以组合专家和多视角知识共享为核心,使得神经网络在处理多约束车辆路径问题时同时兼顾性能与可扩展性。实验结果证明了其在同分布和跨分布任务上的显著优势,并展示了在新约束接入时的强大适应能力。未来可以探索更高效的专家共享机制或参数化策略,以进一步提升模型在更多复杂约束组合中的应用潜力。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、汪朝杰、王一航、张仁义(EIC)、张晓乐
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



