论文题目:Deep controlled learning for inventory control
第一/通讯作者:Tarkan Temizöz(埃因霍温理工大学)围绕库存管理展开研究,提出适用于库存控制高度随机性问题的深度受控学习(DCL)算法,还探索库存管理的零样本泛化方向并提出 Train, then Estimate and Decide(TED)框架与通用能力失销网络(GC-LSN)模型,相关方法在缺货损失、易腐品库存等多种场景中表现优于传统策略和现有深度强化学习方法。
E-mail:t.temizoz@tue.nl
高度随机库存管理:融合序贯半分与共随机数的深度控制学习
论文摘要
本文针对库存管理中广泛存在的 高随机性需求与随机补货时间 问题,提出了一种新型深度强化学习方法——深度控制学习(DCL)。传统基于马尔可夫决策过程的动态规划方法难以处理维度爆炸。现有深度强化学习算法如 A3C、DQN、PPO 等并未针对外生随机性设计,常常难以超过经典启发式策略,例如基准 基库存策略(BSP)。DCL 将库存问题建模为带外生输入的马尔可夫决策过程(MDP-EI),以分类式策略迭代为框架,在 近似策略迭代 中通过模拟确定每个状态的近似最优行动,并用神经网络学习策略。算法引入 共随机数(CRN) 降低模拟方差,并利用 序贯半分(SH) 优化模拟资源分配。实验覆盖失销库存、易腐品库存和随机补货时间三类问题,结果表明 DCL 在小规模实例中的最优性缺口不超过 0.09%;在大规模实例中平均成本最低,显著优于 BSP 和 A3C 等策略。该研究揭示了在高随机性环境中定制化深度强化学习方法的潜力,并为库存管理领域提供了泛化性强的新框架。
一、研究背景与问题定义
1.1 库存管理的挑战与传统方法
高随机性:需求和供应的不确定性导致决策过程复杂,各类库存问题(如失销、易腐品和随机补货时间)具有显著不同的动态特征。 计算困难:精确求解这些问题需要遍历巨大的状态–行动空间,其计算复杂度随维度呈指数增长。 启发式策略局限:基库存及其改进策略简单易用,但在某些场景难以取得最优表现。 现有 DRL 算法适配性不足:A3C、DQN 等算法在随机输入驱动的马尔可夫决策过程中表现不稳定,难以超越 BSP。
1.2 研究问题
本文关注如何设计适用于高随机性库存管理问题的深度强化学习算法,使其能稳定优于传统启发式,具备良好的 泛化性与鲁棒性。核心问题可概括为:
如何建模:如何将多种库存问题统一为一个易于处理的模型框架? 如何求解:如何在模拟资源有限的情况下准确评估不同行动,并学习高质量策略? 如何减少方差:如何降低模拟估计的方差,使策略迭代收敛稳定?
二、模型与方法框架
2.1 带外生输入的马尔可夫决策过程(MDP-EI)
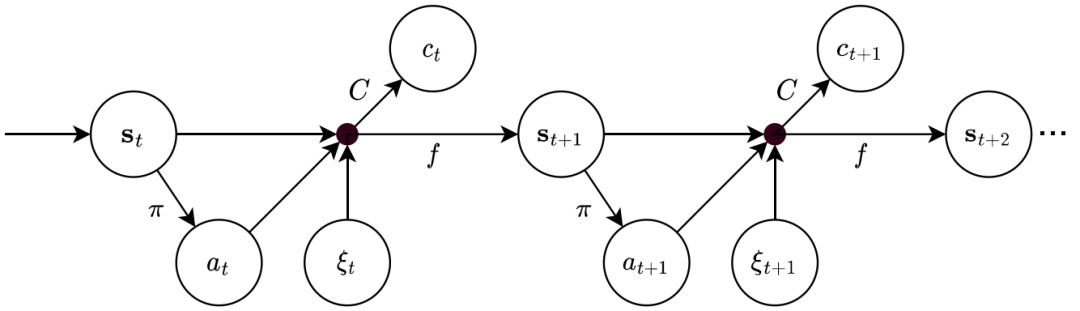
为了统一描述多种库存问题,文章引入 MDP-EI 模型。该模型由状态集 、行动集 和外生随机输入集 组成,其中外生输入代表独立于决策的随机需求或补货时间。其基本要素:
状态转移:在状态 下采取行动 ,并观察外生输入 后,系统转移到 ,其转移概率为
其中 为转移函数。
成本函数:同样情况下产生即时成本 ,其期望值表示为
策略与价值:给定策略 ,价值函数满足
其中 为折扣因子。
最优行动:改进策略通过选取使行动价值最小的行动
达到策略迭代的目的。
为帮助理解,以下图呈现了 MDP-EI 在库存问题中的演化路径:
2.2 深度控制学习算法框架
DCL 采用 分类式策略迭代(Classification-Based Policy Iteration, CBPI) 思路。主要流程如下:
状态采样:从当前策略出发,生成外生场景以遍历状态空间,并随机采样 个状态用于数据集。
模拟评估:对每个采样状态,通过 roll-out 模拟估计各行动的截断期望成本
其中模拟长度为 。
序贯半分与共随机数:采用 序贯半分(SH) 把有限的模拟预算分配给潜在更优的行动,并利用 共随机数(CRN) 在不同行动间共享随机种子,以减少方差。算法在每一轮淘汰表现差的一半行动直到剩下一个最优行动。
策略学习:以采样状态和对应的模拟最优行动作为标签,训练神经网络分类器 近似改进策略。网络结构采用多层感知机(4 层、256→128→128→128 神经元)。
迭代更新:重复上述过程 次,每次使用新策略产生数据集,最终获得策略 。
该方法避免了直接估计价值函数,降低噪声,并通过模拟与分类的结合实现高效迭代。
2.3 关键技术详解
共随机数(CRN):在评估不同行动的模拟成本差值时,共随机数通过共享随机需求序列减少估计方差,理论上显著降低 。
序贯半分(SH):在固定模拟预算下,通过多轮淘汰机制优先保留表现优的行动,减少对明显劣势行动的评估,从而节约模拟次数。
并行化与热身:算法利用多线程并行采样状态和模拟,热身期允许策略走过一段随机序列以进入代表性状态分布。
三、实验设计与结果分析
3.1 实验设置
实验对象:涵盖三类难以求解的库存问题:失销库存控制、固定寿命易腐品库存和随机补货时间系统。 基准策略:包括基库存策略(BSP)、带上限的基库存策略(CBS)、近似 myopic‑2 策略(M‑2)以及 A3C 算法。 参数配置:全部实验使用统一的超参数:采样状态数 、外生场景数 、截断长度 、热身期 、近似策略迭代次数 ,神经网络采用 Adam 优化器训练。
3.2 性能比较
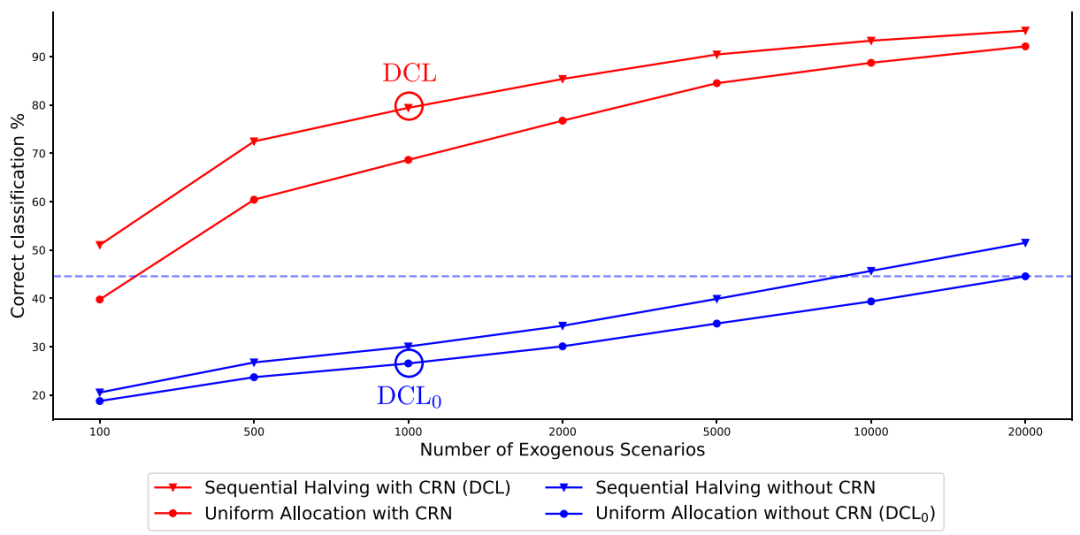
最优性缺口极小:在能求出精确最优解的小规模实例中,DCL 的最优性缺口最大仅为 。 平均成本最低:在大规模实例中,DCL 的平均成本明显低于 BSP、CBS 和 A3C 等,且同一套超参数适用于所有问题,表现出色。 模拟策略评估效果:与不使用 CRN 或 SH 的策略相比,DCL 在正确分类最优行动上的准确率显著更高;按照图中虚线计算,若不用 CRN,需将外生场景数量提升百倍才能达到同样准确度。
下图展示了不同模拟策略在确定最优行动时的正确分类率,其中使用序贯半分和共随机数的 DCL 表现最佳(图中横轴为每个状态的模拟场景数量):
3.3 影响因素分析
CRN 的贡献:使用共随机数能显著减少模拟方差,使得不同行动的成本估计更稳定,提升决策准确率。 SH 的优势:序贯半分优先分配预算给潜在优行动,减少浪费。与均匀分配相比,准确率提升约 10%。 迭代次数与样本量:实验发现三次策略迭代已足够使策略收敛;随着采样状态数和外生场景数量的增加,策略性能提升但计算量迅速增长,因此 DCL 在有限资源下取得较好折中。
四、讨论与创新点
统一建模框架:将失销、易腐品和随机补货系统统一建模为 MDP‑EI,方便算法泛化。 分类式策略迭代:抛弃传统价值函数逼近,直接把策略改进视为分类问题,减轻随机噪声影响。 共随机数+序贯半分:首次将 CRN 和 SH 结合到深度强化学习中,以减少模拟方差并高效分配资源,是算法的核心创新。 鲁棒统一超参数:不同问题使用同一套超参数即可得到优异表现,凸显算法的普适性。 性能优于传统与现有 DRL:在所有测试案例中,DCL 的平均成本低于 BSP、CBS、M‑2 以及 A3C,证明该方法在高随机性环境下的竞争力。
五、结论与展望
本文针对传统深度强化学习在库存管理中难以稳定超越启发式策略的问题,提出了基于 MDP‑EI 模型 的 深度控制学习 算法。通过 共随机数 降低模拟方差、通过 序贯半分 优化模拟资源分配,并以分类任务取代价值函数逼近,DCL 在三类库存问题中取得了优于最佳启发式的结果,其最优性缺口不超过 。
未来工作可在两方面展开:一是将该方法推广到其他具有高随机性的运营决策场景,如调度或资源配置;二是探索跨产品线的模型泛化能力,以减少为每个产品单独训练策略的成本。随着供应链自动化水平提升,复杂策略的实施障碍降低,DCL 有望在实际库存系统中发挥更大作用。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、汪朝杰、王一航、张仁义(EIC)、张晓乐
原文链接:https://doi.org/10.1016/j.ejor.2025.01.026
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



