论文题目:Deep reinforcement learning for real-time scheduling in large-scale mixed-model production systems with dynamic order insertion
第一作者:Donghai Wang 上海交通大学,聚焦于深度强化学习在实时调度方面的研究。
通讯作者:邹璟 上海交通大学溥渊未来技术学院助理研究员,研究涉及制造系统建模和控制优化、智能制造、AI算法、控制理论等。
E-mail:jing.zou@sjtu.edu.cn。
动态订单插入场景:混合生产系统的实时调度决策问题
论文摘要
混合模型生产系统(Mixed‑Model Production System,MMP)同时加工多类型产品,具备高柔性和高吞吐量,但也带来了复杂的排程问题。在市场需求波动下,制造商经常需要插入新的订单,这会打乱原有计划并加剧调度难度。传统的启发式算法难以兼顾大规模调度效率与实时适应性。为应对这一挑战,论文提出一种基于深度强化学习(DRL)的排程框架:通过改进的析取图模型将同类工件的相同工序合并为单个节点,显著降低状态复杂度;在此基础上,利用图神经网络(GNN)与近端策略优化(PPO)构建DRL智能体,实时生成排程策略。该方法在多个模拟数据集上验证了有效性,平均能使生产完工时间(makespan)降低约10%,相较传统规则算法具有更好适应性和稳定性。实验还显示,随着订单规模的增加,所提方法的优化优势逐渐扩大。本文不仅为大规模混合生产系统提供了一套高效、可扩展的实时调度工具,也为未来考虑运输、缓冲区等约束的复杂调度问题奠定了基础。
一、研究背景与问题定义
1.1 背景概述
混合模型生产系统广泛应用于汽车、半导体和装配制造等行业。其显著特点包括:
多工件类型并行加工:多个产品型号在同一生产线/车间内共享设备和资源。 工序路径交叉且数量大:不同类型工件有各自的加工路线,工序间依赖复杂。 动态订单插入:市场需求变化导致频繁插入新订单。 调度目标多样:主要目标是最小化总完工时间(makespan),同时需要考虑设备负载均衡和实时响应。
传统方法(如固定比例排程、循环排程、批量分割等)侧重于静态或小规模问题,难以适应动态事件。而混合模型排程可建模为作业车间调度问题,是典型的 NP‑hard 问题。因此,需要一种能同时处理大规模复杂约束和实时插单的智能方法。
1.2 问题定义与目标
考虑一个由多类型工件组成的混合生产系统,记工件集合为,其中包含 个不同类型。每个类型 的工件集合记为 ,共有 个工件。工件在不同机器上按预定工序加工,机器集合为。
调度目标是确定工件与机器的加工顺序,使得总体完工时间 最小,同时允许在执行过程中动态插入新的订单。为了比较算法性能,引入相对差距指标:
其中 为所有比较算法中得到的最小完工时间。相对差距越小,说明算法性能越接近最优。
二、模型框架:改进的析取图
2.1 传统析取图与其局限
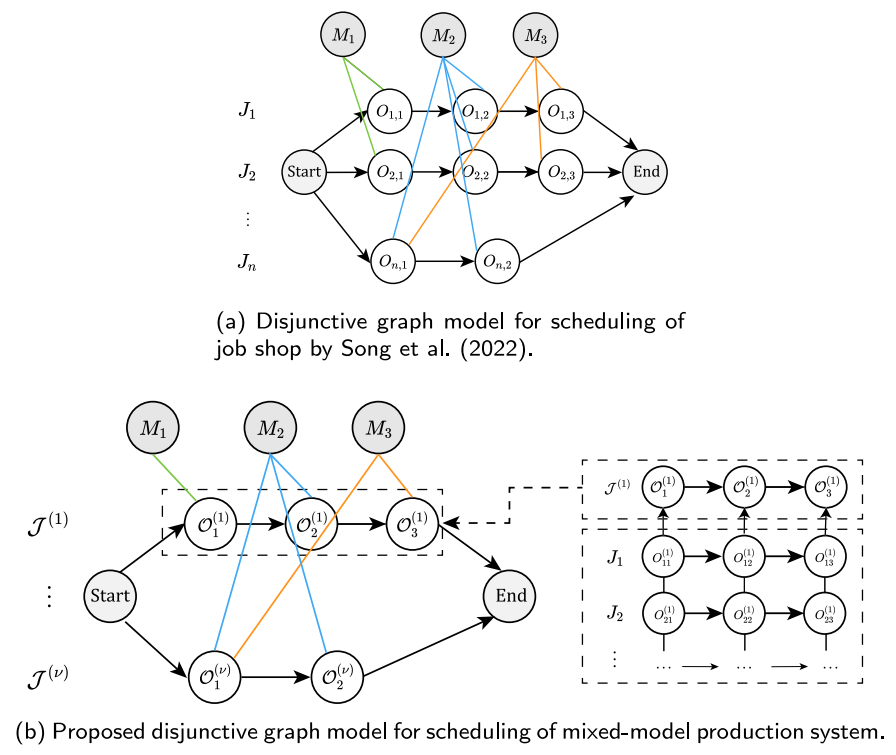
析取图模型是一种广泛用于描述作业车间调度状态的工具。传统模型为每个工件在每道工序建立操作节点,并用方向弧表示工序顺序,用析取弧表示机器与操作间的二选一关系。然而在混合模型排程中,当工件数目庞大时,传统模型的节点和弧数量呈线性增长,导致状态冗余。
2.2 改进的析取图模型
论文提出基于先前工作改进的析取图 。其主要思想是 合并相同类型工件的同一工序,具体结构包括:
操作节点集 :每个节点 表示类型 的工件第 道工序,用以代替同类型所有工件的该工序。 机器节点集 :每个节点 表示一台具体机器。 连接弧集 :同一工件类型内部的工序顺序,用有向弧连接。 析取弧集 :表示机器与操作的可加工关系,每条弧 代表该工序可以在机器 上加工。
通过将相同类型工件的相同工序合并为单节点,操作节点数量从 减少到 。当某类型工件数远大于类型数时,此举可显著降低状态维度和图复杂度,进一步提高训练效率。
在该模型基础上,系统状态可以嵌入到图结构中,调度行为转化为在时间步 选择下一条合适的析取弧 以分配工件和机器。
下图展示了传统与改进析取图的对比,改进模型聚合同类型操作,降低了节点数量并保留了关键关系:
2.3 模型优势
改进模型具有明显优势:
信息合成与对称性利用:聚合节点反映同类工件整体状态,减少冗余,利用相同工件间的对称性。 降低计算复杂度:节点和弧数量显著减少,使得训练时间和策略生成时间大幅下降。 可视化资源瓶颈:保留操作与机器的关联,方便发现机台瓶颈并优化资源配置。
三、深度强化学习调度策略
3.1 状态表示与特征设计
调度问题被建模为马尔可夫决策过程(MDP)。状态 通过改进析取图嵌入的节点特征向量表示,包括操作节点六维特征和机器节点四维特征:
操作节点特征:第 道工序的处理时间 、剩余总处理时间、待加工工件数、前一道工序完成且本工序未开始的工件数、完成率和可加工机器数等。其中第 2、3 维特征的计算如下:
其中 表示工件 的第 道工序在时刻 是否已开始或完成, 表示该工序在时刻 是否正在加工, 为工件 当前工序的剩余加工时间。
机器节点特征:包括机器剩余加工时间、机器当前是否工作、分配给该机器的平均剩余加工时间以及相邻节点待加工工件平均数。
3.2 动作空间与掩码机制
在时间步 ,动作 对应于析取弧的选择,即从某类型工件集合 中选取一个满足前序工序已完成的工件 ,并将其当前操作分配到机器 。为避免选取非法动作(例如机器忙碌或无可加工工件),引入 动作掩码,将不合法动作的概率置为零,保证策略梯度的有效性。
3.3 奖励设计
为引导智能体优化总完工时间,奖励函数定义为状态间近似完工时间的差值:
其中 为系统当前时间, 表示分配给机器 的所有相关操作的平均剩余加工时间,因此奖励反映了 makespan 的减少。累积奖励最大化等价于最小化总完工时间。
3.4 深度强化学习架构与训练
调度智能体由三部分组成:状态嵌入、策略决策和训练机制。
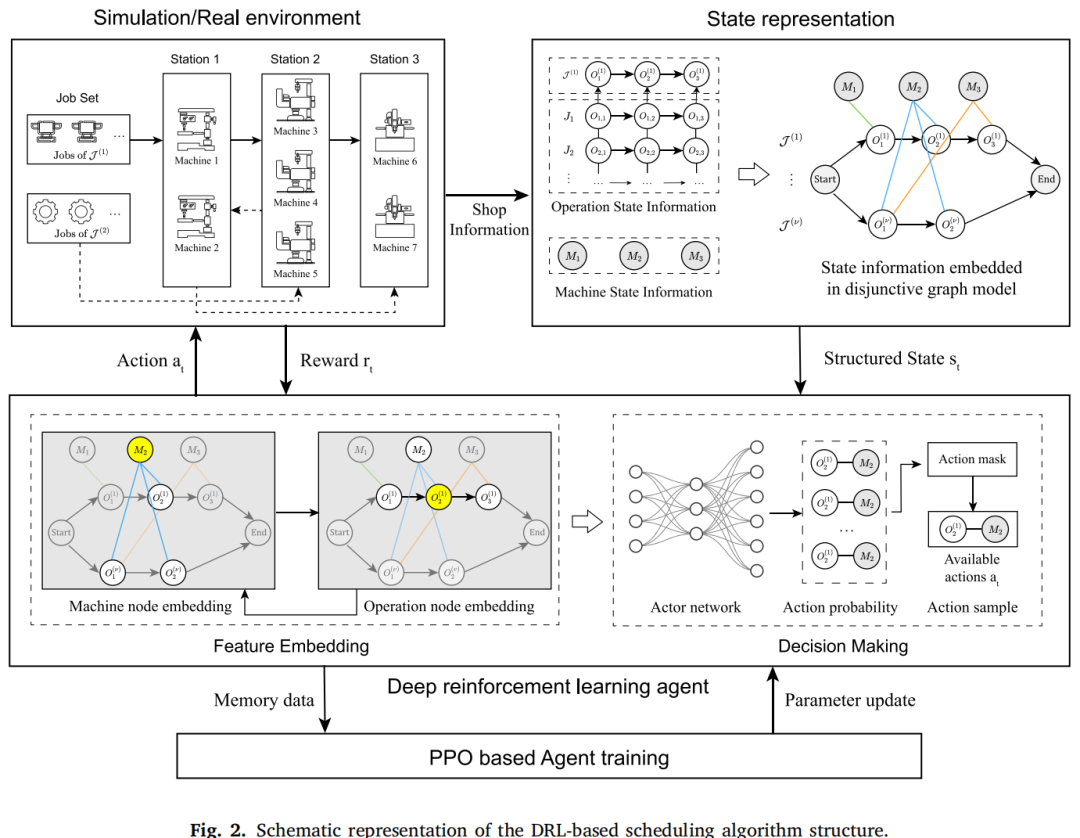
特征嵌入:利用图神经网络(GNN)在改进析取图上进行消息传递,分别更新操作节点和机器节点特征,捕捉工序顺序和机器冲突的语义。 策略决策:GNN 输出的全局嵌入通过多层感知机(Actor 网络)生成每个动作的概率分布,然后结合动作掩码挑选可行动作。 训练机制:采用近端策略优化(PPO)训练 Actor–Critic 结构。Critic 网络利用嵌入状态估计价值函数;通过模拟环境与智能体交互收集的记忆数据进行多批次更新。
训练框架如图所示,从离散事件仿真或真实车间获取状态,通过 GNN 嵌入、Actor 网络决策和奖励反馈形成闭环:
四、实验设计与结果分析
4.1 数据集与基准方法
论文设置四个不同规模的混合生产案例,分别包含 3–8 种工件类型和 5–12 种机器类型,具体参数见 Table 1(原文第7页)。训练阶段每类工件订单量在 0–20 之间随机生成;测试阶段扩展至更大订单规模,以验证模型泛化能力。比较算法包括经典调度规则 FIFO、SPT、LPT、SRPT 和 LRPT,以及改进的遗传算法(GA)和已有 DRL 方法。性能指标为完工时间 和相对差距 。
4.2 小规模订单的训练与验证
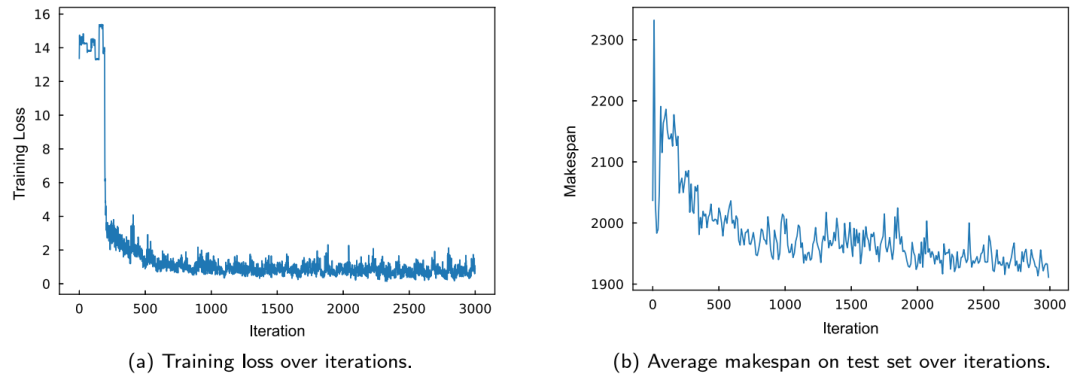
论文首先在小规模订单下训练模型并评估泛化性。以 Case 2 为例,训练损失和测试集平均完工时间随着迭代次数明显下降,表明模型收敛且对未知实例保持稳定表现。作者统计了四个案例各100个实例的平均完工时间和相对差距,结果显示提出的方法在所有案例中都取得最低完工时间,且相对差距均低于1%,而基准规则差距通常超过10%。这说明该方法在小规模场景下优于传统规则和遗传算法。
下图展示了 Case 2 的训练过程演化:
4.3 大规模订单与扩展性分析
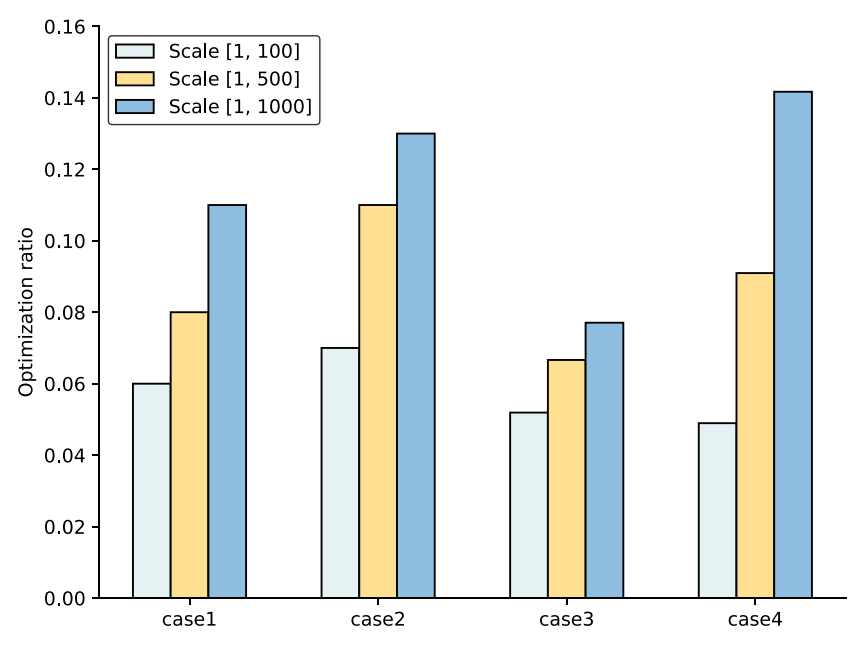
为考察在大规模订单下的表现,作者将每类工件订单数扩大至随机区间 。表4中的结果显示,提出的方法在所有规模下仍保持最低完工时间和最小相对差距,其优化比率随订单规模增大而显著上升。这是因为模型输入复杂度仅取决于工件类型数而非总工件数,随着作业量增长,方法的可扩展优势凸显。
图6给出了不同案例在三种规模下的优化比率柱状图,可以看出订单规模越大,优化比率越高:
除此之外,作者还统计了策略生成的运行时间。相比于 SRPT(最快规则),提出的方法略慢但仍能在 0.01 s 以内完成决策,满足实时要求。
4.4 动态订单插入实验
为验证应对插单的能力,作者在调度过程中随机插入 10 个新订单,插入时间服从 Poisson 过程,订单大小在 (5,20) 或 (10,40) 区间。采用与此前相同的训练模型进行测试,无需再训练。结果表明,在所有插单设定中,所提方法的平均完工时间均显著低于各类规则算法。作者进一步计算了相对优化比率,发现合理的插单响应策略能有效提升生产效率;所提方法在优化幅度和稳定性方面均优于基线。
五、创新点与结论
5.1 创新点与亮点
论文在混合模型排程研究中提供了若干创新:
改进析取图模型:将同类型工件的同一工序聚合为单节点。这种策略利用工件间的对称性,显著减少模型规模,提高调度效率。 图神经网络的状态表示:利用 GNN 嵌入操作和机器节点特征,捕捉工序顺序和机器冲突的语义信息。 基于 PPO 的 DRL 框架:在策略网络前加入动作掩码,结合近端策略优化算法稳定训练,并通过离散事件仿真环境采样,使策略具有实时性与可移植性。 适应动态插单:提出通过更新析取图状态并利用同一策略进行决策的机制,能够无需重新训练即可快速响应新订单。 可扩展性与稳定性:模型复杂度随工件类型数量而非订单数量增长,实验结果表明其在大规模订单和不同插单设置下都能保持稳定优越的性能。
5.2 总结与展望
论文将混合模型排程问题转化为马尔可夫决策过程,构建了基于改进析取图和图神经网络的深度强化学习框架,有效解决了大规模排程与动态插单的难题。实验结果表明,该方法在多种规模和插单情景下均大幅降低完工时间,并具有良好的泛化能力。未来工作可考虑引入运输时间、缓冲区限制和换模时间等现实因素,扩展模型处理更复杂的生产约束,为智能制造提供更全面的决策支持。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、汪朝杰、王一航、张仁义(EIC)、张晓乐
原文链接:https://doi.org/10.1016/j.cor.2025.107345
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。