论文题目:强化学习求解组合最优化问题的研究综述
第一作者:王扬 昆明理工大学硕士毕业生,师从陈智斌教授,研究聚焦:组合最优化与人工智能。
通讯作者:陈智斌 教授,博士生导师,昆明理工大学系统科学系系主任,主要研究方向聚焦于组合最优化、近似算法、图论、运筹学、人工智能算法等,承担并完成多项国自然科研项目。
E-mail: chenzhibin311@126.com
强化学习求解组合最优化问题的研究综述
论文摘要
本文综述强化学习(RL)在解决组合最优化问题(COP)上的研究进展。组合最优化是从有限离散组合中寻找最优解的一类问题,广泛存在于运输调度、资源分配等领域。随着实例规模增大与动态/随机因素增多,传统精确算法和近似算法面临计算复杂度高、泛化能力弱等挑战。深度学习与强化学习的发展为组合优化提供了新的思路:通过智能体与环境的交互学习策略,无需人工设计算法便能在有限样本甚至无样本条件下求解复杂COP。本文首先介绍COP与RL的基本概念及主要难点和优势;然后按照方法框架梳理五类研究路线:基于神经组合优化模型(NCO)、基于动态输入模型、基于图结构模型、RL结合传统算法、改进的RL模型;在每一类中对代表性工作、关键技术和实验结果进行比较分析;最后提出COP与RL结合的研究展望。
一、研究背景与核心问题
1.1 组合最优化问题概述
定义与应用:组合最优化旨在从一个有限的离散集合中寻找最优方案。典型问题包括旅行商问题(TSP)、车辆路径问题(VRP)、背包问题(KP)、集合覆盖问题等。
传统方法困境:
精确算法(如分支定界、动态规划)虽然能得到全局最优解,但时间复杂度呈指数增长,难以处理大规模实例。 近似算法利用贪婪、局部搜索或线性规划在多项式时间内给出近似解,但需要针对特定问题设计,且近似比难以改进。 启发式/元启发式方法(遗传算法、蚁群算法等)能快速获得可行解,但缺乏稳定的性能保证。 NP‑难与组合爆炸:大多数COP属于 NP 难问题。实例规模增长会导致“组合爆炸”现象,求解时间与空间复杂度呈指数增长。
1.2 强化学习与深度强化学习
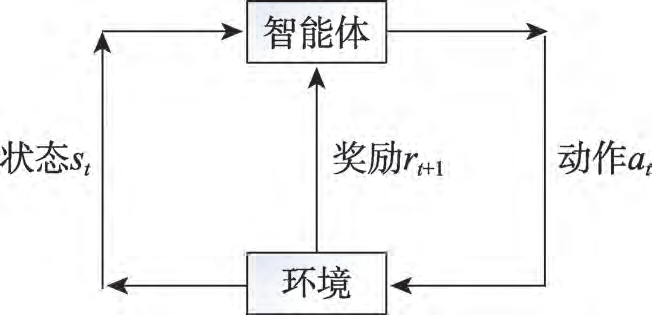
RL的序贯决策本质:强化学习通过智能体与环境的交互,在状态-动作空间中学习策略以最大化累计奖励。本质上属于马尔可夫决策过程,状态 、动作 、奖励 与策略 构成决策循环。 DL与RL结合的优势:深度神经网络(DNN)能够自动提取复杂特征,与RL结合构成端到端的决策系统,在围棋 AlphaGo 和自动驾驶等领域已表现出卓越性能。
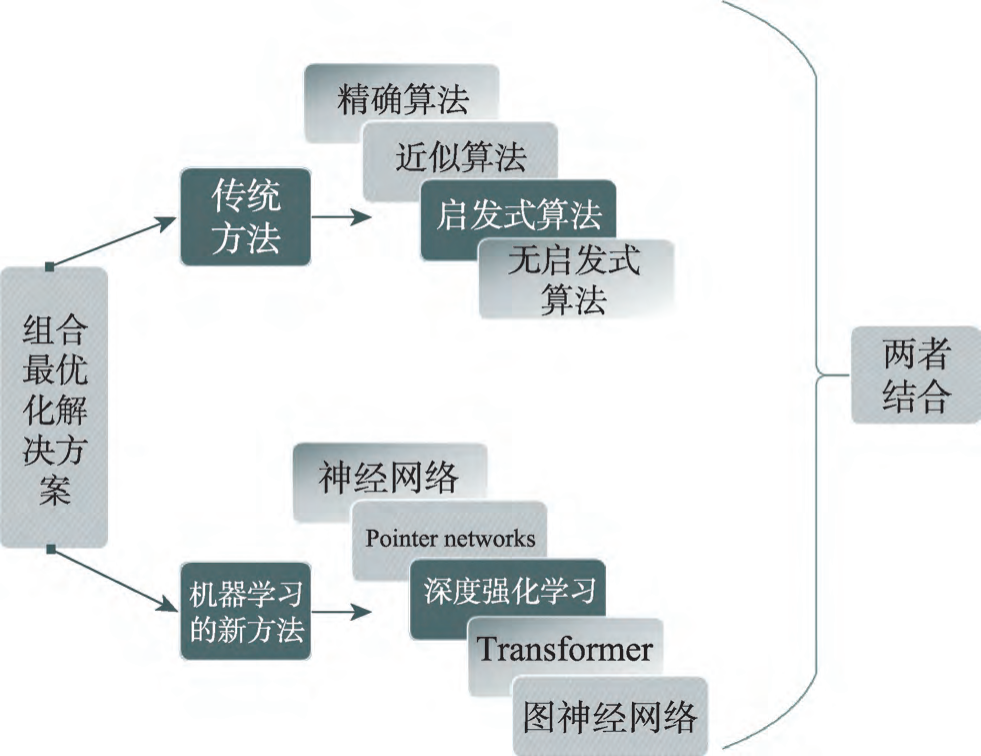
下面的图1显示了传统算法与强化学习解决组合优化的两种思路:传统路径依赖人工设计算法,而RL路径通过学习策略自动求解问题。
二、强化学习求解组合优化的难点与优势
2.1 组合优化的求解难点
缺乏统一近似算法:若假设 ,一般形式的 TSP 不存在多项式近似算法;背包问题等也无法在多项式时间内获得一定近似比。 对偶归约复杂:许多近似算法依赖于将原问题归约到对偶问题,但寻找合适的对偶问题及其下界非常困难。 结构相似性未充分利用:不同实例或类似问题间存在结构相似性,传统算法难以迁移,不利于处理动态或随机变化的输入。 组合爆炸:实例规模增大导致搜索空间呈指数增长,使传统算法难以满足实时求解需求。
2.2 强化学习的优势
泛化能力强:训练完成后模型参数可迁移到不同实例或问题变体,通过学习算法替代手工设计算法。 求解速度快:RL可产生质量较高的初始解并通过策略更新迅速逼近最优解;深度网络的表达减少搜索空间。 伸缩性好:结合GPU/TPU加速,RL模型适用于大规模COP。 减少标签依赖:与监督学习需要大量标签不同,RL通过奖励信号直接评估策略,降低生成标签的成本。
2.3 RL与COP的结合——以 TSP 为例
TSP 可建模为马尔可夫决策过程:状态为已访问城市集合 ,动作为下一个选择的城市 ,奖励设为路径总长度的负数。环游长度为:
强化学习通过参数 学习策略 以最大化奖励,其中策略表示为:
这种建模突出了RL与组合优化的天然契合:RL通过探索状态转移学得最短路径策略。
2.4 深度强化学习模型
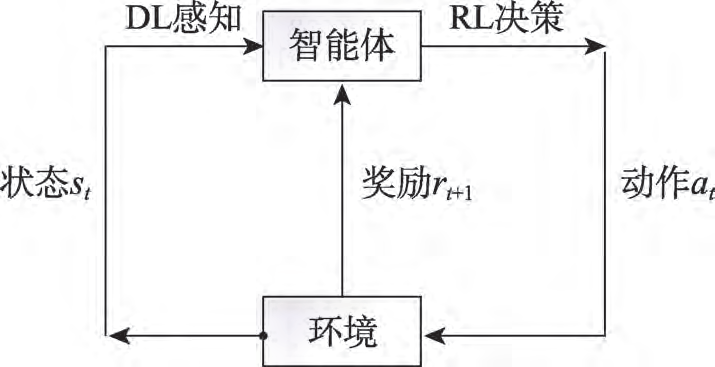
下面的图2展示了强化学习的基本环路(状态、动作、奖励与环境)。图3进一步引入了深度学习感知模块,使智能体能自动提取特征并进行决策。
三、主要方法分类与技术细节
根据文献整理,RL求解COP的方法主要包括五类。下文将逐一梳理每类方法的核心思想、技术细节及代表性成果。
3.1 基于神经组合优化模型(NCO)
核心思想:将组合优化问题表示为序列并用神经网络直接输出解,常采用指针网络(Pointer Networks)结合策略梯度学习。关键技术:
Pointer Networks结构:编码器以 LSTM 或 Transformer 对输入节点序列编码,解码器通过注意力机制逐步指出下一个选择的节点,输出序列即为解。下面的图4为 Pointer Networks 模型结构。
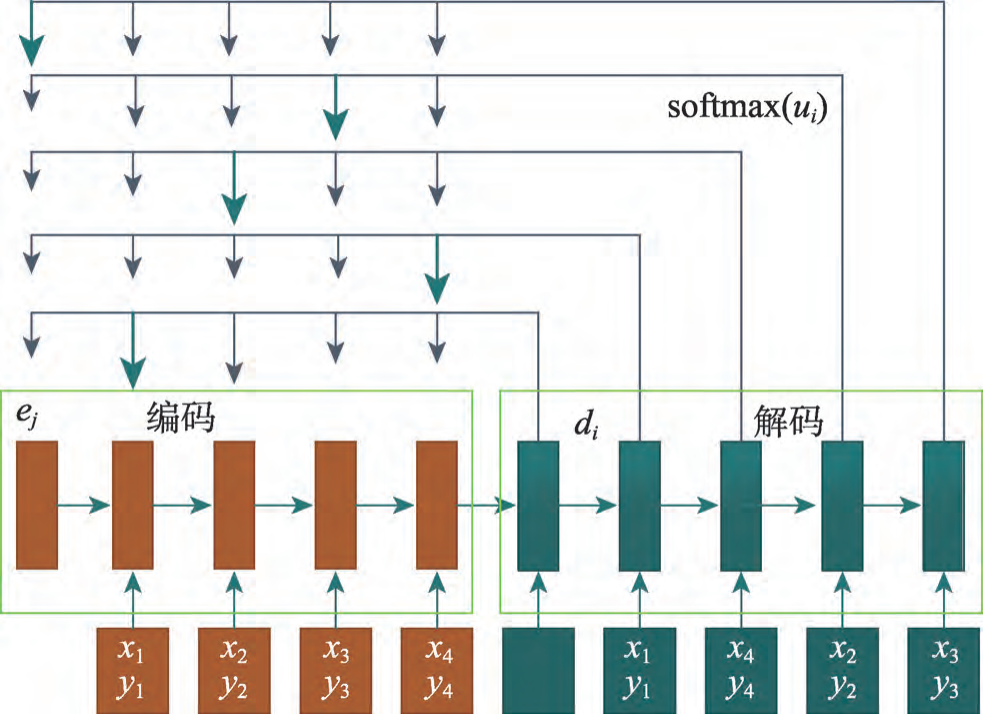
策略梯度训练:采用 REINFORCE 算法,以实例的环游长度作为奖励训练模型参数。为降低方差,引入 critic 网络作为基准估值,利用均方误差训练估值网络。
代表研究:
Bello 等人提出 NCO 框架并在 100 节点 TSP 上取得优于 Christofides 算法的结果。 Chen 与 Tian 设计 NeuRewriter 框架,用迭代重写改进解,采用 Q-AC 算法训练,解的质量超过专业求解器。 Joshi 等人将监督学习与RL结合训练 TSP,证明协同训练能提高泛化能力,并将模型从小规模推广到大规模图。 Miki 等人结合CNN学习TSP路线图像特征,并在推理阶段使用贪婪与2-opt搜索,显著提高解的质量与速度。
局限性:NCO方法通常在固定规模(如100节点TSP或200物品KP)上训练,泛化能力有限,训练速度较慢。
3.2 基于动态输入模型
背景:车辆路径等问题输入带有实时动态信息,传统指针网络难以处理。技术要点:
动态编码:用一维CNN替代RNN编码输入,使模型对节点顺序不敏感。 注意力解码:采用注意力机制融合静态与动态嵌入,通过 softmax 输出节点概率。 策略训练:使用策略梯度并结合贪婪搜索与波束搜索提升解的质量。
代表研究:
Nazari 等人将 PN 扩展为处理动态信息的模型,在 50 和 100 节点 VRP 上优于经典启发式算法。 Kool 等人采用 Transformer 编码节点嵌入,引入上下文节点改善解码,并使用基于确定贪婪搜索的基准函数训练模型。 Oren 等人提出 SOLO 框架,使用深度 Q 学习结合蒙特卡罗树搜索(MCTS)提升稳定性和泛化能力。 Bo 等人建立动态 Attention 模型,通过动态编码-解码快速处理实例中的随机因素。
局限性:大多数模型训练在100节点规模,参数众多、时间成本高;迁移到更大实例时表现下降。
3.3 基于图结构模型
背景:许多COP可表示为图,在图结构上直接建模可利用节点和拓扑信息。技术要点:
图神经网络(GNN):通过邻居聚合更新节点嵌入,以捕捉图的局部结构。GNN模型的基本流程:输入图经过多层聚合与ReLU激活,生成低维稠密向量后输出。
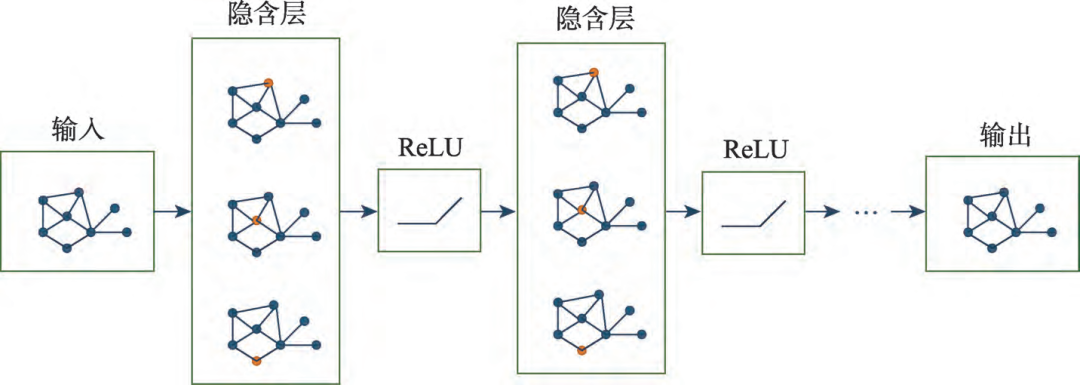
Q‑学习结合图嵌入:S2V-DQN模型将图嵌入与Q‑学习结合,能在300节点TSP、500节点MVC上泛化。 AlphaGo Zero思想:CombOpt Zero框架利用MCTS与GNN结合,采用回报归一化解决奖励不固定的问题,泛化能力优于S2V-DQN。 Transformer与GNN融合:Bresson 等人采用Transformer自注意力编码图节点,解码结合波束搜索,采样2500次后50‑TSP最优间隙仅0.004%,100‑TSP最优间隙0.39%。
局限性:训练常在100–200节点规模,模型收敛性受限,难以反映问题根本属性。
3.4 RL结合传统算法
思路:利用RL产生高质量初始解,结合经典启发式或优化算法提升解的质量。代表工作:
Deudon 等人改进NCO模型,引入Transformer编码和REINFORCE训练,推理阶段结合2‑opt搜索,使50‑TSP与100‑TSP解的质量接近Christofides算法。 Cappart 等人使用决策图(DD)结合Q‑学习确定变量顺序,提高上界和下界的质量。随后又提出将DRL与约束规划结合的模型,在带时间窗TSP和4‑PORT问题上优于专业求解器。 Gao 等人在变邻域搜索和LKH3算法中引入Q‑学习和Sarsa,通过RL选择候选边,提升TSP求解精度。 Costa 等人设计模型学习2‑opt操作,策略神经网络使用PG算法学习局部搜索的决策步骤,收敛速度更快。
局限性:仍需要传统操作(贪婪搜索、2‑opt、波束搜索等),训练时间较长且泛化性不强。
3.5 改进的强化学习模型
目标:通过改进网络结构与训练机制提高RL求解能力。代表成果:
Lu 等人提出分层学习迭代框架求解 CVRP,结合分层策略和REINFORCE算法,在100‑CVRP上达到平均成本15.57,速度超过传统算法。 Li 等人提出DRL‑MOA框架,在Pointer Networks中融合分解策略和邻居多参数传递策略,利用AC算法训练,实现动态TSP与多目标TSP的高效求解。 Silva 等人设计多智能体自适应启发式(AMAM),在VRPTW和工件调度上优于单智能体框架。 Ma 等人利用分层强化学习构建图指向网络(GPN),将城市点嵌入与图嵌入结合,模型参数可从小规模TSP迁移至500/1000节点实例。
局限性:大多方法训练时间长,受限于固定规模;一些模型易陷入局部最优且泛化性差。
3.6 主流算法分类与对比
文献还对深度强化学习算法进行了分类:值函数类(Q‑学习、DQN、AC/A2C/A3C 等)、策略梯度类(REINFORCE、PPO、TRPO等)和基于模型的算法(GPS、Alphazero 等)。下图汇总了主流RL算法分类。
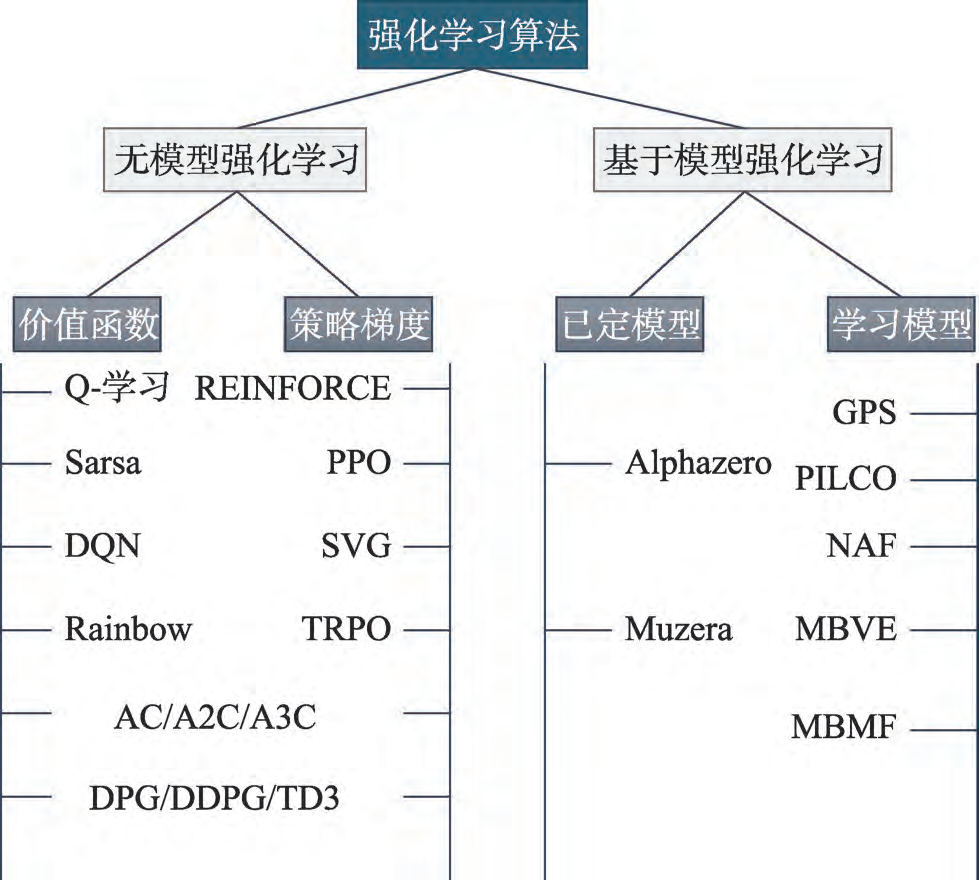
实验比较表明:在小规模 TSP 上,Bresson 等的Transformer+BS方法可达到最优解且速度快;Joshi 等人的基于波束搜索的模型精度较高但运行时间较长;Kool 等人的贪婪搜索方法在秒级时间内能得到近似解,适合在线求解。在 VRP 方面,Lu、Chen等结合传统算法的模型在精度上超过 LKH3 和 OR‑Tools,但求解范围有限。
四、实验对比与综合评价
TSP实验:采用Concorde、Gurobi、OR‑Tools等专业求解器作比较,RL模型在20/50/100节点TSP上与最优解间隙普遍在0.1%–8%之间。Bresson 等模型通过采样和波束搜索,50‑TSP的最优间隙仅0.004%,但训练和采样耗时较长。 VRP实验:在20/50/100节点VRP上,Nazari 模型和Kool 模型取得比OR‑Tools更低的花费和更快的推理速度,但与LKH3相比仍有一定差距。Lu 模型在100‑CVRP上达到目前最优平均成本15.57,显示RL+后处理的优势。
总体而言,RL方法在求解速度和动态处理上具有明显优势,但在精度和泛化能力方面仍与顶尖求解器存在差距。对于大规模实例及复杂约束,RL与传统算法的结合或图神经网络的引入能显著提升性能。
五、结论与研究展望
5.1 主要结论
概念耦合:组合最优化与强化学习具有天然耦合——COP求离散排列的最优策略,RL擅长序贯决策,可通过状态、动作、奖励的映射学习最优解。
方法体系:当前研究可分为五大类:NCO模型、动态输入模型、图结构模型、RL结合传统算法、改进RL模型,每类方法针对不同问题特性设计编码‑解码结构与学习策略。
技术亮点:
指针网络与注意力机制解决端到端生成序列的难题,提高解的质量。 图神经网络充分利用图结构信息,能在中等规模实例上泛化。 RL与启发式/约束规划结合在保证解质量的同时加快求解速度。 层次化或多智能体框架提升调度与多目标问题的效率。 不足:多数模型在固定规模训练,泛化至更大规模或多约束问题时效果有限;训练时间长,收敛性与稳定性仍待提升。
5.2 未来研究方向
扩大求解范围:结合分而治之思想,将大规模问题分解为子问题,利用子图采样、热图合并等技术扩展RL模型的适用范围。 复杂多目标优化:探索RL在多目标、多约束、在线动态决策等复杂COP中的应用,构建适应性更强的模型。 模型改进与压缩:深入研究Transformer与GNN融合的编码-解码结构,引入微分方程数值方法优化网络参数,提高收敛性并减小模型规模。 应用推广:将RL求解COP的方法推广到智能交通、在线调度等实际领域,与高性能计算结合,实现实时决策。
通过对上述研究的梳理可以看出,强化学习在组合最优化领域尚处于起步阶段,但凭借自动学习策略的特点已展现出超越传统方法的潜力。随着深度学习框架和图神经网络的进步,相信未来RL将在运筹优化领域发挥更大的作用,为解决NP难题提供强有力的工具。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、汪朝杰、王一航、张仁义(EIC)、张晓乐
原文链接:doi: 10.3778/j.issn.1673-9418.2107040
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。