基于深度强化学习的组合优化研究进展
论文摘要
组合优化问题普遍存在于国防、交通、工业制造及电力调度等各类场景,其数学形式为在 有限离散决策空间 中寻求最优解的最小化问题。传统求解思路分为 精确方法 和 近似方法 :精确算法(分支定界法、动态规划等)可以获得全局最优,但计算复杂度随问题规模呈指数增长,难以适用于在线场景;近似算法和启发式算法能够在有限时间内求得较好解,但解质量和泛化能力难以保证。随着深度学习和强化学习的发展,研究者开始利用神经网络学习组合优化的隐含结构,并用深度强化学习(DRL)进行序贯决策。DRL 的 “离线训练、在线决策” 特性使得在无需重新搜索的情况下即可快速给出新问题的解,这为实时组合优化提供了新思路。本文对基于深度强化学习的组合优化研究进行了系统梳理,从端到端神经网络模型(Pointer Network、图神经网络)到 利用 DRL 改进局部搜索 的方法进行全面解析,并总结了各类模型的优缺点和应用成果。文章还提出了未来的研究方向,如改进模型结构、提高训练效率、拓展到多目标与约束优化以及工程在线调度等。
一、研究背景与组合优化问题定义
1.1 组合优化问题的特点与数学模型
组合优化问题的决策变量定义在有限离散集合 上,其目标是在满足约束条件 的情况下最小化目标函数 。该问题的数学表述可写为:
其中 为决策变量, 是优化目标, 表示约束函数, 为离散决策空间。
应用广泛:组合优化广泛应用于旅行商问题(TSP)、车辆路径问题(VRP)、车间作业调度、背包问题、顶点覆盖等。 复杂度高:解空间大小随问题规模指数增长,传统穷举或精确算法只能处理小规模实例。 经典算法:现有方法分为精确算法(Branch and Bound、动态规划)和近似算法(贪心、局部搜索、遗传算法、蚁群、粒子群等)。精确算法计算量大,近似算法求解速度快但解质量难以保证。
1.2 深度强化学习的兴起
近年来深度学习在图像、语言等领域的突破促使研究者关注如何将其应用到组合优化上。深度强化学习(Deep Reinforcement Learning, DRL) 擅长通过与环境交互学习策略,其“离线训练、在线决策”的特点与组合优化中的“离散动作选择”天然契合。因此,利用 DRL 解决组合优化问题不仅能减少在线搜索时间,还可能学习到具有普适性的解构造策略。
二、深度强化学习解决组合优化的基本原理
2.1 深度强化学习概述
DRL 通过与环境试错获得策略,策略在马尔科夫决策过程中定义为状态 到动作 的映射,其概率模型一般表示为 。优化目标是最大化期望奖励,通过梯度下降更新神经网络参数 。由于组合优化问题的反馈通常以路径长度、成本等表示,研究者普遍使用 REINFORCE 算法,并引入基线函数 减小方差。
2.2 Pointer Network 端到端模型
2.2.1 模型结构与编码解码流程
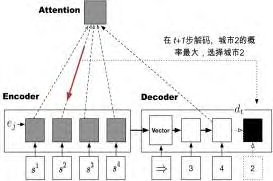
Pointer Network 是处理序列到序列映射的一种端到端模型。其核心思想是用循环神经网络(LSTM)对输入序列编码,然后结合 注意力机制 逐步“指向”输出序列中的元素。
对于 TSP 问题,模型首先将每个城市的二维坐标映射为高维节点向量 ;编码器依次读入这些向量并得到一个整体表示 Vector 及每个城市的隐藏状态 。接着解码器在每一步根据当前隐藏状态 和编码器输出的 计算选择下一个城市的概率,直到生成完整的访问序列。
在下图中展示了 Pointer Network 的结构,其编码器和解码器通过注意力实现“指针”操作,自动从输入序列中选择输出位置。
2.2.2 注意力机制与概率计算
在解码阶段第 步,模型通过注意力机制计算每个候选城市的得分:
其中 是城市 的编码隐藏状态, 是解码器的当前隐藏状态, 为网络参数。概率最大者即为下一步选择的城市。
2.2.3 强化学习训练策略
Pointer Network 可以通过监督学习(依赖大量最优解标签)或强化学习训练。鉴于生成标签困难,多数研究采用 REINFORCE 算法对模型参数 进行训练。
具体而言,将 TSP 定义为马尔科夫过程:状态为城市坐标及已访问城市,动作为选择下一个城市,奖励为路径距离的负数。通过策略梯度更新,模型能够 学习到构造高质量解的策略 。为了减小方差,常引入基线 估计策略的平均表现,并使用 Critic 神经网络预测该值。
2.3 图神经网络方法
2.3.1 图神经网络与节点特征更新
组合优化中的许多问题以图形式表达,如顶点覆盖或最大匹配等。图神经网络(Graph Neural Network, GNN) 通过聚合邻居节点和边的特征以计算节点嵌入。经典 GNN 模型的更新公式为:
其中 是节点 在第 层的表示, 为节点特征, 为边特征, 为邻居 的表示。反复迭代直至收敛后得到每个节点的嵌入。
2.3.2 GNN 在组合优化中的应用
通过学习节点嵌入,可对节点选择类问题直接预测哪些节点属于解集。例如在最小顶点覆盖或最大独立集问题中,将嵌入映射为选择概率并使用贪婪策略构造解。对于边选择类问题(如 TSP),可将两个节点的嵌入映射为边存在概率并辅以波束搜索或局部搜索构造哈密顿回路。早期研究将 structure2vec 与 DQN 结合,用 DQN 估计节点价值并迭代选择;后续工作通过 GCN、Graph Attention 等网络改进嵌入表示,并与 Pointer Network 结合,从而在 TSP 等问题上取得更好效果。
三、主要模型与算法发展
3.1 Pointer Network 端到端模型的发展
3.1.1 基线模型与多头注意力改进
Vinyals 等人提出的 Pointer Network 是最早将序列模型应用于 TSP 的工作。随后 Bello 等人采用 REINFORCE 和 Critic baseline 训练该模型,对输入路径进行采样并用损失反向传播,提高了求解质量。在模型结构方面,Deudon 等人采用 Transformer 的多头注意力代替 LSTM 编码器,使得模型能更充分捕捉节点间关系;Kool 等人进一步使用 Transformer Attention 与 REINFORCE 结合,提供贪婪解码与采样两种策略,其模型在 100‑TSP 问题上接近最优解且求解速度快。
贪婪策略 vs. 采样策略:贪婪策略每步选择最大概率城市,求解时间极短但解质量受限;采样策略通过多次采样取最优解,质量更高但计算时间长。 集成局部搜索:将 Pointer Network 生成的解与 2OPT 或其他局部搜索结合可以进一步提升结果,证明神经网络与传统启发式结合的有效性。
3.1.2 监督学习与强化学习训练方法比较
监督学习需要大量最优路径作为标签,难以在实际问题中构建,因此目前主流方法采用强化学习训练。Li 等人对监督学习与强化学习进行了对比实验,发现强化学习收敛较慢但具有更强的泛化能力。改进方向包括在 REINFORCE 中使用 Critic-baseline、rollout-baseline 或层次强化学习(HRL)降低方差,提升模型稳定性。
3.2 图神经网络端到端模型与混合模型
3.2.1 代表性端到端 GNN 模型
Dai 等人采用 structure2vec 与 DQN 结合求解 MVC、MAXCUT、TSP 等问题,通过 DQN 估计节点价值并贪婪选择。随后 Mittal 等人将 GCN 与 Actor‑Critic 结合求解 CVRP,利用 Critic 网络评估解的优劣。Yolcu 等人使用 GNN + REINFORCE 解决 Satisfiability、MIS、MVC 等问题,显示深度强化学习能自动学习变量选择策略,但运行时间较传统算法长。
3.2.2 图指针网络与混合架构
为兼顾序列决策与图结构建模,研究者尝试结合 GNN 与 Pointer Network。Ma 等人设计了 Graph Pointer Network (GPN),编码器由 Point Encoder 和 Graph Encoder 两部分组成:前者提取点嵌入,后者用 GNN 捕捉图结构,解码器仍采用注意力机制。这种混合架构在大规模 TSP 上比纯 Pointer Network 更具优势。
3.3 深度强化学习改进的局部搜索方法
3.3.1 NeuRewriter:局部搜索策略学习
Chen 等人提出 NeuRewriter 框架,将深度强化学习用于学习局部搜索中的“区域选择器”与“规则选择器”。算法先随机生成初始解,通过局部操作逐渐改进解质量;与传统人工启发式相比,该框架利用 Actor-Critic 训练策略,实现了在作业调度和 VRP 问题中优于 DeepRM 与 OR-Tools 的效果。
3.3.2 大规模邻域搜索与 PPO
Gao 等人结合大规模邻域搜索(LNS)与深度强化学习,利用图注意力网络编码问题状态,解码器输出 Destroy / Repair 算子。通过 PPO 训练,模型在 100‑CVRP 问题上的性能超过 Kool 等人的端到端模型,在 400‑节点大规模 CVRP 问题上收敛更快但未达到最优解。
3.3.3 Learn to Improve 框架
Lu 等人提出的 LSI 框架包含提升算子与扰动算子两个模块,训练策略在每一步选择适当算子以提升当前解或扰动解。实验表明 LSI 在 20/50/100‑CVRP 问题上既超越 LKH3 的解质量又具有更快求解速度。
3.4 多目标组合优化与其他扩展
针对多目标组合优化,Li 等人提出 DRL‑MOA 框架,将多目标问题分解为多个子问题并用 Pointer Network 建模,通过邻居参数迁移实现协同训练,在 200‑或 500‑目标 TSP 上显著超越传统多目标演化算法且保持高泛化能力。此外,研究者还尝试在图匹配、资源分配等领域应用 DRL,探索图神经网络与注意力机制的更深结合。
四、实验评估与性能比较
4.1 TSP 与 VRP 端到端模型性能
论文汇总了端到端模型在不同规模 TSP 上的表现。对于 20/50/100 城市的 TSP,基于 Transformer Attention 的模型(如 Kool 等人)在解质量和速度上均优于早期的 Pointer Network 和图神经网络模型;结合 2OPT 等局部搜索可进一步提高解质量。然而,当问题规模超过 100 节点时,模型效果仍落后于专业求解器 LKH3,但其求解速度优势明显。
在 VRP 场景中,Nazari 等人利用 Pointer Network 解决带货物约束的动态拾取配送问题;Kool 等人的 Transformer 模型通过贪婪解码快速生成解。大型 VRP 数据集的比较显示,深度强化学习端到端模型在解质量与传统启发式之间存在差距,但训练完成后能实现秒级求解。
4.2 局部搜索方法与传统求解器对比
针对车间调度、CVRP 等问题,NeuRewriter、LNS‑PPO 和 LSI 等改进局部搜索方法的解质量显著优于 DeepRM、Google OR-Tools 等传统求解器,并在部分小规模实例上达到最优。然而,这类方法仍依赖多次搜索迭代,求解速度不如端到端模型,训练成本较高。
4.3 综合评价
端到端模型:训练完成后可快速求解任意规模的同类型问题,适合实时应用;但解质量在大规模问题上较难超过专业求解器。 局部搜索改进:通过学习局部搜索策略,可显著提高解质量甚至超过专业求解器,但求解时间长且训练复杂。 模型组合:将 Pointer Network 的注意力机制与 GNN 的结构表示结合,或在神经网络生成解的基础上附加局部搜索,是当前性能提升的有效途径。
五、挑战、创新与未来方向
5.1 模型结构与训练效率
现有模型多采用 LSTM 或 Transformer 作为编码解码器,但二者计算复杂度高且训练效率有限。未来研究可探索更高效的编码结构、图卷积与注意力的结合,并设计适用于组合优化的专用神经网络。同时,现有强化学习训练方法(REINFORCE、DQN)采样效率低,收敛慢,亟需开发针对组合优化特性的高效训练算法。
5.2 研究对象扩展
现有研究主要针对 TSP、VRP、Knapsack 等单目标问题。实际工业问题常包含多目标、多约束甚至动态变化的特征,如何将 DRL 扩展到多目标优化、约束优化和动态优化是重要方向。例如 DRL‑MOA 已在多目标 TSP 上取得突破,但多目标调度与资源分配问题仍待深入探索。
5.3 深度强化学习算法改进
REINFORCE 与 DQN 等基础算法难以充分利用组合优化问题的结构,未来需结合价值基线、自适应采样、层次策略等技术设计更高效的策略梯度方法。针对局部搜索方法,如何在保证搜索效率的同时提高策略泛化能力亦是挑战。
5.4 工程应用与在线调度
如何在工程实际中部署基于深度强化学习的组合优化模型仍是未决问题。例如,在线调度要求模型在不断变化的订单和资源约束下快速更新解,现有端到端模型虽具备在线决策潜力,但缺乏对约束变化的适应能力。通过增量学习、在线迁移和混合搜索等方法提升模型适应性将是未来重要方向。
六、结论
基于深度强化学习的组合优化研究近年来快速发展,Pointer Network 和图神经网络为端到端求解开辟了新思路,深度强化学习改进的局部搜索方法则在解质量上取得突破。这些方法展示了神经网络通过学习数据分布而自动构造优化策略的潜力。尽管如此,当前模型与专业求解器在大规模问题上的差距依然明显,且训练成本和应用范围受限。未来研究应在模型结构、训练算法和应用场景上持续创新,并探索与传统启发式的深度融合,以推动深度强化学习在组合优化领域的应用落地。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、汪朝杰、王一航、张仁义(EIC)、张晓乐
原文链接:https://doi.org/10.16383/j.aas.c200551
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。