原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。
时间窗约束组合优化场景:融合元学习的深度强化学习方法
论文摘要
本文针对 时间窗定向问题(Orienteering Problem with Time Windows, OPTW) 提出一套元学习增强的深度强化学习框架——MetaPNet‑OPTW。OPTW 是一种兼具 背包问题 与 旅行商问题 特征的 NP‑难组合优化问题,在物流配送、旅游线路规划与急救派遣等领域有重要应用。传统的元启发式方法在求解效率和泛化能力方面存在局限,近年来的深度强化学习 (DRL) 方法虽取得一定进展,但往往依赖非马尔可夫状态和手工遮蔽规则,难以适应新实例。
作者提出基于指针网络的 DRL 框架,并结合 马尔可夫状态表示 与 运筹学可行性规则,设计自适应遮蔽策略。为了提升跨实例泛化能力,引入 Meta‑Learning enhanced REINFORCE 算法,在多个实例的分布上进行“元训练”,使模型能快速适应新实例。通过积极搜索与束搜索进一步优化推理阶段。大量实验证明,该框架在 Gavalas 等数据集上更新了 20/33 个最佳已知解。本文还通过 t‑SNE 可视化分析了学到的潜在空间,揭示模型在不同数据族上的表现差异。综上,MetaPNet‑OPTW 实现了高效泛化的 DRL 求解器,为时间窗定向问题开辟了新的研究路径。
一、研究背景与问题定义
1.1 OPTW 的提出与应用场景
问题背景:OPTW 要在有限时间预算内选择一条路线,使车辆从起点到终点访问若干客户并最大化总收益,其本质是选择高价值顶点并安排最佳巡游路径。
应用场景:
物流配送:在规定时间窗口内完成多客户配送,最大化收件数量或收益。 旅游路线规划:游客在有限时间内尽可能多地游览景点。 应急服务调度:救护车在规定时限内尽可能多地救治病人。 研究难点:NP‑难问题,传统元启发式如模拟退火、变邻域搜索等在大规模实例上求解效率有限;现有 DRL 方法多基于非马尔可夫状态和经验遮蔽规则,泛化能力差。
1.2 数学模型与约束
设图 表示所有顶点及其连线, 为起点, 为终点; 表示客户集合。每个顶点 具有收益 、服务时长 以及时间窗 ,车辆必须在时间窗内到达并服务。决策变量包括:
:车辆是否在顶点 后访问 ; :是否访问顶点 ; :在顶点 的服务开始时间。
目标是最大化总收益,基本模型如下:
约束包括起点和终点的流守恒、每个客户最多访问一次、累积时间符合时间窗以及车辆总行程不超过 等。这些约束保证了路线的合法性与时间可行性。
1.3 现有 DRL 方法的局限
非马尔可夫状态:以历史访问序列作为状态导致维数高且不可转移,难以在新实例上泛化。 遮蔽规则手工化:多数算法仅遮蔽已访问顶点或违反时间窗顶点,无法体现更多运筹学结构信息。 缺乏跨实例泛化:训练模型往往只适用于固定规模或特定分布的实例。
二、创新方法与技术框架
2.1 高效马尔可夫状态表示与自适应遮蔽
为克服非马尔可夫表示的局限,作者在 多利润定向问题 (MPOP) 的基础上提出一种精简的马尔可夫状态 :
:一维布尔向量记录各顶点是否已访问; :从起点到当前顶点的累计行程时间; :累计收益; :当前顶点索引。
通过合并具有相同服务状态和累计收益的部分路线,该表示显著减少状态空间,保留马尔可夫性质。文章以简单实例比较基本与精简状态(下图):
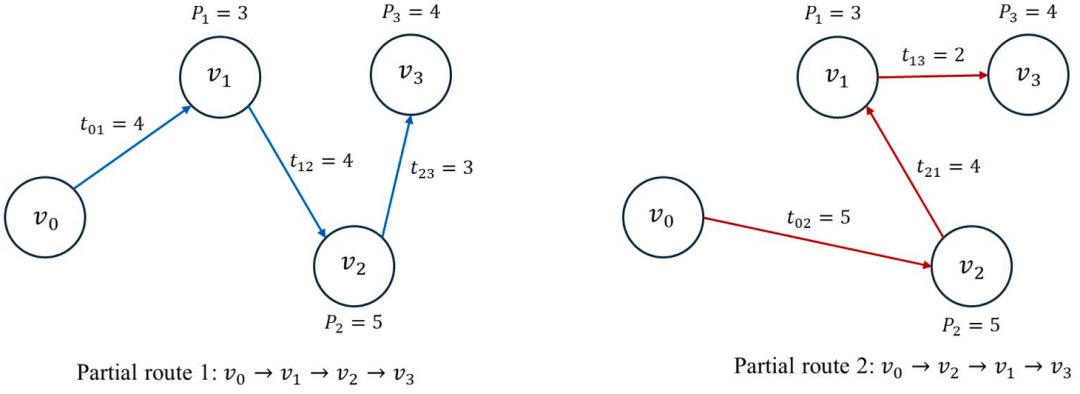
结论:基本状态需记录完整访问序列,其数量上界为 ;提出的精简状态上界仅为 ,大幅减少状态数。 自适应遮蔽:结合该状态,作者设计出三类可行性规则,不仅遮蔽已访问顶点,还通过累计时间预算、连接性等更高级条件过滤不可行顶点,使蒙版决策兼具普适性和效率。
2.2 指针网络框架与改进
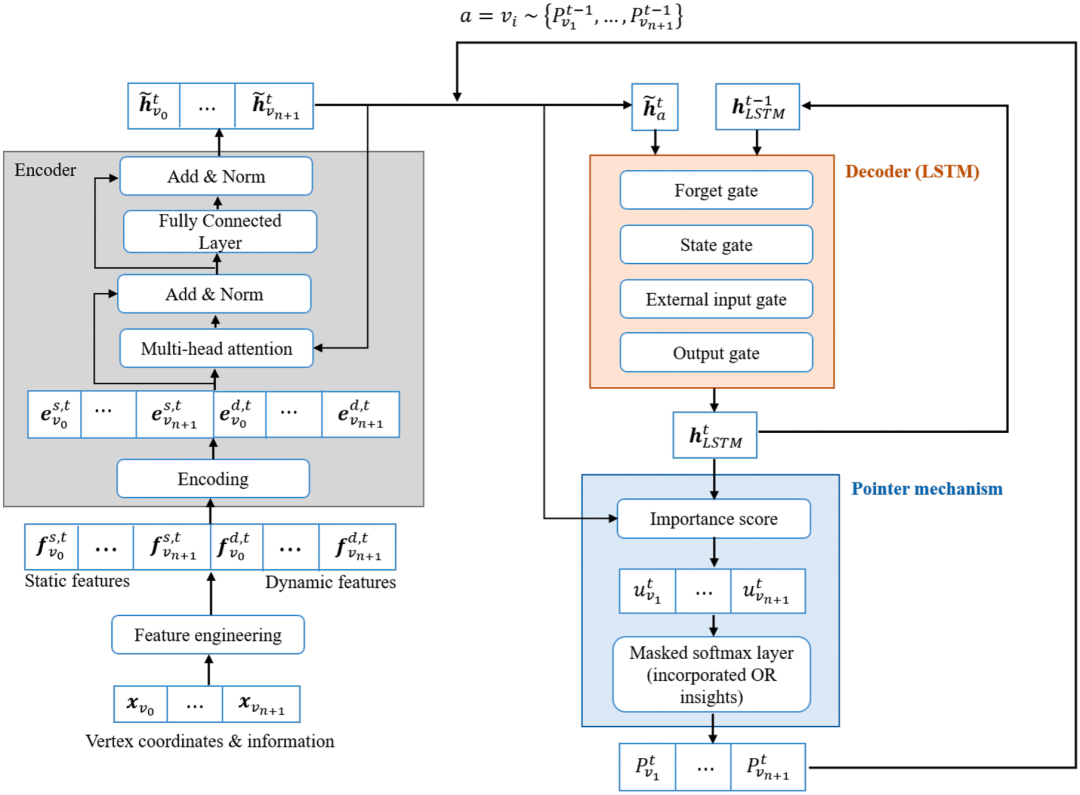
MetaPNet‑OPTW 采用基于 指针网络 (Pointer Network) 的深度神经结构:由 编码器、解码器 (LSTM) 和 指针机制 三部分组成,如下图所示:
关键改进包括:
输入特征增强:静态特征包含顶点坐标、时间窗、服务时长和最大巡游时间等;动态特征由马尔可夫状态计算,例如当前时间 、当前顶点 的位置及已访问标记 。 运筹学遮蔽机制:与以往只通过简单遮蔽保证可行性不同,本模型在指针机制的 softmax 计算中加入基于命题的可行性检查,使网络在解码时自动排除不可行的后继顶点。 训练策略优化:对比 Gama 和 Fernandes (2021) 的方法,本模型采用递归 Encoder,使编码器在每一步动态更新顶点表示;Decoder 使用 LSTM 逐步生成解决方案;Pointer 机制根据上下文计算下一个访问顶点的概率。
2.3 元学习增强的 REINFORCE 算法
传统 REINFORCE 训练的指针网络仅针对特定实例学习策略,缺乏泛化能力。作者引入 元学习 (Meta‑Learning) 思想,将训练分为外循环和内循环:
外循环:从实例分布 中采样不同的 OPTW 实例,每个实例为一项任务,旨在学习跨任务共享的初始化参数。 内循环:在给定实例内,对多个候选路线进行采样更新,以适应该实例。
其优化目标为:
其中 为在实例 上通过策略 得到的总收益。与经典模型不同,本算法内外循环共用同一参数 ,采用单步内循环更新来降低计算成本,同时通过批量平均收益作为基线减少梯度方差。
推理阶段:采用抽样、贪心、束搜索以及主动搜索四种策略。其中束搜索保持多个最优候选路线,可视为对贪心解的改进;主动搜索在推理过程中微调模型参数,使其更适应特定实例。
2.4 面临的挑战与应对
状态维数与可行性:难点在于同时追踪历史访问、累计时间和累计收益;提出的马尔可夫状态表示有效降低了状态空间规模。 遮蔽规则过于依赖经验:通过运筹学命题推导的自适应遮蔽,解决了手工规则在复杂约束下难以泛化的问题。 跨实例训练不稳定:元学习增强的 REINFORCE 在外循环中跨多个实例更新参数,并引入基准值缓解了训练波动。 推理效率:束搜索和主动搜索相结合既提高了解的质量,又使模型在推理时能快速微调以适应新实例。
三、实验设计与结果分析
3.1 基准数据集与实验设置
作者在 Solomon、Cordeau 和 Gavalas 等经典 OPTW 基准上进行测试,涵盖 ‑type、‑type、‑type、‑type 等不同类别,共数百个实例。模型采用两层多头注意力(8头)、256 维隐藏单元的编码器、128 维隐藏单元的解码器。通过统一实例分布采样训练,学习率 、批量大小 32。
3.2 整体性能
新最佳解数量:在 Gavalas (t‑type) 基准上,MetaPNet‑OPTW 在 33 个实例中更新了 20 个最佳已知解。 相对百分差 (RPD) :在 c‑type 实例上平均 RPD = –0.78%,即模型达到或超越最佳解;在 r‑type 实例上平均 RPD = –3.82%,说明随机型实例更具挑战;pr‑type 的 RPD 约 –1.07%;t‑type 平均 RPD 为 0.42%,说明模型在这些实例上优于基准。 泛化能力测试:作者将训练数据按实例族划分,在多个未见过的数据集上测试模型。在 c‑type 未见实例 c201–c204 上,平均 RPD 为 –0.78%;在 r‑type 未见实例 r202、r206、r207 上平均 RPD 为 –3.82%;结果表明模型能在无额外微调情况下近似最优解。
3.3 t‑SNE 潜在空间分析
为解释模型为何在不同数据族上表现差异,作者将经过主动搜索与束搜索的模型输出嵌入到二维 t‑SNE 空间。下图所示为按 相对时间差 RTD 着色的嵌入图,其中每个点代表一个实例的隐表示:
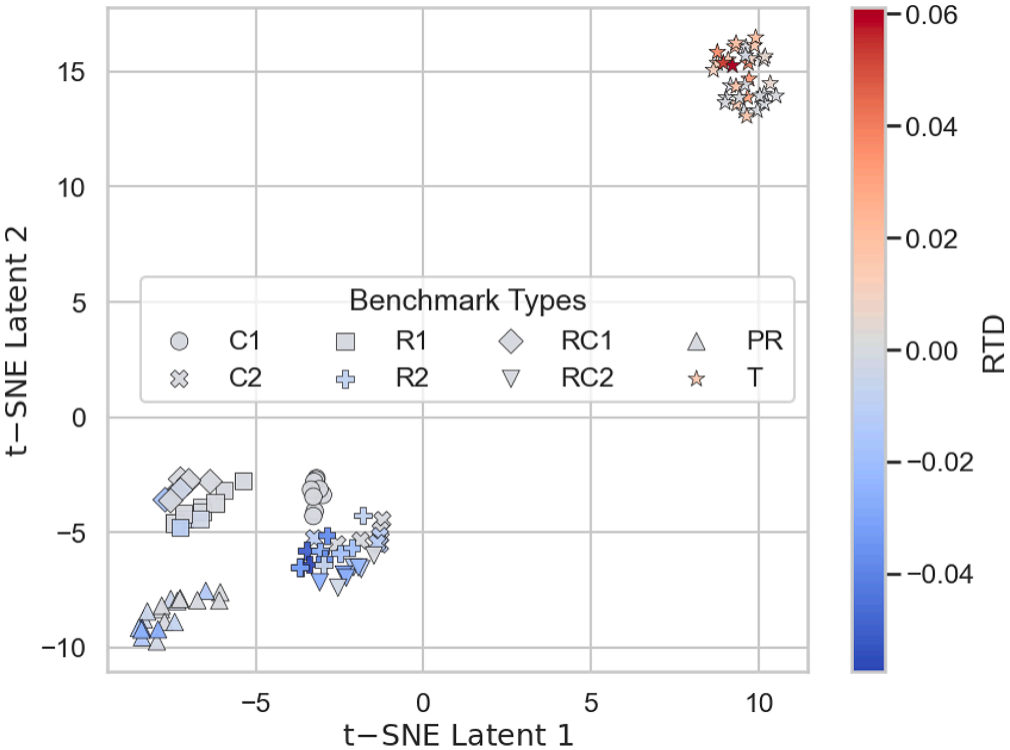
聚类现象:Solomon、Cordeau、Gavalas 三类数据形成明显的聚类;Gavalas 类实例集中在具有正 RTD 的区域,说明 MetaPNet‑OPTW 在这些实例上显著优于基准;而 r2 与部分 c2 实例聚集在低 RTD 区域,表明这些实例结构更难,模型表现较差。 指标解释:进一步通过可行路径统计(旅行距离的均值与标准差、可行利润的四分位距和标准差等)对 t‑SNE 嵌入着色,发现 Gavalas 实例的利润分布波动更大、可行距离更长,因此模型更容易通过元学习捕获其结构;Solomon 实例利润波动小,模型效果接近基准;Cordeau 实例则表现出高收益‑距离比,模型仍能找到高质量解。
3.4 消融与比较
与 Gama & Fernandes (2021) 的指针网络基线相比,本文模型的主要改进在于自适应遮蔽和元学习训练。消融实验显示:
仅使用基线遮蔽时,模型只能在部分实例中接近基准; 加入运筹学遮蔽后,性能提升明显; 再加入元学习训练可在未见实例上保持稳定性能,提高泛化性。
四、结论与启示
提出适用于 OPTW 的高效 DRL 框架:通过马尔可夫状态表示与 OR‑启发的遮蔽机制,MetaPNet‑OPTW 在减少状态空间的同时保证了训练效率和可行性筛选。 引入元学习提升跨实例泛化:Meta‑Learning enhanced REINFORCE 在多实例分布上学习共享初始化,使模型能快速适应新实例,实现“一次训练、多次适用”的 DRL 求解器。 实验更新最佳已知解:在 Gavalas 等数据集上更新了 20 个最佳已知解,整体 RPD 显著优于基准,表明该框架在实际路由优化中具有应用潜力。 可视化揭示实例难度:t‑SNE 分析显示不同数据族在隐空间中形成可分聚类,难度较高的 r2、c2 实例位于低性能区域,提示后续研究可针对这些实例设计更适应的特征或训练策略。 局限与展望:当前方法仍局限于单车 OPTW,对于多车或非确定性收益的变种尚未充分适应。未来可将该框架扩展到更复杂的车辆路径问题,并探索结合图神经网络与迁移学习的方案。
通过本篇论文的详细解析,可以看出 MetaPNet‑OPTW 不仅在算法设计上融合了运筹学规则与深度学习结构,还通过元学习思路实现了模型的快速适应与跨域泛化,为解决时间窗定向问题提供了新的研究方向和实践工具。
文章须知
推文编辑:单子叶
责任编辑:张仁义
原文链接:https://doi.org/10.1016/j.trc.2025.105450