原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。
可解释自动驾驶策略学习:深度强化学习与KAN 的融合研究
论文摘要
传统深度强化学习(DRL)在自动驾驶决策中取得了显著进展,但基于多层感知机(MLP)的策略模型难以解释其决策依据。本文提出了 Kolmogorov‑Arnold Network 基于可解释强化学习框架(KAN‑IDRL)。该框架采用结构透明的 Kolmogorov‑Arnold 网络(KAN)替换黑盒神经网络,结合 动态修剪 和 层次相关传播 (LRP‑KAN) 提供本地和全局解释。作者在高速公路巡航和上匝道合流两种场景开展实验,结果表明 KAN‑IDRL 在保证决策性能的同时显著提高了可解释性。此外,动态修剪使模型计算图更加紧凑,而 LRP‑KAN 则解决了传统 LRP‑MLP 无法处理“零输入”语义的缺陷。本文同时提出基于特征归因的反事实搜索方法,为理解模型决策提供进一步证据。
一、研究问题与方法概述
1.1 背景与挑战
深度强化学习的黑盒性:传统 DRL 模型依赖 MLP,难以解释决策逻辑,影响安全领域的应用。 解释方法局限:后验解释如 SHAP、LIME 增加系统复杂度且可能与模型行为不一致;固有可解释模型(有限状态机、决策树)又难以处理复杂任务。 多车交互场景复杂:高速巡航和合流任务涉及高维观测、混合离散/连续决策以及安全、效率、舒适度等多目标需求。
1.2 核心思路
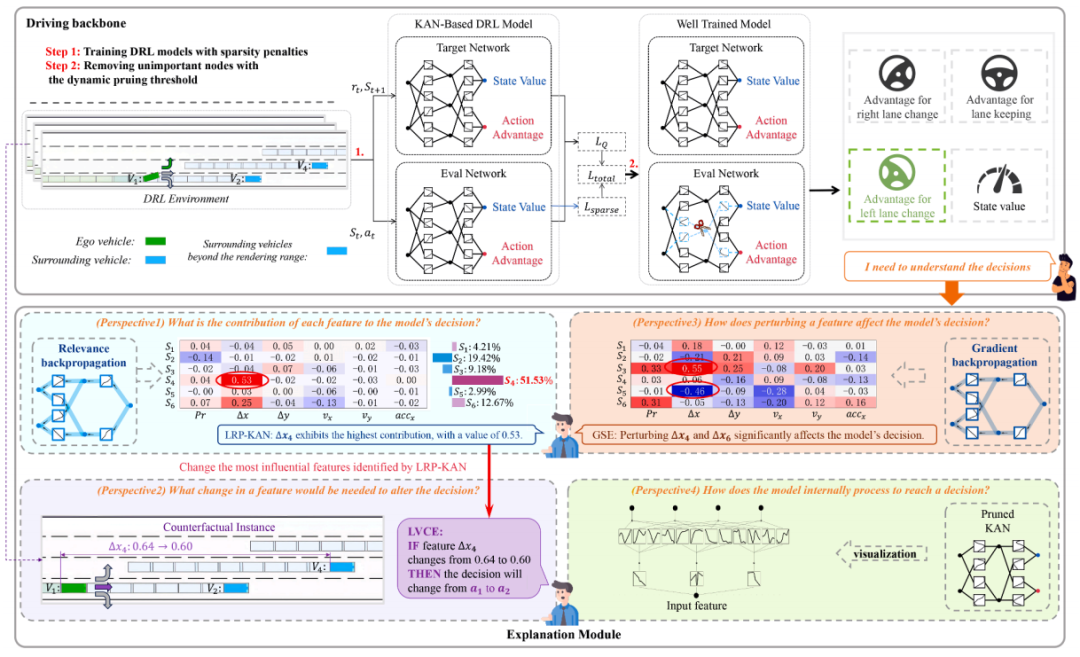
KAN‑IDRL 框架:引入 Kolmogorov‑Arnold 网络,将多变量函数表示为可组合的单变量 B‑样条函数,天然形成可视化计算图。为适应强化学习,使用 Dueling DQN 估计状态价值和动作优势,并在连续控制场景采用 PPO。 动态修剪:在训练过程中动态评估各神经元重要性,逐层调整修剪阈值,逐渐删去不重要的节点,使计算图保持紧凑。 解释模块:提出 LRP‑KAN,扩展层次相关传播到 KAN,使得即使输入为 0,也能正确传播相关性。同时结合梯度敏感性分析和基于 LRP 的反事实搜索,提供多视角解释。
下面通过示意图展示整体框架,左侧为决策主体,采用 Dueling DQN/ PPO 进行策略学习;右侧为解释模块,分别通过动态修剪、LRP‑KAN、梯度敏感性和反事实搜索生成解释。
二、模型设计与关键技术
2.1 状态与动作设计
高速巡航场景:考虑自车及五辆周围车辆,总状态 包含 36 维特征:
自车状态 ,分别代表左右偏距、纵向/横向速度和加速度; 第 辆周车状态 ,其中 为感知指示。 动作空间为三种离散动作:左变道、保持车道、右变道。 上匝道合流场景:仅考虑自车和前后两车,状态 为 9 维。动作为连续纵向加速度控制。
2.2 奖励函数与多目标兼顾
总奖励定义为速度奖励减去四种成本:
其中:
速度奖励:鼓励达到目标速度。 舒适成本:惩罚大加速度和频繁变道。 油耗成本:近似为加速度的二次函数。 安全成本:考虑碰撞、跟车距离等分段函数,过近将付出高成本。
这种分解使政策在效率、舒适与安全之间取得平衡。
2.3 KAN 结构及动态修剪
Kolmogorov‑Arnold 网络通过多个单变量 B‑样条函数 和加法节点组合近似多变量函数。为了保持计算图紧凑并增强可解释性,作者对 KAN 网络进行 L1 正则化 和 动态修剪:
在训练中添加稀疏正则项,并通过超参数 调节惩罚强度。
每隔 步计算各层神经元的重要性 ,根据其均值与 稀疏因子 计算层内阈值 :
当某个节点的 时,该节点及其连接被剪除,形成更精简的网络。
这种方法使最终模型仅保留对策略最重要的计算路径,避免不必要的复杂度。
2.4 LRP‑KAN 解释与敏感性分析
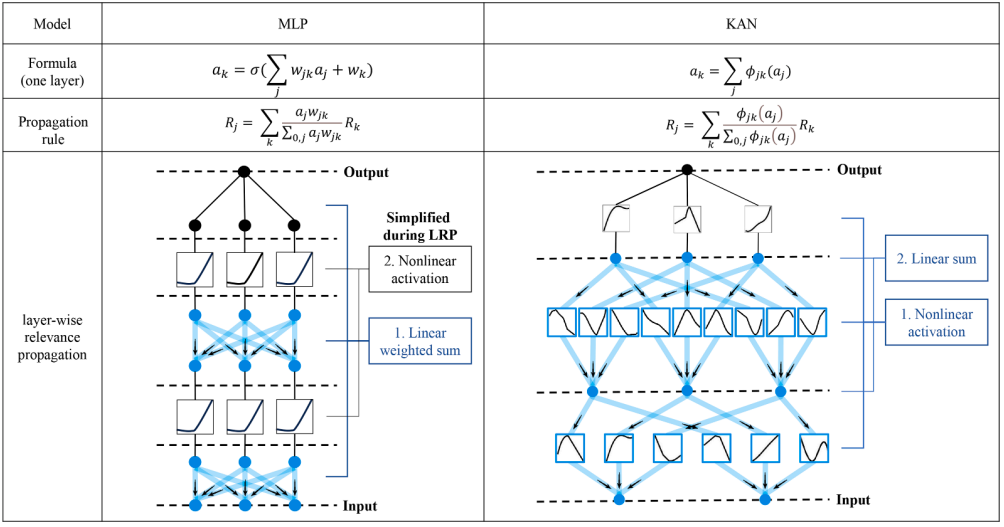
层次相关传播 (LRP‑KAN) :对于每个动作输出,将输出层的相关性沿网络反向传播至输入层。与传统 LRP‑MLP 不同,KAN 的加法节点先将输入通过非线性函数映射,再计算相关贡献,避免了零输入特征会产生零相关性的错误。 **梯度敏感性 (GSE)**:计算输入微小扰动对输出的影响,衡量特征敏感性。 全局归因统计:对多个场景的归因结果取平均,获得整体特征重要性。
LRP‑KAN 与 LRP‑MLP 传播规则对比如下图所示。
三、训练与实验设置
仿真环境:使用开放式车道系统模拟四车道高速公路和上匝道合流场景。密度分为低、中、高三种。 训练算法:离散决策采用 Dueling DQN + KAN;连续控制采用 PPO + KAN。基线算法包括传统 DQN、Dueling DQN、PPO、A2C 等。 评价指标:累计奖励、平均速度、成功率、舒适成本、油耗成本、安全成本等。 训练细节:每个场景训练 100 个回合,并在 100 个测试回合上评估;同时记录 GPU 资源使用情况。
四、实验结果与分析
4.1 性能比较
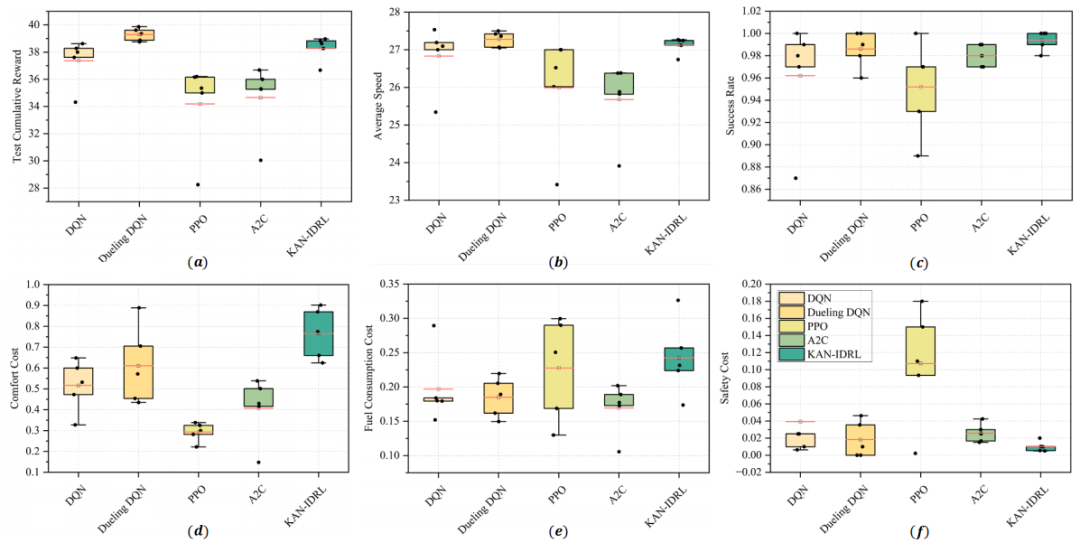
下图展示了低密度场景中各算法的综合性能。
关键发现:
成功率最高:KAN‑IDRL 成功率达 99.4%,明显高于 DQN(96.2%)、PPO(95.2%) 等基线。 累计奖励与速度可比:平均奖励与速度与最优基线 Dueling DQN 相当。 安全性更佳:舒适成本、油耗成本略高(因为更积极变道加速),但安全成本最低,表明其采取更稳健的安全策略。 资源消耗合理:推理速度与基线接近,GPU 显存略高,但不影响实时性。
中高密度场景见附录,KAN‑IDRL 在所有场景中均能维持最高或次高成功率。
4.2 消融实验
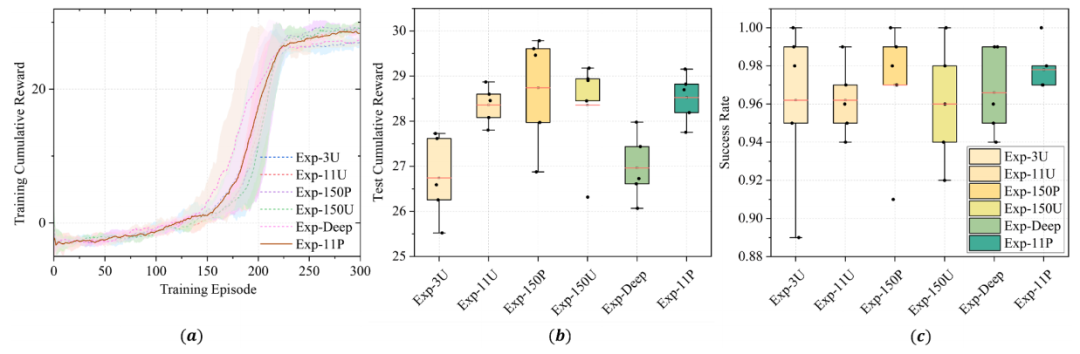
为探究网络深度、节点数以及动态修剪对性能的影响,作者设计了多个配置进行对比。下图为消融实验的学习曲线与评价结果。
结论如下:
节点过少或过深均影响性能:只有 3 个节点或 7 层深的 KAN 学习难度增加,成功率下降。 150 节点模型经修剪后最优:带修剪的 150 节点 KAN 取得最高平均奖励 29.11,证明适当冗余加上修剪能提升性能。 修剪不损失性能:对 11 节点模型进行修剪后,成功率最高且奖励略降,表明动态修剪以较小代价换取更安全策略。
4.3 模型紧凑性与计算图可视化
KAN 本身具有可视化的计算图,但如果不修剪仍包含大量节点,理解起来仍然困难。动态修剪后的计算图如 图5 所示,其中右侧显示了某一输入特征的传播路径。
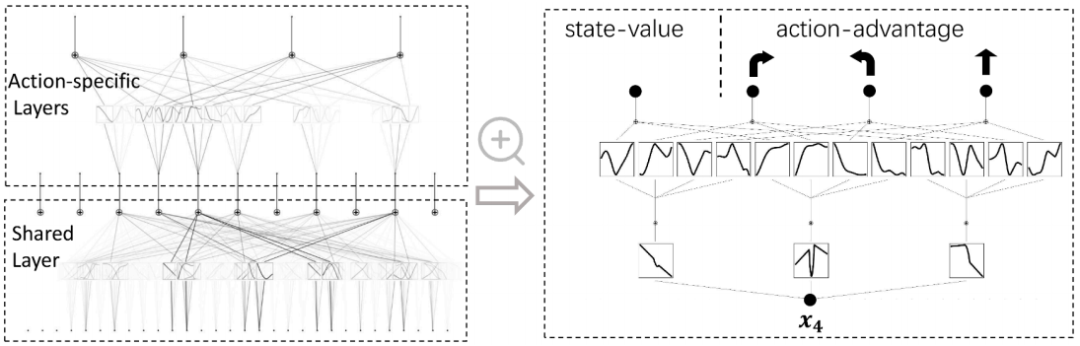
通过修剪,仅保留 6–7 个隐藏节点,远少于 MLP 的数百节点。计算图简洁后,可以对单个输入特征的影响路径进行清晰追踪,有助于专家分析。
五、可解释性分析
5.1 特征归因与敏感性
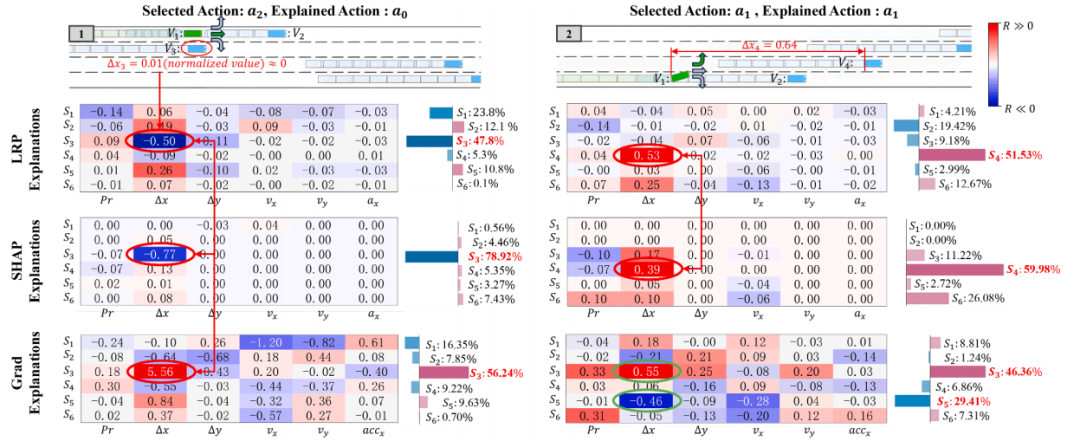
作者在随机选取的两个高速巡航场景中比较了 LRP‑KAN、SHAP 和 梯度敏感性 的可视化结果。下图展示了其中一个场景的归因热图及车辆重要性条形图。
解析:
绿色车辆为自车,红圈标出最重要的周车。LRP‑KAN 的热图和条形图表明,前右车辆的相对距离是影响右变道决策的主导因素。 SHAP 和梯度敏感性也能识别出关键特征,但归因更加分散。 LR P‑KAN 能够准确反映“距离为 0 表示碰撞危险”的语义,而传统 LRP‑MLP 会将零输入解释为无贡献。
作者还对合流场景进行了逐步归因,揭示了车辆距离和速度对加速度决策的影响(详见附录图 11)。
5.2 LRP‑KAN 与 LRP‑MLP 对比
在高风险场景,作者比较了 KAN 和 MLP 模型下不同 LRP 规则得到的解释,结果如 图9 所示。
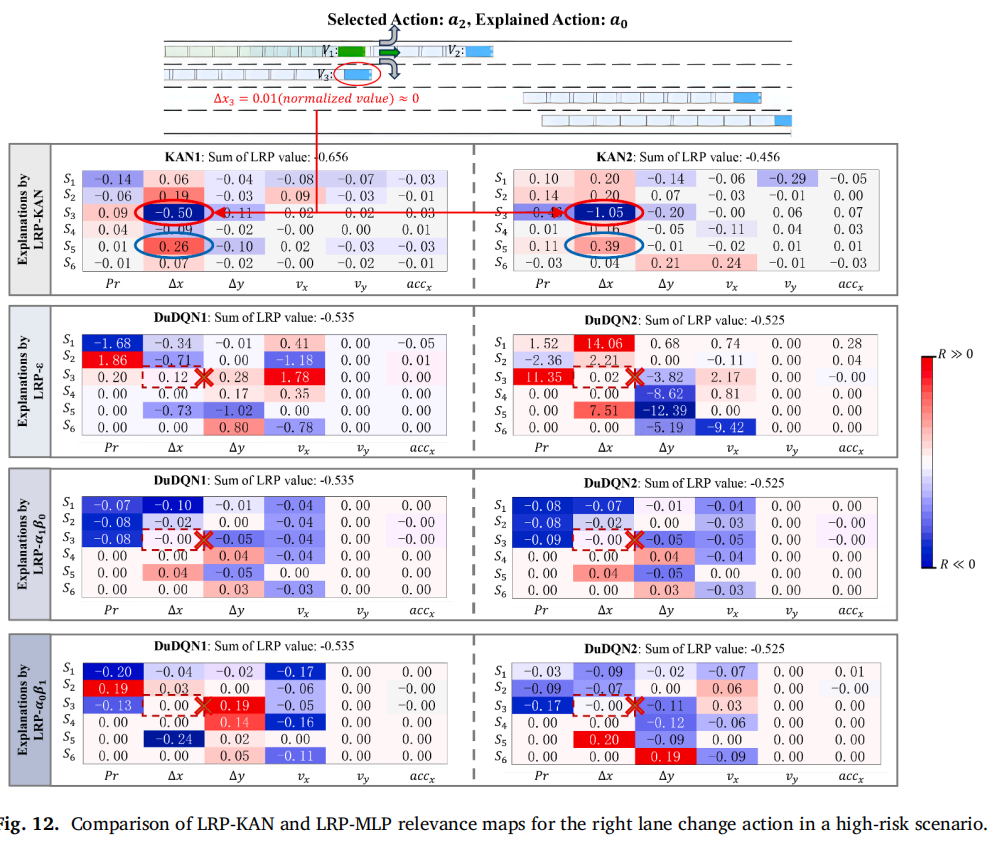
KAN 模型的两个实例给出的热图几乎一致,均正确识别出 Δx₃(前右车辆距离)为主要风险因素。 MLP 模型在四种 LRP 规则下,归因结果分散,且普遍忽视 Δx₃,当该特征值接近 0 时更会被错误判定为无贡献。 这证明 KAN 的结构优势使得 LRP‑KAN 提供更加稳定且符合语义的解释。
此外,作者在深层 KAN 上验证了归因稳定,发现无论浅层还是深层模型,LRP‑KAN 都能一致识别关键特征。
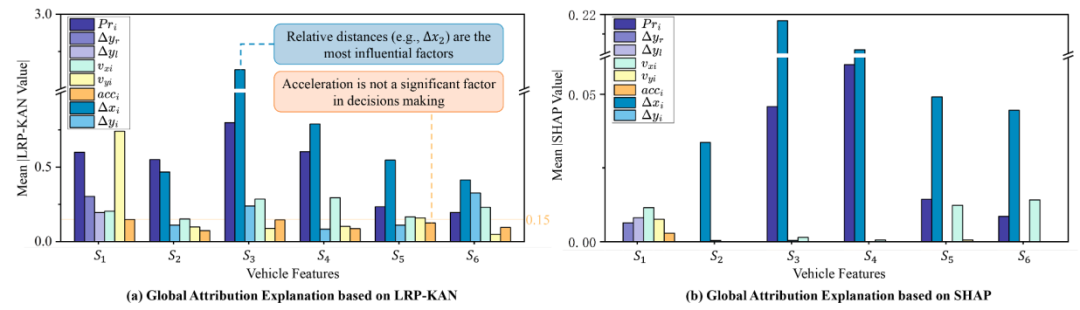
5.3 全局归因与敏感性分析
通过对多场景归因结果求平均,作者绘制了全局特征重要性图,发现自车速度、前车距离 和 左右偏移在长期表现中最为重要。敏感性分析则表明:纵向速度、横向偏移对输出最敏感,且敏感度随交通密度增加而增强。
六、基于归因的反事实解释
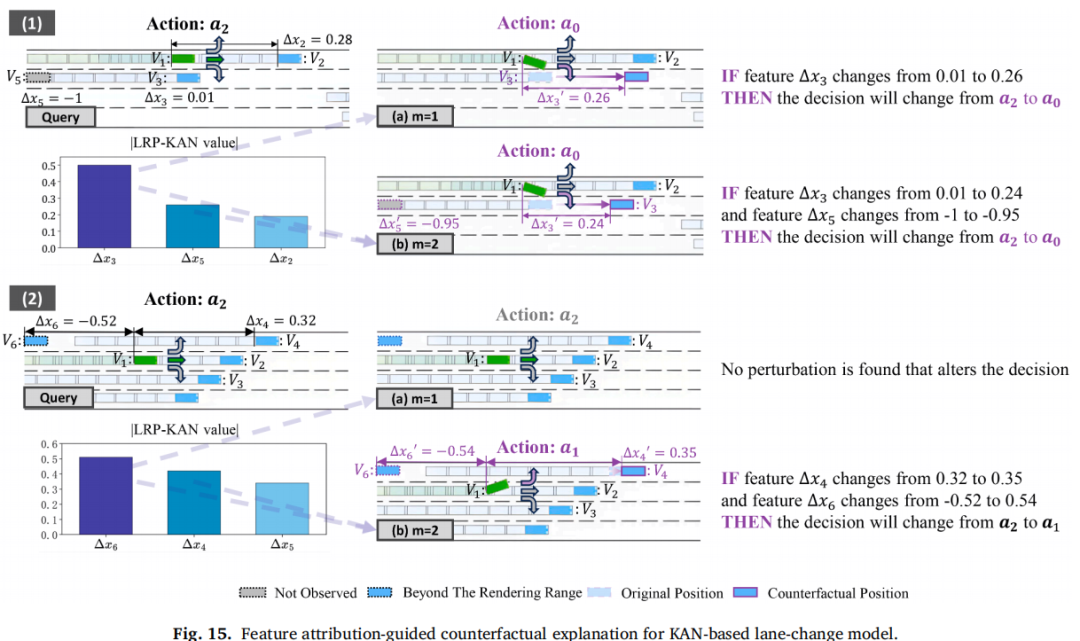
为了指导驾驶员或开发者了解如何调整环境以改变决策,作者提出了 归因引导的反事实搜索(LVCE)。其流程为:根据 LRP‑KAN 找出最关键的 个特征,逐步调整这些特征直到模型的决策发生变化,从而生成最小修改的反事实样例。
示例解析:
在场景 (1) 中,自车当前决策为右变道 ()。LRP‑KAN 指出 Δx₃(前右距离)最重要。将其从 0.01 增加到 0.26 即可促使模型选择保持车道()。 若只调整 Δx₃ 无法改变决策,则可再调整第二重要的 Δx₅,形成更复杂的反事实路径。 在场景 (2) 中,仅当同时调整 Δx₄ 和 Δx₆(前左和后左距离)时,模型才会从右变道转为左变道 ()。
这种方法不仅提供了“为什么”决策,还告诉我们“改变什么才能改变决策”,对安全验证和人机交互极具价值。
七、结论与创新点
7.1 研究结论
本文提出的 KAN‑IDRL 框架 在高速巡航与上匝道合流场景中,实现了与传统 DRL 方法相当的驾驶性能,同时显著提高模型可解释性。 通过 动态修剪 和 L1 正则化,KAN 网络在不降低性能的情况下显著减少了节点数。 LRP‑KAN 能够提供稳定、一致且语义一致的局部归因,解决了传统 LRP‑MLP 在零输入情况下解释失败的问题。 敏感性分析 和 反事实搜索 为模型解释提供了多角度视图,帮助理解决策过程并验证模型可靠性。
7.2 创新亮点
首个将 KAN 应用于自动驾驶 DRL:通过 Kolmogorov‑Arnold 表示定理构建具有可视化计算图的策略网络,实现从黑盒向白盒的转变。 动态修剪算法:结合稀疏正则和在线重要性评估,有效压缩模型结构并保持性能。 LRP‑KAN 解释方法:解决 LRP‑MLP 无法处理零输入的问题,使归因结果更符合自动驾驶语义。 跨多种解释技术的统一框架:融合归因、敏感性和反事实,为安全关键应用提供全面、实时的解释。 仿真验证的全面性:在离散和连续控制、不同交通密度场景下均验证了模型性能与解释质量。
7.3 局限与展望
作者指出,本研究仍处于仿真阶段,现实道路的复杂性和动态性需要进一步验证。未来工作将:
在真实车辆或更高保真度仿真环境测试 KAN‑IDRL。 优化 B‑样条函数参数化和网络结构,降低训练与推理的计算开销。 扩展到多车协作、城市交通等更复杂任务。
通过这些努力,Kolmogorov‑Arnold 网络有望在自动驾驶及其它安全关键领域推广,兼顾决策性能和可解释性。
文章须知
推文编辑:单子叶
责任编辑:张仁义
原文链接:https://doi.org/10.1016/j.trc.2025.105386