需求不确定性条件下的补货策略优化:多智能体深度强化学习库存优化解析
一、引言
多级库存优化(MEIO)涉及在供应链的不同层级协调库存水平以降低系统成本。文献中大量研究关注安装库位策略(installation‑stock policy),即每个节点根据自身库存、在制品与到达订单独立做出补货决策。在串联供应链的经典 啤酒游戏 中,零售商、仓库、批发商和制造商四个角色分别面对不同的需求和补货延迟,如何在仅能观测本地信息的情况下协同决策,是一项复杂的去中心化优化问题。
传统方法依赖基于克拉克—斯卡夫算法的基准库位政策(Base‑Stock,BS)或启发式近似,在对环境假设严格或需求分布已知的条件下才能得到解析最优解。而在现实场景中,需求与补货周期往往具有随机性,不同参与者之间信息共享受限;基准政策难以适用。因此,本文引入多智能体深度强化学习(MADRL)框架,通过域随机化技术提升策略的泛化能力,用以解决实际供应链的库存控制问题。
二、研究背景与问题提出
2.1 啤酒游戏的多级库存系统
啤酒游戏模拟了客户、零售商、仓库、批发商和制造商之间的串联供应链,如下图所示。各节点只能观察相邻上下游的到达订单与发运情况,无法共享全局状态。
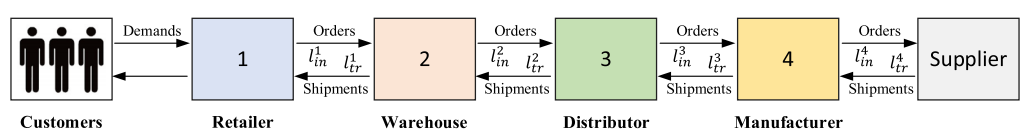
记第 个节点在时刻 的 库存水平 为 、在制品库存为 、到达订单为 、到达发运量为 ,其决策变量包括补货订单 和实际发运 。节点的发运量由本地在制品与下游需求共同决定:
其中 ,表示正负库存部分。发运具有固定的运输和生产提前期,因而在制品和库存在下一个时刻更新为:
系统在每个阶段产生持有成本和缺货成本,以库存水平的正负部分衡量。总成本为
其中 为单位库存持有成本, 为缺货惩罚。由于各节点仅能观测局部信息,这一决策过程构成一个去中心化部分可观测马尔可夫决策过程(Dec‑POMDP)。
2.2 难点与研究挑战
环境的部分可观测性:每个参与者只能看到本地库存、在制品和到达订单,无法实时获取其他层级的状态,导致最优决策难以推导。 行动空间巨大:补货量理论上可取任意非负整数,如果不对动作进行约束,传统强化学习算法难以收敛。 模拟与现实环境差异:强化学习通常在仿真环境中训练策略,真实供应链的需求分布、提前期等参数存在误差,直接部署学习到的策略会出现“仿真–现实差距”。
为解决上述问题,论文采用 集中训练/分布执行(CTDE) 框架的多智能体深度强化学习和 域随机化 技术,设计出能够适应多种环境的库存控制策略。
三、模型与方法
3.1 Dec‑POMDP建模
啤酒游戏的决策过程被建模为八元组 ,其中 表示参与者集合(零售商、仓库、批发商和制造商), 为系统状态集合, 为第 个参与者的补货决策空间, 为其观测空间, 为状态到观测的映射(观测函数), 为状态转移函数, 为公共收益(即负成本), 为折扣因子。由于状态难以完全观测,各节点只能根据 观测历史 选择动作 。全局目标是寻找联合策略 使长期期望收益最大。
3.2 多智能体深度强化学习(MAPPO)
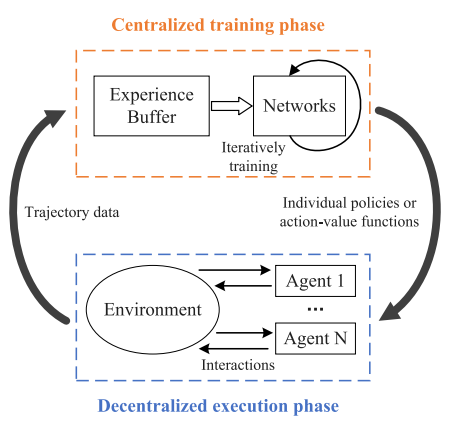
为在去中心化场景下训练多个智能体,作者采用了 集中训练、分布式执行 的训练框架,如下图所示。训练阶段收集所有智能体的轨迹数据共同更新策略;执行阶段每个智能体利用本地策略独立决策。
3.2.1 策略更新与优势估计
本文基于 PPO 提出了多智能体版本的 MAPPO。设当前策略为 ,待更新策略为 ,在优势估计 下,采用下述剪切的近端目标函数:
其中 为剪切阈值以限制策略变动范围。优势函数通过 广义优势估计(GAE) 实现,对时间差分误差进行加权累积,从而在偏差与方差之间取得折中。
3.2.2 神经网络架构与动作约简
为处理时间序列的部分可观测性,策略网络采用包含多层感知器(MLP)、门控循环单元(GRU)和线性层的结构,下图展示了 Actor 和 Critic 网络。输入为当前观测与隐藏状态,输出为动作概率分布或状态值函数。
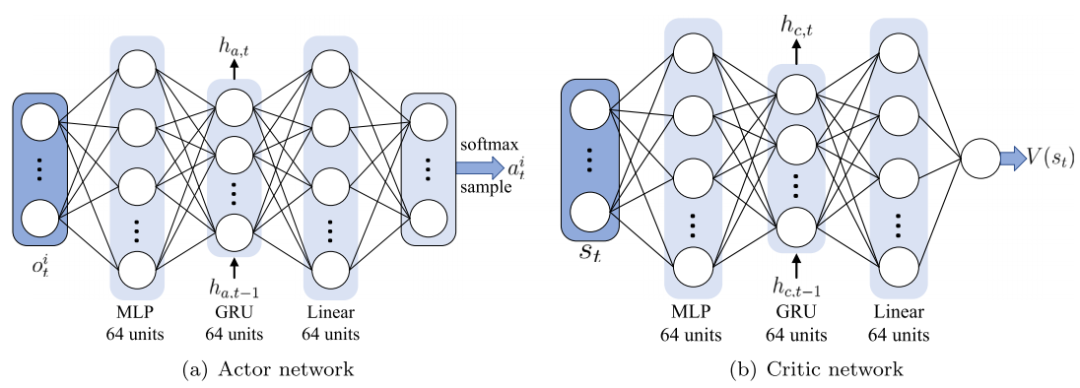
关键细节包括:
参数共享:所有智能体共享同一套网络权重,通过输入中加入代理索引来区分不同角色,使模型利用全局经验训练出个性化策略。 动作空间约简:在基准库位策略最优的案例中,采用“”规则,即补货量等于所收到的需求 加上策略输出的整数偏差 ,显著缩小动作空间。在最优策略未知时则直接优化补货数量。 训练细节:使用 百万步数据、折扣因子 、GRU 单元 64 个隐藏单元等超参数。
3.3 域随机化(DR-MADRL)
强化学习策略往往在训练环境下表现良好,但部署到真实系统时会因需求分布或提前期偏差而性能下降。为缩小这一差距,作者引入域随机化,在训练阶段随机化环境参数,迫使智能体在多种情形下学习稳健策略。
域随机化将环境看作一个包含不同 MDP 的潜在MDP集合。假设参数向量 描述需求均值、方差以及提前期等环境特征,对每个参数定义分布 ,通过采样组合得到特定的 MDP。则域随机化的目标是找到使期望价值函数最大的策略:
其中 为参数组合的联合分布。该方法的流程示意见下图。
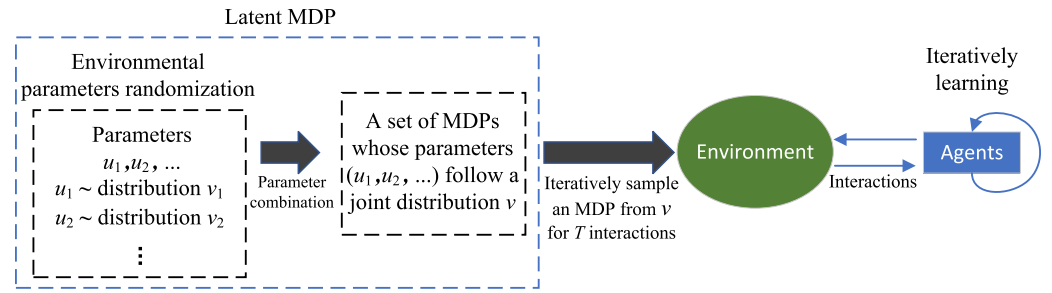
在训练中,为每条轨迹随机抽取环境参数(如需求均值在 、方差在 、提前期偏差在 的均匀分布),采样出的环境组合用于生成经验,再用 MAPPO 更新策略。域随机化促使策略在不同环境下表现一致,从而提高真实部署时的鲁棒性。
四、数值实验与结果分析
4.1 实验设计
为了验证方法有效性,作者设置四个典型需求场景:基本案例、正态需求 、均匀需求 和波动较大的 案例。对每个案例给出了基准库位水平(如 对应正态需求)和相应的动态需求分布;动作空间在不同案例中也随需求规模而调整。基线方法包括解析 BS 策略、单智能体深度 Q 网络(SRDQN)以及文献中的 MILP 与启发式算法。
4.2 训练过程与收敛性
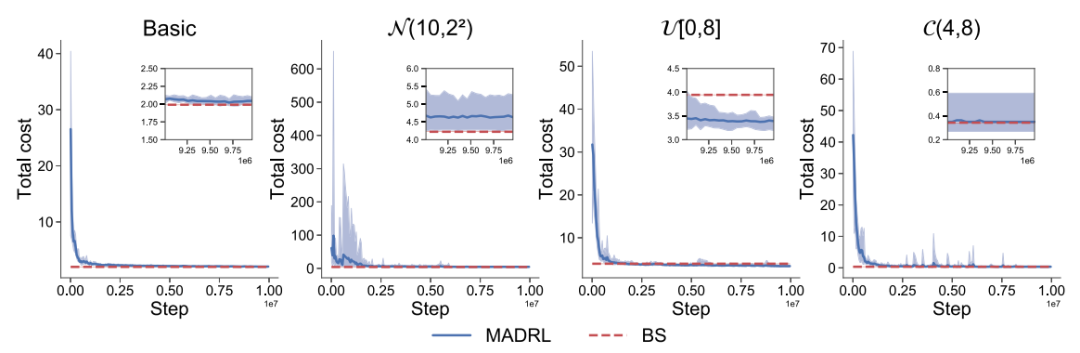
图 5 展示了 MADRL 在四个案例中的训练曲线:蓝色为 MADRL 策略,总成本迅速下降并稳定在较低水平;红色为 BS 策略,对应的总成本在一条直线附近。可以看到在需求分布已知且 BS 最优的情况下,MADRL 的性能快速逼近 BS 策略;在其他案例中,MADRL 也能显著优于基准。
4.3 策略表现与特性
4.3.1 基准案例与正态分布案例
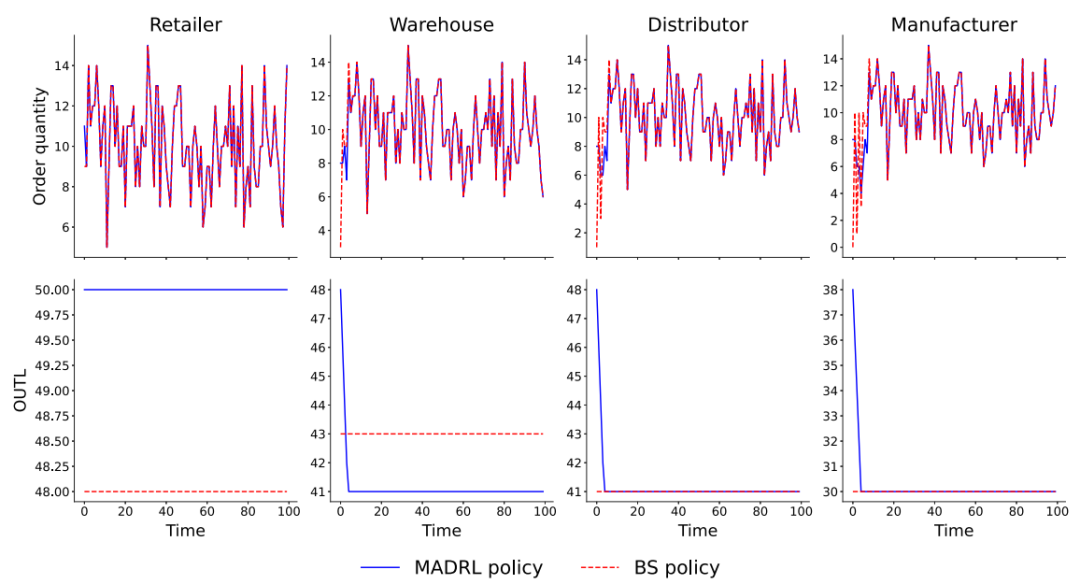
在基本案例和 案例中,最优政策已知且呈现基准库位结构。图 6 为正态需求下 MADRL 与 BS 策略的订货量和订单补充水平(OUTL)轨迹。可以看到,两种策略在订货量曲线高度一致,MADRL 中的 OUTL 迅速趋于固定值,与 BS 库位一致。这说明 MADRL 能够学习到与解析最优策略相同的结构。
4.3.2 均匀分布案例
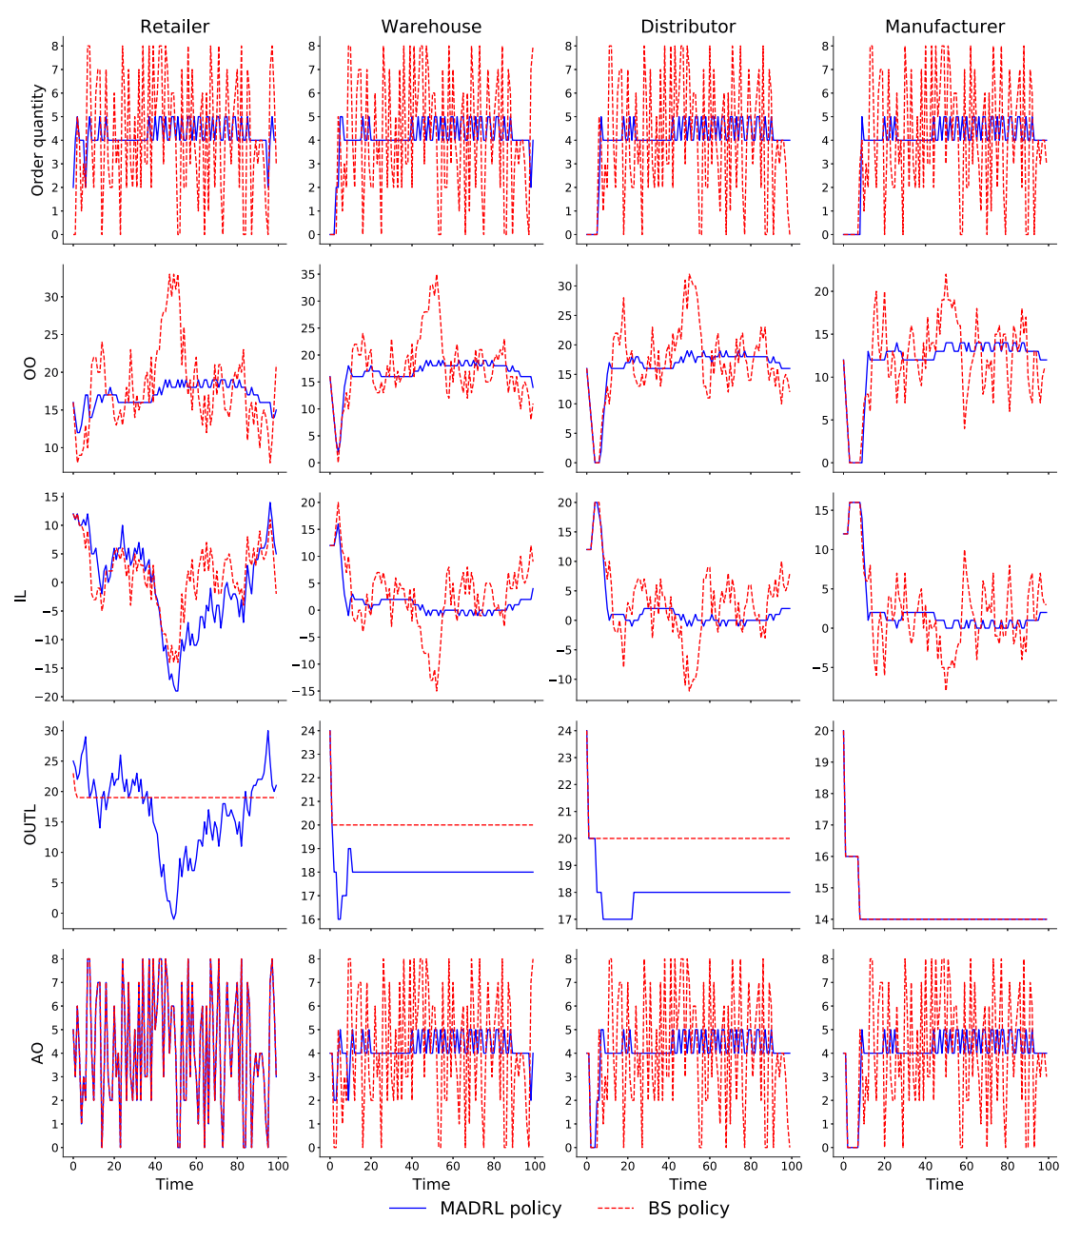
当需求服从 ,最优政策未知。图 7 显示了各节点的订货量、在制品库存、库存水平、OUTL 及到达订单轨迹。可以看出 BS 策略的订单更为剧烈且经常导致高缺货,而 MADRL 策略平滑了补货决策,使库存波动减小,总成本显著降低。
4.3.3 需求分布变化的鲁棒性
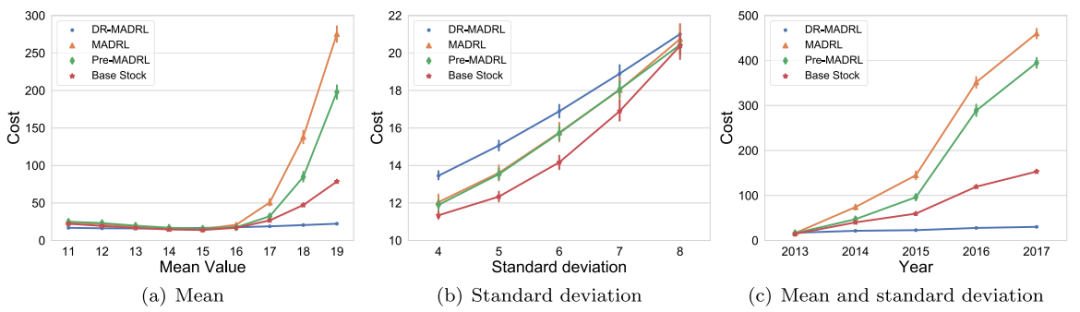
当真实需求的均值或标准差发生变化时,预训练的 MADRL 策略容易失效。图 8 展示了在均值、标准差以及两者共同变化情况下,DR‑MADRL、MADRL、预训练 MADRL 和 BS 四种策略的测试成本。可以看到,随着均值增大,MADRL 和预训练策略的成本迅速上升,而 DR‑MADRL 保持较低增长;在标准差增大时所有策略成本都上升,但 DR‑MADRL 始终优于其他方法。
4.3.4 提前期和需求同时变化
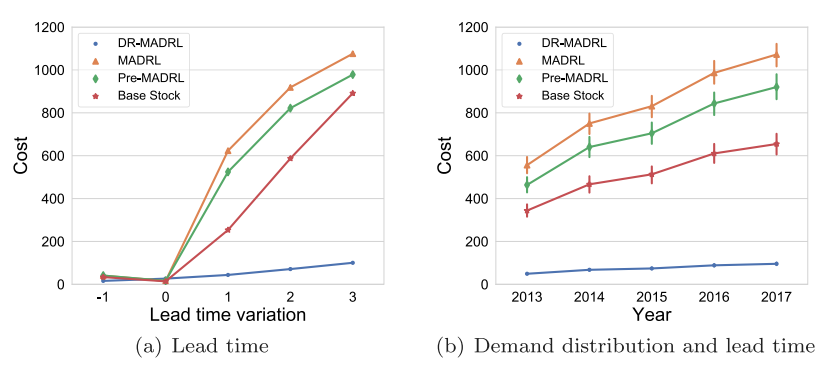
图 9 对提前期和需求分布同时出现差异的情况进行了测试。可以看到,BS、MADRL 和预训练策略在提前期增加时成本急剧上升,而 DR‑MADRL 策略成本增长缓慢,并在提前期和需求均偏离理想环境时显著优于其他方法。这表明域随机化能提高策略对参数不确定性的鲁棒性。
4.4 效果总结
实验结果表明:
近似最优性:当最优政策已知且具有基准结构时,MADRL 能快速收敛并逼近 BS 政策,总成本差距极小。 未知最优政策场景的优势:在最优政策未知的案例中,MADRL 明显优于基准库位、MILP 和传统启发式方法,总成本下降 13%–30%。 策略结构可解释:观察 MADRL 的订货和库存轨迹,可以发现其也呈现出“订货=需求+安全余量”的结构,为设计新的启发式政策提供了线索。 域随机化提高鲁棒性:在需求均值、方差或提前期发生变化时,DR‑MADRL 策略的总成本仅有小幅提高,显著优于未进行随机化训练的策略。
五、管理启示与讨论
根据实验与分析,作者总结出对供应链管理者的三点启示:
策略发现工具:MADRL 可作为发掘补货策略的有效工具。当解析最优政策已知时,MADRL 能逼近并揭示其结构;在未知情况下,则能够生成表现优于传统规则的策略。 动作空间设计的重要性:当最优策略为基准库位形式时,利用“(d+x)”规则缩小动作空间可以加快收敛;但在最优策略未知或偏离基准库位时,该规则可能限制策略改进,应直接优化补货量。 域随机化提升鲁棒性:在实际部署 MADRL 时,引入域随机化训练可明显增强策略对需求与提前期变化的适应性,避免仿真与现实环境不匹配导致的性能下降。
这些经验可指导供应链运营者在实施强化学习方法时如何选择建模假设、动作约束和训练流程,以取得最优的库存控制效果。
六、结论与未来工作
本文将啤酒游戏的多级库存优化问题建模为去中心化 POMDP,并在集中训练/分布执行框架下提出了适用于该问题的 MAPPO 算法,配合 GRU 处理部分可观测性与时间依赖。实验显示,MADRL 在最优政策可解析时能逼近基准策略,而在未知政策场景下明显优于传统启发式方法。通过分析 MADRL 的行为轨迹,可以挖掘出潜在的结构性策略,进一步推动补货政策设计。
为解决仿真与现实环境不一致的问题,作者提出了域随机化训练框架,显著增强了策略在需求分布和提前期变化下的稳定性。此外,该方法无需额外调参,易于在实际系统中应用。
研究仍存在局限:
本文只针对串联结构的供应链进行建模,未来可扩展至网状或环状供应链,需重新设计观测与动作空间。 随着参与者数量增加,去中心化 POMDP 的状态和动作空间呈指数增长,现有 CTDE‑MADRL 方法在大规模网络上计算代价高昂,有必要发展能够利用边缘计算的分布式学习算法。 进一步研究如何结合策略结构分析,开发具有解释性且计算高效的启发式或半解析策略,也是值得探索的方向。
总体而言,本文展示了多智能体深度强化学习与域随机化在复杂供应链库存控制中的巨大潜力,为实践中的库存决策和算法研发提供了重要参考。
文章须知
推文编辑:单子叶
责任编辑:张仁义
原文链接:https://doi.org/10.1016/j.tre.2025.104367