
学习驱动的多目标优化:船舶航线﹣航速的端到端智能决策框架
一 研究背景与问题提出
1.1 船舶运输能源挑战
能源消耗与排放大:海运承担全球90%以上的贸易运输,却消耗大量燃料并产生高排放。提高航线能效是实现绿色航运的重要途径。 慢航与准时矛盾:燃油消耗呈速度的三次方增长,这意味着减速可以显著节能。然而航运合同通常规定到港时间窗口,过度慢航导致迟到风险。 多目标优化困难:航路—航速联合优化涉及节能与准时两个目标以及天气、潮汐、航道等复杂约束。传统多目标进化算法(MOEA)在大规模时容易收敛于欠佳解或产生不可行航线。 学习网络局限:深度学习可提取正向演化规律,但直接生成航线及速度方案时常违反航行约束、出现不连贯的路径或非整数航速。
为克服以上问题,论文提出一套面向航线—航速联合优化的学习驱动进化框架:双通道学习网络捕获演化规律并辅助进化算法搜索;改进的MCL‑EA算法引入簇排序与时间窗优先策略;采用不确定性约束确保时间和安全。实验证明该框架平均可节省约9%的能耗。
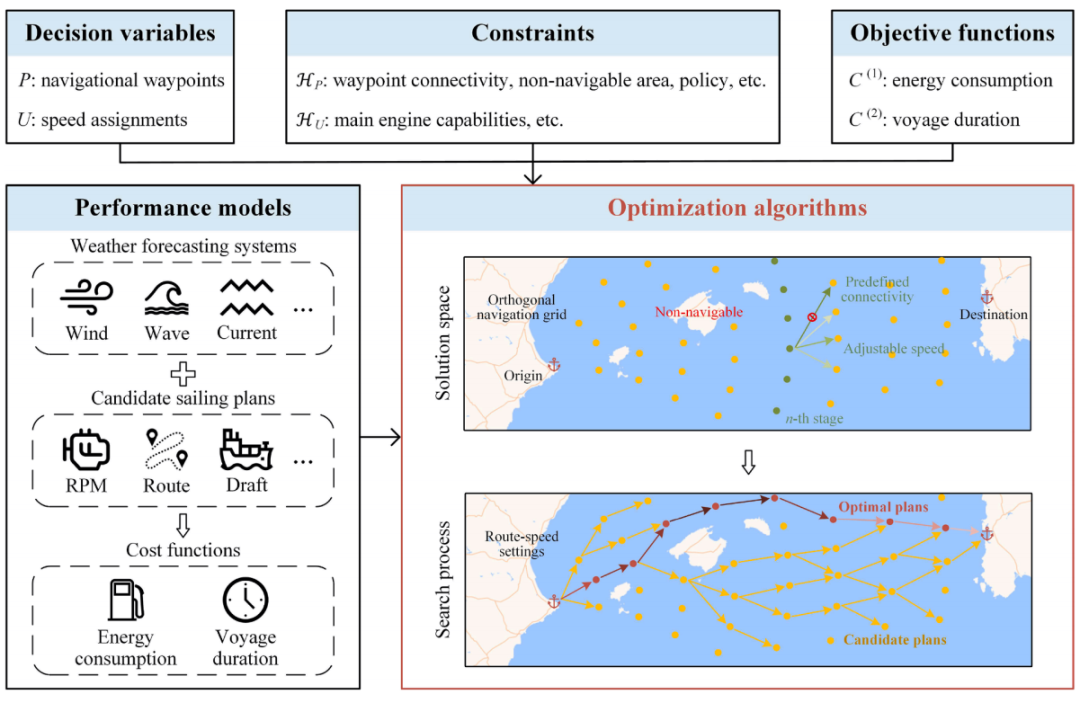
下图展示了航路–航速联合优化问题的要素,包括航点格网、可行航路、航速决策以及优化目标。
二 双通道学习网络设计
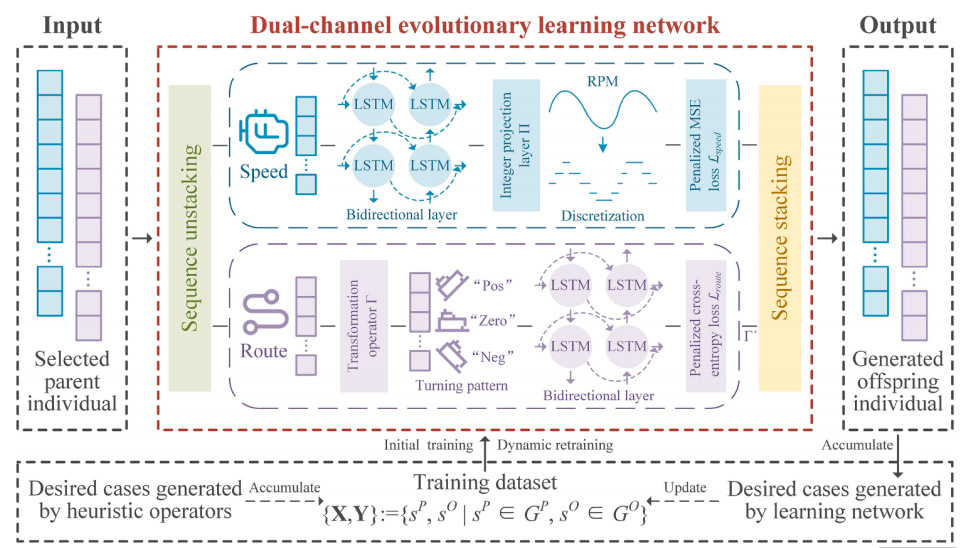
2.1 航路分支:分类化转化与惩罚交叉熵
航路分支将连续的航点序列映射为有限类别的转向模式,用标签“pos”(向高纬度)、“zero”(沿大圆航线)、“neg”(向低纬度)表示相对于当前大圆方向的转向。这一转化将高维回归问题降为三分类问题,显著减少搜索空间。
分类模型以惩罚交叉熵作为损失函数,兼顾样本均衡与预测准确度。设训练样本数为 ,第 条样本的真实标签为 ,模型输出为 ,则损失为:
其中 是惩罚系数, 与 分别代表第 样本的真实标签与预测概率。第二项鼓励模型输出中“pos”与“neg”样本数平衡,以防偏向某一类。
2.2 航速分支:软整数映射与邻接惩罚
主机转速(RPM)在有限离散集合 上取值。航速分支采用软离散投影将连续预测 投影到可执行命令 :
其中 控制离散映射的平滑程度, 为允许的离散RPM指令集合。 当 时, 收敛到最近的整数指令值。这使得网络在保持可微梯度传播的同时,确保航速命令为可执行的整数RPM。
为避免RPM序列出现剧烈变化,该分支在均方误差基础上增加邻接惩罚。设实测RPM为 ,预测RPM为 ,阈值 控制相邻差异,则损失为:
其中 为邻接惩罚系数。该设计保证航速序列光滑且符合主机响应特性。
2.3 网络结构与动态训练机制
双通道网络以 双向长短期记忆网络(BiLSTM) 为基础,分别处理航路标签序列和航速序列。每个输入 的前向与后向隐藏状态更新为:
最终隐藏状态为 。模型采用缩放点积注意力计算加权输出 ,从而聚焦于关键时刻:
为了适应航运时间窗约束,作者构建了Pareto‑advancing 网络和窗口进入网络两套子网,分别学习在时间窗内的正向演化方向和从不可行到可行的转移模式。训练数据通过进化算法不断刷新,形成动态自学习机制。
下图展示双通道学习网络的结构与动态训练流程。
三 MCL‑EA优化算法
3.1 算法流程与改进
论文提出的 MCL‑EA(Multi‑channel Learning Evolutionary Algorithm) 在传统 MOEA 基础上加入学习网络引导。主要步骤如下:
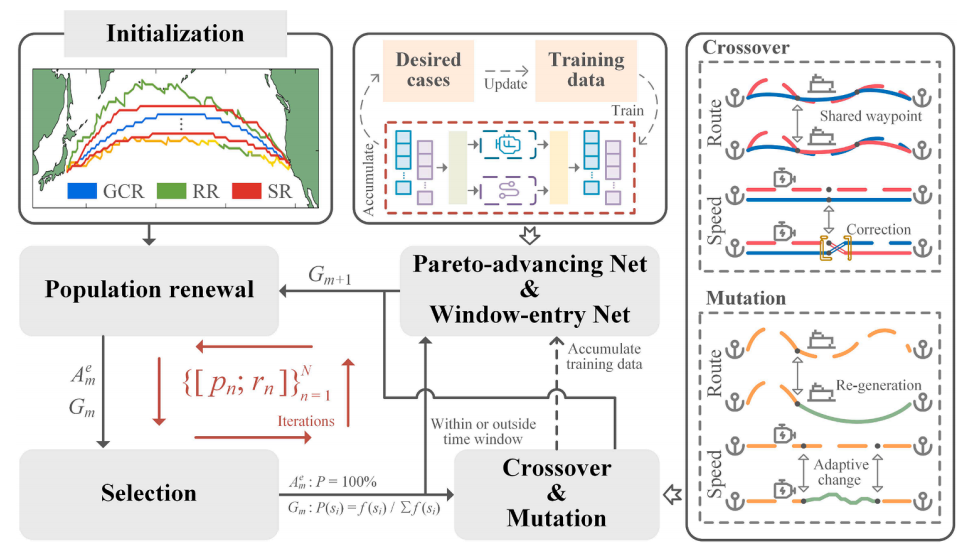
种群初始化:基于大圆航线与航点网格生成初始种群,避免大量无效解。 种群更新:使用进化操作(交叉、变异)产生子代;同时由学习网络生成候选解,并将二者合并形成新种群。 簇排序与选择:采用自适应 K‑均值聚类对非支配解进行簇排序,优先保留满足到港时间窗的解,使得进化聚焦于有限的优质区域。 遗传操作改进:路线上采用单点交叉保证父代共享航点,速度上采用区间交叉与适应性变异,若到港时间超出窗口则通过增减航速修正。
下图是 MCL‑EA 的算法流程图,显示了初始种群、更新、选择与交叉变异步骤。
3.2 演化知识的提取与利用
借助双通道学习网络,MCL‑EA在每代迭代中采集父代与子代之间的正向演化样本和有效转移样本。这些样本用于训练 Pareto‑advancing 网络识别能量与时间的双赢变化趋势,窗口进入网络则学习如何从不可行方案调整到可行。由于训练集动态更新,网络可持续优化并指导后续迭代。
四 性能模型与约束处理
4.1 能耗与航行时间预测
算法在评估每个候选航行方案时需要估计能耗和行程时间。为此,作者构建性能模型:基于 BiLSTM 和缩放点积注意力的序列模型,对航段的实际天气与航速序列进行预测。模型输入包括风速、波高、海流、船速等特征,输出为该航段的能耗和时间。
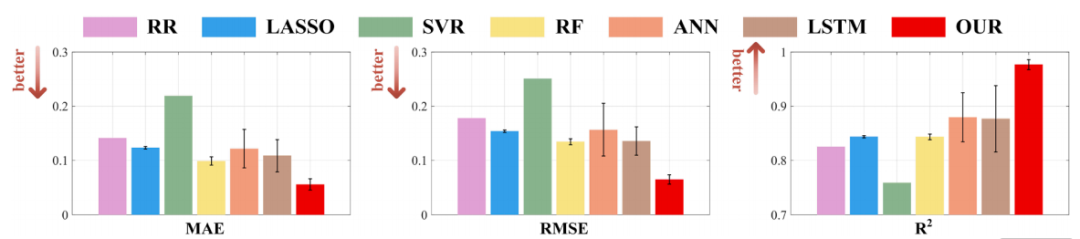
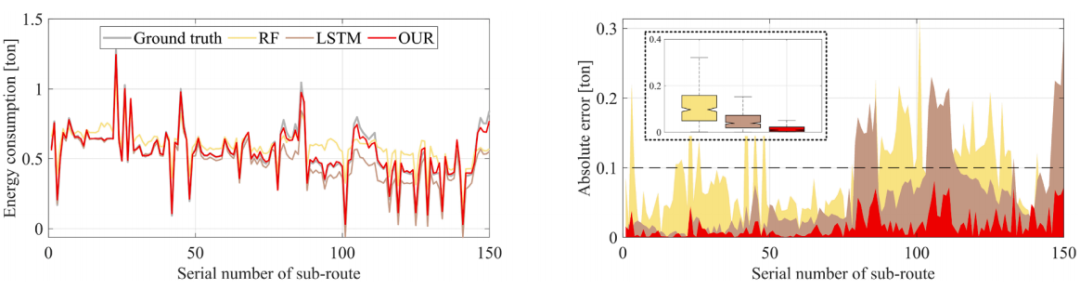
通过训练与基线模型对比,论文证明该模型在平均绝对误差(MAE)、均方根误差(RMSE)和决定系数 上均优于传统回归和深度学习方法(如随机森林、ANN、LSTM),具体结果见图4。图5进一步展示了预测能耗与绝对误差在不同子航段上的分布(取自Fig.6)。
4.2 不确定性与安全约束
航行时间存在气象不确定性。为保证准时到达,论文采用基于马氏距离的时间不确定性指标:
其中 是预测的航段时间向量, 和 分别为平均向量和协方差矩阵。若 超过阈值,则说明方案的时间估计偏离预期较大,应重新调整航速或路径。
另外,算法对每条候选航线进行可航行安全性检查,确保所有航段位于可通行海域并避免恶劣天气。违反者将在进化过程中淘汰或修正。
五 实验设计与结果分析
5.1 数据集与参数设定
研究以跨太平洋航线为例,将大洋航道按0.75°网格划分,共约100个航段。天气数据来自24小时×20成员的集合预报,船舶性能模型通过真实船舶运行数据训练。实验比较了原有方案与各算法输出的能耗与航行时间。
5.2 能耗与航行时间优化效果
示例仿真显示,MCL‑EA生成的优化方案相较原始计划减少燃料消耗 **6%**,同时缩短航行时间 5 小时,仍保持在合同到港窗内。图6展示了原航线和优化航线的对比,蓝色箭头为减速路段,红色箭头为加速路段。
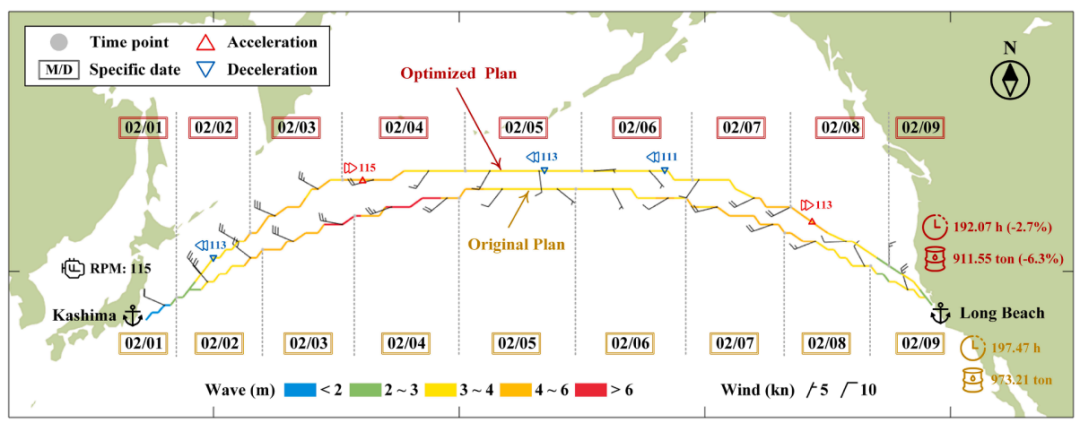
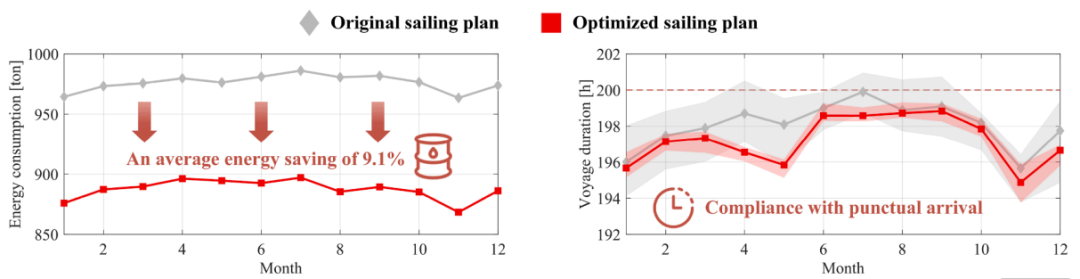
图7给出12个月各月份的能耗与航行时间对比,平均能耗节约约 **9.1%**。
5.3 与其他进化算法的比较
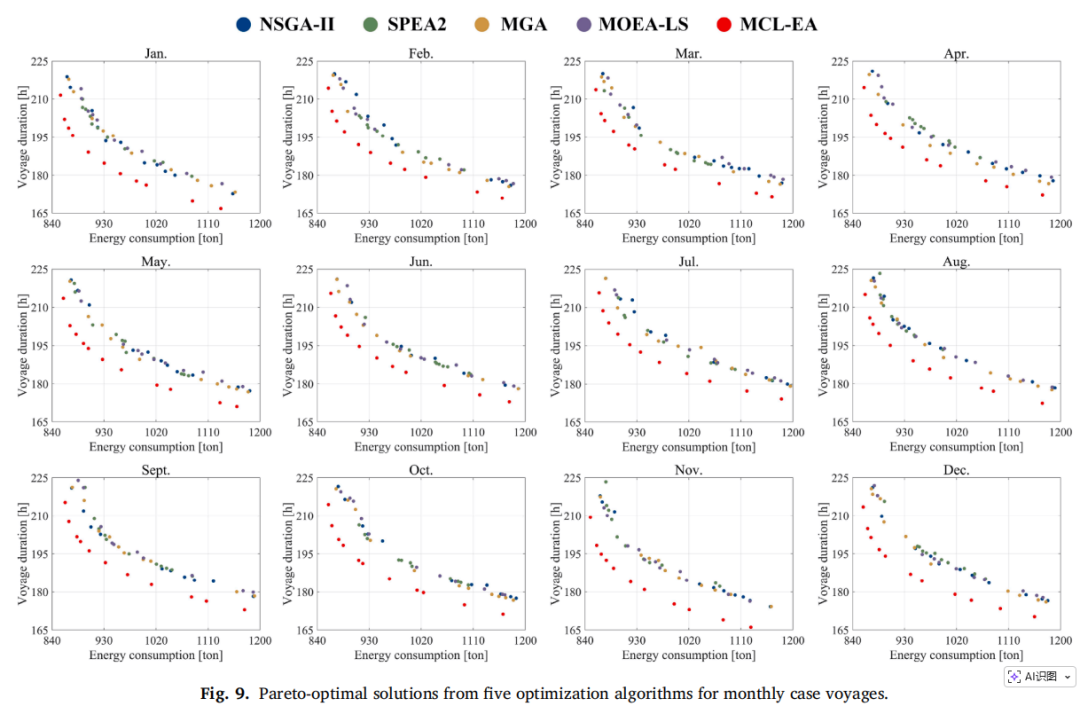
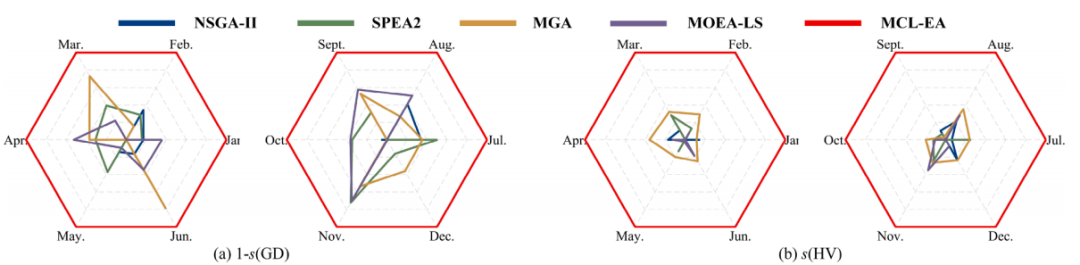
论文与四种先进 MOEA(NSGA‑II、SPEA2、MGA、MOEA‑LS)进行对比。图8展示了某月各算法的帕累托前沿,可见 MCL‑EA 在能耗和航行时间上均占优势。图9为收敛性和多样性指标(GD和HV)雷达图,MCL‑EA在两个指标上均显著领先。
5.4 算法可行性与训练表现
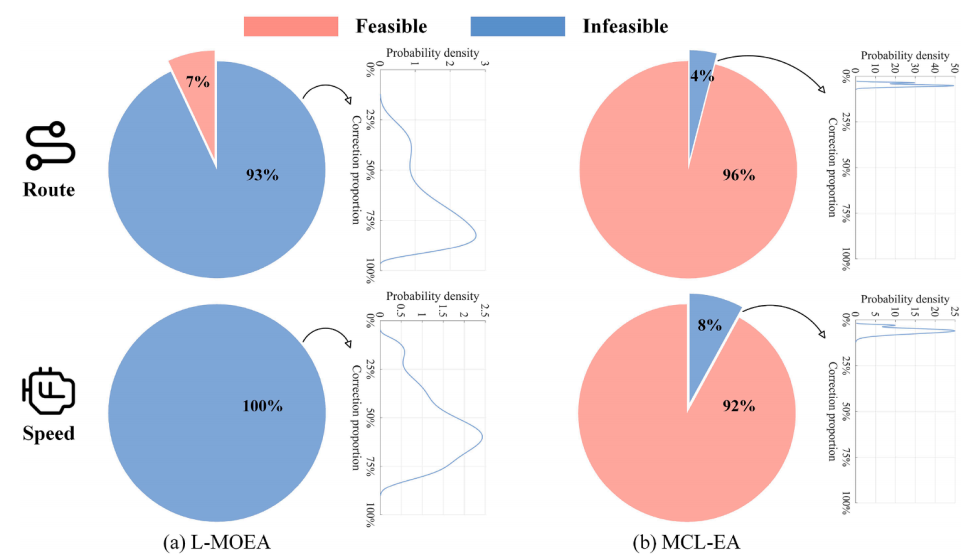
为了评估学习网络的有效性,作者与未经约束的 L‑MOEA 进行对比。结果表明,L‑MOEA 生成的方案中不可行比例高达 70%,需要大量后处理修正;而 MCL‑EA 由于采用航路分类和软离散投影,使 95% 以上的方案直接符合航行约束。图10展示了可行与不可行解的比例及决策变量分布。
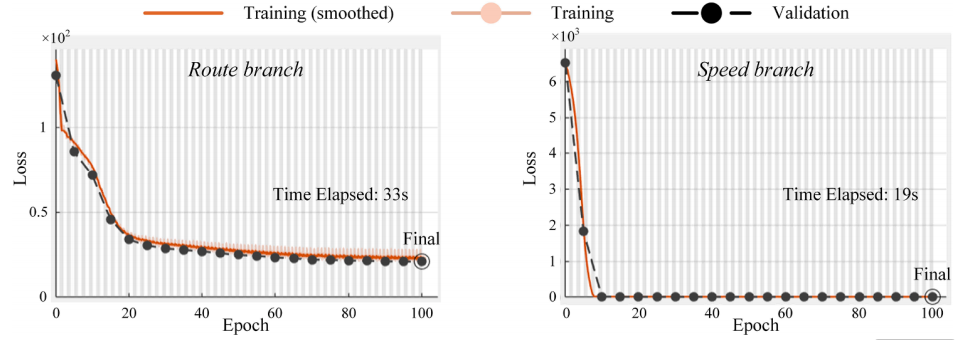
此外,图11显示双通道学习网络的训练损失随迭代逐渐下降,速度分支和航路分支均迅速收敛。
5.5 运行效率与演化成功率
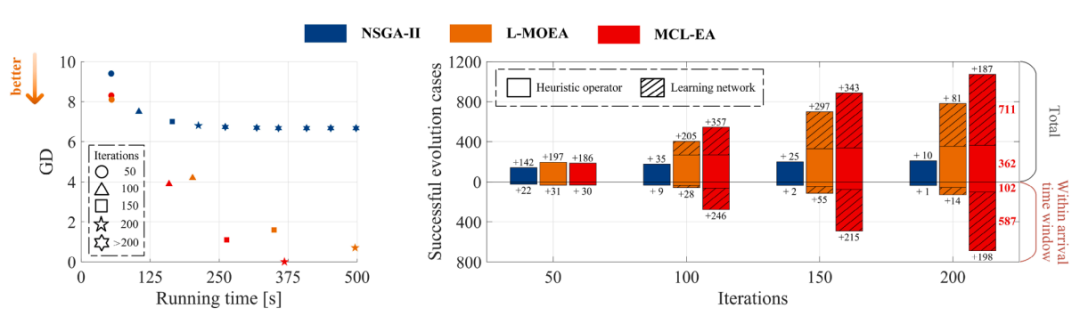
图12给出了不同算法在迭代中每代所需时间与目标值变化的关系。尽管引入学习网络,MCL‑EA 由于减少了无效搜索,总迭代时间仅为传统 MOEA 的 60%,且演化成功率更高。对于约5000海里的航线,MCL‑EA 在6分钟内即可生成优化方案,而 L‑MOEA 需要近10分钟。
六 困难与解决策略
搜索空间庞大且约束复杂:跨洋航线含上百个航段,需满足航道连通性、避开非航区、满足到港时间和天气安全。MCL‑EA 通过航路分类和簇排序压缩搜索空间,并在优化过程中实时修正不可行个体,使搜索更加高效。 基于学习的解可能不可行:单纯使用神经网络预测航点和航速往往产生不连贯路径或超出主机能力的速度。本文采用航路分类和软离散投影确保网络输出满足航路和动力约束,并引入惩罚项平衡标签和抑制剧烈速度变化。 天气不确定性难以控制:预测误差会导致无法准时到港。作者通过马氏距离指标评估时间不确定性,若超出阈值则调整航速或路线。 多目标权衡与决策偏好:不同航运公司可能对能耗与准时重视程度不同。簇排序机制允许指定时间窗优先级,Pareto‑advancing 网络学习符合合同要求的正向演化方向。
七 结论与管理启示
论文提出的学习驱动的MCL‑EA框架在船舶航线—航速联合优化中实现了理论与实践突破。主要结论如下:
显著节能与准时:在真实跨洋航线案例中,优化方案平均减少9%能耗并提早5小时到港,实现了节能与准时的双赢。 双通道网络保障可行性:通过分类航路与离散航速,结合惩罚损失,绝大多数生成方案无需后处理即可执行。 Pareto 前沿优化优越:与多种先进 MOEA 比较,MCL‑EA 在帕累托前沿、收敛性(GD)和多样性(HV)上均表现最佳。 高效求解:MCL‑EA在维持解质量的同时减少迭代时间,表明引入演化知识与自学习机制有助于加速搜索。
管理启示:
系统化优化航运计划:航运企业应采用联合优化框架全面考虑航线与航速,避免单一慢航策略导致迟到或能耗反弹。 引入学习与约束融合:在复杂约束条件下,结合深度学习和约束控制可有效提升决策可行性与效率。 关注不确定性与实时调整:利用不确定性指标及早调整计划,避免极端天气或预测误差造成的延误。 多目标权衡协商:在商业合同制定和运营中,可借鉴簇排序思想设置合理的能耗与准时偏好,指导航运决策。
通过以上解读,相信读者能对航路—航速联合优化的理论模型、算法设计和实践应用有深刻理解,为绿色航运和智能调度提供新的视角与方法。
文章须知
推文编辑:单子叶
责任编辑:弓仪长
原文链接:https://doi.org/10.1016/j.tre.2025.104489


