面向电商物流的大规模VRP求解:基于数据驱动聚类与剪枝局部搜索的优化方案
原文链接见文末
一、研究背景与问题提出
1.1 复杂的“时窗车辆路径问题”
在现代物流系统中,时窗车辆路径问题(Vehicle Routing Problem with Time Windows, 简称VRPTW)是最具挑战性的经典问题之一。它要求在给定的客户集合中,为每个客户分配合适的车辆和访问顺序,使得每个客户的需求在规定的时间窗内得到服务,同时最小化总体运输成本或行驶距离。
随着即时配送、电商物流、干线运输等行业的迅速发展,实际应用中的VRPTW实例规模已经达到上万级客户,远超传统算法的求解能力。尽管已有启发式与元启发式算法(如遗传算法、禁忌搜索、蚁群算法等),但这些方法在大规模高维场景下往往计算时间长、易陷入局部最优、缺乏稳定性。
为应对这一挑战,本文作者提出了一个结构化的框架——DRI(Decomposition–Routing–Improvement)算法。它将庞大的VRPTW实例分解为若干易处理的子问题,再通过独立求解与整体改进,最终得到近似最优的全局解。
1.2 研究目标与创新思路
论文的核心目标是: 在不牺牲求解精度的前提下,显著提升大规模VRPTW的求解速度与可扩展性。
DRI框架的提出背后有三点关键创新:
数据驱动的分解策略:基于客户之间的时空特征和需求相似性进行自动聚类; 多阶段求解结构:将“分解—局部求解—改进”统一到一个系统性流程中; 剪枝式局部搜索机制:利用模糊隶属度函数控制邻域规模,从而平衡精度与效率。
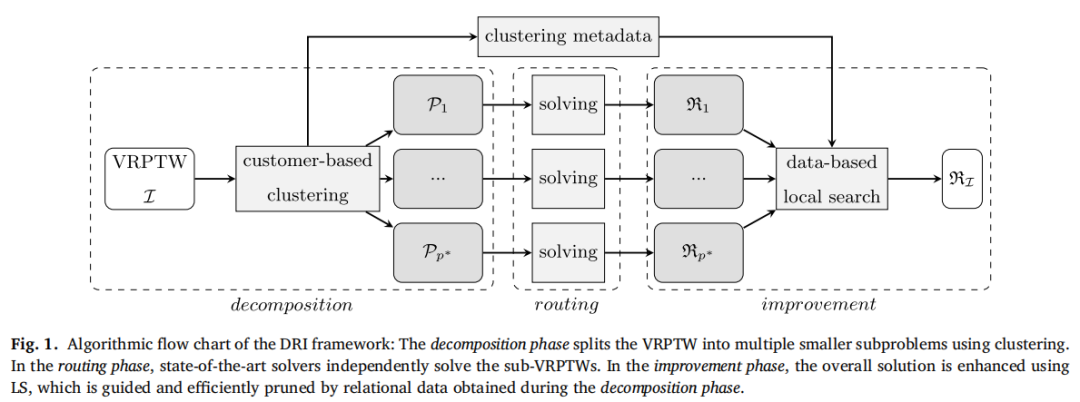
DRI框架分为三阶段结构:分解、路由和改进,下图展示了该框架的整体思路:
二、DRI算法框架的总体设计
DRI框架的思路非常“工程化”:通过先把问题拆小,再逐步拼回去,最终在全局层面实现优化。
2.1 分解阶段:从特征到聚类
这一阶段的目标是将客户按照地理位置、服务时间窗和需求强度等特征分成若干簇(cluster),每个簇作为一个独立的子VRPTW问题进行求解。
作者为每对客户 构建了一个包含多维信息的特征向量,包括:
空间坐标 与极角 ; 时间特征(服务时间窗 、最大到达灵活性 ); 需求信息(相对于车辆容量 的比例)。
最大到达灵活性定义如下:
其中 为服务时间, 为车辆从客户 到 的行驶时间。
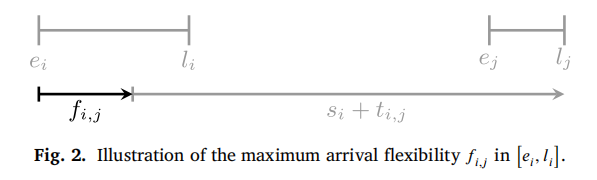
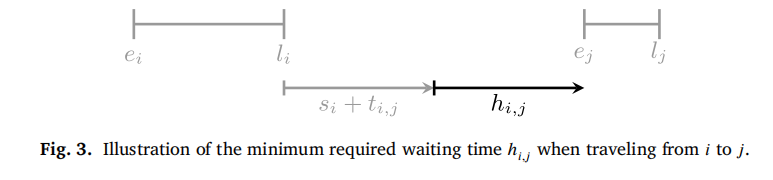
此外,为反映客户间的等待关系,还引入了最小等待时间:
结合空间距离、时间窗与需求,作者提出了 STD距离度量:
这种距离不仅考虑地理距离,也考虑了时间与需求的差异,使得聚类结果更符合实际配送逻辑。
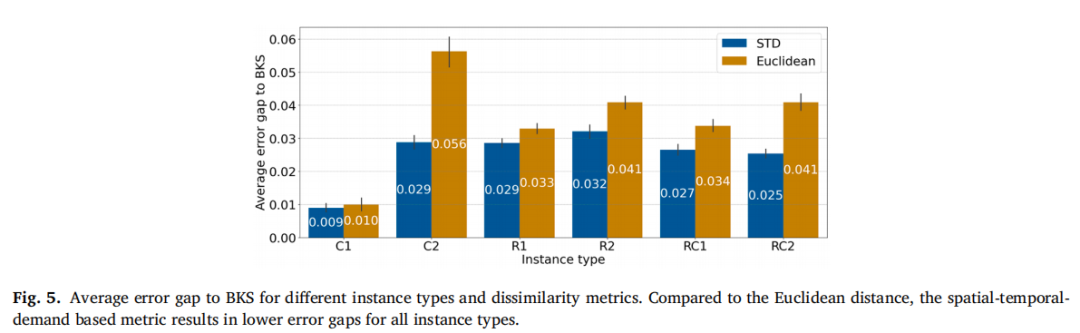
实验表明,STD距离相比欧几里得距离在聚类后的平均误差上降低了约30%。 为了自动确定最佳聚类数,作者采用轮廓系数(Silhouette Coefficient)作为评估指标,使分解阶段实现自适应。
2.2 路由阶段:局部最优求解
完成分簇后,DRI框架将每个簇单独视为一个小型VRPTW实例。 作者使用已有的高效启发式算法(如PyVRP)在每个簇中独立求解,得到一组局部最优解。
初始解通过贪婪插入策略快速生成,随后进行局部优化。 这种“分而治之”的设计,使得原本无法在合理时间内求解的大规模实例,能被并行分解为多个独立的、计算可承受的小问题。
2.3 改进阶段:剪枝与全局优化
DRI的第三阶段是关键所在。 在获得各簇的初步解后,算法进入改进阶段(Improvement Phase),旨在融合局部解并进行全局优化。
这一阶段引入了两个关键机制:
邻域搜索(Neighborhood Search):在不同路线之间尝试“移除-插入”操作,寻找更优组合; 剪枝机制(Pruning Strategy):通过模糊隶属度函数控制搜索范围。
具体而言,作者定义了客户对 的隶属度 ,用于评估它们属于同一簇的可能性。 只有当 时(为剪枝阈值),该边才会参与邻域搜索。
在实验中,当 取值在 0.2–0.35 之间时,算法能取得最优的效率与精度平衡。 此外,算法还对邻域大小 进行了限制,仅保留前 条最有希望改进解的候选边。
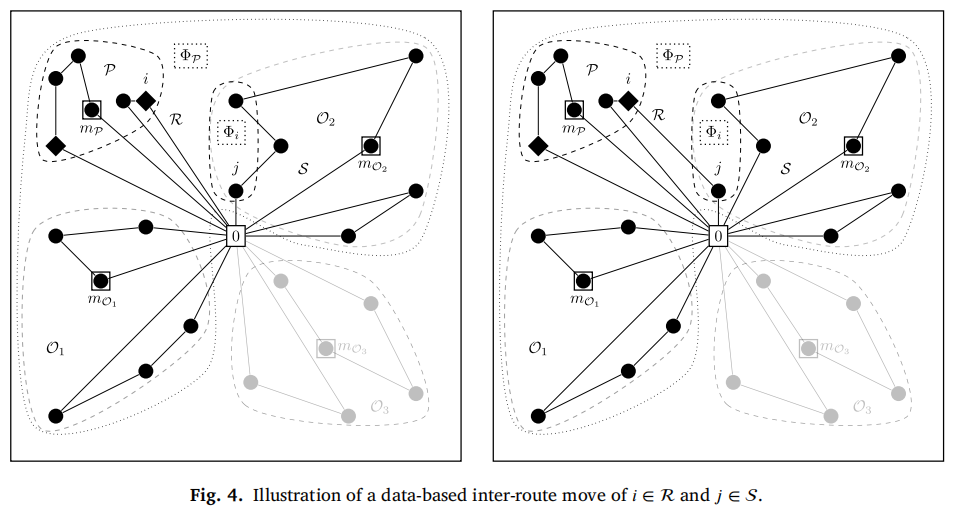
通过这一机制,DRI的搜索空间被有效压缩,使得算法能够在百万级边空间中快速找到高质量解。
三、数据与特征工程
在DRI中,特征设计是算法性能的基础。
空间与时间特征共同刻画了客户之间的“相似度”,而需求特征则保证了每个簇在容量约束下的可行性。 在此基础上,STD距离度量提供了统一的衡量标准,能够兼顾时空和容量信息。
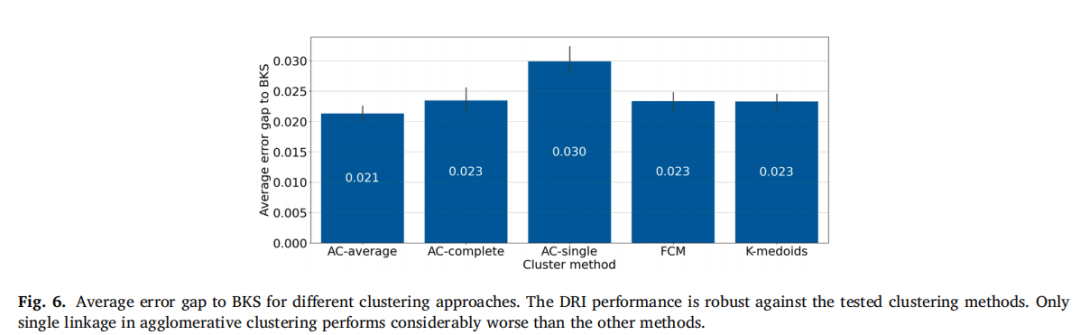
聚类算法方面,作者比较了k-medoids、模糊C均值(FCM)以及层次聚类(Hierarchical Clustering, HC)。 实验结果表明:
k-medoids与FCM性能最稳定; 层次聚类在平均连接(Average Linkage)和完全连接(Complete Linkage)模式下表现尚可; 单链法(Single Linkage)效果最差,容易产生长链簇。
四、改进阶段的关键机制解析
4.1 邻域结构与搜索策略
在全局优化中,邻域操作定义了算法能“跳出局部最优”的能力。 DRI框架的邻域结构包括:
移除(Remove):从原路线中移除某个客户; 插入(Insert):将移除的客户插入到另一条路线中; 交换(Swap):在两条路线间互换客户。
为了防止搜索空间爆炸,作者提出了基于模糊隶属度的剪枝机制。 隶属度低的客户对被提前剔除,大幅减少了不必要的计算。
4.2 复杂度与并行加速
由于每个簇的规模较小,分解后的路由阶段可以完全并行化运行。 改进阶段在多核架构下进一步优化剪枝与邻域评估,使DRI在万级客户规模的实例中依然能在合理时间内收敛。
五、实验设计与结果分析
5.1 数据与设置
作者在Gehring & Homberger VRPTW标准数据集上进行了系统实验。 该数据集包含六类实例(C1/C2、R1/R2、RC1/RC2),分别代表不同的客户分布密度与时间窗紧张程度。 实验平台为intel 8280L CPU、64GB内存的服务器,算法实现基于Python与PyVRP框架。
5.2 距离度量与聚类效果
图5展示了STD距离与欧几里得距离的对比结果,可以看到,STD距离在所有实例中均能取得更低的平均误差。
不同聚类算法的结果如图6所示,FCM与k-medoids表现最优,而单链层次聚类表现最差。
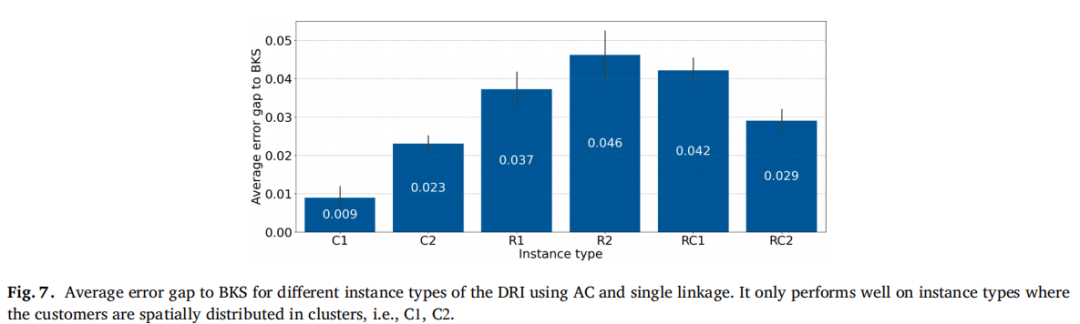
进一步比较层次聚类中的不同合并准则(图7),可见平均连接与完全连接效果明显优于单链法。
5.3 剪枝阈值与邻域大小分析
为了测试剪枝机制的影响,作者对不同阈值与邻域大小进行了敏感性实验。
图8对比了三种剪枝策略(简单剪枝SC、部分剪枝PI、完全剪枝CFRS),结果显示,部分剪枝在误差与计算时间之间取得最佳平衡。
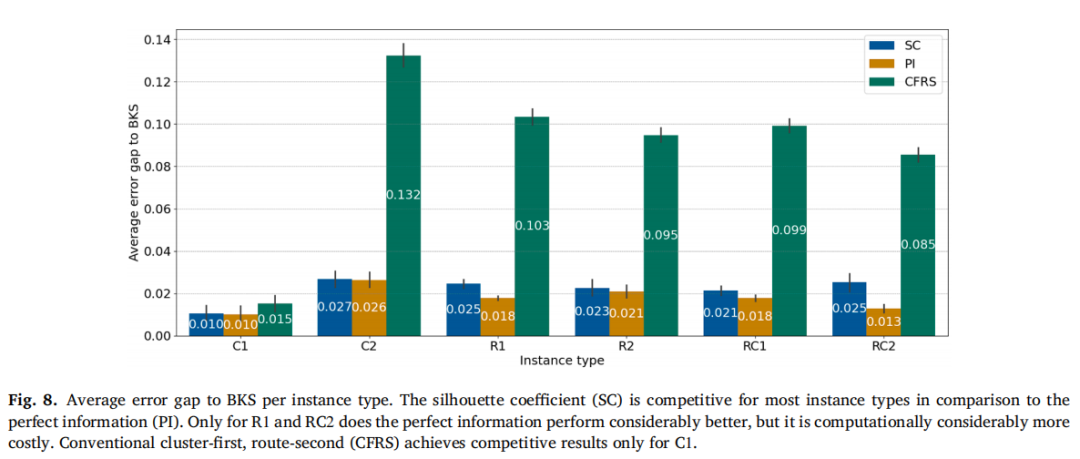
图9展示了隶属度阈值 与邻域大小 对性能的影响。阈值过大将导致局部搜索受限,而过小则增加计算负担。
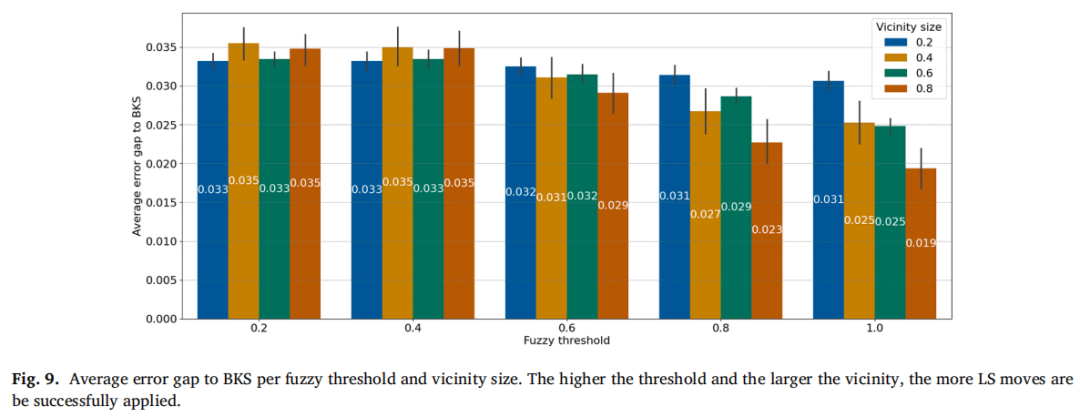
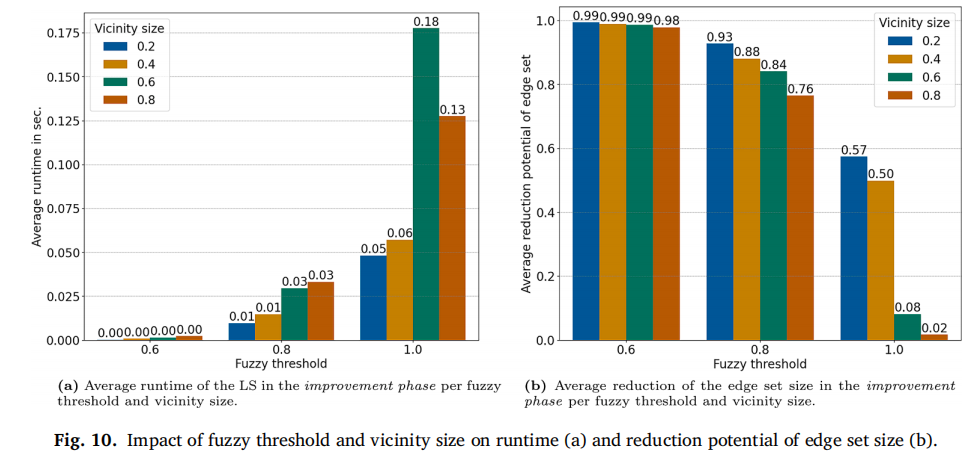
图10进一步分析了运行时间与剪枝比例的关系。可以看到,合适的剪枝设置能在保证解质量的同时显著降低时间成本。
5.4 收敛性分析
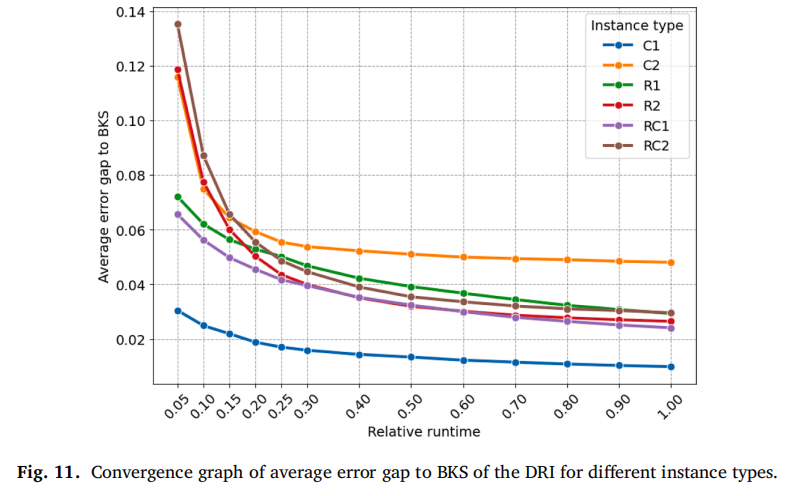
DRI框架的收敛性能如图11所示,随着迭代次数增加,平均误差快速下降并最终趋于稳定。 相比传统方法,DRI能更快地达到高质量解。
六、主要结论与启示
通过系统实验与分析,作者得出了以下结论:
分解-路由-改进结构有效解决了大规模VRPTW的可扩展性问题; STD距离度量 融合时空与需求特征,显著提高了聚类的合理性与求解精度; 剪枝阈值控制与邻域限制 提供了灵活的搜索空间管理机制; DRI框架在万级客户规模的测试中实现了优于现有算法的运行效率与解质量; 在实际物流调度系统中,该框架可为区域划分、车辆分配与动态路径规划提供决策参考。
七、研究思考与展望
DRI框架的最大价值在于其结构化思维:通过数据驱动的特征设计与算法分解,将复杂的优化问题转化为可并行求解的模块化任务。这种设计理念对许多大规模组合优化问题都具有启发意义。
当然,作者也指出,当前DRI框架主要适用于静态VRPTW,未来可进一步扩展至动态VRP(DVRP) 场景,结合强化学习和在线调度机制,使模型能实时响应突发事件(如交通变化或新增订单)。
此外,剪枝策略虽然有效,但阈值 的选取仍依赖实验经验,未来可探索自适应学习的参数控制方法。
原文链接:https://doi.org/10.1016/j.tre.2025.104409
以下是我们的微信交流群二维码,欢迎大家进群(如果二维码失效,请翻阅扫描最新文章的二维码):