预测集装箱出场口:结合机器学习与成本分析的港口堆场优化
一、研究背景与问题提出
原文链接见文末(评论区有勘误)
随着全球贸易量增长,许多大型港口的堆场密度和船舶周转效率面临巨大压力。进口集装箱卸船后通常暂存于堆场,随后由道路或铁路离场。然而,集装箱将从哪个出场口离港并不提前确定,特别是在占比超过70%的 托运人自提运输(Merchant haulage) 模式下。这一延迟决策导致集装箱在堆场的随机堆放与频繁跨场调运,增加了“错过班列”(rail misses)和无效搬运的风险。
为解决这一痛点,论文提出:根据集装箱的初始信息预测其未来的出场口,并以此优化堆场存放位置,从而降低内转成本和错班风险。具体目标包括:
利用结构化与非结构化数据构建多类别分类模型。 通过特征工程与解释性算法理解关键因素。 构建成本模型评估预测错误带来的经济影响。
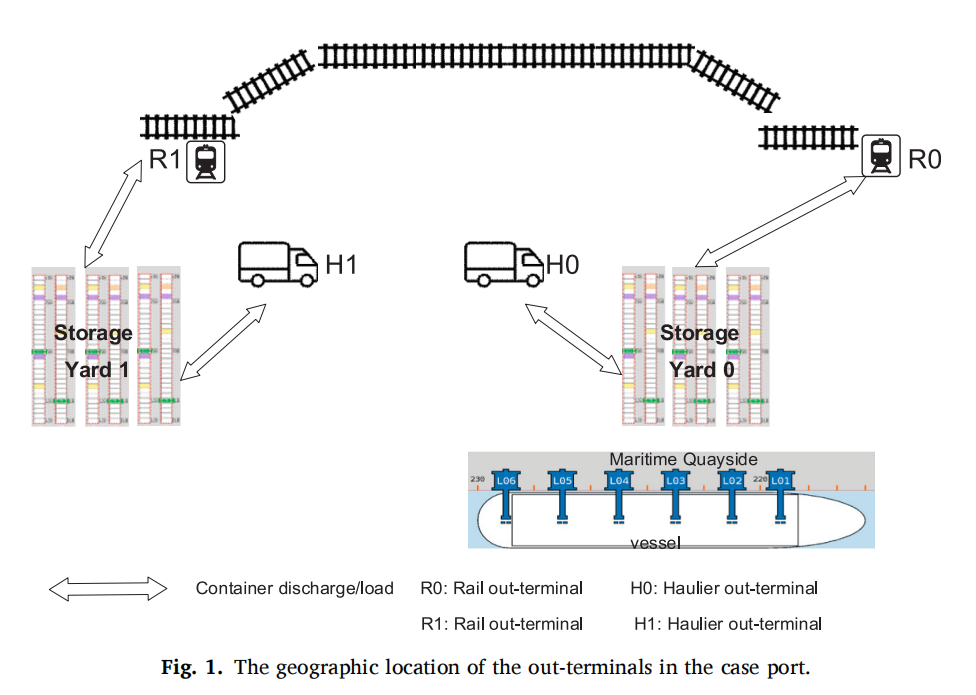
下图展示了案例港口的出场口与堆场分布:两个堆场与两个公路出场口(H0、H1)及两个铁路出场口(R0、R1)分别相邻。
二、数据与特征工程
2.1 数据来源与分布
研究使用某西欧港口2020年记录的 668,080 个进口集装箱数据。原数据包含约 70% 的公路箱和 30% 的铁路箱;进一步按出场口分类,铁路 R1 箱(132,857 个)远多于 R0 箱(34,272 个),存在明显类别不平衡。为保证模型有效性,作者进行了数据清洗和异常值剔除,最终得到 627,886 条记录。
2.2 特征选择
表2(论文)列出了 21 个初始特征,包括 箱体尺寸、船舶航次、原始港口、重量、箱主信息、冷冻标记等。作者采用过滤法、Boruta 算法以及业务知识逐步筛选出高相关特征,如箱高、箱长、船舶所属公司、服务代码、始发港、总重等。
2.3 非结构化内容处理:SITC 分类
集装箱内容(general_cargo_content)含有 98,271 种文本描述。由于人工标注耗时且主观性强,论文采用 GloVe 词向量 + 余弦相似度 进行无监督文本分类,将每种描述映射到联合国商品分类体系(SITC)第五级 2970 个代码之一。具体做法是:将每条内容和每个 SITC 标题转化为词向量矩阵,计算其余弦相似度;与某 SITC 标题相似度最高者即为其类别。实验表明该方法与人工标注的吻合率达 80%。最终生成新的低维特征“SITC”,替代原有文本内容。
三、模型构建与评价
3.1 模型选择与数据划分
研究将出场口预测问题视为三分类任务:公路出场口 H(合并 H0 和 H1)、铁路 R0、铁路 R1。基于数据是表格结构,作者选择 随机森林 和 XGBoost 两种树模型。数据按 75/25 分割为训练集与测试集,考虑类别不平衡设置类别权重为“balanced”。
3.2 性能对比与 SITC 的作用
作者分别在包含 SITC 和不包含 SITC 的特征集上训练模型,结果见表5。引入 SITC 后,随机森林和 XGBoost 的整体准确率均约为 80%,平均 ROC AUC 达 86%。以 XGBoost 为例,含 SITC 时 R1 类的 F1 得分为 0.60,高于不含 SITC 的 0.50。由此验证了利用非结构化数据提升预测性能的价值。
四、模型解释:SHAP 分析
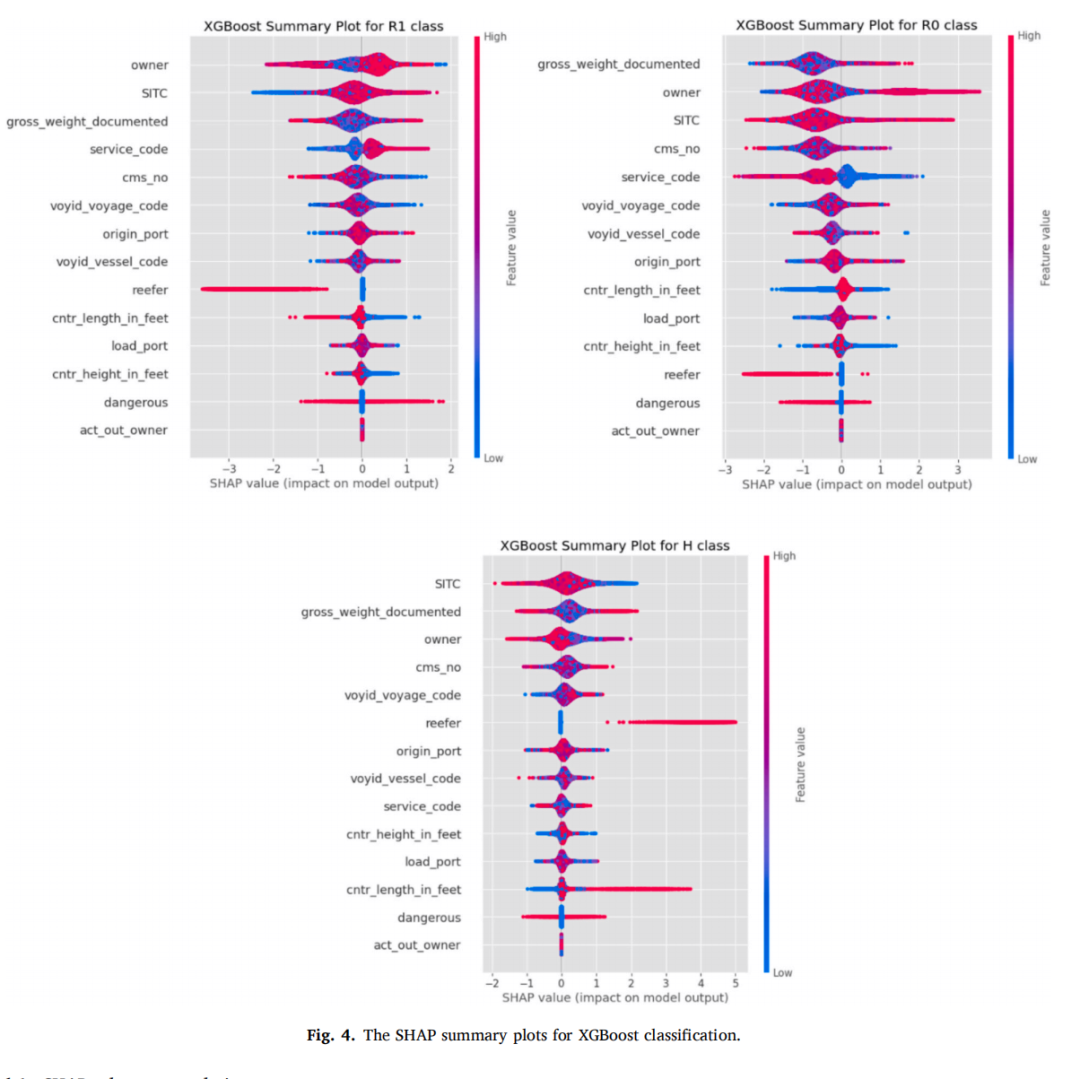
为了提高模型可解释性,研究使用 SHAP (SHapley Additive exPlanations) 计算各特征的贡献。图4给出了 XGBoost 模型对三类预测的 SHAP 总结图。
主要发现包括:
特征重要性排名:对 H、R0、R1 三类预测而言,前三大特征均是 SITC、箱主、总重。SITC 将高维内容转化为易解释的类别;某些箱主偏好使用铁路或公路运输;重箱因铁路限载被倾向安排公路出场。
特征影响方向:重量越大预测为公路 H 的概率越高。再例如,冷冻箱(reefer=1)对铁路 R0/R1 的 SHAP 值偏向负方向,表示其更可能走公路。低箱高和较短箱长则提升被预测为铁路的概率。
局部解释:长尾现象说明某些低全局重要性的特征在个别样本中影响显著。
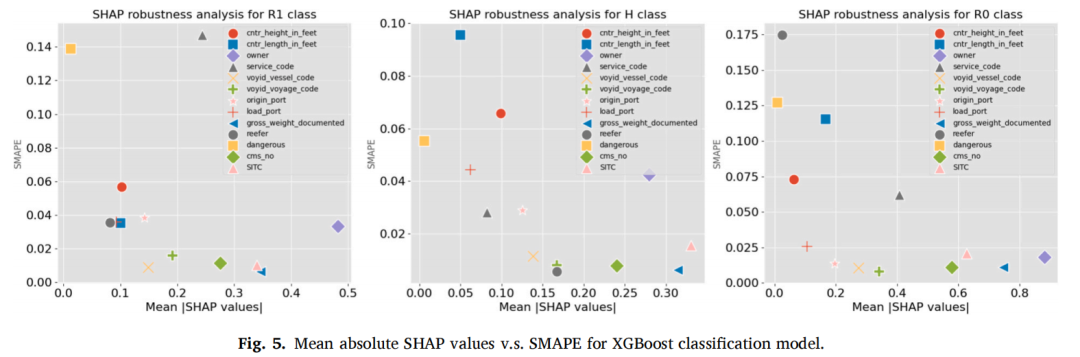
为检验解释结果的稳健性,作者对训练数据进行 10 次自助法抽样,比较不同数据集下 SHAP 排名的对称平均绝对百分比误差(SMAPE)。多数特征的 SMAPE 小于 0.2,说明解释结果稳定。图5展示了 SHAP 值与 SMAPE 的关系。
五、成本模型与方案评估
5.1 成本系数估计
由港口运营团队评估,从堆场到各出场口的移动成本按相对距离和错班罚金归一化得到表7。例如,跨堆场运送至铁路出场口的成本 (C_{yr01}, C_{yr10}) 取 20–60 的区间,远高于同堆场至公路口的成本 (均取 1)。
5.2 三种运营场景
论文构建了三种堆场操作场景(见图2和图6):
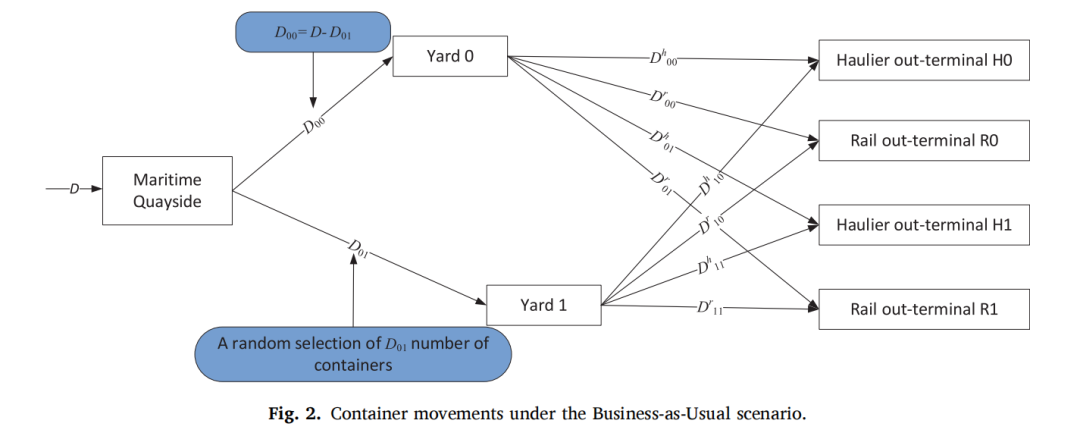
业务惯例(Business-as-Usual):不提前知道出场口,按 70:30 比例将箱子分别存于近码头的堆场0和远离码头的堆场1。由于公路箱由操作方指定出场口,只有极少数需要跨堆场移动。
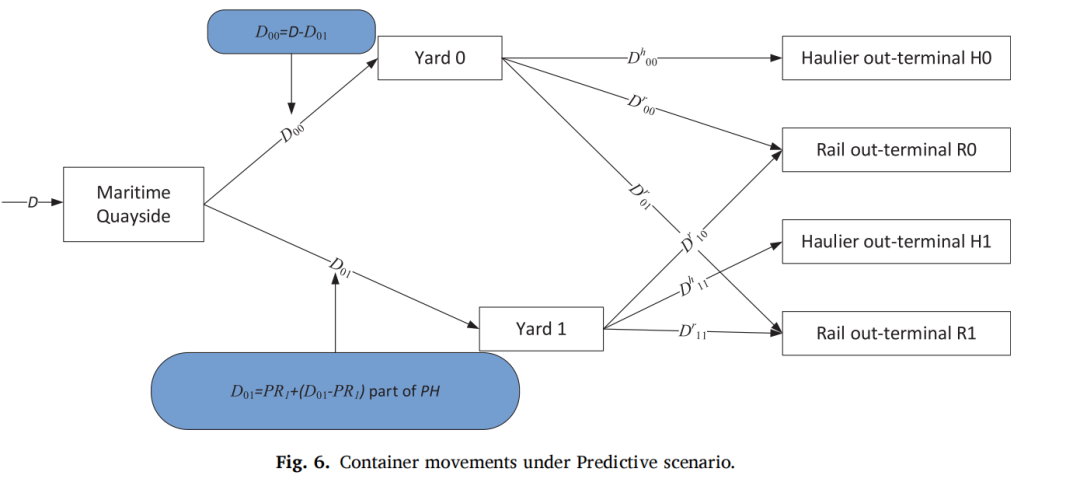
预测场景(Predictive):用模型预测各箱的出场口,将预测为 R1 的箱全部存至堆场1,预测为 R0 的存至堆场0,其余公路箱仍按 70:30 比例分配,以保持工作量平衡。同时,公路箱在其所在堆场直接出场,避免跨堆场移动。
理想预测(Ideal Predictive):假设预测 100% 准确,所有箱都能存放于正确堆场。
以下分别示意两种场景下的集装箱流动:
业务惯例场景
预测场景
5.3 成本模型与公式推导
对每个场景,作者基于如表3的流动记号建立运输相关成本公式。例如,在业务惯例场景下,堆场0和堆场1的成本分别为:
其总成本为 。类似地,预测场景和理想预测场景通过读取模型的混淆矩阵 (表6) 中各类的正确率与误差率,计算出不同实际流动量并代入成本公式,得到相应成本。
5.4 结果与灵敏度分析
比较三场景成本(表8)显示,当跨堆场至铁路的成本系数 C_{yr01}=£20 时,预测场景的总运输成本为 £2,679,682,而业务惯例为 £3,148,962,理想场景为 £2,043,575。预测场景比业务惯例减少的成本主要来源于减少堆场0到 R1 的跨场运输(降幅 44.37%)和堆场1到 R0 的运输(降幅 31.38%)。
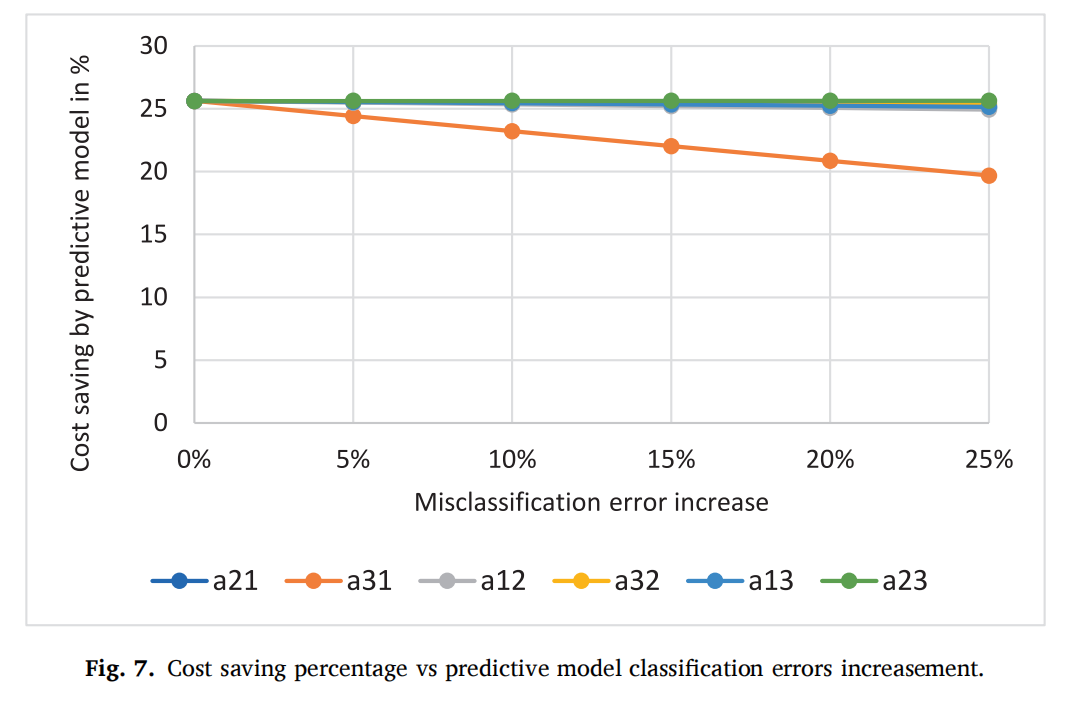
进一步将跨场铁路成本从 £20 提升至 £60,发现预测场景的总成本降低幅度可达 14.90% ~ 30.45%,且随成本系数增加而增加。敏感性分析表明,误判 R0 为 R1 或 R1 为 R0 的错误率 (a12, a21) 对成本影响最大。
下图展示了在不同误判率增长情况下的成本节约百分比。即使误判率提高 20%,预测场景仍明显优于业务惯例。
六、讨论与结论
该研究首次提出利用机器学习预测进口集装箱出场口,从而制定堆场储放策略的思路。通过对 Port A 的实证研究,作者总结出以下关键贡献:
方法论创新:构建了结合结构化与非结构化数据、特征工程、解释性分析与成本评估的完整框架。无监督的 SITC 分类使文本内容成为有价值的特征,提升预测精度。
模型效果:XGBoost 在引入 SITC 后整体准确率约 80%,能较好地区分铁路与公路集装箱。SHAP 分析指出关键因素是内容分类、箱主和重量,揭示了业务规律。
经济效益:预测场景较业务惯例减少 14.9%–30.45% 的运输相关成本,且越是跨场至铁路的成本高昂,预测模型带来的效益越明显。此外,模型部署对现有操作系统影响极小,可作为简单模块集成。
适用性与扩展:该框架可推广至其他港口和行业。文中建议未来可融合更多信息如托运人/收货人信息,联合堆场排班与车辆调度模型以进一步提升效率。
展望
研究认为,实时预测并引导堆场运营的决策方式将成为港口数字化转型的重要方向。未来可考虑将预测模型与码头桥机作业、集装箱移位优化等决策结合,或应用于其他供应链场景,拓宽数据驱动决策的边界。
通过深入解析该论文,我们看到数据科学与运营管理结合的潜力:不仅通过模型预测提升效率,更强调解释性和经济价值评估,为传统行业注入创新力量。


