基于图神经网络的深度强化学习方法在高铁时刻表和站台分配联合再调度中的应用
原文链接见文末
一、引言:高铁虚拟耦合与联合再调度的意义
随着人工智能和列车‑列车通信技术的发展,虚拟耦合(virtual coupling)成为高铁调度中的新模式。相较于固定物理编组,虚拟耦合允许列车以 更短的列车间隔 成列运行,提高线路和站内资源利用率,特别是在突发情况下更能体现灵活性。然而,站内线路和站台资源是高铁运行的关键瓶颈。传统调度方法往往将列车时刻表调整和站台分配分开处理,难以充分利用站内复杂路网、运行序列和不同车次停站模式之间的耦合关系。近年来强化学习被引入列车再调度研究,能够通过离线训练得到在线可直接应用的策略,既保证了近似最优的调度质量,又能在复杂场景下快速生成新时刻表。
本文针对虚拟耦合下的高铁时刻表和站台联合再调度问题,在分析站内列车占用过程的基础上构建了联合再调度模型,引入异质图表达状态,并利用图神经网络‑近端策略优化(GNN‑PPO)算法求解。研究表明,该方法能在实际线路数据上显著降低列车总延误,并具有很好的扩展性和泛化能力。
二、问题描述与建模挑战
2.1 列车运行过程和事件分解
为同时考虑时刻表重排与站台分配,论文将车站内的轨道划分为四类:进站线路、站台、出站线路和区间。列车在这些轨道上执行 到达、停站、出发、区间 等事件。例如一列列车先占用进站线路到达车站,随后停在某个站台,再从出站线路离站。每个事件有预定的开始时间和结束时间,调度的目标是在保证安全间隔的前提下重新分配事件开始/结束时间以及其所选轨道,从而得到新的时刻表和站台分配。
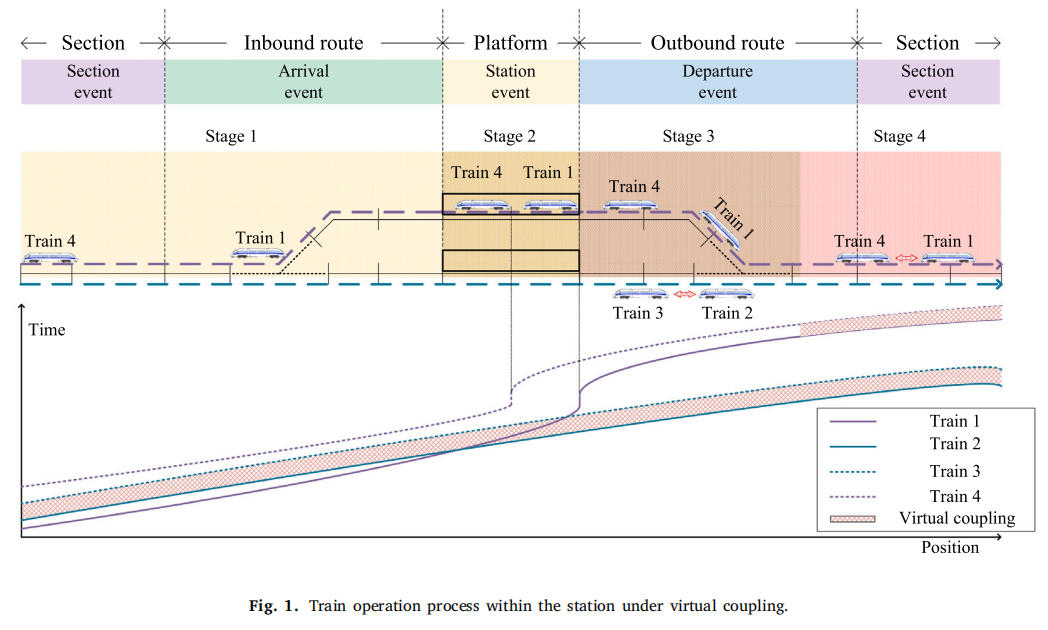
进站和出站线路之间存在冲突,需要计算列车间的最小安全间隔;不同编组列车对站台的占用方式也不同。图1展示了虚拟耦合条件下车站内多列车的运行过程示意:不同颜色表示不同车次在进站、停站和出站阶段的占用路径,蓝色/紫色虚线代表可行的调度方案(取自图1)。
2.2 联合再调度模型概述
模型的目标是 最小化所有列车事件的总延误。若记 为所有事件集合, 为事件 的计划结束时间, 为重调度结束时间,则目标函数为:
决策变量包括:每个事件的重调度开始时间 、结束时间 、选用轨道指示变量 (为1表示事件 选择轨道 )。基本约束包括:
唯一轨道分配:每个事件必须从其可用轨道集合中选出一个轨道; 非提前发车:重调度时间不得早于原计划时间; 事件连续性:事件完成后需立即进入下一个事件; 执行时长限制:事件在某轨道上的执行时间不得小于该轨道的最小运行时; 冲突间隔限制:对任意一对冲突线路 ,当两列车相继占用它们时,开始和结束时间间隔需满足最小安全间隔约束。
2.3 轨道占用与释放过程
模型中需准确描述轨道占用和释放规律:
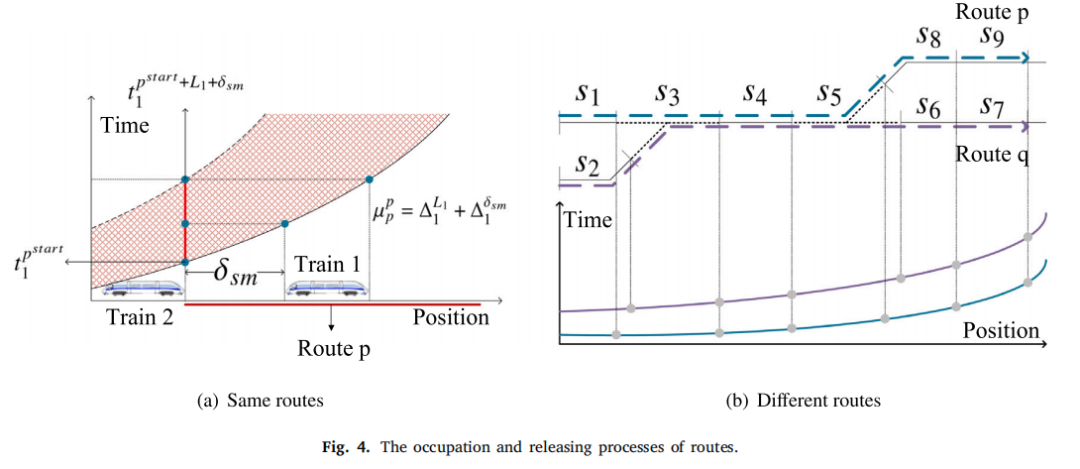
线路(进站/出站)占用:当一列车占用线路 时,需同时锁定与之冲突的线路(共享道岔)。列车尾部离开起点后行驶一段 (相对制动距离加安全余量)才可允许后车进入。若两车连续占用同一线路,最小间隔为:
其中 表示前车头从起点行驶一个车身长度 的时间, 表示行驶安全余量所需时间。当连续占用不同线路 与 时,考虑共享道岔和先后释放,最小间隔可由式(8)(省略证明)归纳而来。
站台占用:站台可容纳一列16/17节车或两列8节车,模型考虑不同编组同时占用站台以及先后停靠和离开时的可用性转换。
区间占用:多列车可同时运行,但满足先进先出原则即可。
图4给出了线路占用‑释放的时空示意以及不同线路共享区段时的间隔计算过程(取自图4)。
2.4 模型挑战
该问题的难点包括:
虚拟耦合下安全间隔可变:列车间距不仅与速度有关,还需根据相对制动距离实时计算,导致约束复杂。 站内细粒度拓扑:传统宏观模型忽略站内道岔和站台之间的互联关系,而本问题需在微观层面考虑多个并行线路、共享道岔和不同站台容量。 问题规模大:多列车、多车站、多种编组,导致搜索空间巨大;传统精确算法难以满足实时性。
为解决这些挑战,论文提出利用 异质图 将列车事件与轨道关系进行统一表示,并通过 深度强化学习 学习调度策略。
三、异质图表示与MDP建模
3.1 异质图结构
为了将站内复杂的轨道拓扑、事件序列和冲突关系整合在一起,研究采用了异质图(Heterogeneous Graph) 表示系统状态。异质图包含以下元素:
节点:事件节点 (列车到达、停站、出发和区间事件)、轨道节点 (进站线路、站台、出站线路和区间);
边:
顺序边 :表示事件执行顺序(如同一列车的到达后必须停站); 冲突边 :连接互相冲突的线路,保证最小安全间隔; 相邻边 :表示轨道之间物理连接关系; 可用边 :连接事件与其可选的轨道。
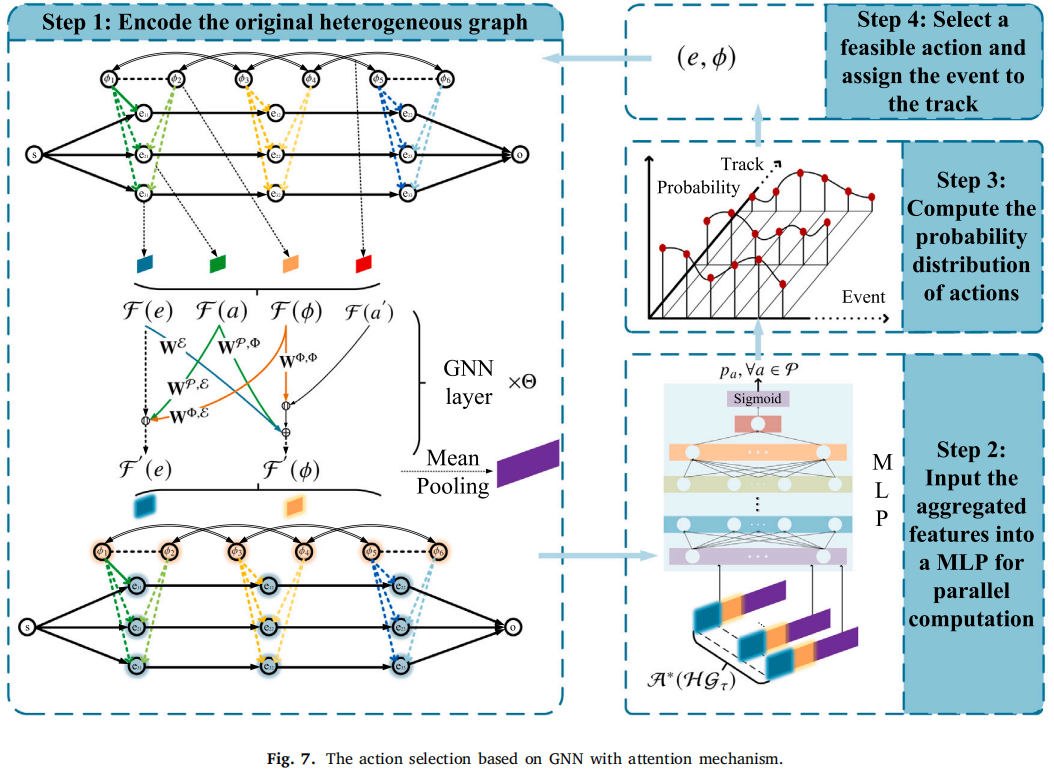
图7展示了异质图的嵌入与动作选择过程示意,左侧是输入图、邻居特征聚合,右侧为通过聚合后计算动作概率的过程(取自图7)。
3.2 马尔可夫决策过程定义
基于异质图构建 马尔可夫决策过程(MDP):
状态:决策时刻 的异质图,包括节点静态特征(如事件的前继/后继关系、列车编组类型、原计划时间)和动态特征(如事件是否完成、轨道剩余容量、事件预计完成时间等)。
动作:选择将某个事件 分配到可用的轨道 。为增加灵活性引入“虚拟动作”,允许在某一步暂不分配,等待环境时间推进。
奖励:为减小延误,选择动作时的即时奖励设为负的延误增量。若某事件的预计完成时间超过了当前环境时间但其后续事件尚未调度,则收取附加惩罚。
状态转移:分为两种情况:
非推进状态转移(NTAT):动作改变轨道占用但不需要推进时间,直接进入下一决策时刻; 推进状态转移(TAT):在没有可用动作时推进系统时间至下一个轨道释放或事件完成时刻,再进入下一决策时刻。
此MDP保证了状态转移的唯一性和安全性,为深度强化学习提供了清晰的决策框架。
四、图神经网络‑PPO求解方法
4.1 GNN嵌入:结构感知的状态表示
由于问题规模(列车数量、轨道数量)不固定,采用 图神经网络(GNN) 结合注意力机制对异质图进行嵌入。嵌入过程分为两步,可以并行执行:
轨道节点嵌入:对于轨道节点 ,需要聚合相邻事件节点和相邻轨道节点的特征。令 和 分别为事件节点和事件‑轨道边的原始特征,则轨道节点的注意力权重计算为:
其中 表示向量拼接, 为可学习参数。归一化注意力系数经 Softmax 得到 。聚合不同邻居并经过 MLP 得到轨道嵌入 。
事件节点嵌入:事件节点的嵌入需要考虑其前继事件、后继事件和自身特征,通过三个 MLP 编码后拼接,再与相邻轨道嵌入通过注意力聚合得到 。
堆叠多层 GNN 并采用平均池化得到整张图的表示 。然后对每个可行动作 连接事件嵌入、轨道嵌入及图嵌入,通过 MLP 计算动作优先指数并经 Softmax 得到动作概率分布,用于采样决策。
4.2 PPO算法:稳定高效的策略学习
考虑到调度问题状态‑动作空间庞大且需要较稳定的训练收敛速度,论文采用 近端策略优化(PPO) 训练智能体。PPO通过剪切策略更新,限制策略变化幅度,使训练更加稳定。具体步骤如下:
离线训练:在模拟的列车运行环境中随机生成各种故障场景(速度限制、区段故障、发车延误等),让智能体尝试调度多种规模的问题,收集状态‑动作‑奖励轨迹。 策略更新:在每次迭代中,利用收集到的轨迹计算优势函数,按PPO剪切目标优化策略网络参数。 在线应用:训练完成后,可直接在线使用策略网络对新情况进行决策,无需额外搜索。
GNN‑PPO 的关键优势在于:一是利用异质图和注意力机制学习到轨道冲突、事件顺序等结构信息,实现 规模无关的表示;二是PPO使训练稳定且具有较强泛化能力;三是通过引入虚拟动作,适应不同的问题节奏和时间推进需求。
五、实验设计与结果分析
论文基于 京沪高铁 实际数据构建三个区段布局,分别包含4、7、10个车站,对应 45、90、117 条轨道,分别选取 6、12、20 列车组成九种规模。为了测试方法在不同规模和场景下的性能,实验设计了以下四类对比和分析。
5.1 与常用调度规则的比较
文中将 GNN‑PPO 与常见的规则调度策略(最早完成时间、最短/最长处理时间规则、先到先服务等)比较。结果表明,GNN‑PPO 在 1800个随机案例 中平均延误仅为 3764分钟,比基线规则平均低 **9.8%**。同时,其求解时间随着问题规模近似线性增长。例如在6列车45轨场景求解耗时约2.46秒,20列车117轨场景约38.68秒,平均每次轨道分配决策耗时不到0.06秒,满足实际实时应用需求。
5.2 与 CPLEX 和遗传算法的比较
在较小规模问题下与商用求解器 CPLEX 进行比较,发现 GNN‑PPO 获得的延误比 CPLEX 的近似最优解高约5.7%,而在大规模问题中(轨道数和列车数更大)与 CPLEX 的差距约8.5%,但前者求解时间显著更短。与遗传算法相比,GNN‑PPO 在求解质量和效率上均优于对方,展现出很好的适用性。
5.3 虚拟耦合效果分析
为验证虚拟耦合的效益,论文比较了基于 虚拟耦合(VC)、路段锁定‑路段释放(RLRR)、路段锁定‑分段释放(RLSR) 和 分段锁定‑分段释放(SLSR) 四种模型。结果显示,采用虚拟耦合的 GNN‑PPO‑VC 平均延误最小,较SLSR下降4.35%,较RLRR下降6.56%。说明在安全控制下缩短列车进出站间隔,可显著提升恢复能力。
5.4 泛化能力测试
为评估模型在不同规模和线路上的泛化性,论文训练了九个不同规模的智能体,并交叉测试于九种规模的问题上。结果发现,在所有测试场景中,在大规模(20列车、117轨)训练的智能体泛化性最佳,无论测试场景大小都取得最低延误。这表明增加训练时的轨道数量 能够提高模型对复杂拓扑的适应能力;列车数量的提升次之。此外,将训练好的智能体迁移到另一条 京广高铁 线上测试,GNN‑PPO‑20‑117 在所有六种新场景中表现均优于在该线路上训练的基线智能体,平均延误降低1.76%,说明模型具有良好的跨线路泛化能力。
5.5 消融实验与注意力可视化
为分析各组件的贡献,作者进行了消融实验。移除注意力机制的 GNN‑PPO‑Baseline 延误提高了10%,用全连接网络替代GNN的 FCNN‑PPO 延误提高20%,改用 A3C 算法的 GNN‑A3C 性能略逊于 GNN‑PPO。说明GNN 结构和注意力机制对捕捉轨道‑事件关系至关重要,PPO 有助于稳定训练。
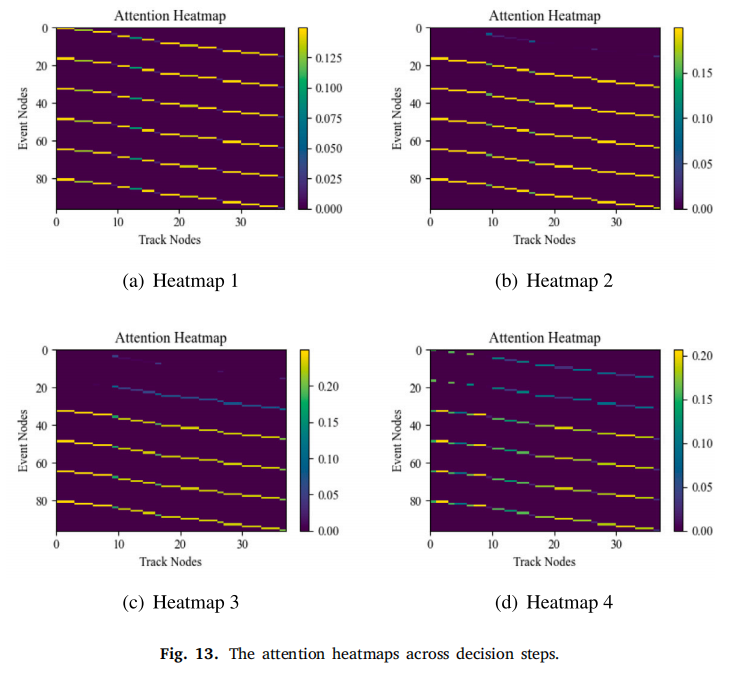
此外,论文可视化了注意力权重变化(取自图13)。下图展示了在四个不同决策步骤中,模型如何动态调整事件‑轨道对的注意度:紫色表示重要性低,黄色表示高。可见随着某些事件执行或轨道释放,注意力不断重新分配,这验证了模型能够根据实时状态自适应调整优先级。
六、结论与展望
本文围绕高铁虚拟耦合条件下的列车时刻表和站台联合再调度问题提出了一种 异质图‑MDP‑GNN‑PPO 一体化解决框架。研究主要贡献包括:
精细建模:将车站划分为进站线路、站台、出站线路和区间,并将列车运行过程分解为连续事件,考虑虚拟耦合下的最小安全间隔,通过公式计算不同情况下的最小头距。 异质图表示:构建包含事件节点、轨道节点和多种边关系的异质图,用于表达列车状态、轨道拓扑和冲突关系,实现规模无关的状态表示。 GNN‑PPO算法:设计基于注意力的图神经网络提取异质图特征,并结合PPO在仿真环境中离线训练,在在线调度中以策略网络快速决策,实现端到端联合再调度。 广泛实验验证:在京沪高铁真实数据上测试多个规模和场景,结果表明该方法可平均减少近10%的总延误,求解时间随规模近似线性增长,并且泛化到不同线路仍表现优异。
文章指出,虚拟耦合为列车紧密编组提供了可能,联合调度模型可以最大限度地发挥这种优势;深度强化学习在处理大规模复杂调度问题上表现出良好的实时性和适应性。未来工作可进一步考虑 不同站台的虚拟耦合、多线路耦合 及 多目标优化,并将模型与实际列控系统结合,推进智慧铁路调度的落地应用。


