今日的“论文速递”系列文章,我选了物流优化中的经典难题——旅行商问题(TSP),并结合《A contextual framework for learning routing experiences in last‑mile delivery》一文,聊聊如何将快递员的实战经验注入算法,让最后一公里更高效。
从仓库到小区大门是“长途”,真正难的,却是门口到家门的“最后一公里”。直线百米,看似简单,背后却可能隐藏封闭小道、杂乱单元门、临时改派、甚至电动车临停没电或老旧电梯罢工等各种突发状况。最优路径算法往往只能脱稿演算,却难以兼顾这些“场景变量”。而无数优秀配送路线,正是快递员凭借经验踩出的“硬核捷径”。
论文的核心思路在于:别只让算法盯着距离,先从历史高质量轨迹里提炼出道路类型、地形特点、取件时段等关键维度,然后为每条路段「打分」——分值越高,意味着越不建议选择。将这些“经验惩罚”与距离成本一并喂给经典TSP求解器,得到的线路既兼顾效率,也更符合快递员的真实操作习惯。
接着,让机器自动学会如何打分,无需繁琐手动调参。作者提出两种方法:
微调式试错:先用规则方法得到初始评分,每轮检测出若干“表现最差”的路段组合,适当增加惩罚,再整体评估;不断迭代,直到效果稳定。该方法可精细优化,却需要较高计算资源。
频次式统计:统计所有优质路线中各特征组合出现的频次,出现越多,惩罚越低;若从未出现,则赋予高惩罚。这一路径部署迅速,但对全新场景的适应性相对有限。
两种思路各有侧重:前者强调精确微调,后者追求快速落地。后续章节中,作者还将它们与传统规则进一步融合,以获得更佳性能。总体来看,这篇论文最具价值的,是它让路径规划算法不再“冰冷”,而是真正融入了快递员的实战智慧。
后文是正片论文的总结,感兴趣的同学可以访问期刊下载或者直接关注公众号留言获取。
01|问题背景:最后一公里的经验难以建模
作者从亚马逊 2021 年 Last-mile Routing Challenge 提供的真实数据出发,分析了超过 6000 条配送路径。这些路径中,快递员并不总是选择距离最短的线路,而是基于场景中的“软信息”进行微调——比如优先完成某区域的集中投递、避免某些复杂转向、响应用户变更等。
传统 TSP 模型(即最短路径模型)无法体现这些“偏好”。因此,作者提出将每一条路径的“弧”(节点间的连接)打上权重,构成一个转换惩罚矩阵(Transition Weight Matrix),以反映某条边的“可取程度”。 这个矩阵并非直接从地图计算得出,而是从历史优质路径中“学习”来的。
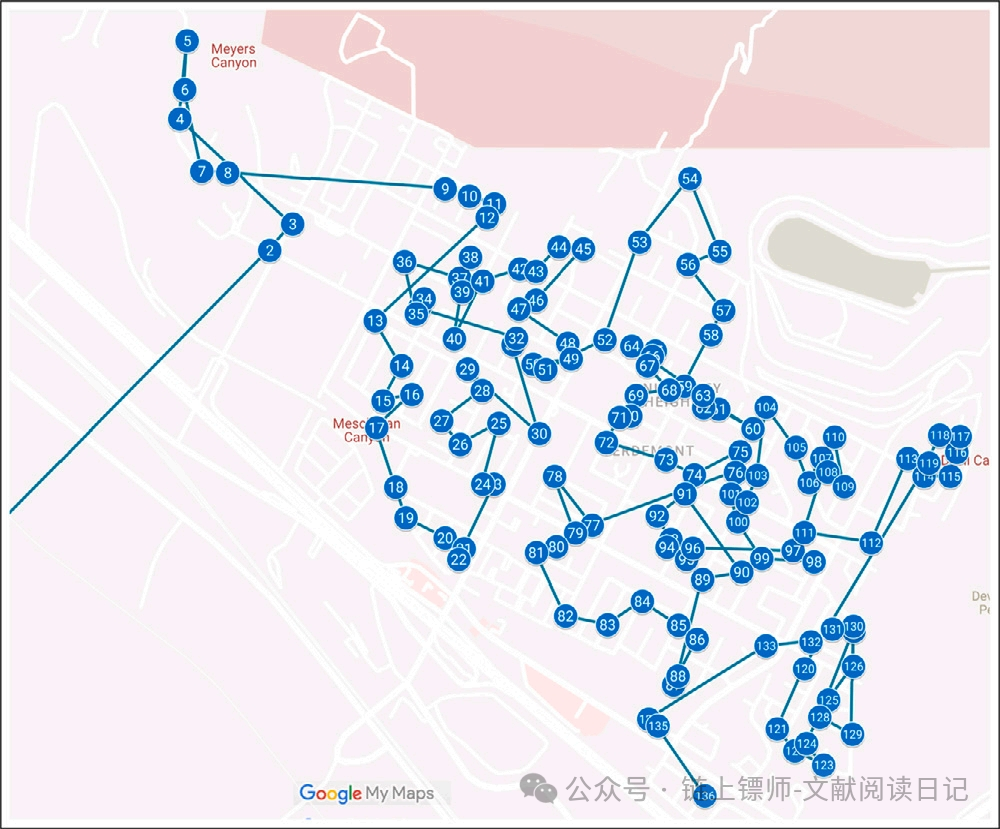 节点在路线上的顺序标记
02|核心框架:经验矩阵的构造逻辑
每条路径实例 对应一个权重矩阵 ,其中每个元素 表示从节点 到 的惩罚程度。 为了降低学习维度,作者对矩阵进行了按“特征因子”的分解:
其中:
表示特征集合(如距离、区域、包裹大小、时窗等); 是指示矩阵,标明每个节点的特征取值; 是我们需要学习的“特征影响矩阵”,表示不同特征取值之间的偏好关系。
举个例子,若两个节点分别属于不同配送区域,则它们之间的连接可能会受到更高的惩罚,从而使算法倾向于先完成区域内配送。
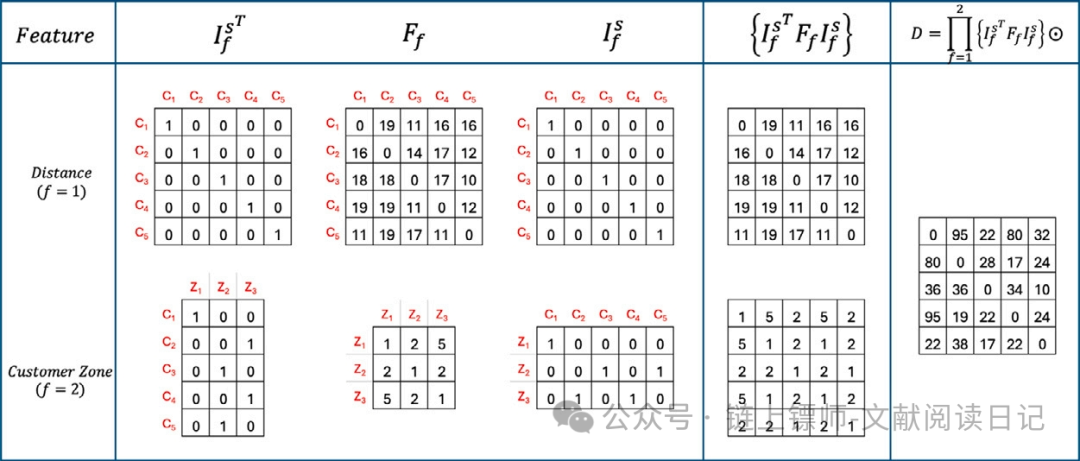 五个节点和两个特征(距离和包裹大小)
03|学习方法一:Score-Guided Coordinate Search(SGCS)
这一部分的核心是:如何从历史数据中自动调整这些特征惩罚矩阵 ?
SGCS 是一种无需导数的优化方法,灵感来自坐标搜索(Coordinate Search)。它的核心策略是:
从当前矩阵出发,找出一批“表现最差”的连接(比如频繁出现在低质量路径中); 逐步加大这些连接的惩罚; 每次评估整体路径质量是否提升,如果有,就接受这个调整。
伪代码如下:
Input: 特征影响矩阵 F_f, 历史路径集合 S, 惩罚步长 Δ, 最多迭代次数 T
For t in range(T):
    γ_f = compute_weighted_scores(S, F_f)
    worst_entries = pick_bottom_ε(γ_f)
    for each entry in worst_entries:
        F_f[entry] += Δ
    If overall_score improves:
        accept change
    Else:
        backtrack or increase penalty
SGCS 的好处是可以精细调整,但代价是每次更新都需要重新计算大量路径,训练时间较长。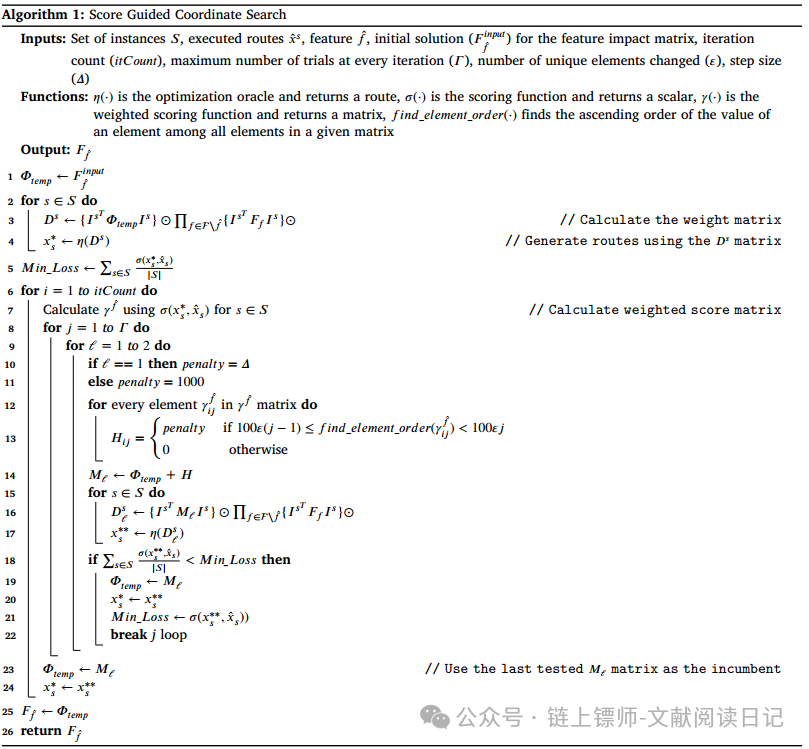 论文中的完整伪代码
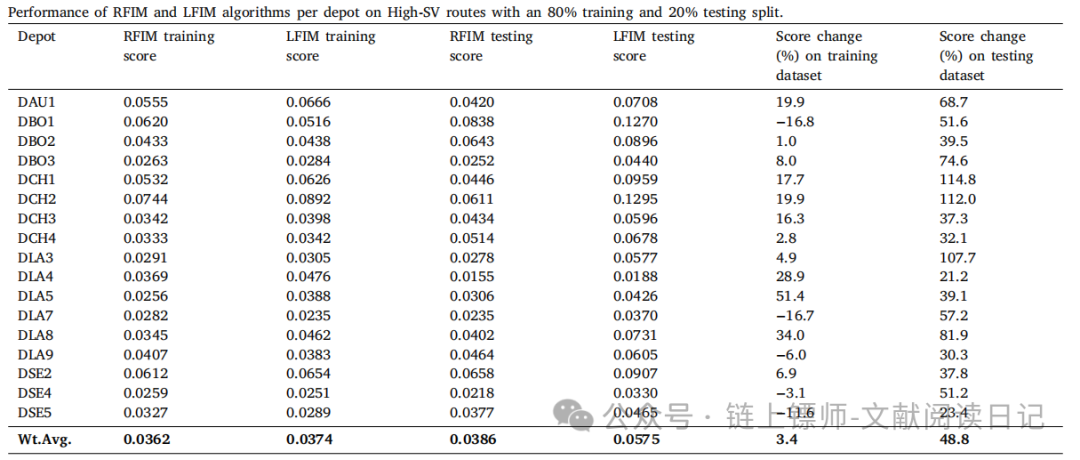
04|学习方法二:Label-guided Feature Impact Matrix(LFIM)
相比之下,LFIM 更像是统计学方法的应用:
统计在高质量历史路径中,某一类特征组合(如“区域 A 到区域 A”、“区域 A 到区域 B”)出现的频次; 出现越多的连接,惩罚越低;从未出现的连接则设置较高惩罚。
LFIM 的矩阵构造规则如下:
这种方法无需迭代训练,速度快且实现简单,但在面对新场景时缺乏适应能力。
05|融合策略:R + LFIM
为了解决泛化性与细节捕捉的平衡问题,作者提出了一种结合方法:
对于训练集中出现过的连接,使用 LFIM 统计得分; 对于未出现过的连接,退回到 RFIM(基于规则的评分方式)。
这种融合方法兼具数据驱动的精度与规则方法的稳健性,在测试集上表现最优。
06|小结与思考
这篇论文提出了一个思路清晰、方法精细的路径学习框架,它既考虑了实际操作中的经验性偏好,也利用了现代机器学习的工具对其进行建模与优化。 在最后一公里这个充满“不确定性”的领域,让算法拥有“经验感”,或许正是提升效率与适应性的关键一步。
关注公众号,每日推送论文速递,每周推送论文精读


