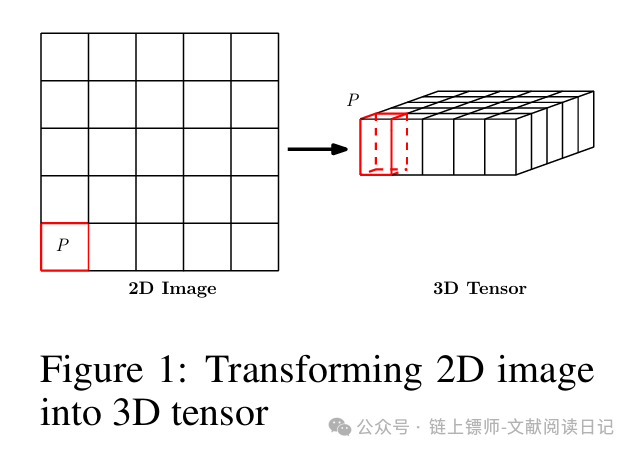
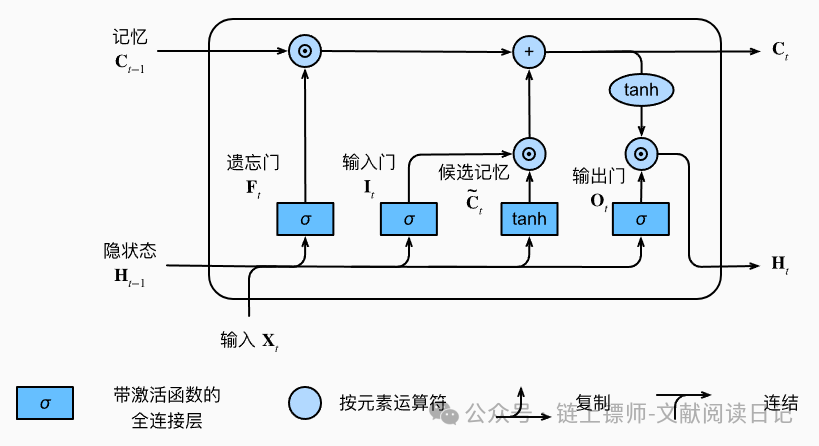
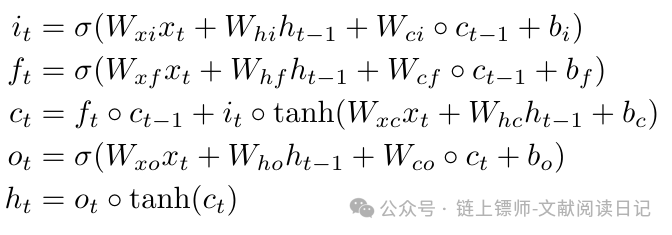
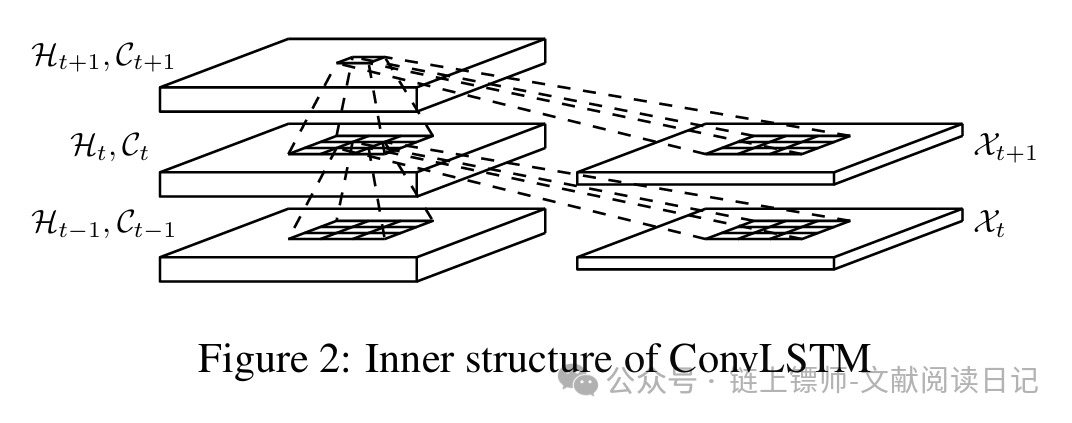
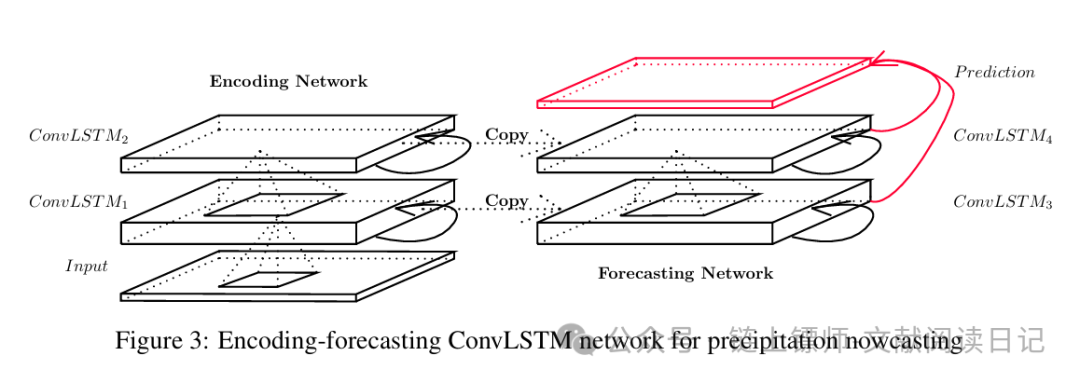
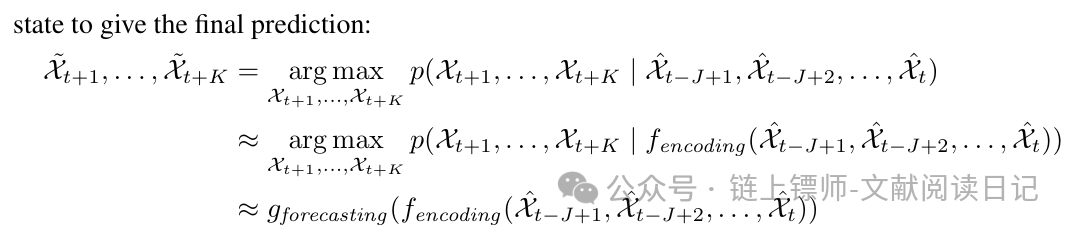
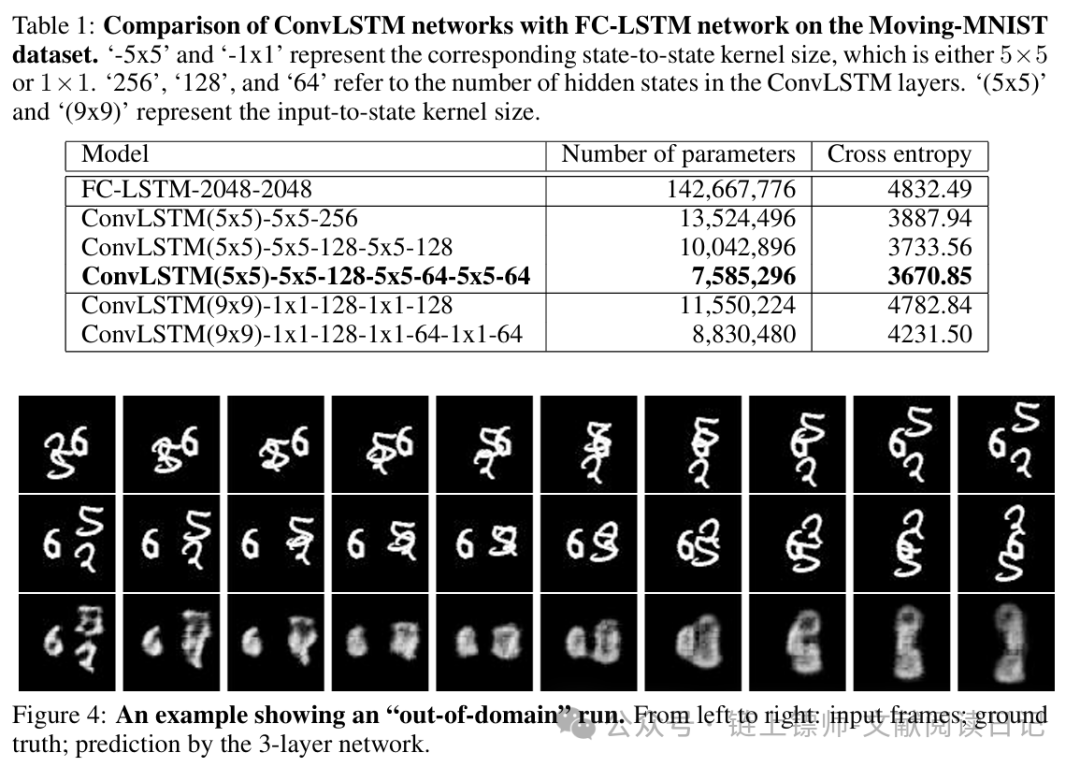
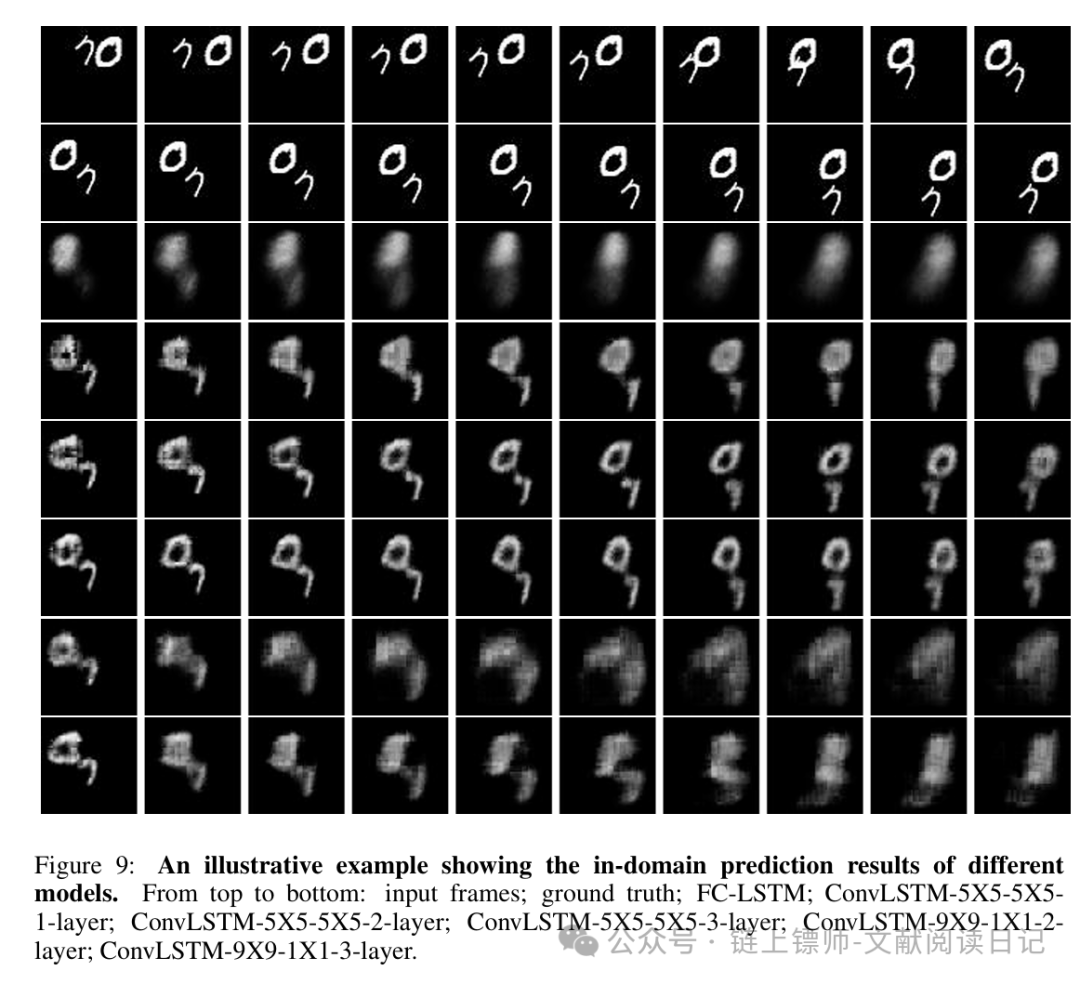
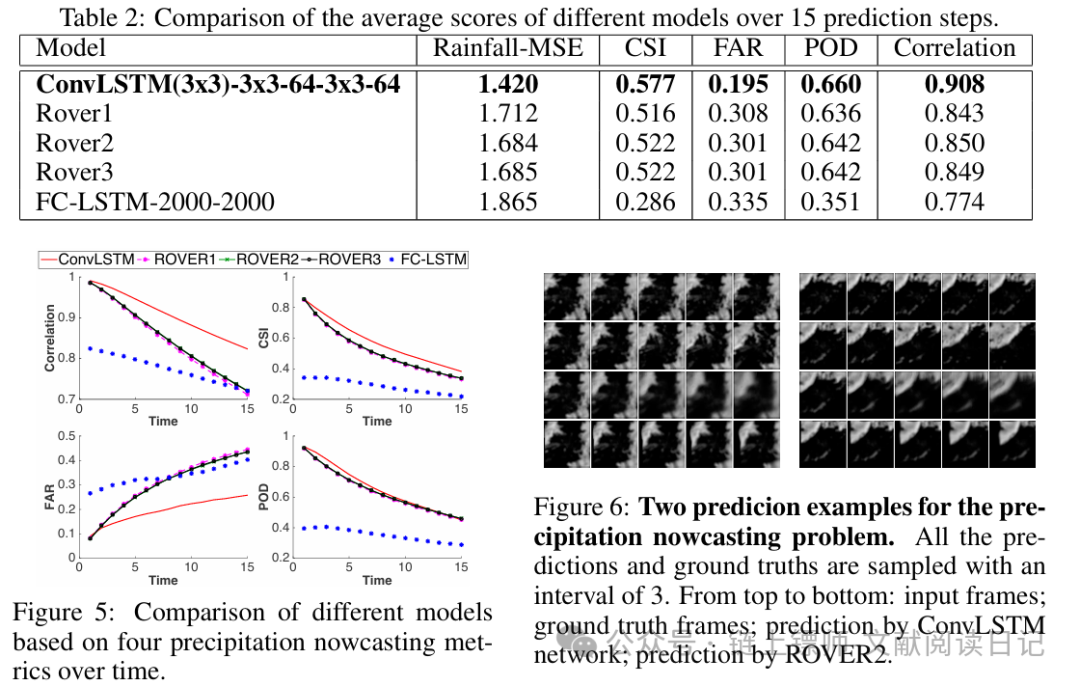
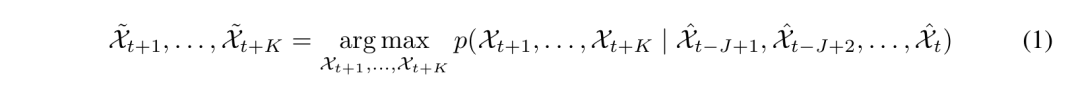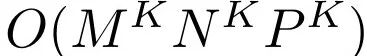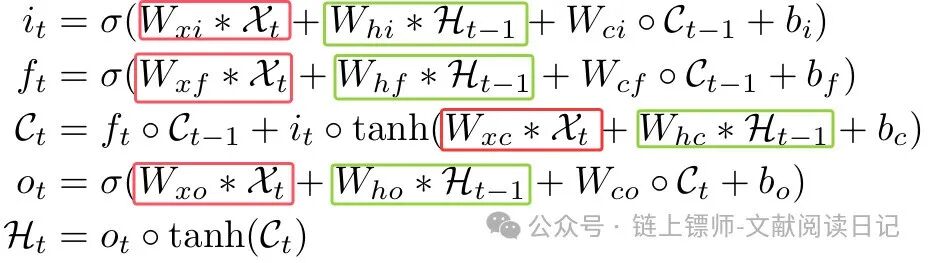这是我第一次尝试写与时空序列预测方面相关的文章,笔者也是一年前刚开始接触到这个研究领域,希望大家一块交流,共同进步。 时空,顾名思义是时间与空间两个维度,对于经常参加竞赛的朋友来说,首先想到的可能是数学建模比赛中经常出现与时间相关的一系列预测问题,这些问题往往通过ARIMA、LSTM等一系列时序模型来进行拟合预测。 时间序列和时空序列时常有朋友搞混,其实不然,时空序列问题包含了时间和空间两个方面的因素。 这里时间其实是空间维度前后的序列,这里空间也指向图片上的目标以及目标的移动和变化的空间信息,也指存在表格化数据中存在gps数据或者x、y或者经纬度的空间信息。 最经典的时空序列模型莫不过于施行建博士的ConvLSTM。 那么接下来,带大家来精读一下施博士这篇时空序列预测的根基性paper。 这是NIPS 2015年的一篇会议:https://arxiv.org/pdf/1506.04214.pdf 常见领域中对图片的处理往往用于识别、分类、检测等工作,而在这篇 paper中,作者解释了时空序列预测问题的本质是什么,是通过雷达回波图来进行降水预报,雷达回波图往往是每间隔6min一张,通过已知的雷达回波图来预测固定小时之内的图像序列。这就是时空序列预测问题。 正如作者图中所表示的那样, P 维度实际上是回波图通过一定变化推断得出的物理量维度,同时,也形象的说明了为什么通过预测可以得出对应位置的降雨量。 这个表达式是时空序列预测的标准表达式,阐述了通过定期记录的观测值来预测未来最有可能的长度为K的序列。 时空序列与时间序列另一个区别是,在相同的序列长度下,时空序列的数据复杂度往往是是时间序列的指数倍,正如文中所表诉的那样: 这篇paper的一个领域奠基性创新点是在于突破了传统模型中的ecoding-decoding的结构,转而使用ecoding-forcasting的结构,同时,将input-to-state、state-to-state中的普通相乘替换成卷积运算,构建了一钟新颖的端到端的可训练模型:卷积长短期记忆网络(ConvLSTM)。 首先,让我先了解一下LSTM,下面是LSTM中“记忆细胞”的示意图: 正如作者在文中提及的那样,LSTM通过类似于“记忆细胞“中的输入门,输出门、遗忘门来实现信息的选择性流通,通过“恒定误差循环”的机制,LSTM在时间序列模型中可以有效的避免梯度消失的问题。 正如上文所提及的那样,作者采用卷积操作而非传统的全连接操作,因为全连接意味着整体的图像信息全部相乘等于一个值,这样无法对时空信息做一个提取特征的作用,而改为卷积操作的话,通过改变卷积核的大小,即可捕获不同的时空特征,如果卷积核大,捕捉到的偏向于更快的动作,如果卷积核偏小,捕捉到的偏向于更慢的动作。 ConvLSTM中的公式其实就是把红色部分的input-to-state和绿色部分的state-to-state替换成卷积运算,与上图对比起来更为直观。 这幅图看起来比较抽象,但是如果仔细观察,就会体会到作者的独特见解, 输入 X 和 C 还有 H 都是三维的数据tensor。而图中的九宫格和曲线,指的是利用卷积运算通过过去一个时刻的输入和C还有H得到下一时刻的C和H值。 在这个理解下,FC-LSTM 其实可以看作是ConvLSTM的输入和输出以及状态H都为3D而最后两维为1的情况。 3.2 Encoding-Forecasting Structure 在文中,作者很清楚地说明了Forecasting网络初始的”记忆细胞“输出与隐藏状态由编码结构的 最终状态复制而来 ,正如文中的表达式所表述的那样。与传统 Seq2Seq不同,其预测输出并非直接采用解码状态,而是通过 1×1 卷积对所有解码状态进行维度映射,生成与输入维度一致的预测值。 作者使用了最经典的Moving-MNIST数据集和雷达回波数据集来进行模型结果的验证,通过对比全连接的FC-LSTM模型和基于光流法的ROVER算法模型来对比验证模型的性能。最终得出以下结果: 1、ConvLSTM比FC-LSTM在空间上处理更好。 2、state-to-state上的kernel大小要大于1对于提取时空的特征是必要的 3、更深的stacking模型会更好,这个对于数据量大的数据来说普遍如此 4、ConvLSTM比传统的降水预测的方法ROVER要更好 数据集包含20帧的序列,前10帧用于模型输入,后10帧为模型预测值,数据集为64 ×64的连续数字运动轨迹,分为10000条训练集、2000条验证集与3000条测试集。使用 cross-entropy交叉熵作为损失函数,设置优化策略为 学习率为0.001并带有0.9的延迟率,采用的optimizer为RMSProp, 同时,实现基于验证集结果早停的策略。得出以下的训练结果: 由表格可知,作者把每个模型的input-to-state的kernel size都设置一致,只有每层的state-to-state的卷积大小和隐藏状态的大小在变。通过表格,我们不难得出以下结论: Convlstm的效果比fc-lstm的效果好;更深的网络会更好,但是二层和三层之间差距不大。 而表格下方的 图主要来测试模型的泛化性,也是作者对前文中所提及的 out-of-domain的恰到好处的解释。 尽管实验结果从图中来看并不尽人意,但通过不同模型之间的对比,可以得出 较大的状态卷积核(如 5×5)显著优于 1×1 卷积核,表明更大的卷积核有助于捕捉长距离时空运动。 作者选择了 2011-2013 年香港地区的雷达数据,选取 97 个雨日,提取中心 330×330 区域,预处理后缩放到 100×100 像素。为什么只有97个雨日呢?正如文中所描述的那样,并不是所有地区每时每刻都在降雨,作者不能把没下雨的雷达图作为噪声或者负样本的情况来进行训练,因此作者采取了降水量最高的97天来作为训练数据。 首先通过归一化处理将330 ×330的的图像转换成100 ×100的图像, 之后作者利用kmeans对图像的每月平均像素做了一下聚类来进行去噪操作。但是,正常的雷达图都是6min或者12min获取的连续的序列,为此,作者采用了窗口大小为20的方法来获得不重叠的序列block,通过把每天的序列分成40个不重叠的block,随机分配四个block作为训练集,一个为测试集,一个为验证集。全部的block都是20的长度,5个为输入,15个为预测。这一点很好的解决了数据集缺失严重的问题,同时也满足了时空连续性的要求。 最后将ConvLSTM与降雨预测最传统的光流法(ROVER)和 FC-LSTM进行了对比 。
表格中的 CSI FAR POD Correlation等都是对于天气中的一些重要指标,在实验的对比之下,作者得出了如下的实验结果: 1. FC-LSTM效果没有ConvLSTM好 2. convlstm比传统的光流法要好,主要归结于两个原因:一个为convlstm能够更好的处理边缘,也就是上面所说的out-of-domain的能力,更泛化,对于降水的场景,会在边缘突然出现有雨等情况下处理能力更佳,另外convlstm的encoding-forcasting为端到端的结构,更为便于使用。 ConvLSTM 的提出为时空序列预测提供了兼具理论创新与实践价值的解决方案,其核心贡献在于通过卷积结构增强空间建模能力,并通过端到端训练实现复杂动态系统的有效建模。尽管在长时预测和物理约束融合方面仍有改进空间,但其方法论为机器学习与气象科学的交叉研究奠定了基础,有望推动短时预报技术向更精准、鲁棒的方向发展。
内容来源 链上镖师公众号公开文章 本站保留公开发布内容的标题、摘要、正文与来源链接,方便持续检索、阅读和分享。
打开公众号原文