链上镖师 / Chain Biaoshi
CIE|冷链运输温度告警:边缘小模型生成驾驶员决策说明
从九点温度监测、规则分类到四行自然语言处置建议
论文把冷链温度规则、0.6B小语言模型和边缘网关接成一条本地决策链,将传感器风险分类转换为驾驶员可直接阅读的四行告警。
- 01:边缘网关在断网期间仍可完成异常检测、风险分类、消息生成和本地缓冲。
- 02:草莓案例采用九个传感器、十分钟采样网格和一小时分析窗口。
- 03:微调后的Qwen3-0.6B实现100%格式合规和1.000风险槽位准确率。
- 04:30人交叉实验中,AI辅助界面的信任评分提高1.10分,SUS提高17.67分。
- 05:模拟边缘基准报告3.0秒推理延迟和1.39 GB显存占用。
冷链温度告警缺少哪一环
冷藏车已经能够连续采集货厢多点温度,驾驶员仍需自行判断偏离幅度、持续时间、数据完整性和处置优先级。论文归纳出三项运行障碍:云端分析受运输网络中断影响,统一阈值难以适配不同产品,数字或颜色告警缺少风险原因与行动说明。随着传感器种类增加,这类解释工作会进一步增加操作员的认知负担。
研究任务被限定为规则风险的自然语言解释:风险等级由确定性规则计算,小语言模型负责生成结构化驾驶员消息。
01输入:多位置传感器读数、产品温区、偏差幅度、持续时间和数据覆盖度。
02判断:异常检测与产品专属规则共同给出风险等级、热稳定性和置信度。
03输出:风险状态、温度模式、数据质量和处置动作组成的四行说明。
三层架构把决策留在边缘网关
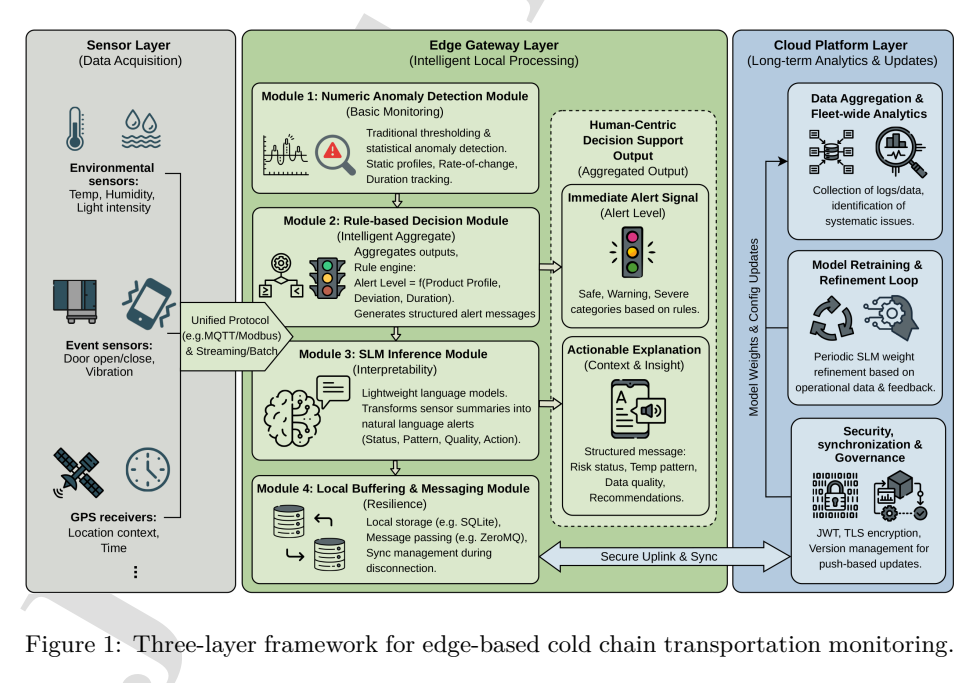
三层边缘冷链运输监测框架,边缘网关依次执行异常检测、规则分类、SLM推理和本地缓冲。来源:Figure 1
传感器层通过MQTT、Modbus等工业协议传递环境、事件和位置数据。边缘网关依次运行数值异常检测、规则决策、SLM推理与本地缓冲,直接输出风险指示和可执行说明。云平台承担车队分析、模型再训练和安全同步,核心监测链路可以在网络中断期间继续运行,并在连接恢复后同步本地记录。
1多点传感器采集温度与运行状态
2异常检测模块识别阈值偏离和统计异常
3产品规则结合偏差程度与持续时间生成风险等级
4小语言模型将结构化特征写成四行驾驶员消息
5本地队列缓存记录并等待云端同步
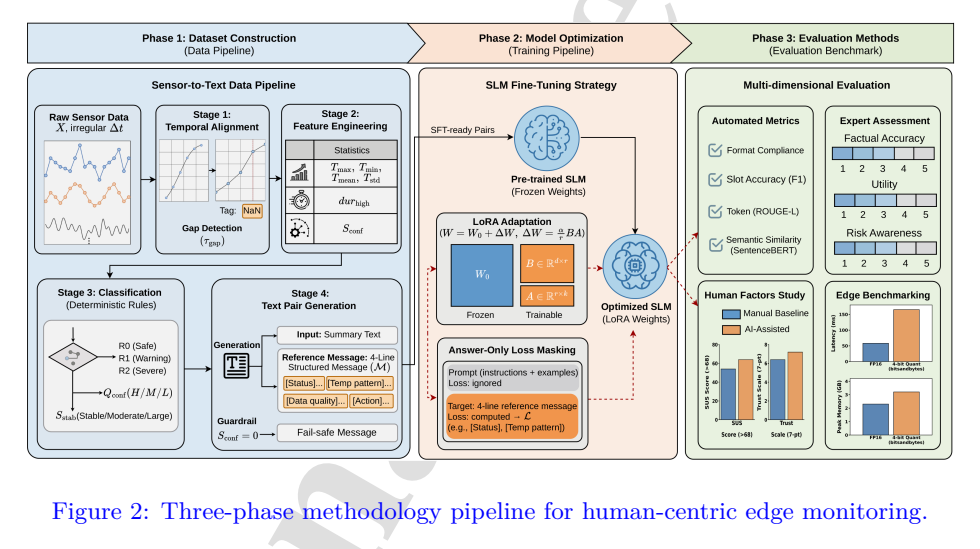
研究按照数据集构建、模型优化和多维验证三个阶段推进。来源:Figure 2
规则判断怎样变成四行驾驶员消息
每个分析窗口先计算最高温、最低温、平均温、温度标准差、超温持续时间、低温持续时间和数据覆盖率。风险等级由产品配置、偏差幅度及持续时间共同确定,数据覆盖率映射为高、中、低置信度,温度标准差映射为稳定、中等波动或大幅波动。所有数值和分类均可追溯到实际传感器记录与显式规则。
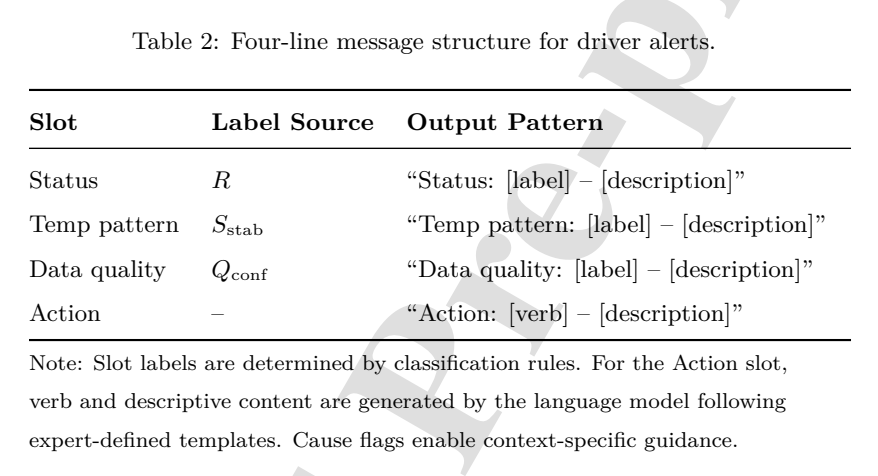
四行消息分别表达风险状态、温度模式、数据质量和建议动作,各字段均由规则特征提供依据。来源:Table 2
第1行:当前风险状态及其严重程度
第2行:主要温度模式与触发原因
第3行:数据覆盖情况和判断置信度
第4行:与风险模式对应的驾驶员处置动作
确定性特征提供事实底座,固定四槽结构约束生成范围,低数据覆盖情形直接触发预设安全消息。
九个传感器怎样形成草莓运输样本
案例使用公开草莓冷链数据集,包含S1至S6六个运输批次和货厢内九个传感器位置。原始读数约每5至10分钟记录一次,并从华氏温度换算为摄氏温度。研究将数据重采样到固定十分钟网格,超过三十分钟的数据间隔标记为缺失值,避免无传感器支持的插值进入后续风险判断。
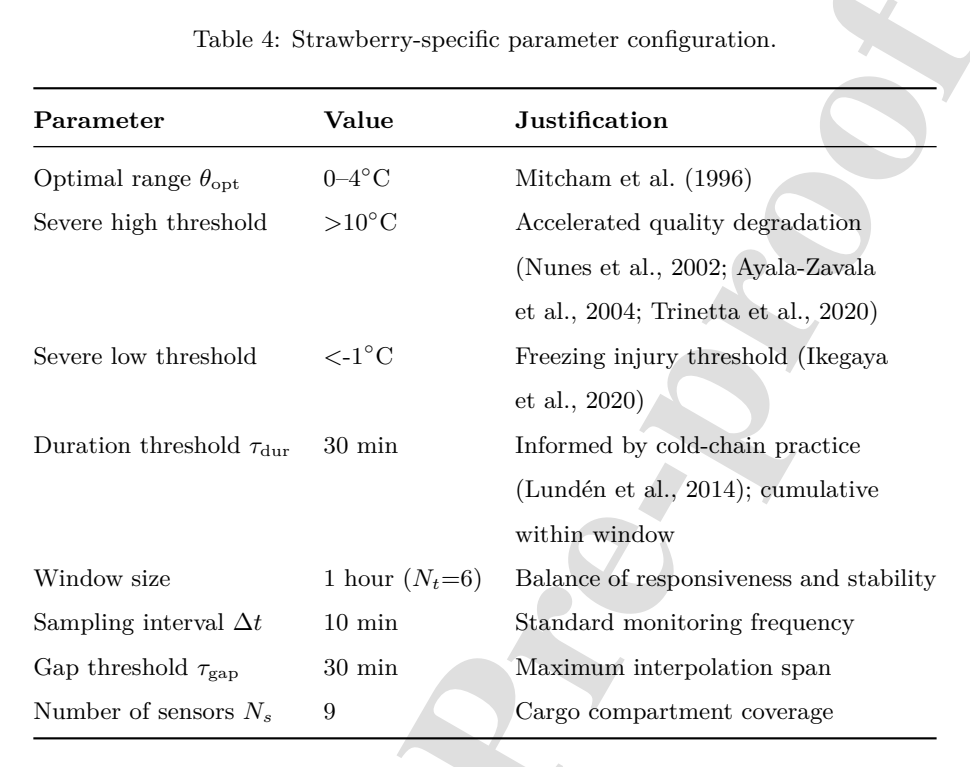
草莓适宜温区设为0至4摄氏度,参数表同时给出偏差、持续时间、采样间隔、分析窗口和传感器数量。来源:Table 4
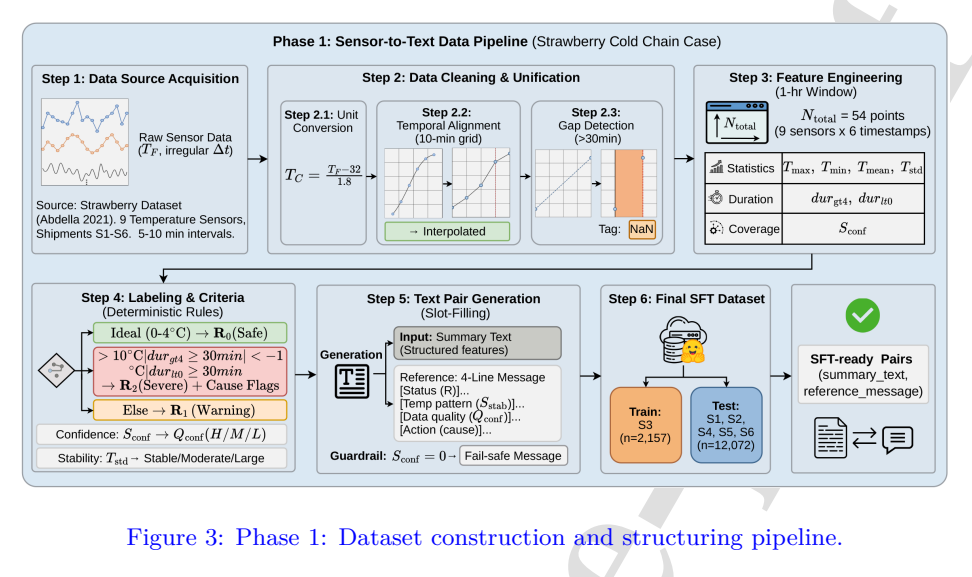
九点温度记录经过清洗、时间对齐、窗口化、特征计算、规则标注和文本格式化后形成SFT样本。来源:Figure 3
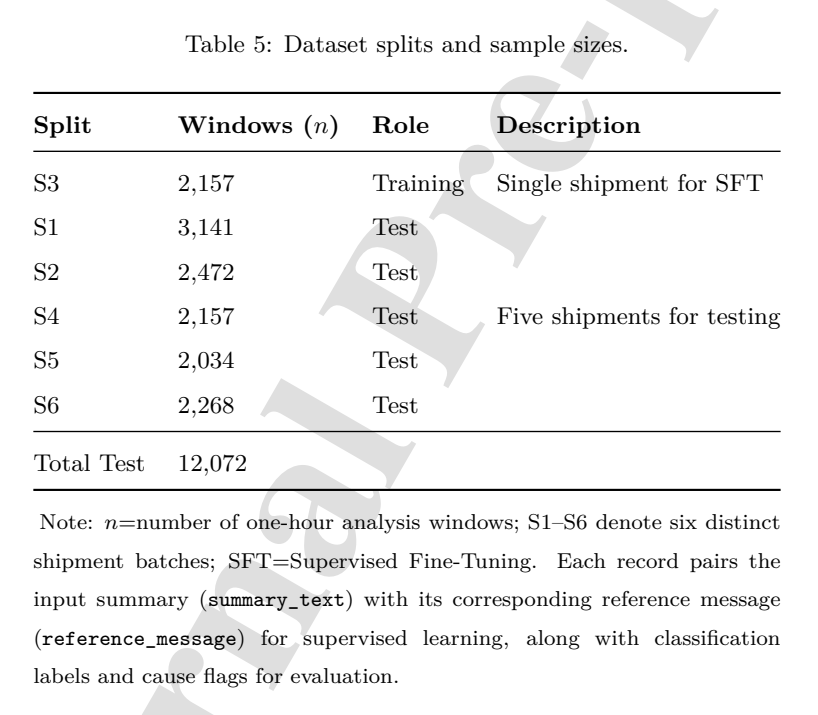
模型使用S3运输批次训练,并在S1、S2、S4、S5、S6五个完整批次上测试,测试集共含12072个一小时窗口。来源:Table 5
每个一小时窗口包含六个时间点和九个传感器位置,理论上形成54个数据点。训练与测试按照完整运输批次划分,可以隔离同一批次相邻窗口之间的高度相关性。论文采用单个批次训练、五个未见批次测试的保守设置,用于检验固定四槽生成任务能否适应新的运输轨迹与风险演化过程。
0.6B模型如何学习固定规则映射
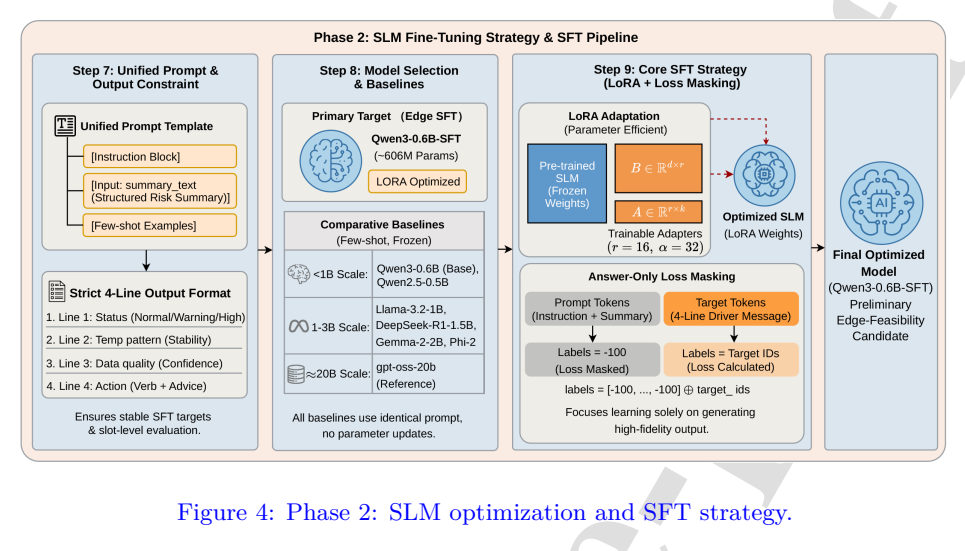
Qwen3-0.6B通过LoRA监督微调和仅答案损失掩码学习四行结构化消息任务。来源:Figure 4
训练输入是由实际传感器特征确定性生成的摘要文本,目标是专家规则模板形成的四行参考消息。LoRA只更新低秩适配参数,仅答案损失掩码让优化集中在回复内容。推理阶段还会抽取首个完整四行消息并删除额外生成内容;数据覆盖不足时,系统跳过模型推理并返回固定安全提示。
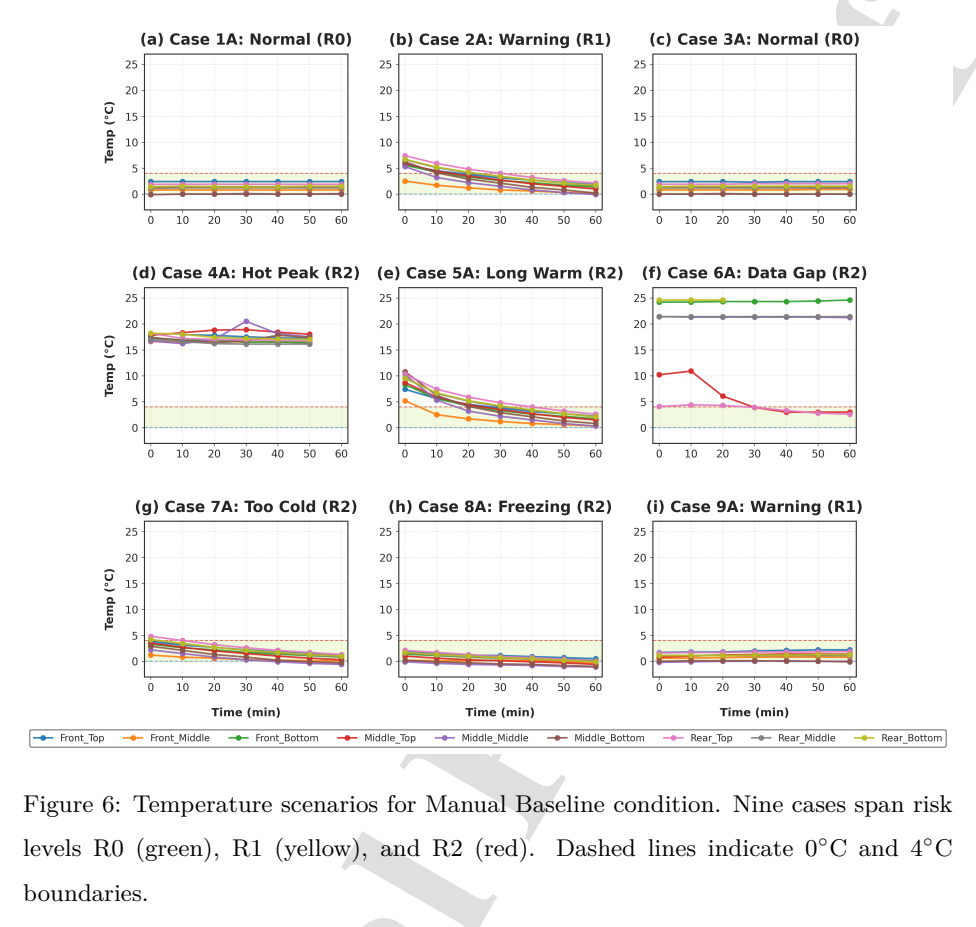
实验以正常、升温、降温、冻结和波动等温度情景检验规则响应,虚线标示0摄氏度和4摄氏度边界。来源:Figure 6
这些温度轨迹用于验证告警规则和人机界面,论文未将其作为未来温度预测性能曲线。
规则复现、专家评分与操作体验
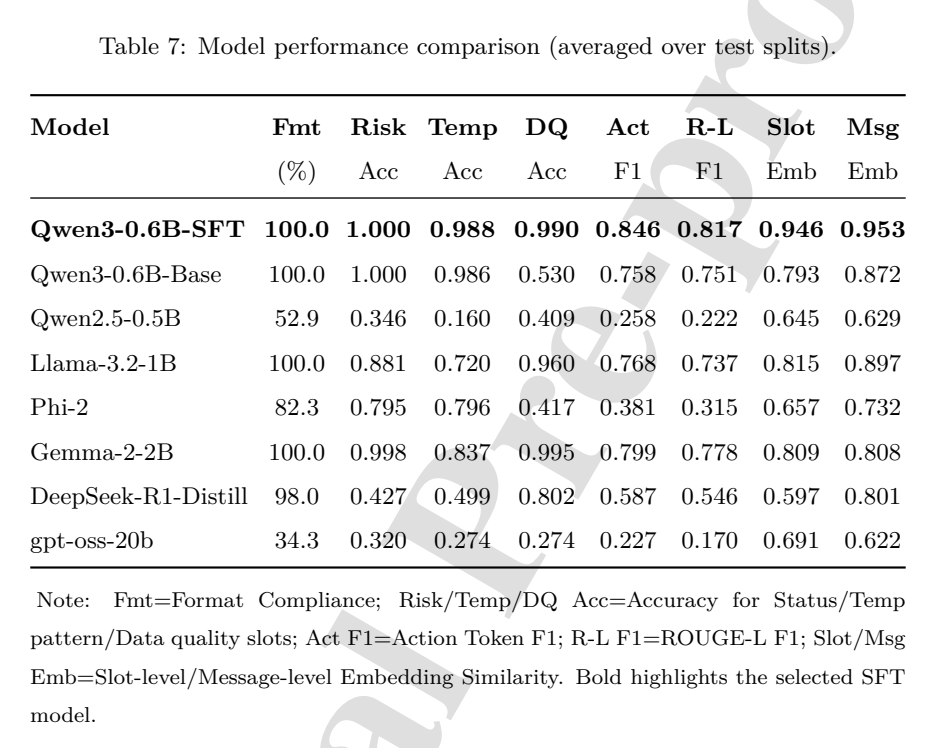
微调模型在五个独立测试批次上实现100%格式合规、1.000风险准确率和0.953消息嵌入相似度。来源:Table 7
数据质量槽位准确率
0.990
基础Qwen3-0.6B为0.530,微调后提高0.460
动作文本F1
0.846
基础Qwen3-0.6B为0.758,微调后提高0.088
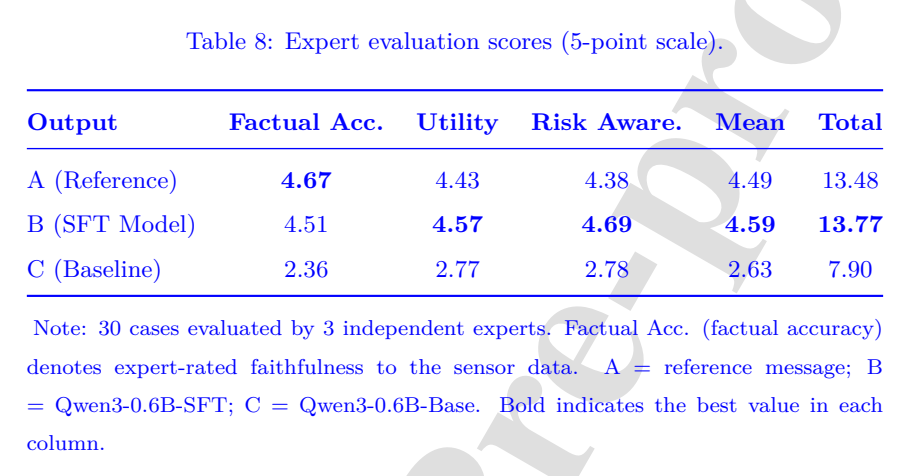
三名冷链专家对30个案例评分,微调模型总均分为4.59,风险意识为4.69,实用性为4.57。来源:Table 8
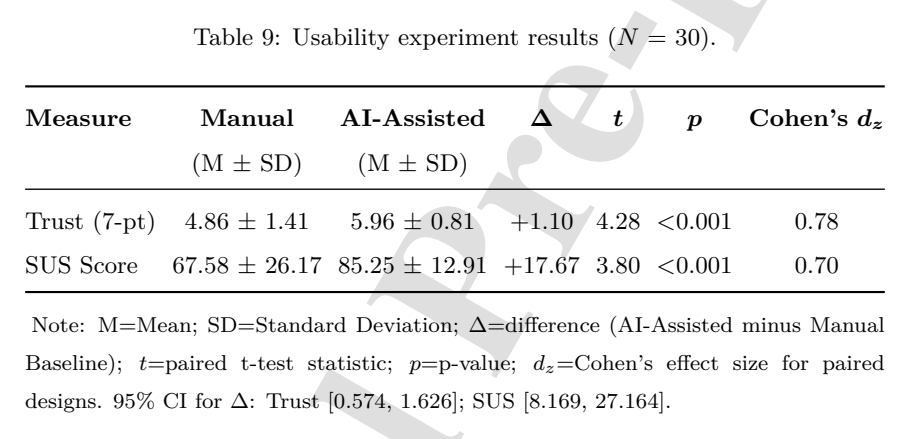
30名参与者的交叉实验显示,AI辅助条件下信任评分增加1.10分,SUS增加17.67分,两项差异均为p小于0.001。来源:Table 9
专家评价覆盖事实准确性、实用性和风险意识三个维度。微调模型总体得分13.77,高于参考消息的13.48和基础模型的7.90;其事实准确性为4.51,参考消息为4.67。可用性研究采用被试内平衡交叉设计,30名持有效驾照的参与者分别体验交通灯风险界面和附带四行说明的AI辅助界面。
边缘部署适用条件与研究边界
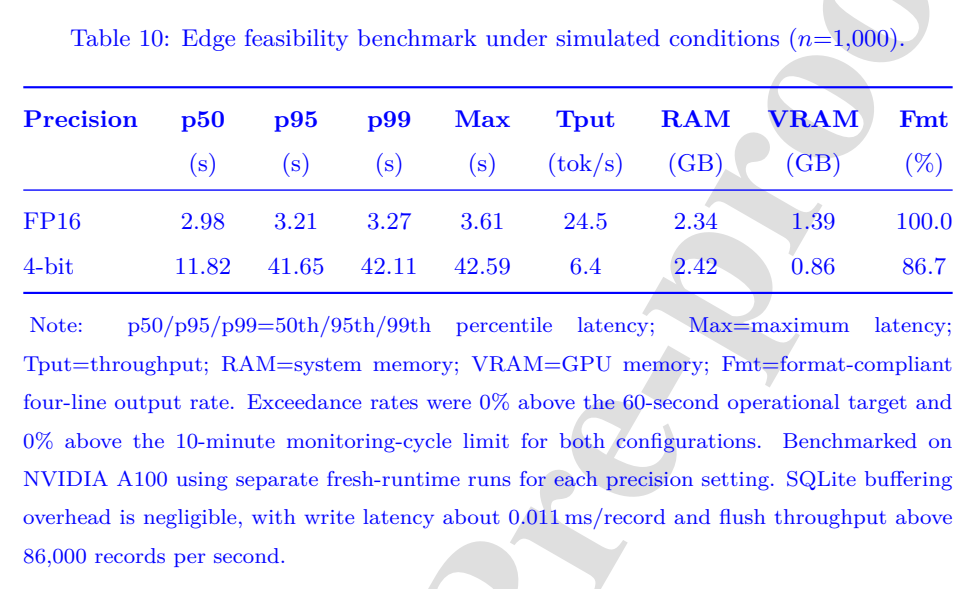
FP16与4位量化配置的边缘可行性基准覆盖延迟分位数、吞吐量、内存占用和格式合规率。来源:Table 10
论文在A100 GPU上对1000个样本开展模拟边缘测试,摘要报告推理延迟为3.0秒,显存占用为1.39 GB,耗时低于十分钟采样周期的1%。这组结果说明推理循环能够进入当前监测节拍。测试设备属于模拟环境,论文未报告在真实冷藏车边缘网关上的延迟、功耗、热稳定性和长期离线运行结果。
✓产品范围:实证案例仅覆盖草莓及其0至4摄氏度温区,其他食品和药品需要重新配置规则与阈值。
✓模型范围:SLM复现确定性风险映射并生成说明,论文未评估货品剩余寿命或未来温度预测。
✓数据范围:训练数据来自一个运输批次,跨地区、季节、车辆和设备型号的表现尚未报告。
✓人因范围:参与者通过便利抽样招募,平均年龄26.57岁,真实职业驾驶员群体的长期使用效果未报告。
✓部署范围:边缘可行性来自A100模拟基准,量化模型在实际低功耗硬件上的性能仍需验证。
当前证据支持一项清晰结论:规则负责风险事实,小语言模型负责受约束的语言表达,边缘网关负责在监测周期内把两者交付给操作员。
论文:A human-centric decision support framework for edge-based cold chain transportation monitoring with small language models
作者:Hu Li,Özer Uygun,Xiaoqing Yu,Yehong Zhou,Zeru Yang,Chun-Hsien Chen
期刊:Computers & Industrial Engineering
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


