链上镖师 / Chain Biaoshi
TRE|混合航站空域应急无人机离场:APPO战术解冲突轨迹规划
在eVTOL计划航迹保持不变的前提下,让紧急UAV更安全、更快地离开航站空域
这篇论文把混合UAV-eVTOL航站空域里的紧急无人机离场建模为战术解冲突问题,用APPO训练一个兼顾出口方向、间隔安全和在线计算效率的轨迹规划策略。
- 01:场景来自未来AAM运行:eVTOL按既定航迹和MF时窗运行,紧急UAV需要立即从vertiport离开航站空域。
- 02:方法用20维本地状态、9个离散速度和航向动作、目标导航奖励、安全奖励和资源效率奖励训练APPO策略。
- 03:评估覆盖合成相遇几何和真实空域不同需求水平,并与APF、VO、RRT、Modified CL-RRT和MCTS-UCT对比。
研究背景
AAM和UAM把低空城市交通从单一地面网络扩展到空中层。eVTOL可承担空中出租车和城际快速出行,UAV可承担医疗物资、器官、血样等时间敏感物流任务。论文关注的压力点在vertiport周边:到离场航迹、公共走廊和计量点会把流量集中到局部航站空域。
在这种局部高密度区域,eVTOL通常由空管式战略调度提前安排,MF穿越时窗和四维航迹相对固定。紧急UAV任务具有即时出发需求,等待全局重规划会损失任务时效,因此需要一个能在既定eVTOL航迹旁边自主调整速度和航向的战术层。
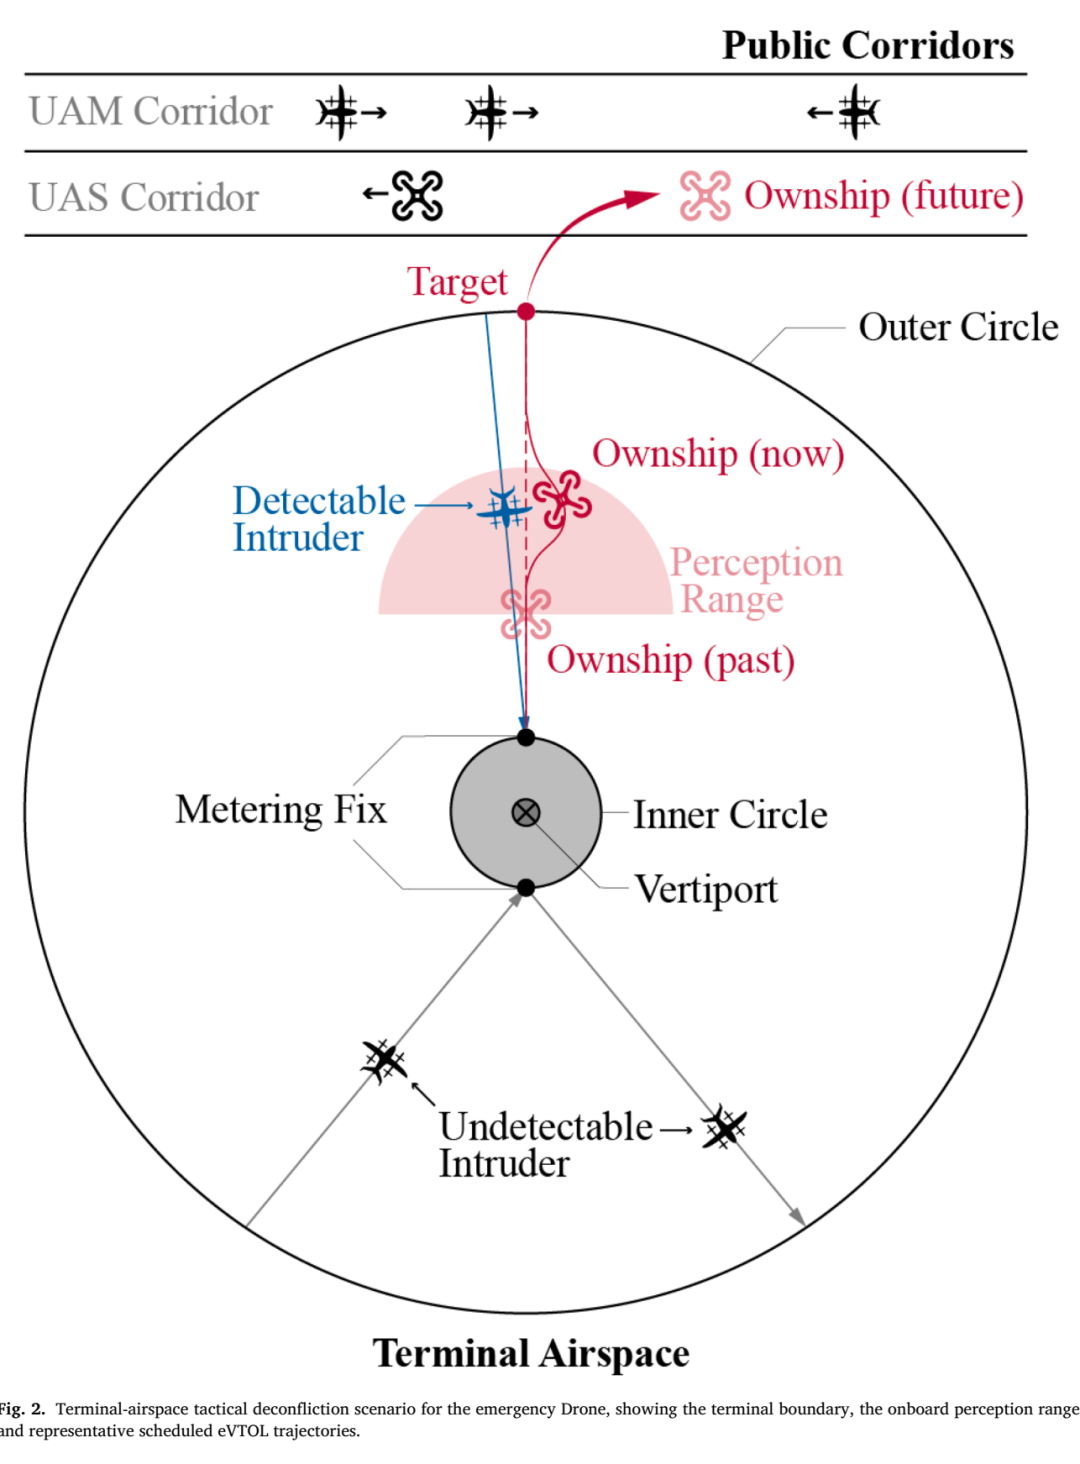
来源:Fig. 2。应急无人机在航站空域中的战术解冲突场景,把边界出口、感知范围和计划eVTOL航迹放在同一任务环境中。
论文的核心运行假设很清楚:eVTOL是高优先级、非协同、按计划飞行的交通流;紧急UAV是可本地机动的执行者,需要在不触发全局重排的条件下离开航站空域。
核心问题
作者把问题放在战略调度和末端防碰撞之间。战略层已经给eVTOL安排了vertiport、MF和公共走廊之间的时空资源,末端防碰撞安全网只处理最后时刻的危险。本文要解决的是中间的战术离场:UAV在有限感知范围内持续做局部决策。
战术策略的目标包含三个约束方向:尽快朝指定边界出口离开航站空域,避免与计划eVTOL发生MAC和NMAC,控制飞行资源消耗和在线计算成本。论文明确设定UAV水平感知范围为300米,NMAC阈值为150米,MAC阈值为10米。
NMAC阈值
150 m
低空UAM航站空域的近距冲突分界
MAC阈值
10 m
轴对齐包围盒安全模型中的碰撞分界
这个问题的难点来自不对称交通关系:eVTOL速度更高、任务优先级更高、航迹不配合改变;UAV速度更低、机动更灵活,需要靠自身感知和策略推理让出高风险空间。
方法框架
论文将无人机离场过程建模为MDP。每个决策步里,UAV读取自身运动状态、最多三架前向入侵eVTOL的相对状态、目标点和边界信息,策略输出速度和航向组合命令,再交给AirSim中的AirLib飞控模型执行低层响应。
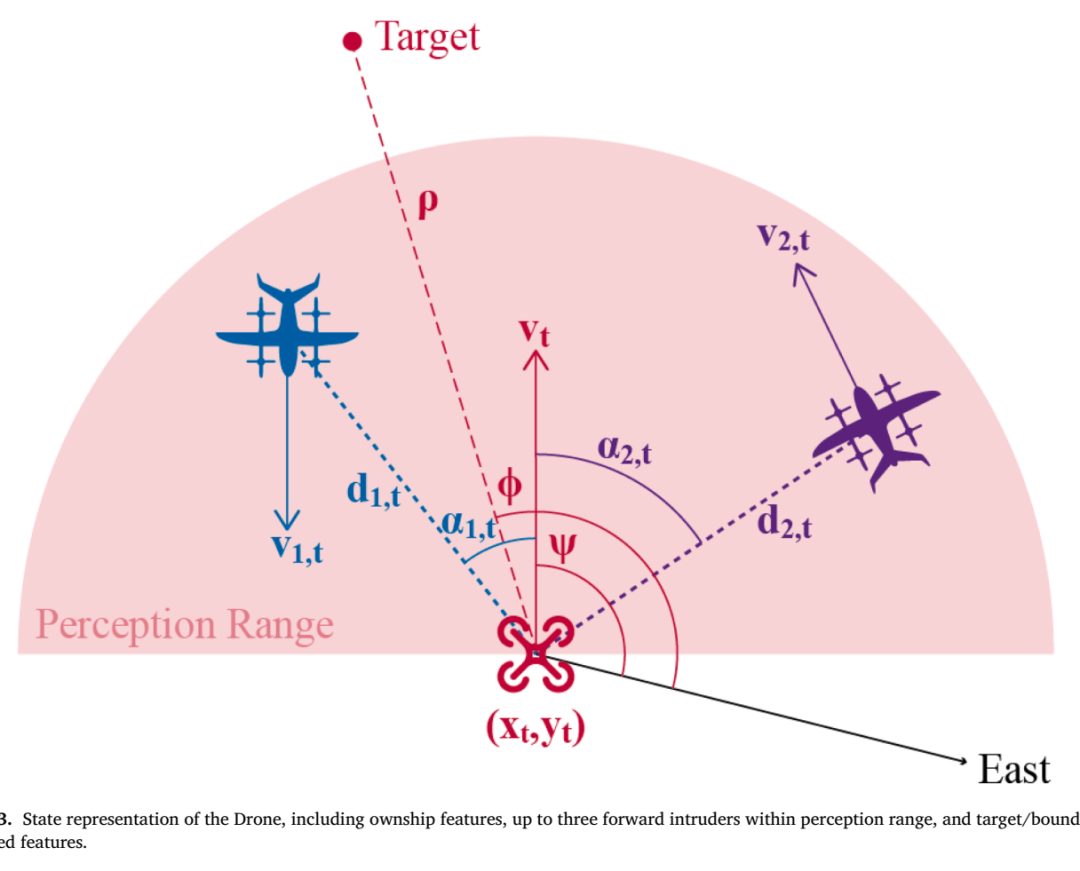
来源:Fig. 3。状态表示把自身、入侵机、目标与边界相关特征压缩为本地策略输入,是战术MDP的核心建模入口。
1感知:UAV在300米水平范围内识别周边eVTOL交通。
2编码:构造包含自身、目标、边界和最多三架前向入侵机的20维状态向量。
3决策:APPO策略网络输出9个离散速度和航向机动命令之一。
4执行:AirLib飞控模型模拟低层速度和航向响应,并进入下一决策步。
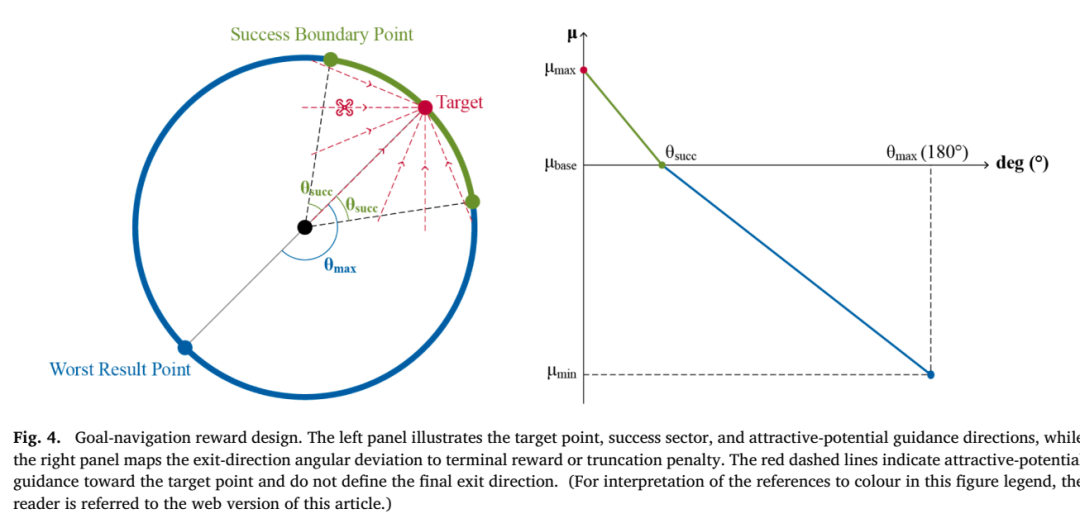
来源:Fig. 4。目标导航奖励将靠近目标点的过程奖励与出口方向终端奖惩结合,推动UAV以走廊对齐方式离开航站空域。
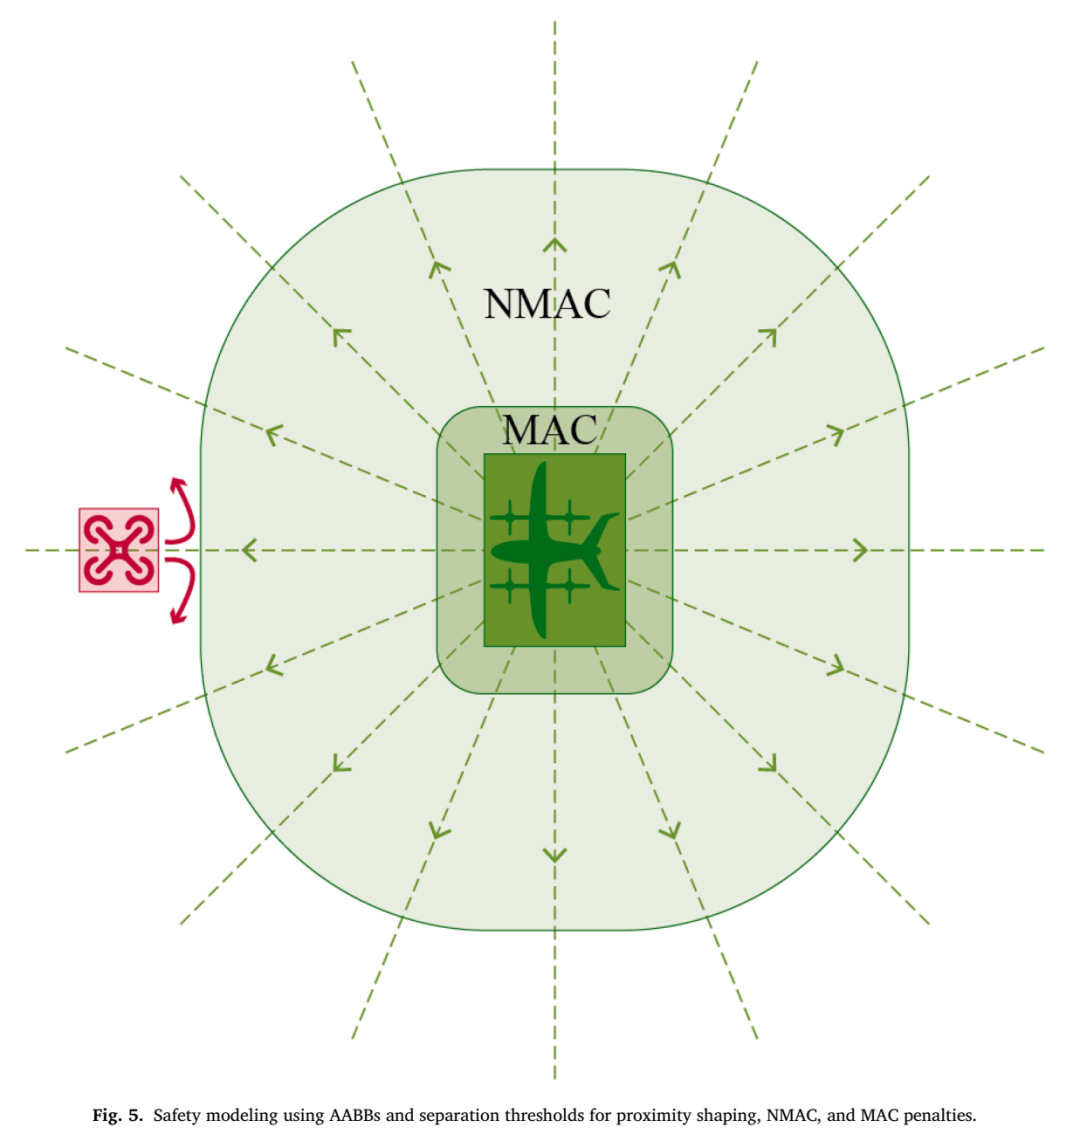
来源:Fig. 5。AABB安全包络把MAC、NMAC和接近势场统一到奖励函数中,给策略训练提供可解释的安全边界。
案例或实验设置
训练采用分阶段课程学习。策略先学习无冲突导航和基本离场,再进入单个迎头冲突、单个交叉冲突、混合几何冲突,最后处理多入侵机场景。最难阶段同时编码三架安全关键入侵机,与状态空间里的最大前向入侵机槽位一致。
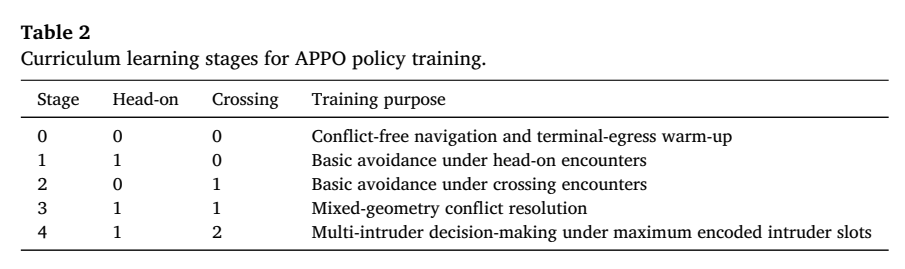
来源:Table 2。课程学习按五个阶段逐步加大冲突复杂度,从终端离场热身推进到最大编码入侵机槽位下的多目标决策。
评估分成两类:第一类是合成相遇几何,包括交叉、迎头以及交叉加迎头的混合场景;第二类来自真实空域交通数据,按低、中、高需求水平提取航站区域流量。每种场景构造30个独立仿真,所有规划器在同一交通实现上比较。
- 对照算法包括APF、VO、RRT、Modified CL-RRT和MCTS-UCT。
- 终止条件包括UAV离开航站空域、发生MAC或达到最大决策步数。
- NMAC在仿真过程中持续记录,用于衡量间隔维持能力。
结果分析
训练曲线显示出阶段性学习特征:早期走廊对齐成功率快速提高,课程切换到更难场景后,成功率和截断退出率会出现临时波动,随后策略在新的冲突几何和更高密度条件下继续收敛。碰撞率用于观察安全学习是否被复杂场景破坏。
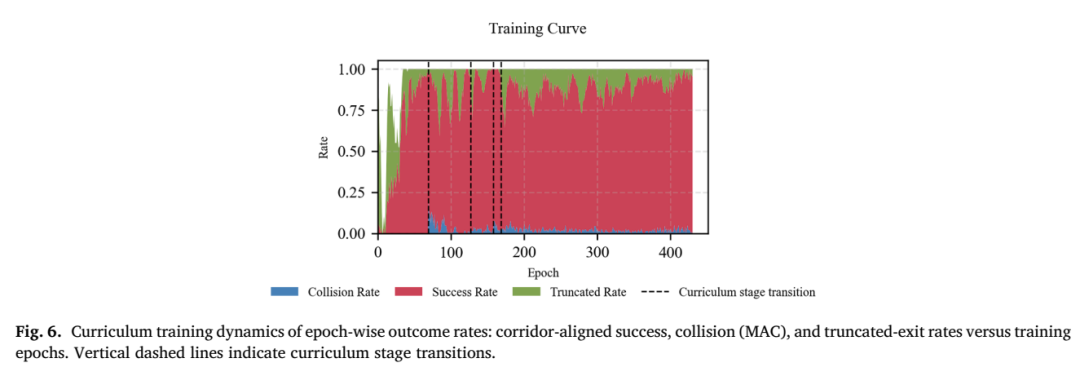
来源:Fig. 6。课程训练曲线展示走廊对齐成功、MAC和截断退出率随epoch变化,并用竖向虚线标出课程阶段切换。
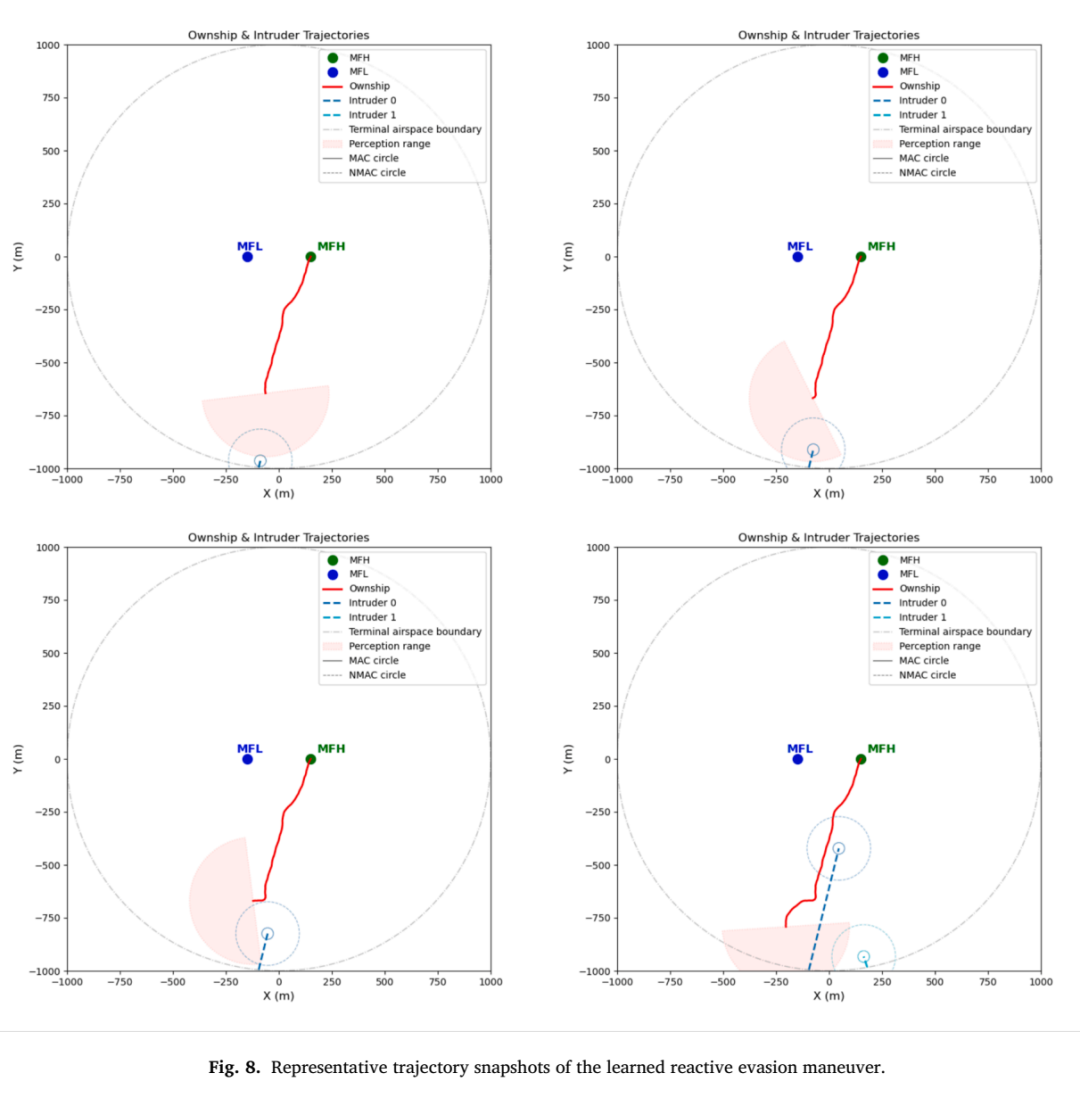
来源:Fig. 8。反应式规避轨迹显示,学习策略会在靠近局部高风险MF区域前调整路径,以减少进入NMAC易发区域的暴露。
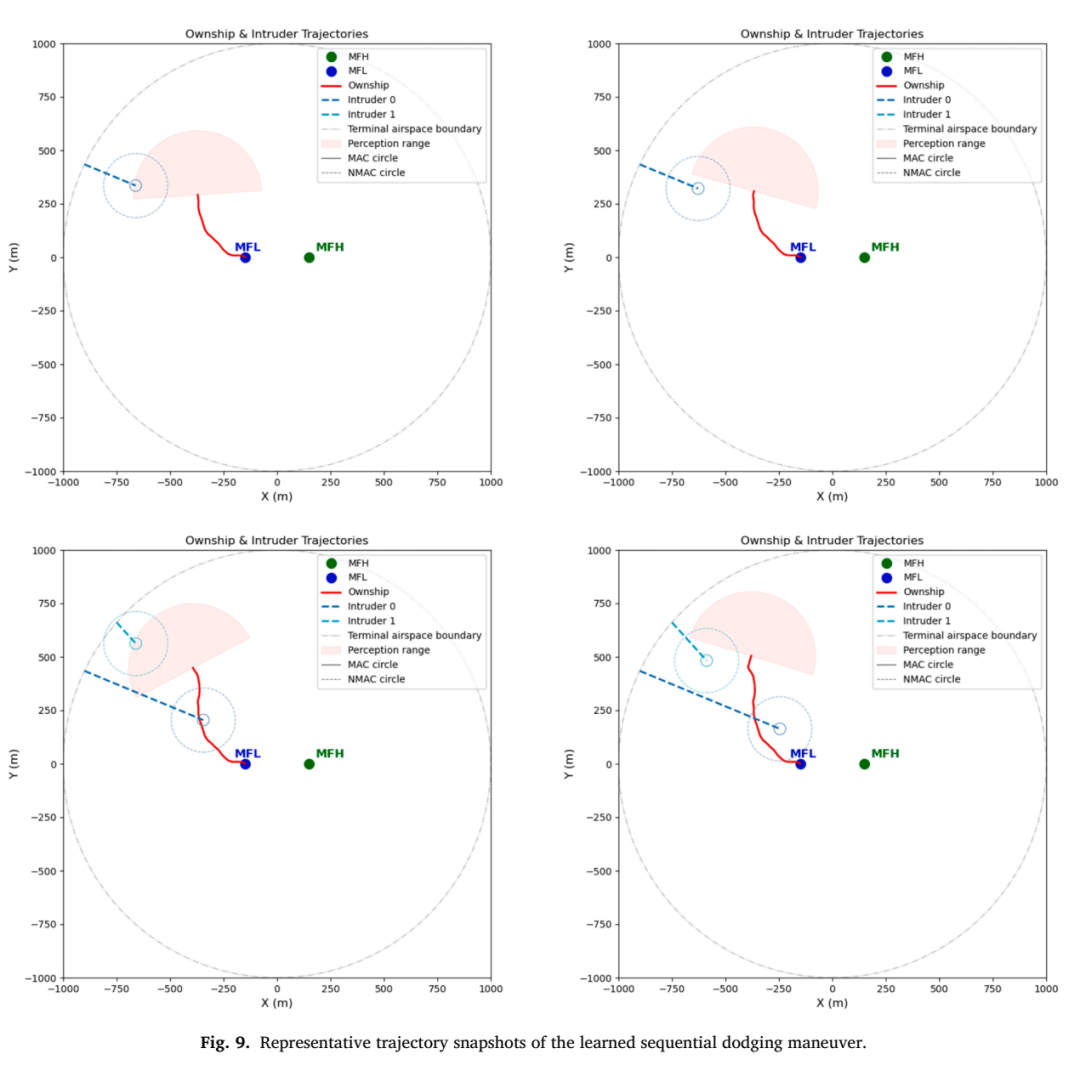
来源:Fig. 9。连续躲避轨迹展示策略在多个相继入侵机出现时进行时序化速度和航向调整,体现多目标冲突下的局部协调。
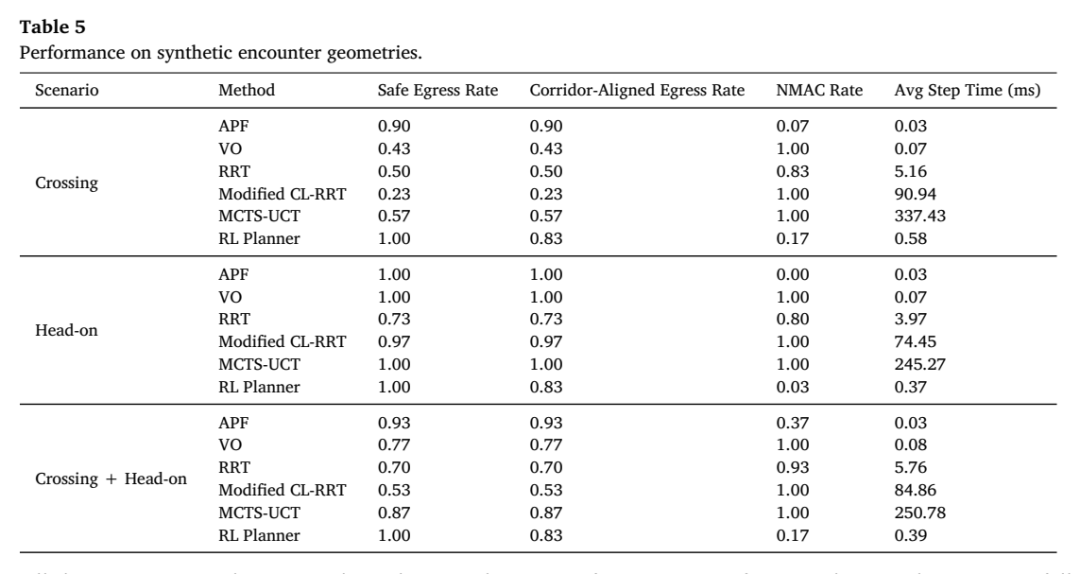
来源:Table 5。合成相遇几何结果按crossing、head-on和mixed场景比较安全退出率、走廊对齐率、NMAC率和平均单步计算时间。
管理启示
从运行管理角度看,论文给出的方案适合充当战略调度之后的本地战术层。MF时窗和eVTOL四维轨迹仍由上层系统维护,紧急UAV只在水平离场层根据感知到的周边交通做速度和航向微调,从而减少对既定客运或高优先级航班的扰动。
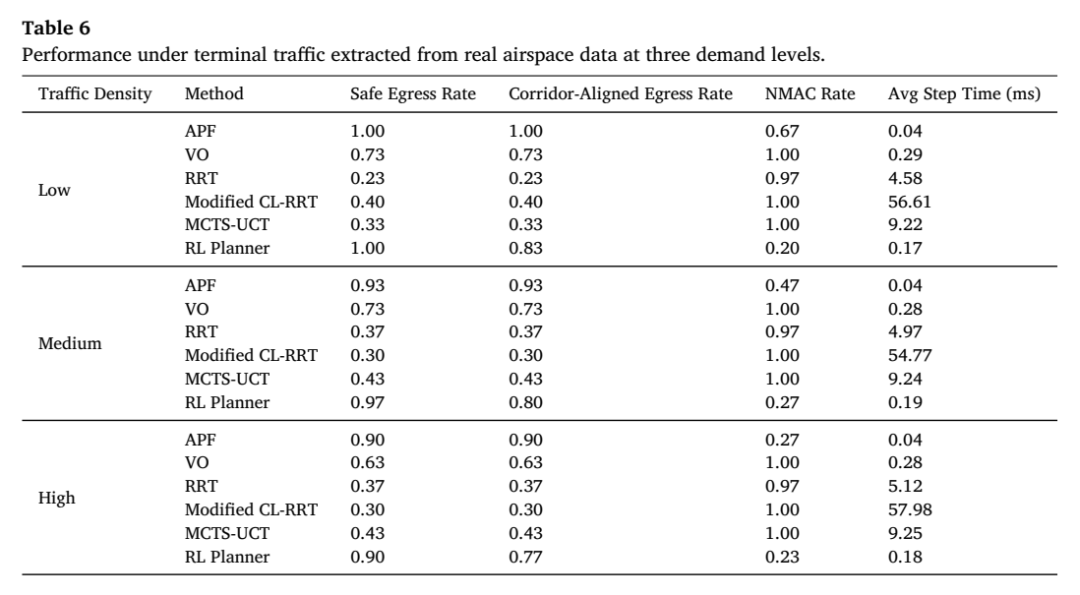
来源:Table 6。真实空域低、中、高需求水平结果用于观察方法在运营压力变化中的安全边际、走廊对齐能力和在线实时性。
这类策略对AAM运营的价值在于分层治理:计划流量继续依靠MF时窗和走廊组织,应急任务交给轻量策略网络完成本地推理。论文说明,部署时不需要把完整仿真平台和分布式训练系统放到UAV上,只需运行训练后的轻量多层感知机。
在线状态
20维
部署时由本地感知构造的紧凑状态向量
机动命令
9类
策略前向推理后输出的离散速度和航向组合
论文结论指向一个实用边界:在混合航站空域中,紧急UAV离场可以通过学习型战术策略承担局部解冲突任务,同时保留eVTOL战略时刻表和MF资源管理的稳定性。
论文:Learning-based emergency egress trajectory planning for UAV in mixed terminal airspace
作者:Lichen Su,Shulu Chen,Yuhao Wang,Leyan Chen,Zhiheng Li,Kai Wang,Xiaobo Qu
期刊:Transportation Research Part E
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


