链上镖师 / Chain Biaoshi
TRE|城市空中交通战术解冲突:LLM辅助MARL策略推荐模型
用大语言模型生成奖励权重候选、训练策略库,再按运营偏好推荐安全、效率或平顺性取向的空中交通管理策略
论文面向城市空中交通战术解冲突,把LLM用于离线奖励权重探索和运营偏好到MARL策略的推荐,降低人工调参成本,并让安全、效率、平顺性取舍更容易被操作员表达和调用。
- 01:研究对象是UAM航空器之间的战术解冲突,MARL策略负责实时速度建议,目标是在NMAC和LoWC约束下兼顾飞行时间与速度变化次数。
- 02:LLM用于离线生成奖励权重候选,并在决策支持层根据自然语言偏好推荐预训练策略,实时控制回路仍由训练后的MARL策略执行。
- 03:实验展示了最快、安全优先、舒适优先三类偏好对应的模型选择和指标差异,证明框架具备偏好映射和策略库调用的可行性。
研究背景
城市空中交通把短途出行从地面扩展到低空航路,安全间隔成为规模化运营的前提。论文延续作者此前的UAM冲突管理研究,将战略层的需求容量平衡与战术层的学习型解冲突连接起来,关注航空器在运行中如何通过速度建议保持安全距离。
现有MARL方法已经能为每架航空器生成实时速度调整建议,训练过程依赖奖励函数和超参数。UAM场景的运营优先级会随空域、任务和服务要求变化,安全裕度、飞行时间、速度变化次数之间需要可解释的权衡,手工调参成本由此上升。
本文的关键设定是让LLM承担奖励权重探索和模型推荐工作,实时战术控制仍由经过仿真评估的MARL策略完成。这个分层设计把语言模型放在决策支持层,降低安全关键控制链路中的不确定性。
核心问题
论文要解决的问题可以概括为:当UAM操作员用自然语言表达任务偏好时,系统怎样把这些偏好转成可执行的战术解冲突策略。输入可能是“最快抵达”“强风雨下更保守”“乘客更舒适”,输出需要对应到已训练策略及其安全、效率和平顺性指标。
01安全指标包括NMAC和LoWC,分别对应150米以内的关键安全违规和500米以内的安全裕度降低事件。
02效率指标用飞行时间衡量,反映航空器在空中停留时长和战术解冲突策略带来的运行效率。
03平顺性用速度变化次数近似表示,速度调整越频繁,乘坐舒适性和操作稳定性压力越大。
作者特别限定了LLM的作用边界。天气等自然语言提示用于测试偏好解释能力,论文没有在MARL状态、奖励、仿真动力学或评价指标中显式建模天气扰动。因此相关结果代表偏好到策略的映射能力,不能解读为物理天气场景下的性能验证。
方法框架
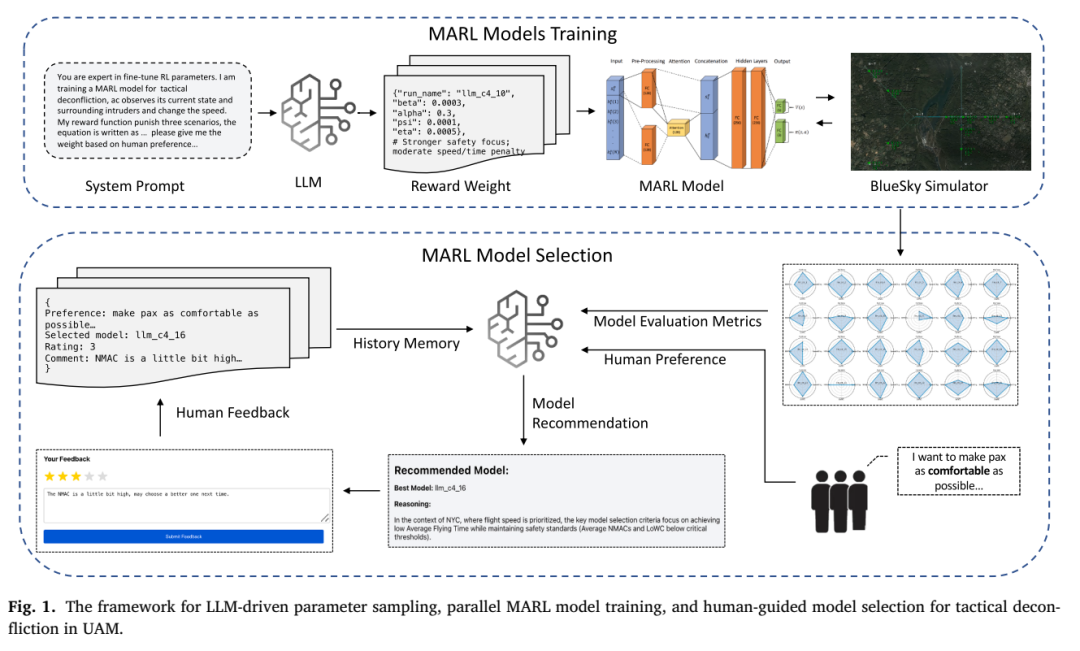
来源:Fig. 1。LLM驱动奖励参数采样、并行MARL训练与人类偏好模型选择框架。
框架先用LLM根据结构化提示生成多组奖励权重候选,再为每组权重训练对应的MARL策略,形成离线策略库。执行阶段不在线更新奖励权重,系统只根据操作员偏好和已评估指标,从策略库中推荐一个合适模型。
1描述UAM战术解冲突任务、奖励项和评价指标,向LLM提供可约束的参数生成语境。
2生成安全、效率、平顺性相关奖励权重候选,并并行训练多个MARL策略。
3用NMAC、LoWC、飞行时间和速度变化次数评价每个策略,建立可比较的策略库。
4第二个LLM读取自然语言偏好和指标表现,向操作员推荐预训练策略并给出选择依据。
MARL基础模型采用actor-critic结构,并用PPO式截断目标约束策略更新。每架航空器的状态包含到目标点距离、速度、航向和NMAC边界,对入侵航空器也构造类似状态;注意力机制把可变数量的入侵者状态聚合为固定长度输入。
案例或实验设置
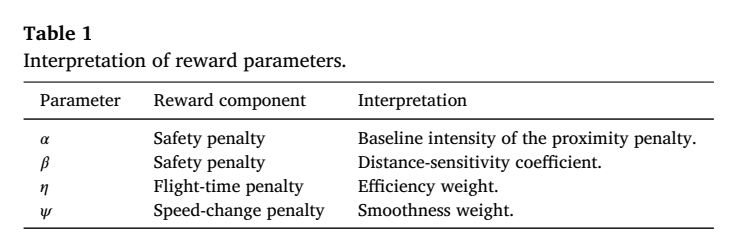
来源:Table 1。奖励参数及其对应的安全、效率和平顺性解释。
奖励函数围绕三类目标展开:安全惩罚、飞行时间惩罚和速度变化惩罚。安全项由α和β控制强度与距离敏感性,η对应效率权重,ψ对应速度变化惩罚。论文设定NMAC边界为150米,LoWC边界为500米。
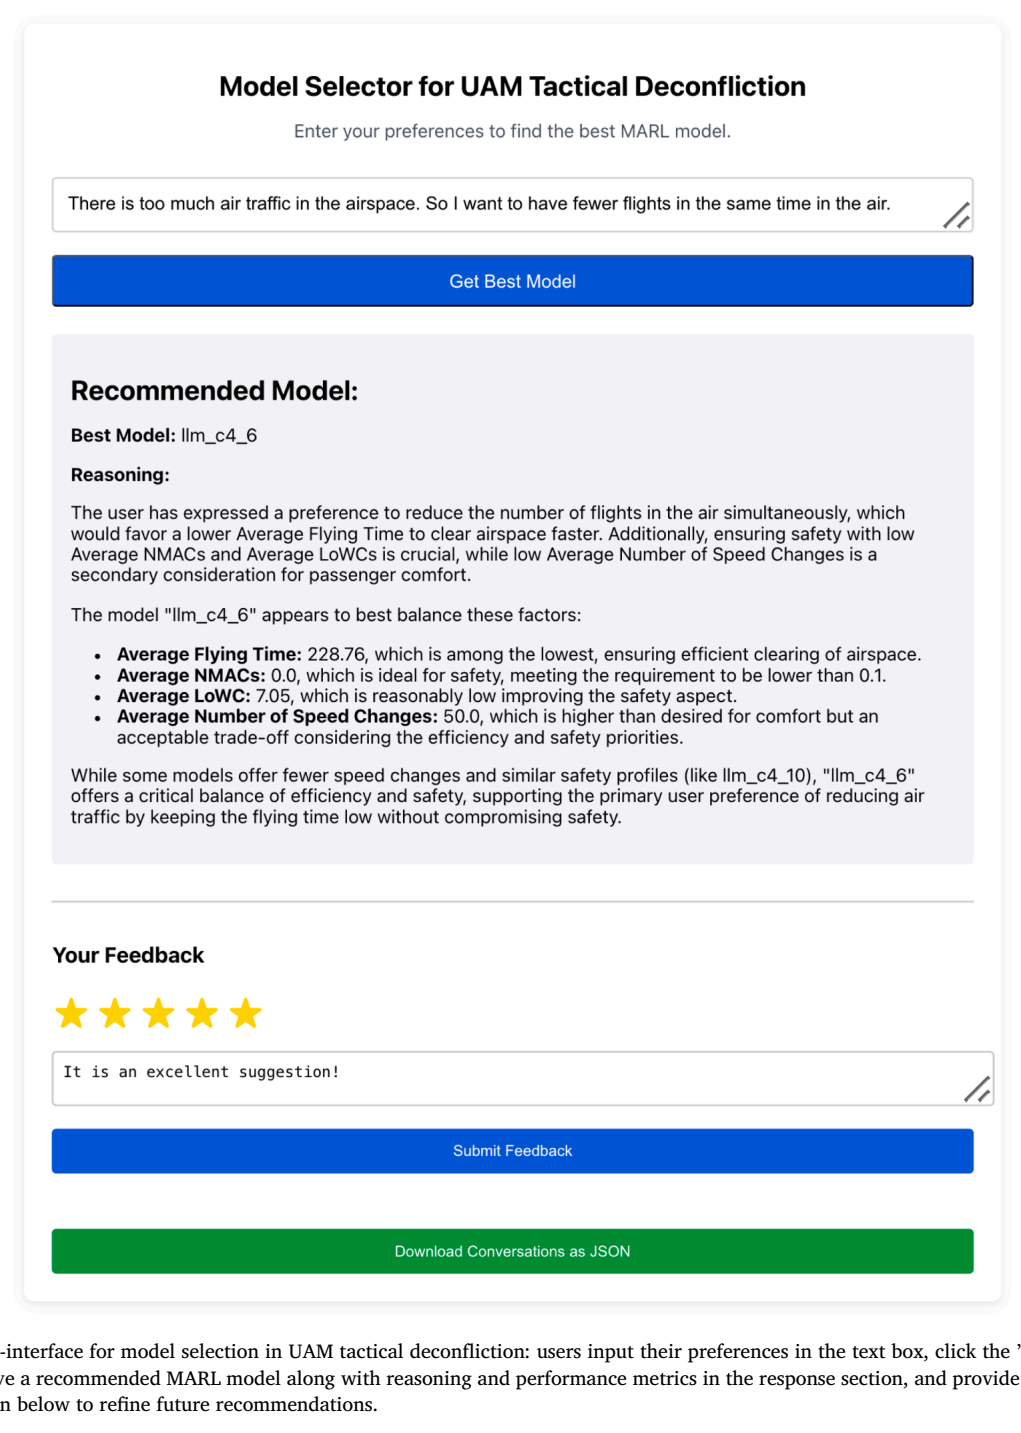
来源:Fig. 3。UAM战术解冲突模型选择的人机交互界面。
界面面向ATM或UAM运营决策者,例如交通管理主管、机队运营方和调度员。用户输入任务层或系统层偏好,系统展示推荐模型、理由和性能指标,并收集反馈作为历史记忆模块输入,用于后续推荐调整。
结果分析
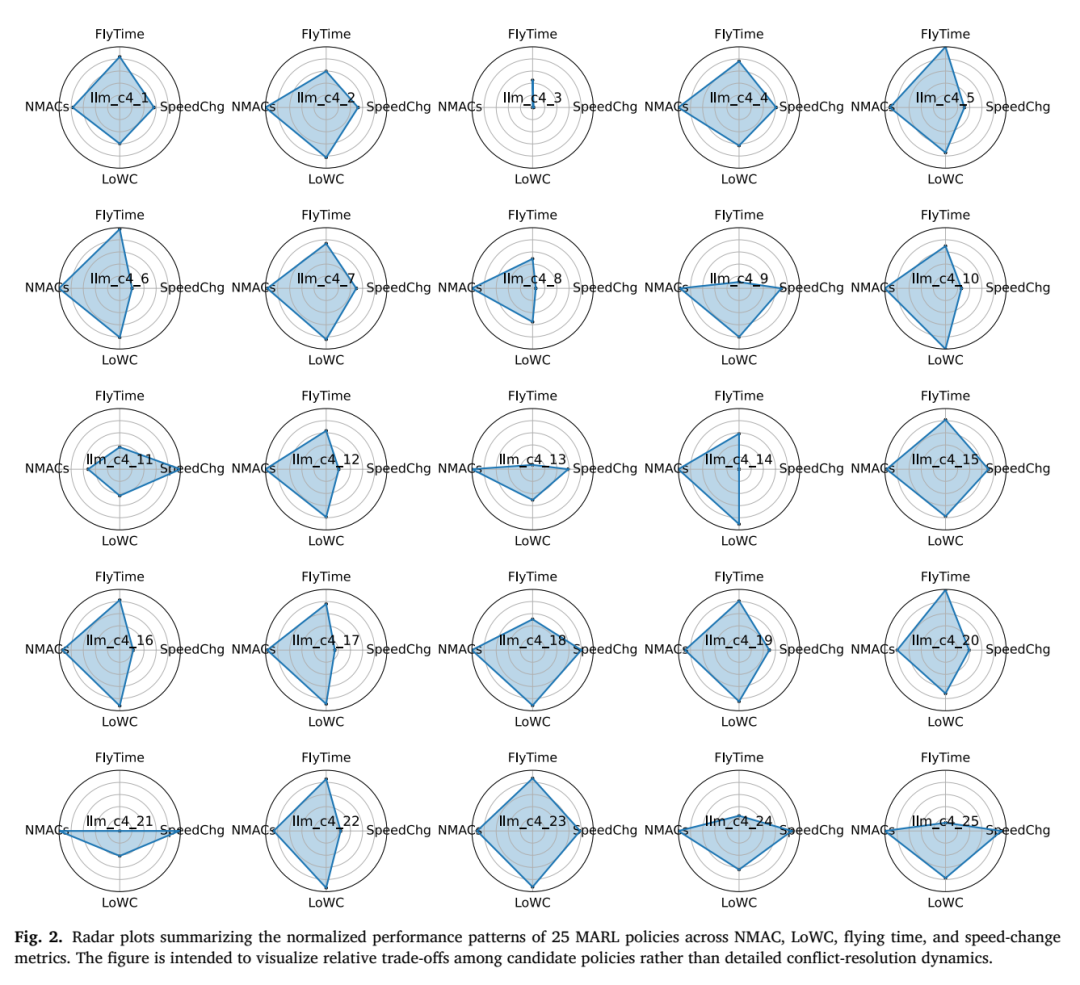
来源:Fig. 2。25个MARL策略在NMAC、LoWC、飞行时间和速度变化指标上的归一化表现。
作者用25个MARL策略构成候选库,并对NMAC、LoWC、飞行时间、速度变化次数做对数变换和反向归一化。由于四项指标数值越低越好,归一化后分数越高代表表现越优,雷达图用于展示候选策略之间的取舍空间。
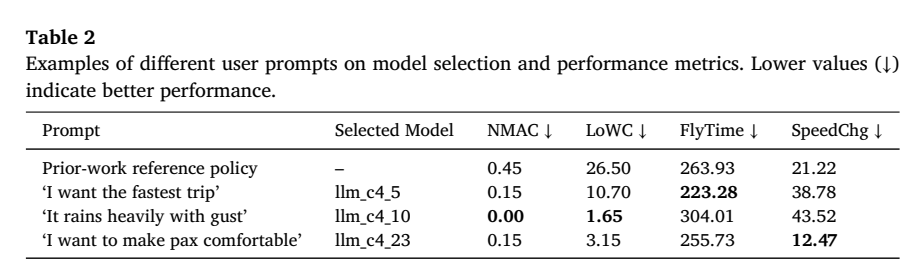
来源:Table 2。不同用户提示下的推荐模型与NMAC、LoWC、飞行时间、速度变化指标。
最快偏好
llm_c4_5
飞行时间为223.28,NMAC为0.15,LoWC为10.70,速度变化次数为38.78。
舒适偏好
llm_c4_23
速度变化次数为12.47,NMAC为0.15,LoWC为3.15,飞行时间为255.73。
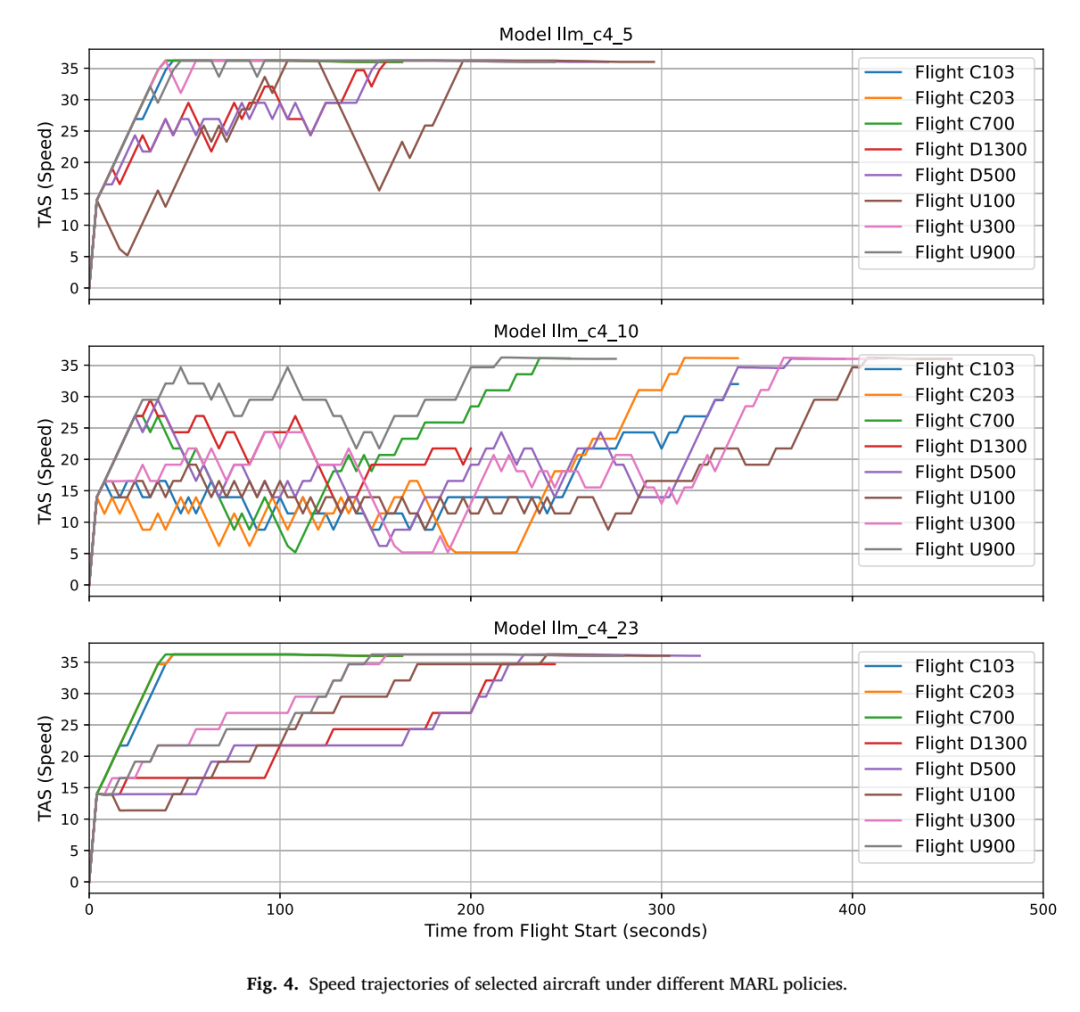
来源:Fig. 4。不同MARL策略下代表性航空器的速度轨迹。
管理启示
对低空交通管理者来说,这项研究提供了一种把运营语言转成策略选择的接口。调度员无需直接指定奖励权重,可以用“更快”“更安全”“更平顺”等任务偏好触发模型推荐,再结合NMAC、LoWC、飞行时间和速度变化次数理解取舍。
✓安全优先任务可关注NMAC和LoWC表现,示例中“强风雨”提示对应llm_c4_10,NMAC为0.00,LoWC为1.65。
✓效率优先任务可关注飞行时间,示例中“最快旅行”提示对应llm_c4_5,飞行时间为223.28。
✓舒适优先任务可关注速度变化次数,示例中“乘客舒适”提示对应llm_c4_23,速度变化次数为12.47。
论文的贡献在于证明LLM可以辅助奖励权重探索和偏好条件化模型推荐,当前结果属于概念验证。作者没有给出与手工调参、随机搜索、贝叶斯优化、消融实验或统计显著性检验的系统比较,后续应用仍需要更完整的基准评估。
系统落地时,LLM适合承担策略库检索、偏好解释和推荐说明,安全关键的速度建议仍由经过训练和仿真评估的MARL策略生成。这样的架构让运营偏好表达更自然,也保留了对控制策略进行离线验证和指标审查的空间。
论文:Adaptive air traffic management via large language model augmented reinforcement learning
作者:Shulu Chen,Amin Tabrizian,Peng Wei,Yuhao Wang,Xiaobo Qu
期刊:Transportation Research Part E
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


