链上镖师 / Chain Biaoshi
TRC|驾驶人风险容忍下的轨迹规划:人机协同优化框架
用多方向感知风险与RTA-SAC,把辅助驾驶轨迹调到更贴近个人偏好的安全区间
这篇TRC论文把驾驶员风险容忍度量化成轨迹规划的输入,用RTA-SAC生成更贴近个体偏好的变道轨迹,并在人机协同测试中提升协同持续时间和安全性。
- 01:研究对象是L2人机协同驾驶中的变道轨迹规划,重点处理机器规划轨迹与驾驶员期望轨迹不一致引发的冲突。
- 02:方法先用多方向驾驶员风险场和车辆风险场计算感知风险,再估计驾驶员风险容忍度上下限。
- 03:实验显示,规划轨迹在保证安全边界的同时更贴近个人偏好,驾驶人在环测试中协同持续时间至少提升54.24%,安全性最高提升78.39%。
研究背景
L2人机协同驾驶把机器的快速响应和驾驶员的环境理解放在同一个控制闭环中。论文指出,协同效果取决于人和系统是否朝着相近的轨迹目标工作;当自动系统规划的路径明显偏离驾驶员预期,驾驶员需要额外修正车辆,规划层面的冲突会直接传导到控制层和安全体验。
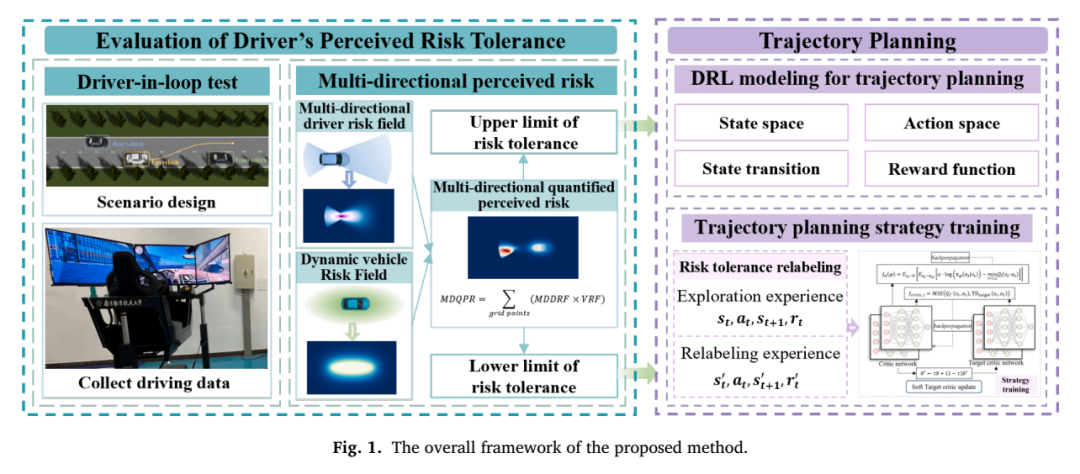
来源:Fig. 1,考虑驾驶员风险容忍度的人机协同轨迹规划总体框架。
这篇论文的核心任务是把“驾驶员能接受多大风险”提前放进轨迹规划,而非等到控制层再补救冲突。研究主线包括风险容忍度评估、RTA-SAC规划策略训练,以及驾驶人在环验证三个部分。
核心问题
论文讨论的场景是双车道道路中的跟车与变道。自车前方有慢车,后方有来车,驾驶员需要在继续跟车、加速变道、减速让行之间做选择。不同驾驶员面对同一前后车速度组合时,能接受的后车逼近风险不同,理想轨迹也会随之分化。
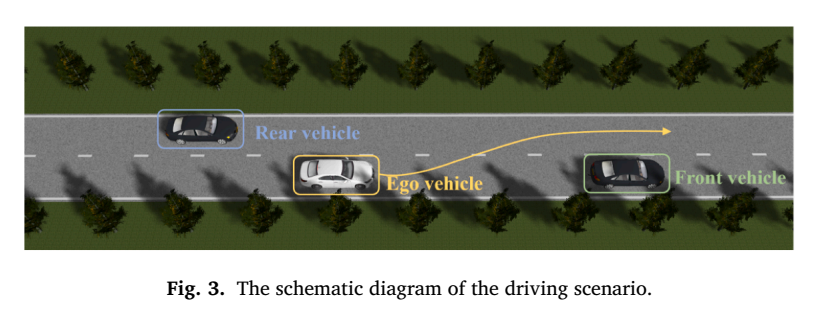
来源:Fig. 3,双车道变道实验场景示意图。
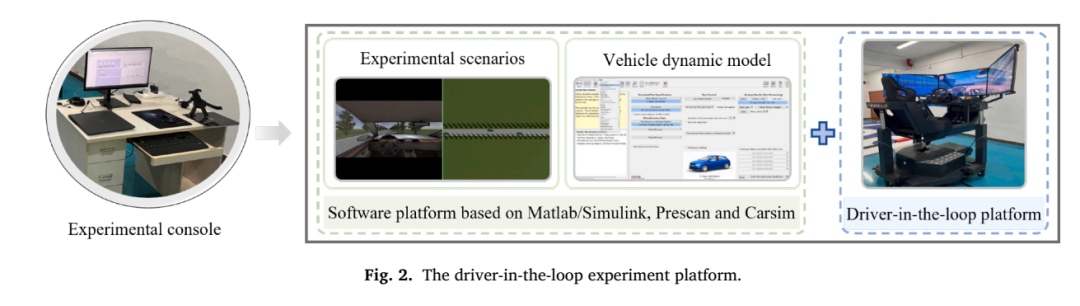
来源:Fig. 2,驾驶人在环实验平台。
01实验设计了11组风险逐步增加的场景,前车速度从15 m/s降到5 m/s,后车速度从5 m/s升到15 m/s,自车初始速度为14 m/s。
0210名驾驶员参与测试,包含5名男性和5名女性,驾龄从2年到12年,用于采集不同风险偏好的行为数据。
03每名驾驶员完成11个场景,每个场景重复三次,采集位置、速度、航向角和转向角等数据,采样间隔为0.01秒。
论文要解决的难点有两层:先把主观风险容忍度转成可计算变量,再让强化学习规划器在复杂驾驶偏好下快速收敛,并输出符合安全约束的连续轨迹。
方法框架
作者先建立多方向驾驶员风险场,用前向风险场描述驾驶员对前车与路径前方的感知,用后向风险场描述后视镜视野内后车逼近带来的感知。车辆风险场则用动态椭圆碰撞区表示不同速度和航向下的客观后果,两者逐点相乘并求和,形成多方向量化感知风险MDQPR。
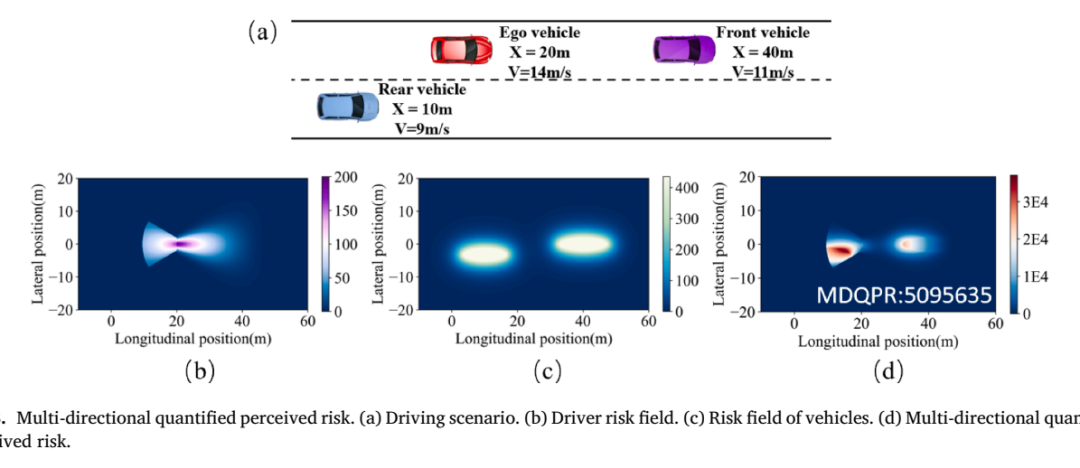
来源:Fig. 8,多方向量化感知风险的计算示例。
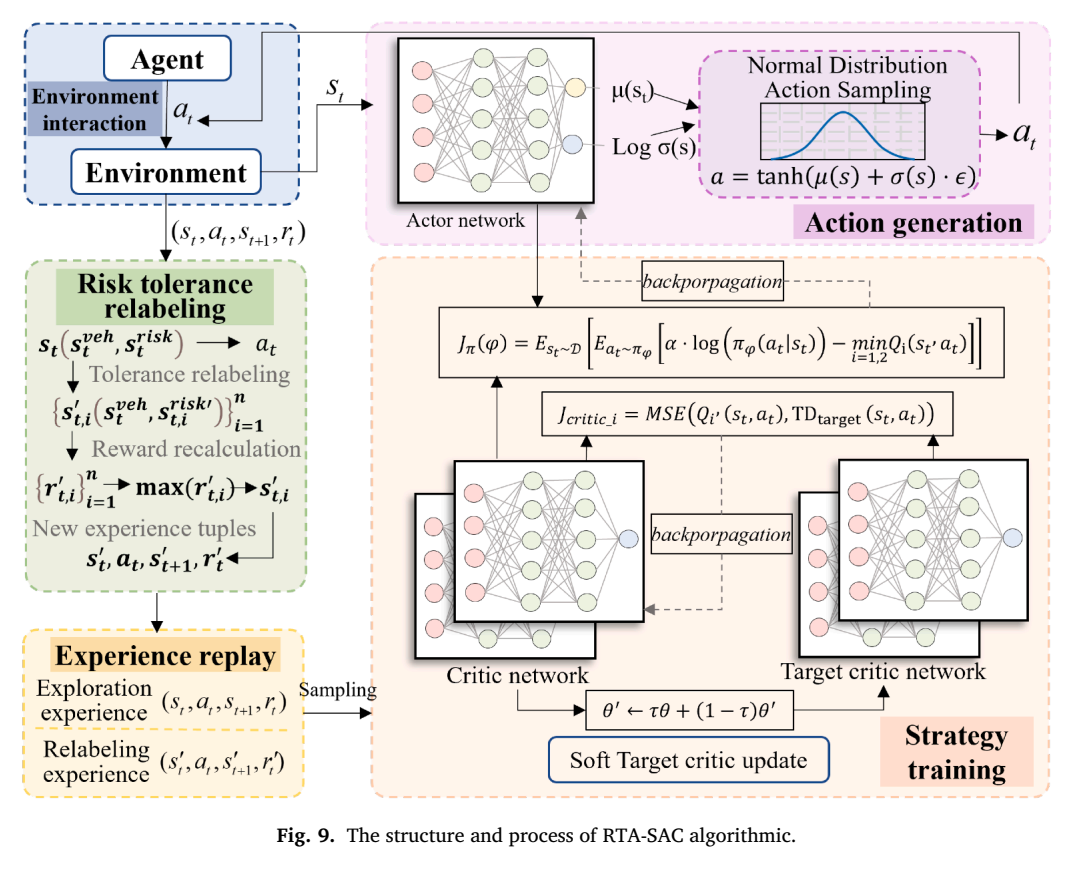
来源:Fig. 9,RTA-SAC算法结构与流程。
1用驾驶人在环数据计算每个时刻的MDQPR,识别从跟车转向变道、从变道转向减速让行的行为切换点。
2把最后一次可接受跟车的最大感知风险作为风险容忍度下限,把最后一次可接受变道的最大感知风险作为上限。
3在SAC框架中加入风险容忍度重标注模块,把高奖励经验写入回放池,帮助策略覆盖不同驾驶偏好。
4应用阶段加入安全检查模块,对可能违反TTC、道路边界或风险上限的动作进行最小修正。
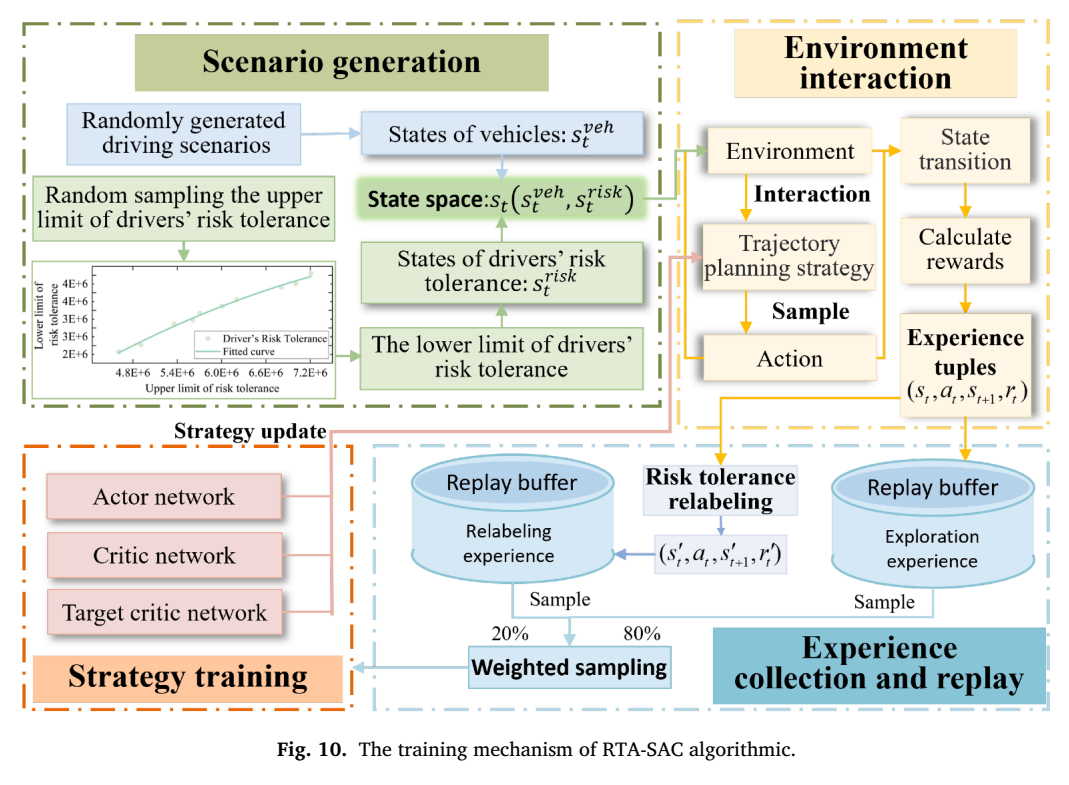
来源:Fig. 10,RTA-SAC轨迹规划模型训练机制。
案例或实验设置
训练阶段随机生成前后车位置、速度、航向和自车状态,并随机抽样驾驶员风险容忍度。论文用实验得到的风险容忍度上限范围进行采样,再通过上下限的二次多项式拟合关系推算下限,使模型在训练中接触保守、中间、激进等不同偏好的轨迹需求。
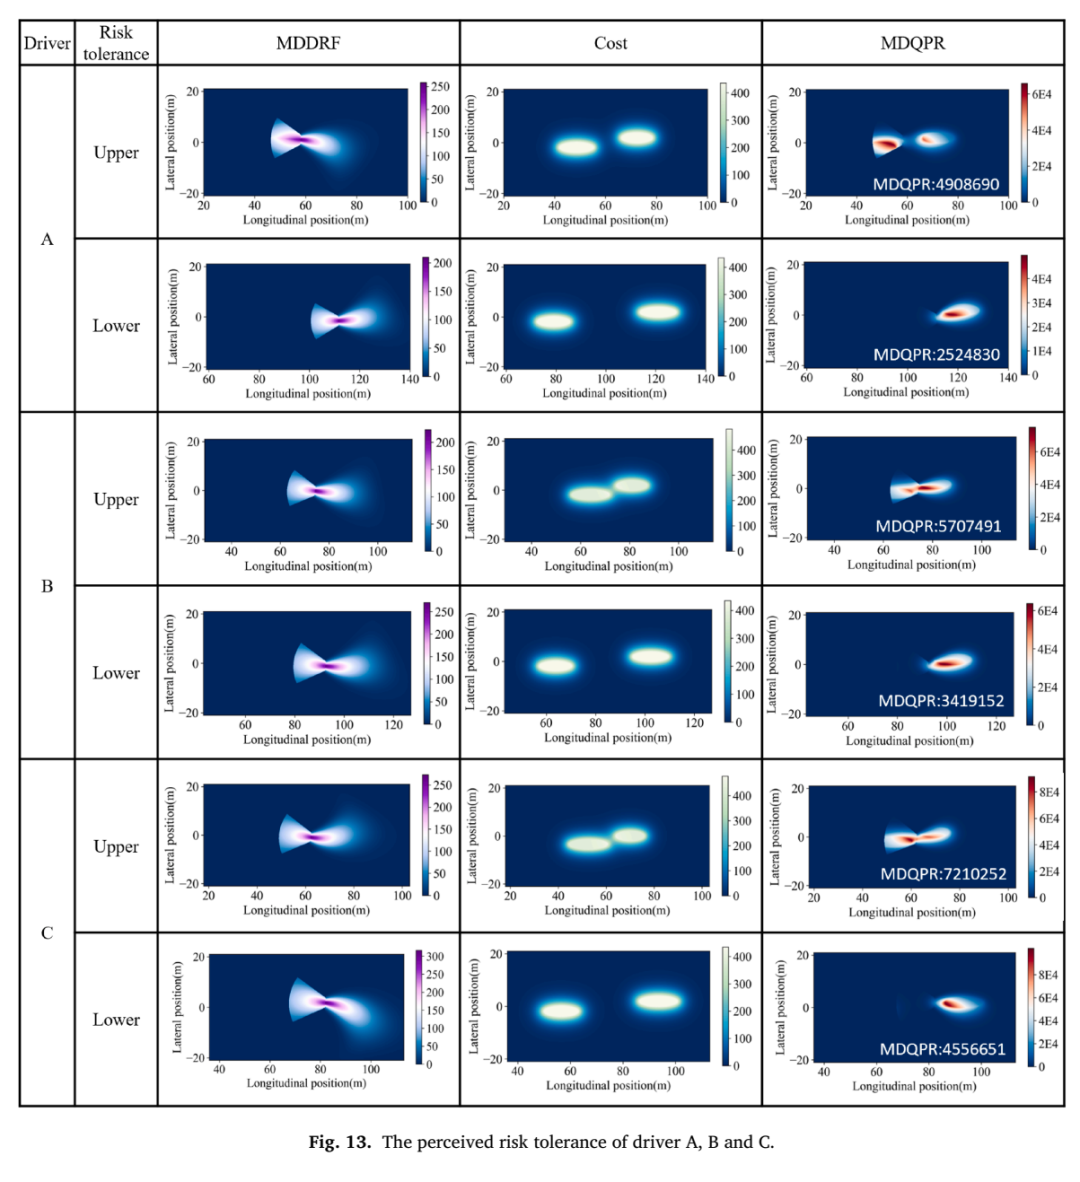
来源:Fig. 13,驾驶员A、B、C的感知风险容忍度。
✓驾驶员A在较早阶段选择不变道,上限风险容忍度最低,对应更保守的驾驶风格。
✓驾驶员C只在变道条件不足时放弃变道,上限风险容忍度最高,对应更激进的驾驶倾向。
✓驾驶员B的切换位置和容忍度位于两者之间,说明MDQPR能刻画不同风险水平下的行为差异。
训练系统
Win10 + RTX3090 + i7
论文报告的模型训练硬件环境
经验采样
80%探索数据 + 20%重标注数据
论文实验中取得较好效率与稳定性的回放采样比例
结果分析
在相同状态空间和动作空间下,论文将RTA-SAC与传统SAC、DDPG、TD3比较。DDPG训练振荡明显并且长时间未收敛;TD3可以收敛,收敛后平均奖励为587.98,低于SAC和RTA-SAC;RTA-SAC约在15000个训练回合后稳定收敛,传统SAC约在20000个回合后开始收敛。
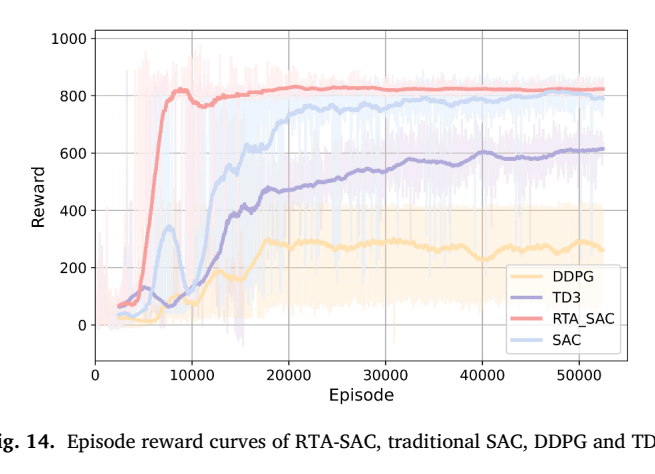
来源:Fig. 14,RTA-SAC、传统SAC、DDPG和TD3的训练奖励曲线。
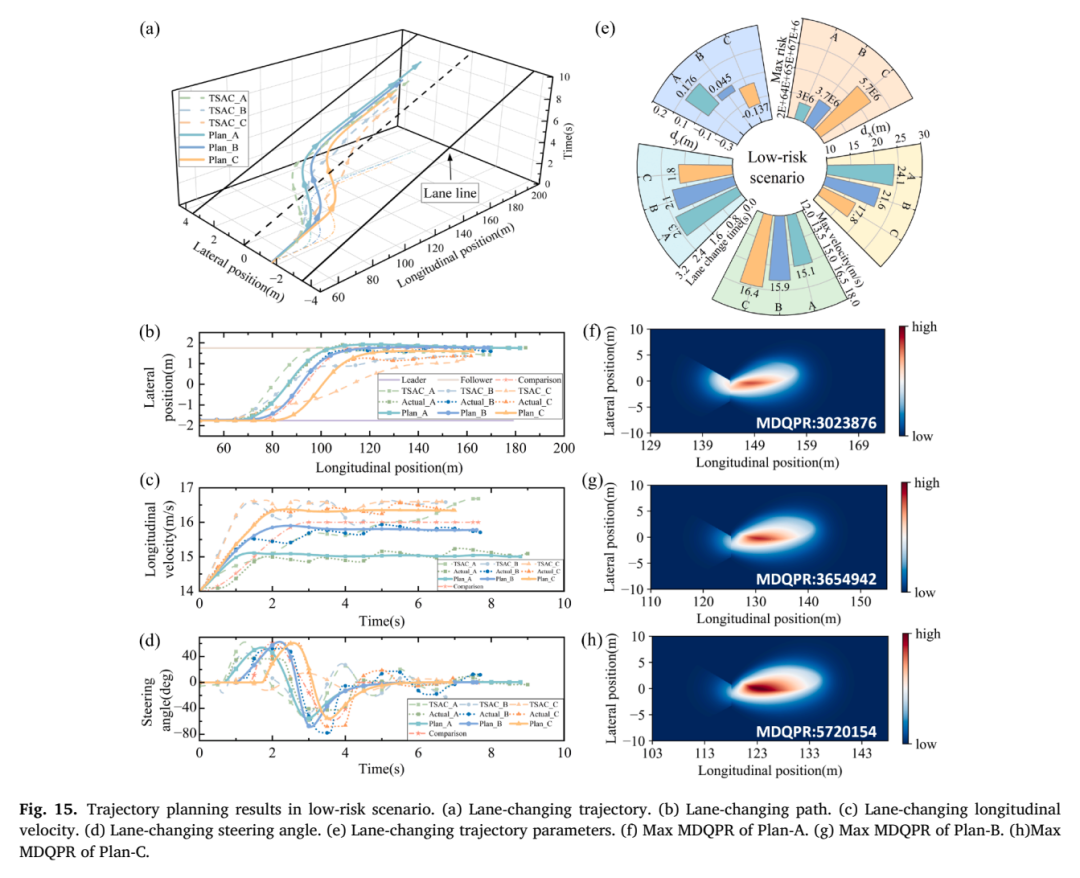
来源:Fig. 15,低风险场景下的轨迹规划结果。
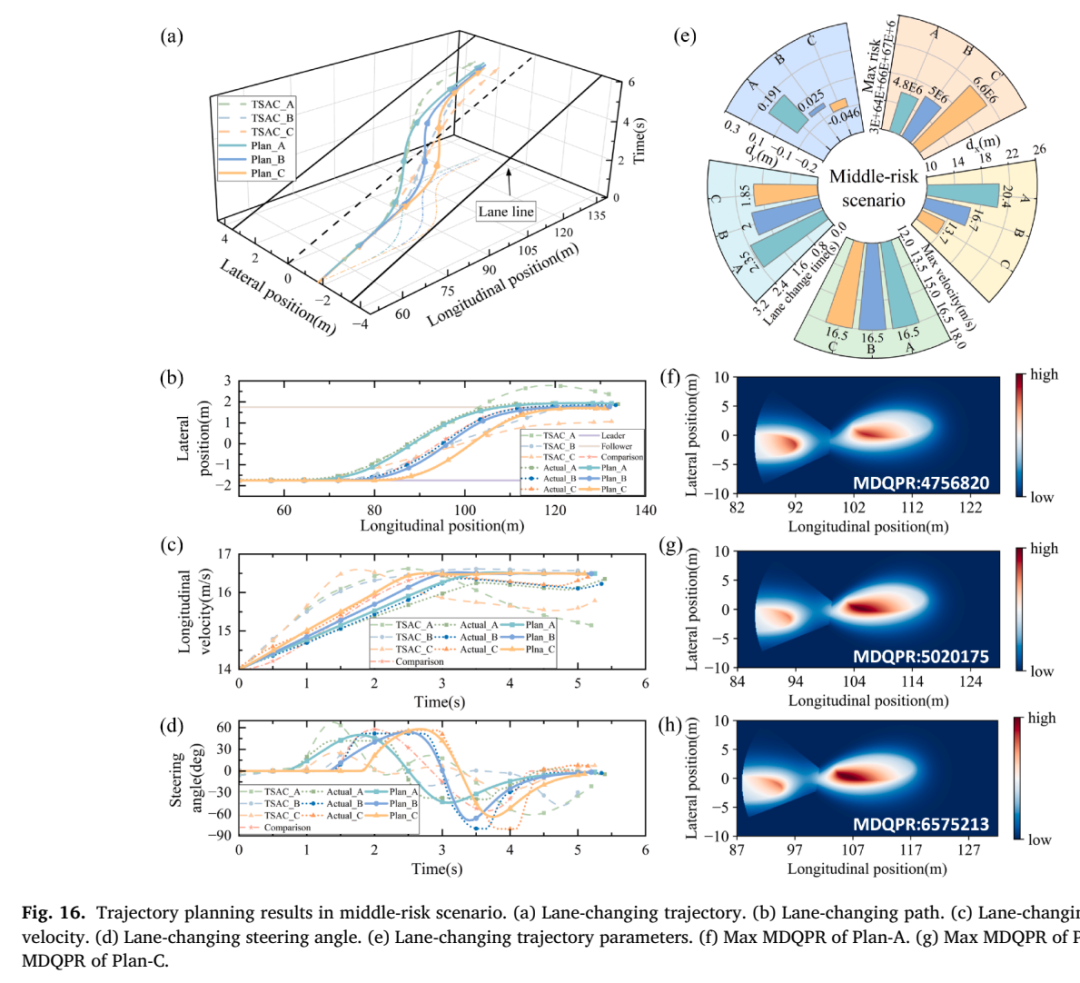
来源:Fig. 16,中风险场景下的轨迹规划结果。
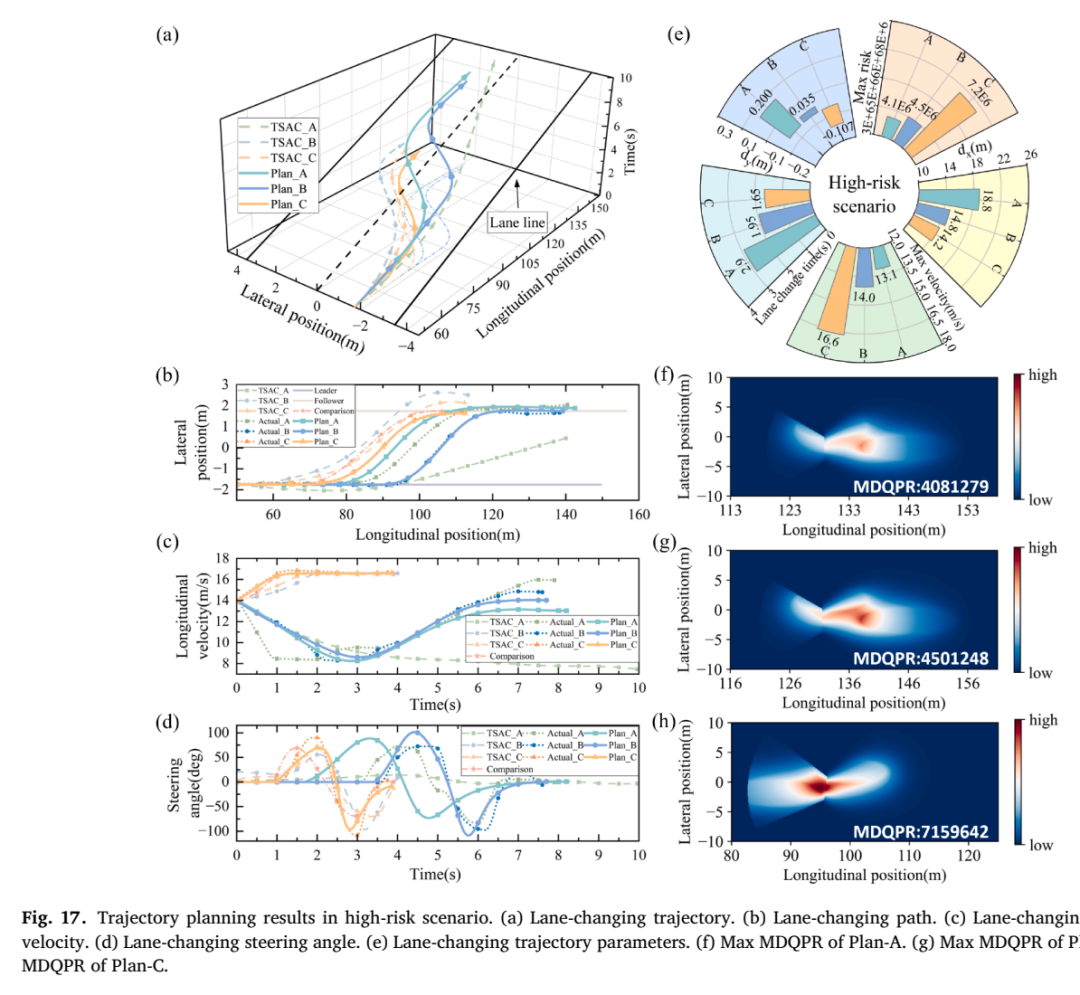
来源:Fig. 17,高风险场景下的轨迹规划结果。
管理启示
从应用角度看,这项研究给辅助驾驶系统提供了一种“偏好进入规划层”的实现方式。系统先识别驾驶员可接受的感知风险区间,再在安全约束内调整速度、转向和变道时机,使机器轨迹更接近驾驶员预期轨迹,减少驾驶员接管或强行修正的需求。
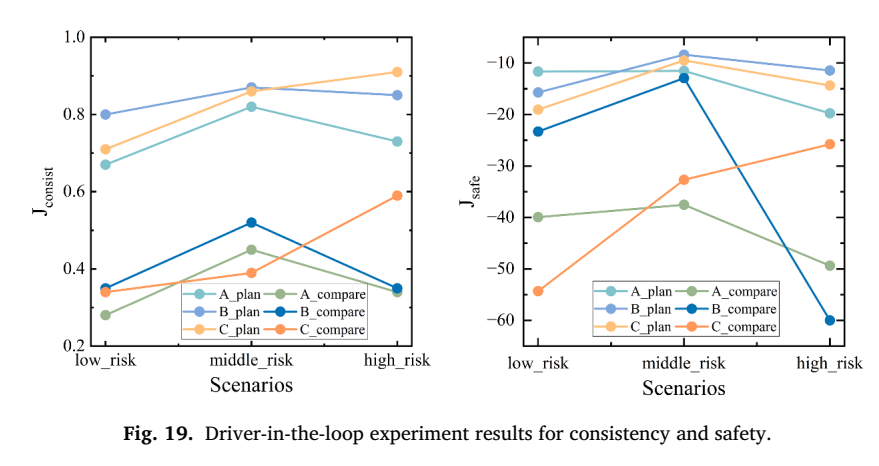
来源:Fig. 19,驾驶人在环实验中的一致性与安全性评估结果。
协同持续时间
至少提升54.24%
驾驶人在环测试中的人机协同时间改善
安全性
最高提升78.39%
论文摘要报告的安全性改善幅度
- 对车企和辅助驾驶系统开发者,规划层个性化可以用来降低机器轨迹与驾驶员预期之间的偏差。
- 对算法部署,论文中的安全检查模块说明个性化轨迹需要服从TTC、道路边界和风险上限等基础安全约束。
- 对后续研究,作者指出10名驾驶员样本难以覆盖更广泛人群,未来需要扩大驾驶员规模来验证风险容忍度评估的泛化性。
论文:Human-Machine Collaborative Trajectory Planning Considering the Driver’s Risk Tolerance
作者:Mengqi Zhang,Chunyan Wang,Wanzhong Zhao,Ziyu Zhang
期刊:Transportation Research Part C
链上镖师、先卜交通、先卜运筹通用论文ID
保存此推文 ID,可在粉丝群内获取相关材料,未来更多功能敬请期待
先卜科技团队:常文婕、张巧巧、王一航、夏子帆、张晓乐、祁园园、张仁义


