论文题目:A foundation model for cross-city multimodal transportation demand prediction
第一作者:蒋志寰 北京交通大学交通运输学院博士生,导师黄爱玲教授。
通讯作者:黄爱玲 北京交通大学交通运输学院教授,研究涉及综合交通系统智能管控、交通大数据挖掘和分析、公交复杂网络韧性、物流系统工程等,
E-mail:alhuang@bjtu.edu.cn
多模式运输系统跨城需求预测:TransFM模型结构与创新
论文摘要
现代城市交通由高运力的 地铁、公交 与灵活的 网约车、共享单车 等多种模式组成,各模式的需求受城市结构与居民活动模式影响而呈现显著差异。现有多模式交通需求预测模型通常专注单一城市,难以在数据稀缺的新城市间迁移。为解决模式差异和城市异质性的双重挑战,作者提出 TransFM 基座模型:该模型通过 模式专门记忆增强混合专家(MoE)模块 捕捉每种交通模式的专有特征,并允许跨模式知识交流;同时利用 跨城市通用时空 MoE 模块 联合建模城市间的差异与共性,提取可迁移的时空原型。实验证明,TransFM 在六城四模式十一组数据上平均超越基线模型 5.63% ,并能在少量样本下仅微调 0.78%~6.50% 参数即可保持领先性能。
一、研究背景与问题定位
1.1 多模式交通系统与预测难题
城市交通涉及地铁、出租车、网约车和共享单车等互补模式,各模式的空间尺度和服务人群不同。其需求模式受 城市布局、交通网络拓扑 和居民活动周期控制,呈现复杂的时空异质性。准确预测各模式的需求能帮助乘客无缝换乘并支持管理部门合理配置运力。
1.2 现有方法的局限
城市专用模型难以泛化:多数研究针对单个城市优化模型,在训练城市内表现良好,但迁移到新城市时性能严重下降,需要大量历史数据重训。
已有基础模型忽视模式差异:近年来统一交通数据的基础模型(如 UniST、UniFlow、BIGCity 等)能学习多源数据表示,但对各交通模式的专有结构理解不足。
跨城市场景中的双重挑战:
模式级:需在保留模式独特性的同时建模跨模式潜在联系。 城市级:需在捕捉不同城市各模式的时空差异同时挖掘可迁移的共性。
二、TransFM模型框架设计
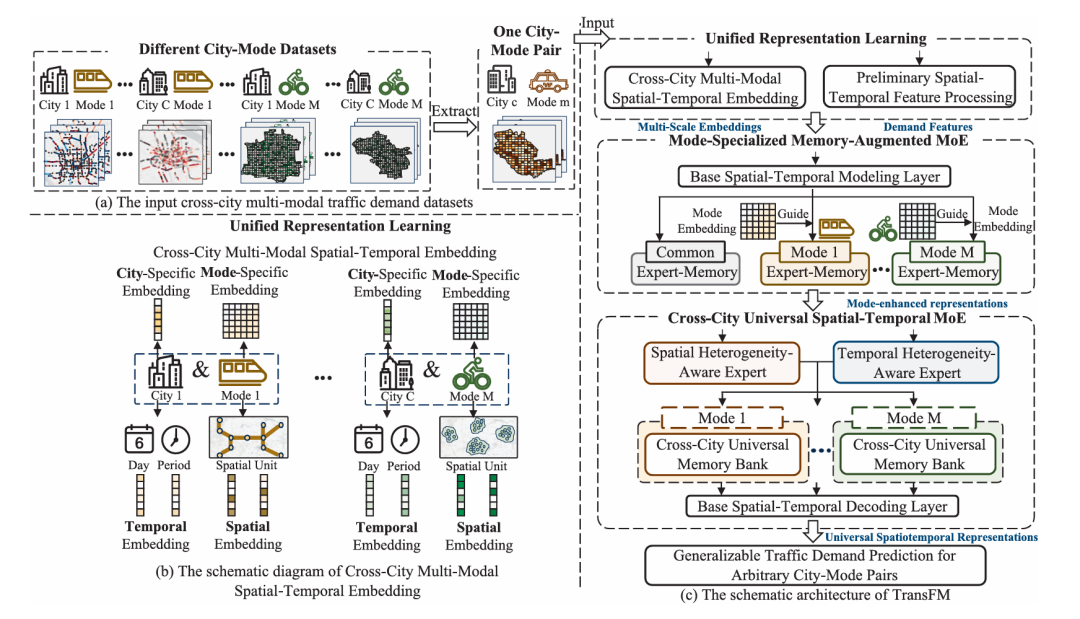
TransFM 旨在解决模式差异与城市异质性并存的难题。整体流程包括四个部分:统一表示学习 → 模式专门记忆增强 MoE → 跨城市通用时空 MoE → 输出层,其结构如图所示。
2.1 统一表示学习模块
作用: 构建统一的高维表示,以支持跨城市、跨模式学习。
时空嵌入:为每个城市‑模式建立空间和时间嵌入矩阵,将站点/区域、一天中的时间段和一周中的日期编码到向量空间中。 模式与城市嵌入:每个交通模式和城市分配一个可学习的嵌入向量,用于表示其整体特征。 初始特征处理:对原始需求序列进行 SwiGLU 变换和扩张卷积,以捕捉初步的时间关联;采用 Meta‑GCN 构建自适应邻接矩阵并生成时空特征。 输出:得到初始时空表示 ,为后续模块提供输入。
2.2 模式专门记忆增强 MoE 模块
作用: 同时刻画模式专有特征并实现跨模式知识共享。
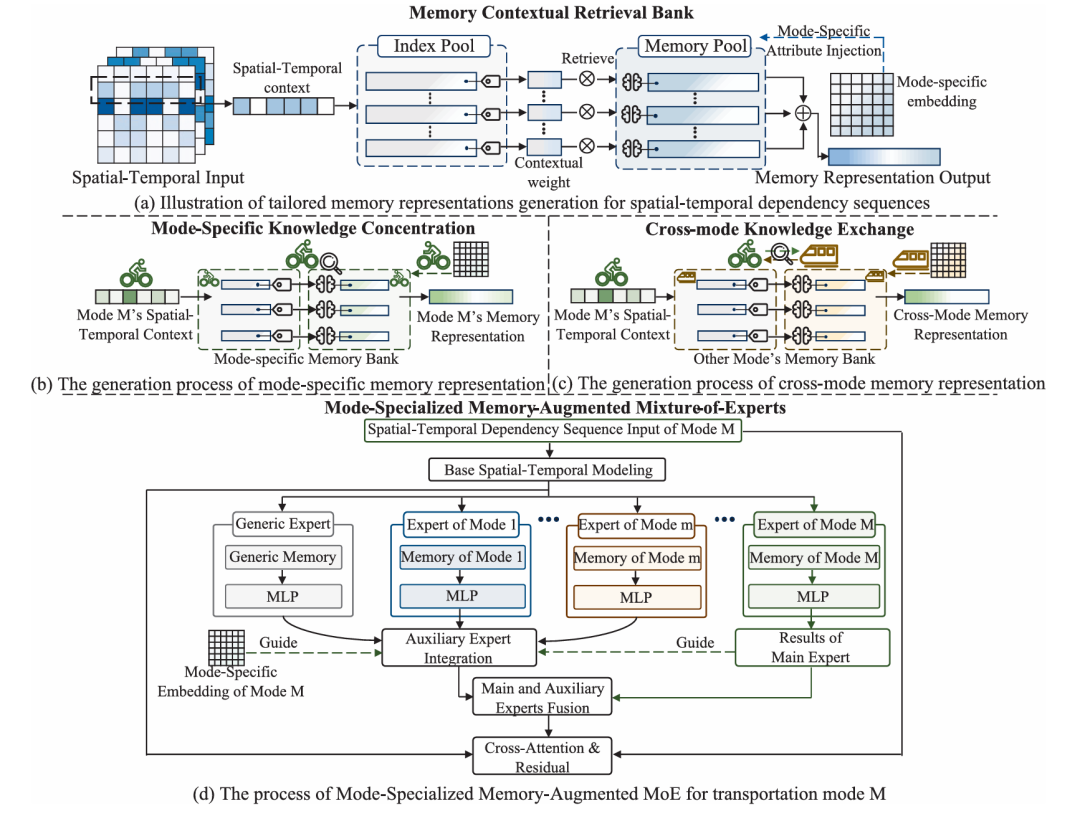
基准时空建模:通过时间和空间多头注意力以及门控融合构建精细的时空表示。 模式专有记忆库:
每个模式建立 键值记忆池 。记忆池中向量代表典型需求原型。 通过模式嵌入将模式特征注入记忆池:
记忆检索与重组:对于输入时空序列 ,计算相似度并生成权重 , 从记忆池重组出匹配的模式特 。 模式专家与跨模式专家:
每个模式对应一个专家,通过记忆检索结果 另设一个泛化专家用于捕获跨模式共享属性。
跨模式专家融合:主专家输出 与辅助专家输出堆叠 经过两阶段门控融合:
辅助专家集成:依据主专家输出和模式嵌入生成权重,将各辅助专家输出加权求和。 主‑辅助融合:通过 MLP 生成门控系数 ,融合主专家与辅助专家集成结果
跨注意力与残差连接:最终的记忆增强表示 通过跨注意力与原输入融合,并残差相加。
2.3 跨城市通用时空 MoE 模块
作用: 兼顾城市‑模式异质性和跨城市普适性,提升泛化能力。
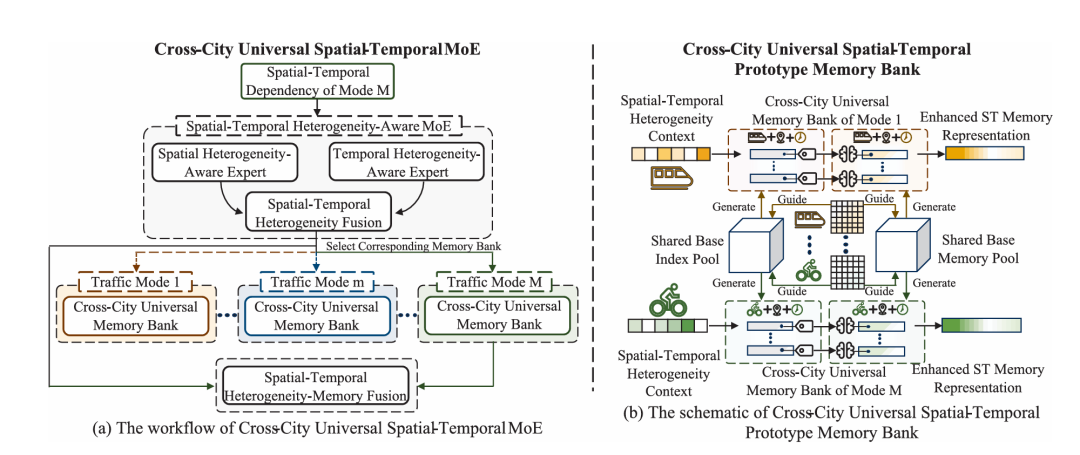
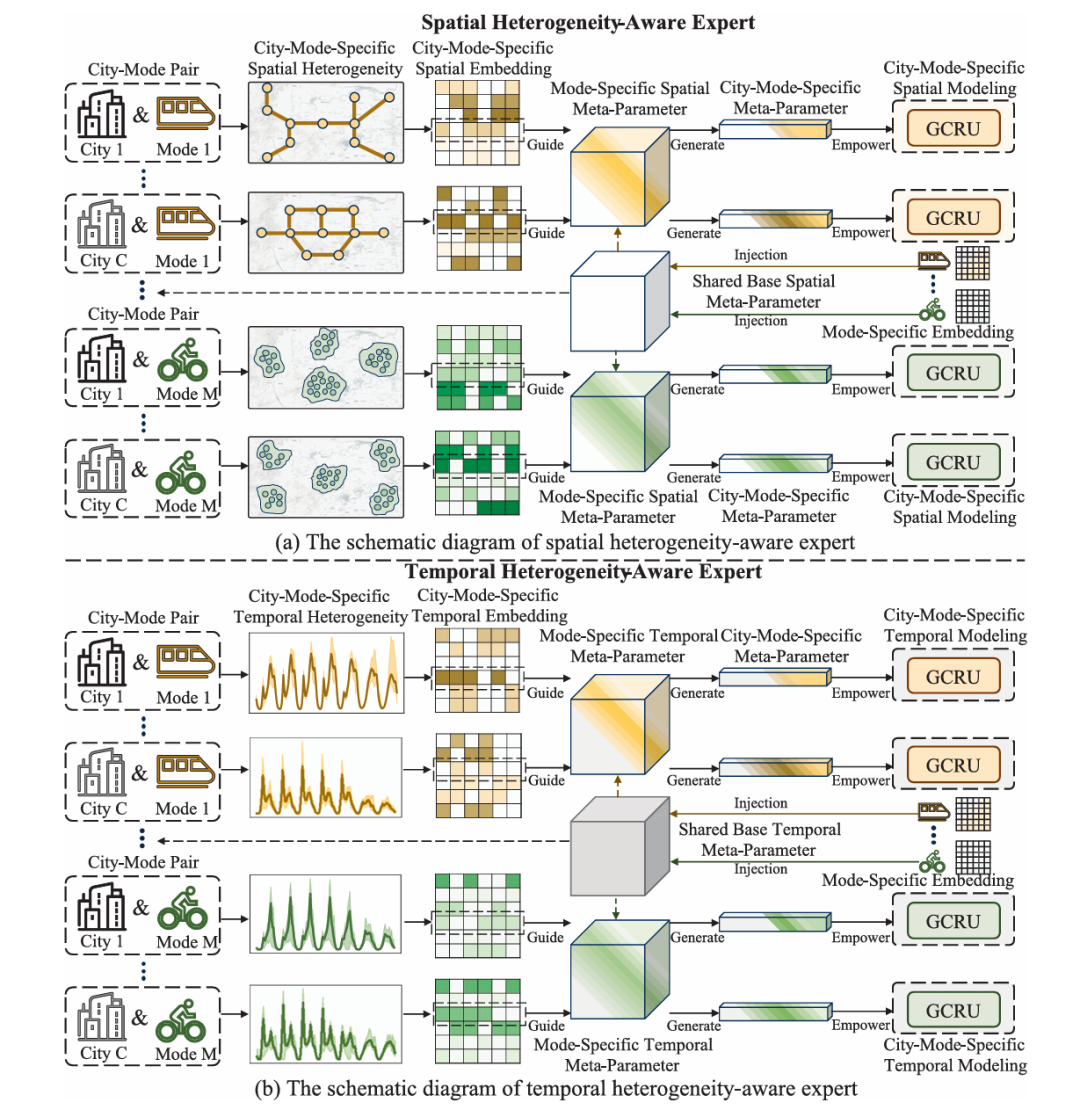
时空异质性专家:利用图卷积递归单元为每个城市‑模式对生成 空间 和 时间 两类元参数集,通过 元学习 动态适配不同节点和时间步的参数。在 空间维度 的图卷积递归单元中,重置门、更新门、候选状态和隐藏状态更新分别计算为:
其中 是自适应邻接矩阵, 为当前时间步的输入特征,、 和 为对应的模型参数, 表示 Hadamard(逐元素)乘积。这些公式清晰地描述了图卷积递归单元在空间维度上的计算过程,可直接替换原有排版不规范的版本。
跨城市通用记忆库:建立每个模式共享的基础记忆池 ,再注入模式嵌入生成模式专用的通用记忆池。对输入 计算权重
并得到记忆表示 。
通过跨注意力生成最终的通用时空表示 。
解码与输出层:使用多头注意力和门控融合解码 ;随后通过轻量化 MoE 及线性层输出预测值,并采用 Huber 损失与 MAPE 的混合损失进行训练。
三、实验设计与结果分析
3.1 数据集与基线模型
数据来源:作者汇集了 美国和中国六座城市(纽约曼哈顿、华盛顿 D.C.、芝加哥、北京、上海、杭州)在 地铁、网约车、出租车、共享单车 四种模式下的 11 组真实需求数据。数据包含 1 722 个空间单元、55 368 个时间步,总计 8 180 568 条观察。 处理方式:不同数据集的时间间隔在 10–60 分钟之间,输入序列长度为 4–12 步,并按 6∶2∶2 划分训练、验证和测试集。 对比模型:选择 ASTGCN、Graph WaveNet、AGCRN、MVSTT、STAE‑F、L‑STGTN、HimNet 等单模式或跨模式预测模型作为基线;另外引入 MMDNet 作为城市内多模式基线。
3.2 综合性能与对比
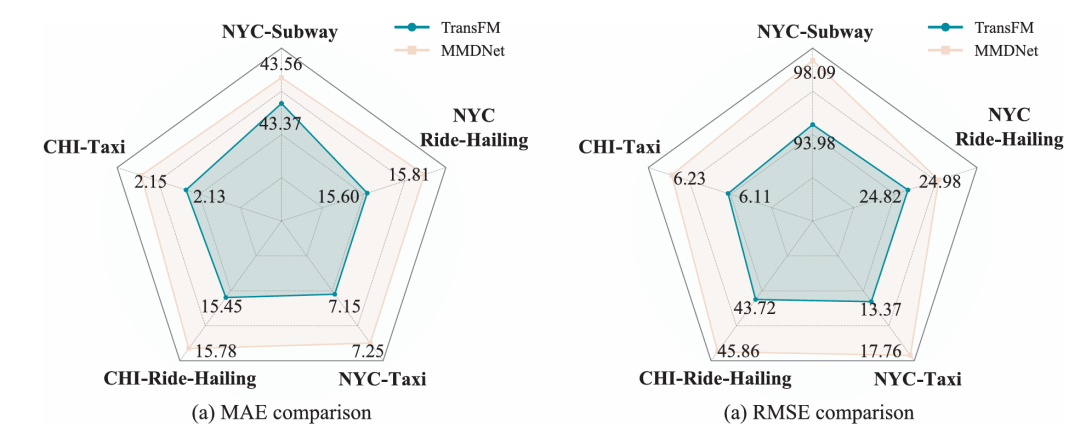
在 八个训练集(1–8 号数据)上与基线模型比较,TransFM 在所有数据集的 MAE、RMSE 和 MAPE 指标上普遍领先(部分结果见表 3)。与最佳基线相比,平均性能提升 5.63% 。 将 TransFM 与 MMDNet 在纽约和芝加哥的多模式数据上比较,TransFM 在 MAE 和 RMSE 两个维度均显著优于 MMDNet,说明统一跨城模型比仅在单城联合训练更具泛化能力。
3.3 消融实验
作者设计三种变体:去掉模式专门模块(V1)、去掉跨城市模块(V2)及同时去掉二者(V3)。结果表明完整的 TransFM 在各数据集上表现最佳;去掉模块会导致性能下降,其中 V2 的退化最明显,反映出跨城市通用模块对预测稳定性的关键作用。
3.4 少样本迁移能力
为验证跨城市迁移能力,作者在上海地铁、北京地铁和北京出租车三个未见过的数据集上仅使用 10% 训练数据进行微调。TransFM 只需调整约 0.78%–6.50% 的参数(新增嵌入和少量 LoRA 层),就能显著优于全参数训练的基线模型。数据稀缺的情况下,TransFM 能有效转移在数据丰富城市学到的知识,实现快速适应。
四、创新点与学术意义
跨城市统一预测框架:TransFM 首次将多模式交通需求预测从单城提升到跨城场景,通过统一表示学习模块兼容不同城市和模式的数据。 模式专门记忆增强 MoE:为每种交通模式配备私有记忆库并注入模式嵌入,在保留模式独特性的同时通过跨模式检索实现知识共享,解决了跨城场景下缺乏直接联通的模式关联问题。 跨城市通用时空 MoE:引入异质性感知专家和通用记忆库,既适应每个城市‑模式的特定时空结构,又提炼可迁移的时空原型,实现城市间异质性与普适性并举。 极高的泛化与少样本适应性:实验表明,TransFM 在标准训练和少样本微调场景下均大幅超越现有模型,并能通过极少量参数更新适应新的城市和模式。 解释性探索:论文通过 t‑SNE 等可视化分析验证了城市嵌入和模式嵌入能形成明显集群,表明模型内部能学出可解释的城市‑模式表征。
五、结论与展望
TransFM 提供了一个强大的跨城市多模式交通需求预测基座模型。它通过专门的记忆增强 MoE 捕捉模式差异,通过通用时空 MoE 提炼城市间共享知识,实现了对城市异质性与模式差异的统一建模。大量实验验证了其准确性、稳定性和极佳的迁移能力。未来的研究可以在以下方向深入:
融入更多类型的交通模式和复杂路网特征,例如公共汽车、步行数据等。 探索实时数据的在线更新与快速推断能力,为智慧交通决策提供更即时的支持。 与城市规划和资源调度系统结合,在优化公共交通布局、制定动态收费政策等方面发挥更大作用。
文章须知
链上镖师团队:常文婕(AEIC)、张巧巧(AEIC)、王一航、祁园园、张晓乐、张仁义
原文链接:https://doi.org/10.1016/j.trc.2026.105618
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



