论文题目:A foundational individual mobility prediction model based on
open-source large language models
城市出行预测:基于开源大型语言模型的MoBLLM框架
论文摘要
个体出行预测是个性化服务和智能交通管理的关键,但传统机器学习或深度学习模型只能针对单一数据集进行训练,很难跨城市、跨时空泛化。当前的零样本大模型虽然具有强大的推理能力,但在个体出行任务上的准确率不够高、成本也偏高。本文提出一种基于开源大型语言模型的基础模型——MoBLLM,旨在通过指令驱动训练构建统一的出行行为表示,跨越GPS轨迹、签到记录和自动售检票(AFC)数据等多种来源。作者先采用商用LLM生成多样化的半成形指令,再结合真实出行序列构造完整的训练样本;随后在轻量化的开源LLM上利用参数高效微调(PEFT) 和低秩适配(LoRA) 进行训练,从而在保持低成本的同时实现高性能。多城市六个数据集的实验表明,MoBLLM在准确率和F1值方面显著优于深度学习模型与商用LLM;模型还展现出强大的跨城市迁移能力和在网络变化、政策干预、特殊事件等情况下的鲁棒性,成本只有商用模型的约1/60。该研究为开发可复用、可迁移的出行预测基础模型提供了新的思路。
一、问题与背景
1.1 个体移动预测的重要性
个体出行预测指在给定历史移动序列的情况下,预测未来停留地点或行程信息。它是智能推荐、运输管理、拥堵缓解和出行激励的重要支撑。近年来,GPS轨迹、签到数据以及AFC数据的普及催生了大量数据驱动模型。然而,这些模型往往局限于局部数据,缺乏跨区域的泛化能力。
1.2 研究问题与基础任务
作者提出“基础模型”概念,旨在构建可在不同城市、不同时间和不同情境下迁移的通用行为表示。为此,研究定义四个基础任务:
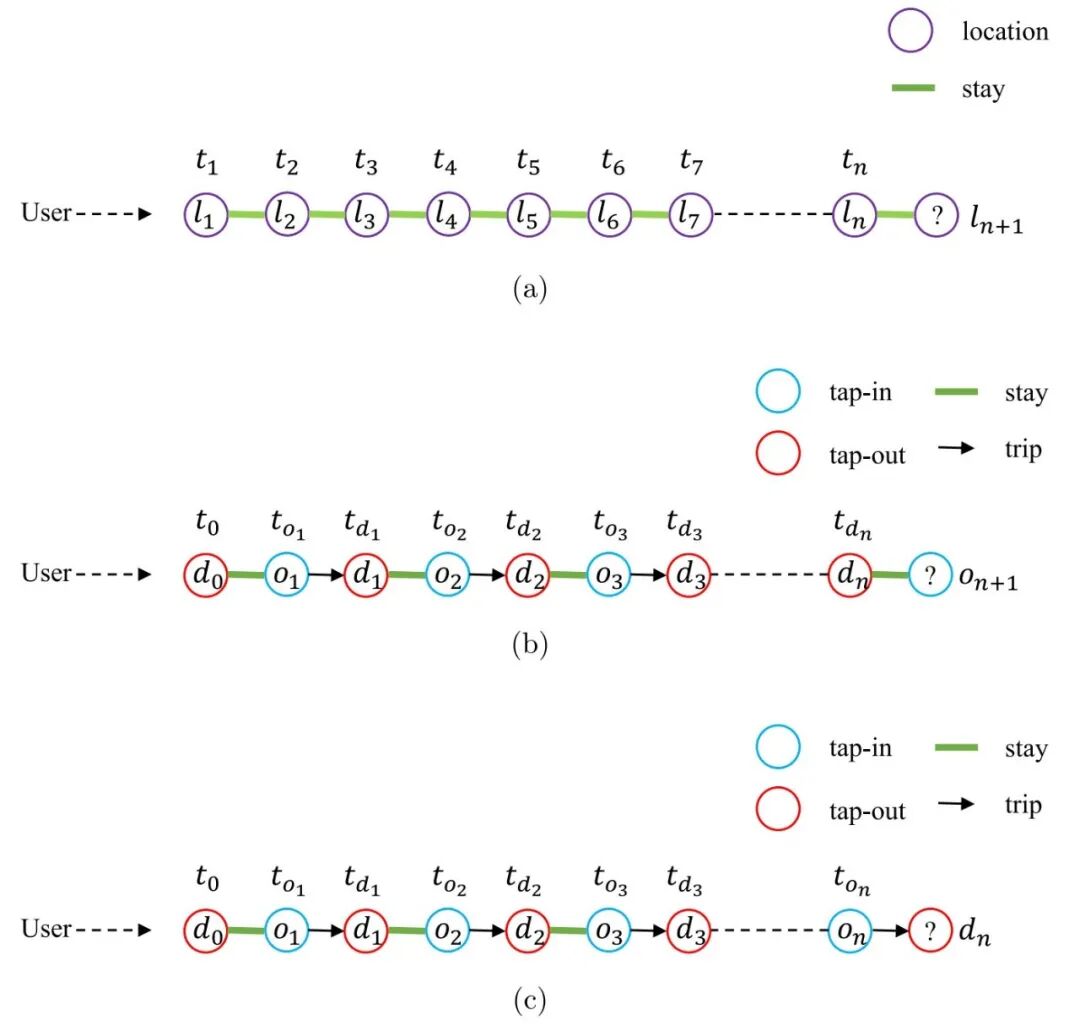
任务1(下一个停留点预测):根据历史停留序列预测下一次停留的地点,停留包含起始时间、星期信息和地点。 任务2(下一个停留点及时长预测):在任务1基础上,同时预测下一次停留的持续时长。 任务3(下一程出发站预测):根据历史出行序列(起始站、终点站、持续时间等)预测下一程的出发站。 任务4(下一程目的站预测):根据历史出行序列预测下一程的目的站,并考虑前一次停留时长。
为了适应不同数据类型,文中将原始坐标等信息离散化为序号,弱化绝对空间语义,从而提升跨城市泛化能力。
在基础任务示例中,作者通过三个子图解释了GPS轨迹与AFC数据下的任务特征(图1)。下图展示了通过离散化后的基准任务示例,可直观理解任务1/2与任务3/4的差异。
1.3 现有方法的局限
传统模型局限:早期工作多采用马尔可夫链等模型,其直观但难以捕获复杂的时空模式,准确率有限。 深度学习模型:RNN、Transformer 等能够学习长序列依赖,但需要大量数据,并且针对单城市训练,缺乏跨域迁移能力。 商用大型语言模型:零样本提示(zero-shot CoT)可以直接预测未来出行,但由于模型未专门为出行任务训练,预测准确率不高,且调用成本昂贵。
这些局限性促使研究者探索能够在多个数据源之间共享知识、同时具有高性能和低成本的基础模型。
二、方法框架与技术细节
2.1 MoBLLM整体框架
作者提出的MoBLLM框架由三个主要步骤组成(图2):
多风格指令生成:采用具备强推理能力的商用LLM(如 GPT 系列)作为教师模型。根据预定义的基础任务模板,向教师发出指令,生成多个风格的半成形指令。 结合真实数据构建指令数据集:将这些半成形指令与真实的个人出行序列组合,形成完整的训练样本。 参数高效微调开源LLM:使用PEFT方法在开源模型(如 LLaMA-3.1-8B-Instruct)上微调,从而得到具备预测能力的学生模型 MoBLLM。
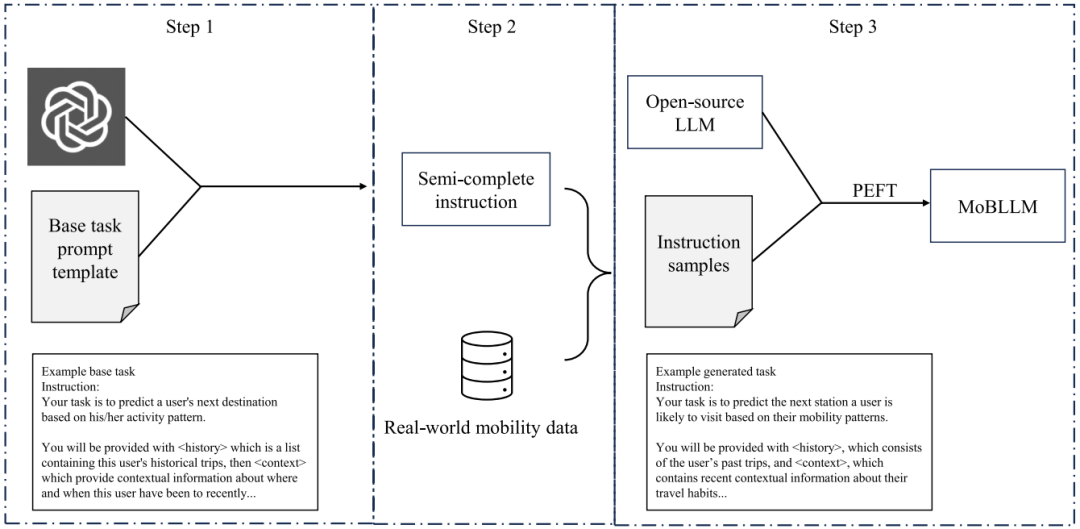
该框架的创新在于利用教师模型生成指令,通过低成本的开源模型学习行为规律,最终在多个任务上共享模型参数并实现迁移。
2.2 提示模板设计
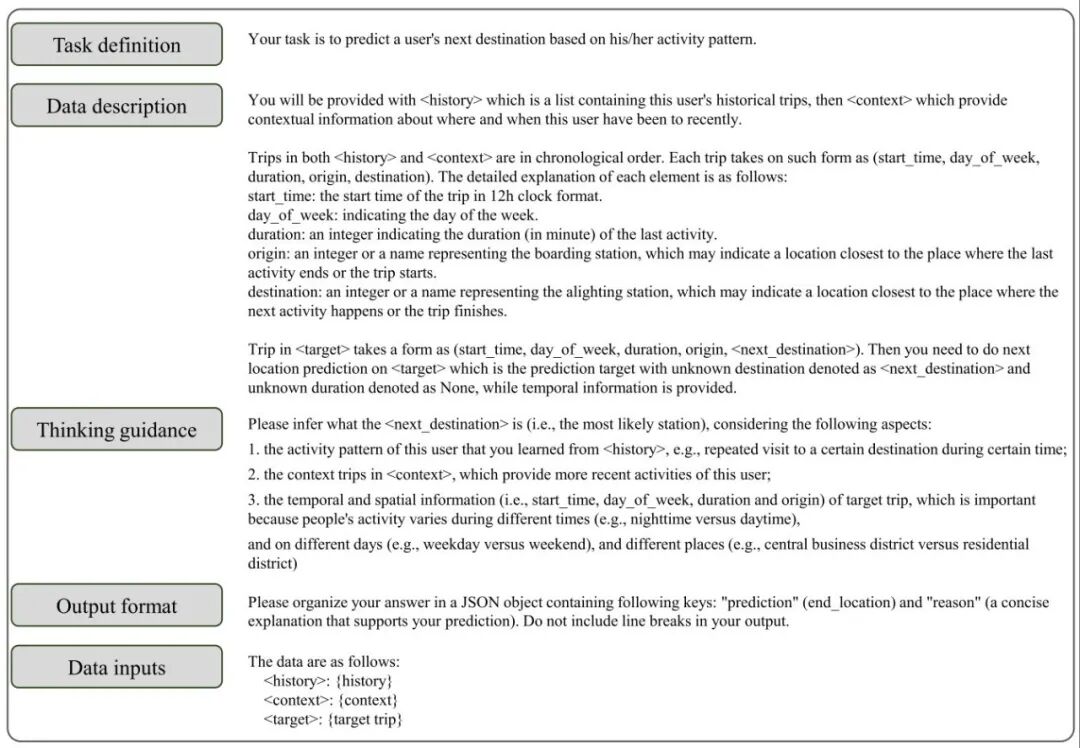
为了让模型理解出行序列并输出规范答案,作者设计了统一的提示模板,包括五个部分:
任务定义:简述预测任务,如“预测下一次停留点”或“预测下一次出行目的站”。 数据描述:说明输入数据的格式及含义(历史停留序列或行程序列)。 思考引导:用“思考链”方式引导模型分步推理,提高推理质量。 输出格式:规定回答的格式,例如仅输出一个编号或同时输出编号及置信度。 数据输入:提供历史序列 <history>、近期停留<context>和当前状态<target>。
下图为指令实例示意,其中各部分以不同颜色区分(图3)。这种模板保证了输入输出的一致性,便于模型在不同任务间迁移。
2.3 多样化指令生成与知识蒸馏
为增强学生模型的泛化能力,作者借鉴知识蒸馏思想,通过商用LLM生成多种风格的指令。其核心流程如下:
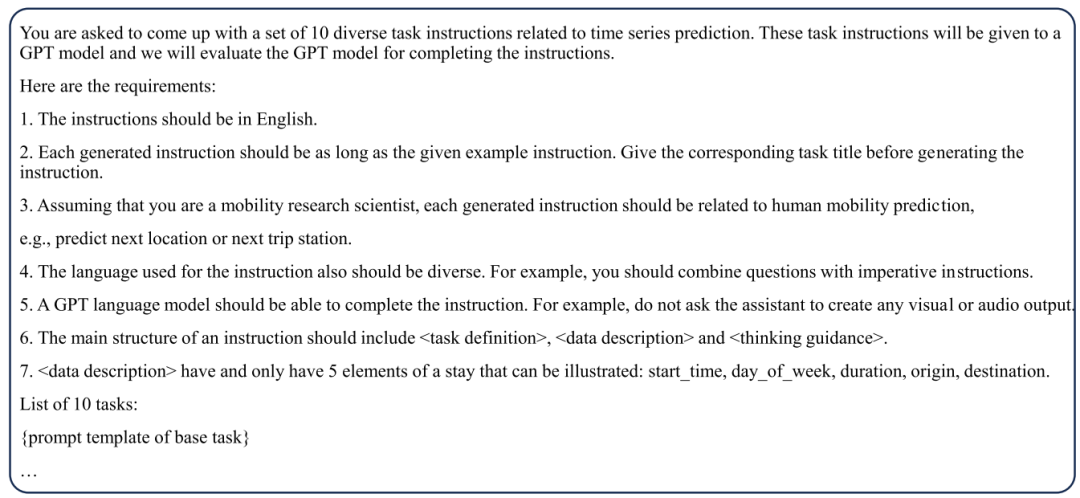
零样本 CoT 提示:采用类似 LLM-Mob 的零样本提示策略,引导商用模型对基础任务进行推理,生成思考链与答案。 风格多样化:构造不同的提示,如变换描述方式、调整思考顺序等,生成多种风格的半成形指令。 组合真实数据:将生成的半成形指令与真实出行序列结合,构建完整的指令—答案对。
图4为生成多样化指令的示例,展示了如何在提示末尾加入任务模板让教师模型学习风格。
2.4 参数高效微调(LoRA)
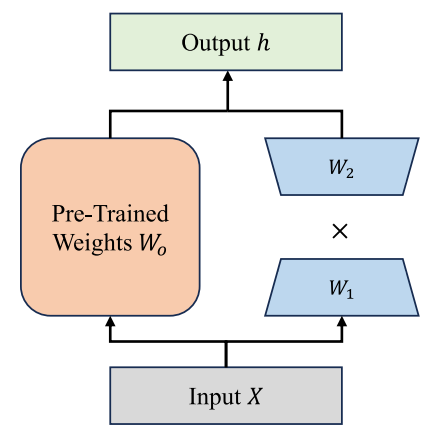
为降低微调成本,作者采用低秩适配(LoRA) 等PEFT方法。LoRA通过在预训练权重矩阵上添加低秩更新来捕获任务特定知识,其计算公式为:
其中 为固定的预训练权重, 和 是可训练的低秩矩阵, 是调节低秩更新贡献的缩放系数。由于 和 的参数远少于 ,这一方法显著降低了显存消耗和训练时间。
除此之外,作者还比较了 OLoRA、EVA、PiSSA、LoftQ、LoRA+、rsLoRA、QLoRA 等变体,评估了它们在显存占用和训练时间上的权衡。下图展示了LoRA框架的示意。
三、实验设计与结果分析
3.1 数据集与评价指标
作者在六个真实数据集上验证模型,其中包括GPS轨迹数据(Geolife)、签到数据(FSQ-NYC、FSQ-TYK、FSQ-Global)和AFC数据(HK/HZ的出发/到达子集),覆盖北京、纽约、东京、全球415座城市、香港和杭州等不同场景。数据集规模从数千到十万条记录不等,任务类型覆盖基础任务1至4。
评价指标包括:
准确率(ACC):预测正确样本占比。 加权F1值(F1):针对不同地点访问频率不均衡的问题,引入按访问次数加权的F1分数,以突出常访问地点的预测性能。
3.2 PEFT方法比较
表3比较了不同PEFT方法在四个训练数据集上的表现。主要观察结果如下:
OLoRA在所有数据集上均取得最高平均准确率和F1值,但显存占用最大。 QLoRA使用4比特量化,显存需求最少,但准确率下降明显。 基于LoRA的其他变体(EVA、LoftQ、rsLoRA等)在准确率和资源消耗上表现出不同的折衷。
综合考虑性能和成本,作者在后续实验中选用 OLoRA 微调得到的MoBLLM模型。
3.3 与基线模型比较
为验证MoBLLM的有效性,作者将其与四种基线模型比较:
DeepMove:利用循环神经网络和注意力机制捕捉周期性特征。 MobTCast:使用Transformer结构结合时间、语义、社会和地理上下文。 MHSA:采用多头自注意网络融合历史地点、停留时间和周边用地信息。 LLM-Mob:基于商用LLM的零样本预测模型。
实验结果显示,MoBLLM在所有数据集上的准确率和F1值均超过基线。在含有密集周期性模式的AFC数据(HK-ORI、HK-DEST)上,深度学习模型接近MoBLLM,但在稀疏的GPS和签到数据上表现较差,说明MoBLLM对稀疏数据更具适应性。
3.4 转移能力与成本分析
在跨数据集迁移测试中,作者从Geolife、FSQ-NYC、HK-ORI和HK-DEST训练MoBLLM,并在FSQ-TYK、FSQ-Global、HZ-ORI、HZ-DEST等未见数据上评估。结果表明,MoBLLM在所有测试数据上均优于基线 LLM-Mob。特别地:
在HZ-ORI/HZ-DEST上,MoBLLM的准确率分别达89.24%/80.15%,高于LLM-Mob的74.03%/69.26%。 在FSQ-Global这一含11万多地点的极稀疏数据上,MoBLLM仍明显优于商用模型。 成本上,生成训练指令约需0.7美元,而直接使用商用模型推理则需43.8美元。
3.5 鲁棒性评估
作者进一步利用香港地铁网络的四类异常场景验证模型鲁棒性:网络结构变化(MNC)、政策干预(PI)、特殊事件(SE)和事故(MI)。这些数据与常规训练数据在车站数量、票价政策或事件影响上存在差异。实验结果(表7)显示:
MoBLLM在各种情境下的准确率下降幅度显著小于深度学习模型和 LLM-Mob。 深度学习模型在政策干预数据上准确率下降超过10%,MoBLLM仅下降约3%。 在事故与特殊事件场景下,MoBLLM甚至在目的站预测上提升了性能,说明模型学到的行为模式具有一定稳定性。
四、结论与展望
本文提出的 MoBLLM 通过指令驱动与参数高效微调构建了一个可跨城市、跨数据源的个体出行预测基础模型。其主要贡献和创新点包括:
统一的行为表示:通过离散化位置索引、统一的提示模板和多任务微调,建成了跨数据类型共享的出行行为表示。 教师–学生蒸馏策略:利用商用LLM生成多风格半成指令,再结合真实出行序列生成训练数据,提高了模型理解能力同时大幅降低成本。 参数高效微调:采用LoRA等PEFT技术,只微调少量低秩参数即可适配任务,显著减少GPU显存需求和训练时间。 出色的迁移性与鲁棒性:实验表明,MoBLLM在不同城市和情境下准确率显著优于深度学习模型和商用LLM,并能适应网络变化、政策干预和特殊事件等条件。 成本优势明显:指令生成与微调成本约为商用模型的六十分之一。
尽管如此,作者指出零样本思考链的推理序列可能会引入错误的级联,影响最终输出,需要通过自一致性或验证策略提升鲁棒性。未来工作将探索情境感知提示、解释性增强以及更广泛的出行预测任务(如行程时间估计)。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、王一航、张仁义(EIC)、张晓乐、张巧巧
原文链接:https://doi.org/10.1016/j.trc.2026.105562
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



