论文题目:TRIP: Transport reasoning with intelligence progression—A foundation framework
第一作者:刘志远 东南大学统计与数据科学学院教授,连续4年入选“爱思唯尔中国高被引学者”、“全球前2%顶尖科学家”。主要研究领域包括交通大数据分析、交通网络规划与管理、多模式网络与公交建模、交通系统仿真等。
E-mail:zhiyuanl@seu.edu.cn
通讯作者:Shaoweihua Liu 东南大学毕业生,就职于浙江交通投资集团,研究聚焦交通大数据分析、大语言模型等,
E-mail:liushaoweihua@cncico.com
智能交通基础模型:语义-物理双状态空间的推理框架
论文摘要
该论文讨论了智能交通系统发展中存在的三大瓶颈:状态表示不完整 、多源知识融合不足以及跨尺度决策优化困难。作者提出基于双状态空间(Dual State Space) 的TRIP框架,将交通系统的状态分解为连续的物理状态与离散的语义状态,通过可学习映射在两者之间建立双向联系。框架利用大语言模型的语义理解能力与世界模型的物理预测能力,采用分层强化学习实现渐进式推理,由高层语义理解过渡到低层物理行动。核心贡献包括:提出跨模态对齐策略,确保物理–语义状态一致;设计分级推理机制,使决策既符合场景语义又满足物理约束;构建可扩展的双状态建模方法,并提供稳定性与可解释性理论保障。实验在信号控制和路线规划中验证了框架优于传统方法,证明了其应用潜力。
一、研究背景与问题
1.1 智能交通的挑战
状态表示单一:现有智能交通系统多依赖速度、流量等物理数据,忽视事故、管制等语义信息,导致对交通情境的理解不全面。 知识融合薄弱:多源异质数据和专家知识难以融合,现有方法存在可解释性差、泛化性不足等问题。 决策难以分层优化:现有控制策略通常单层优化,难以协调宏观策略与微观行动。 大模型与交通的鸿沟:大语言模型擅长语义推理,但难以处理物理约束;世界模型重视物理精确性,却缺乏高层语义理解。如何将二者结合,是交通建模的关键问题。
1.2 研究目标
定义交通系统的最小粒度并建立统一的状态表示,使模型既能捕捉连续的物理动态,又能描述离散的语义事件。 提出一种跨模态对齐与渐进推理的理论框架,能够将大语言模型的语义理解与世界模型的物理预测结合起来,实现实时、可解释的交通控制。
二、双状态空间理论
2.1 物理状态空间
物理状态空间 用向量描述与交通相关的可测物理量,如车辆的位置、速度、加速度、道路流量和密度。对任意时刻 ,物理状态向量为
其中各符号表示具体物理变量。物理状态空间具有可观测性与连续性,可以直接从传感器测量或通过估计得到。
2.2 语义状态空间
语义状态空间 用离散集合描述交通中的抽象属性,如事故类型、道路状况、交通法规、管理策略等。所有可能组合构成全集 ,受领域约束得到实际语义状态空间:
语义状态由四元组 表示,分别对应事件类型、条件描述、法规和策略。
2.3 双状态空间与映射
为克服传统模型的物理–语义割裂,作者提出双状态空间 ,借助可学习映射将物理状态与语义状态投影到统一的嵌入空间。映射定义如下:
物理映射:满足唯一性和 Lipschitz 连续性
保证物理状态间距离在嵌入空间中保持比例。
语义映射:满足类似条件
使语义相似的状态在嵌入空间中靠近。
这些映射保证了跨模态一致性与可分性,使得在 中既能保留原有信息,又能进行融合和决策。
2.4 认知框架示意
下图展示了双状态空间及其决策流程示意:从传感器采集物理状态与文本、事件分析获取语义状态,经映射后形成统一的双状态表示,再通过层级奖励机制产生决策。
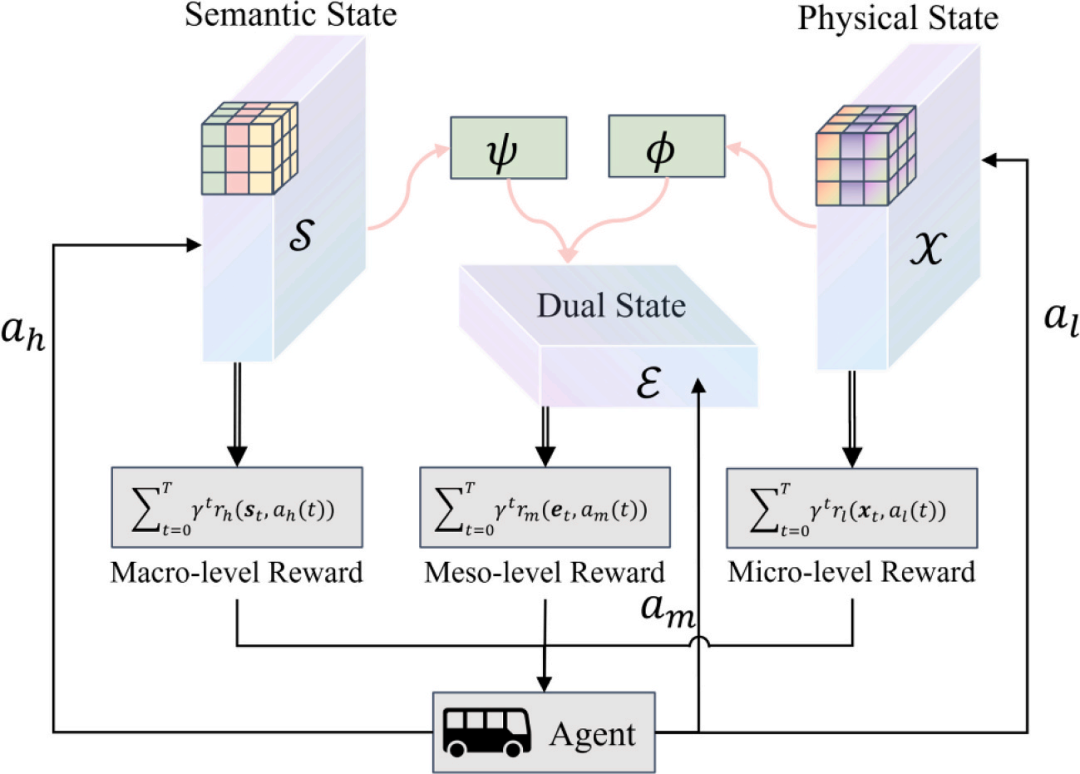
图1形象地展示了物理–语义空间映射、双状态交互及多层奖励体系。
三、渐进式推理与协同决策机制
3.1 分层动作空间
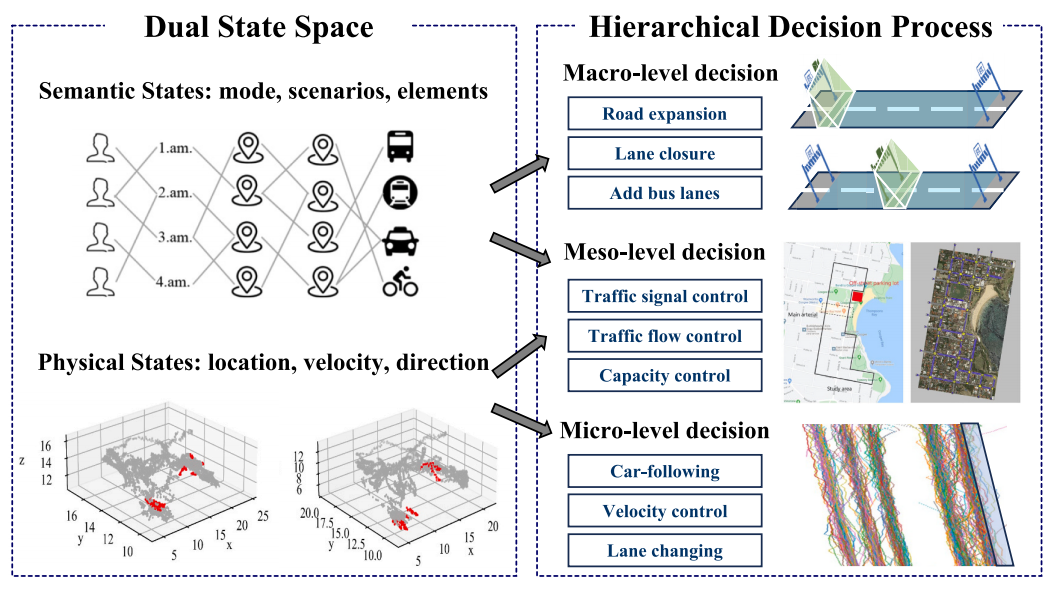
为了处理不同尺度的交通决策,TRIP将动作空间分为高层策略 、中层策略 和低层控制 ,三层组合构成整体动作空间 。各层作用:
高层策略:侧重语义决策,制定全局交通策略,如事故避让或公共交通优先。 中层策略:结合双状态,负责区域策略落地,如调整某路段信号时长。 低层控制:基于实时物理状态进行具体控制,如改变某个信号灯绿灯时间。
3.2 层级策略优化
各层通过强化学习分别优化累积收益函数:
其中 为双状态, 是折扣因子。通过跨层信息传递函数 、,高层策略指导中层,再由中层指导底层控制。
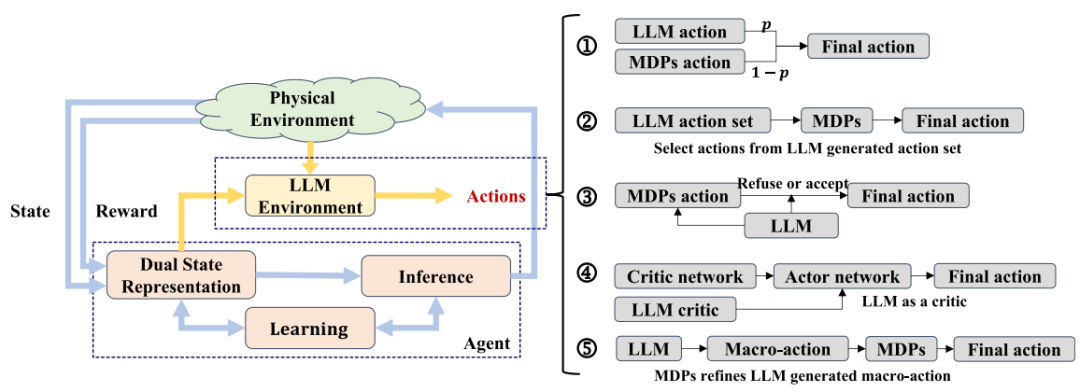
3.3 五种决策融合策略
作者探讨了将大型语言模型(LLM)与马尔可夫决策过程(MDP)融合的五种策略:
概率选择策略:以概率 在LLM和MDP动作间选择,适用于非稳定环境; 动作集筛选:LLM生成合法动作集合,MDP在集合中择优,缩小搜索空间,提高效率; 动作接受/拒绝:MDP提出动作,LLM根据语义约束决定是否接受,保障安全; 双重批评者:在Actor–Critic框架中加入LLM作为第二批评者,利用语义反馈提升策略学习; 宏动作细化:LLM生成宏观策略,MDP再细化为具体执行步骤,实现实时热启动。
这五种策略各有侧重,既保证语义丰富性,又确保物理可行性。
下图展示了这五种策略在论文中的示意图:
3.4 渐进式推理框架
综合双状态表征与层级决策,TRIP构建了从感知到预测再到行动的渐进推理流程。下图显示了双状态空间的层次结构和决策流程:左侧是语义与物理状态映射,右侧是宏观—中观—微观的决策层级。
四、实验设计与结果分析
4.1 实验场景与流程
作者在 SUMO 仿真平台中构建了两个实验:单路口信号控制和车辆路径规划。整体流程如图所示,包含数据采集、状态编码、LLM 推理、RL 模型选择与动作融合:
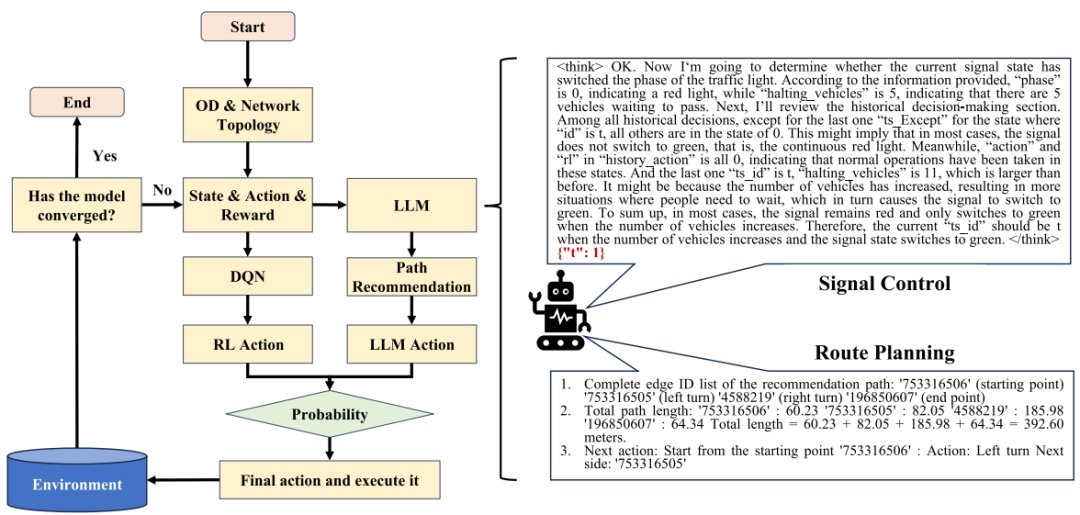
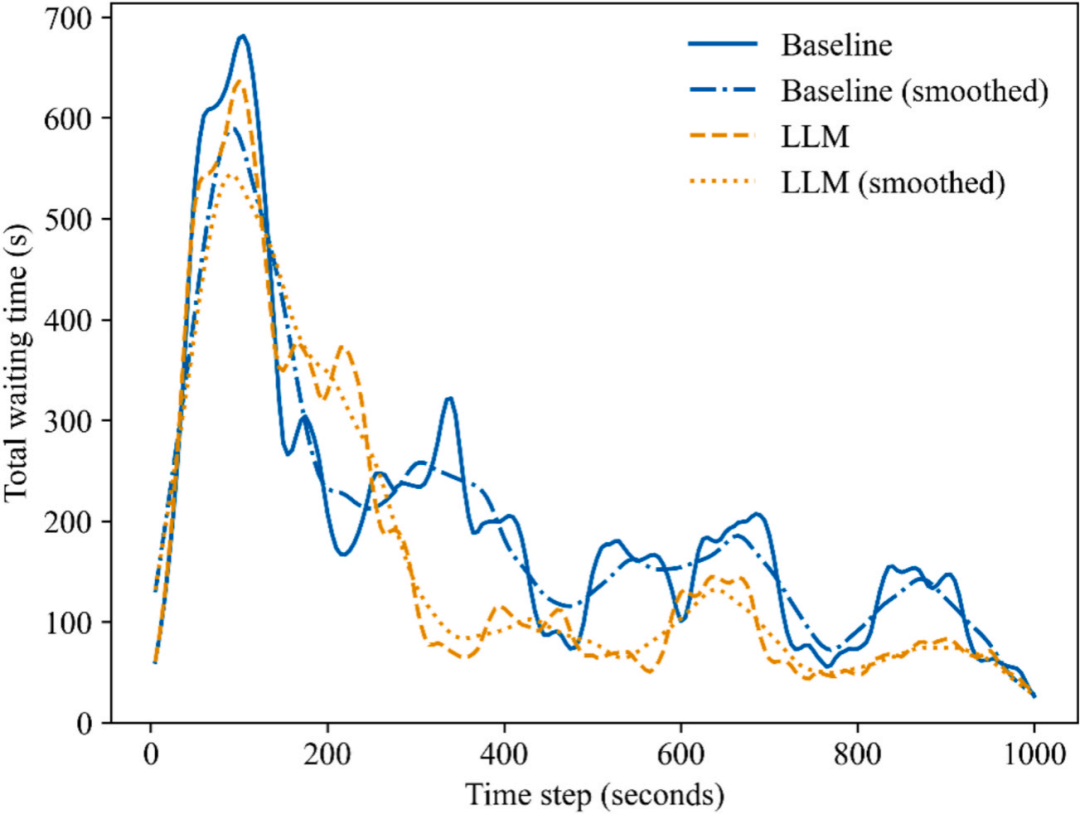
在信号控制实验中,系统每一步收集当前相位、各车道排队车辆数、平均等待时间等物理状态,并与前50步历史动作组合成提示词输入 LLM,得到 JSON 格式建议;同时 DQN 控制器根据物理状态独立选择动作,最终以 90%/10%的概率融合 RL 和 LLM 动作。
在路线规划实验中,TRIP 用于实时决策车辆在交叉口的转向,通过接口将道路拓扑和OD信息转化为自然语言提示,指导 LLM 生成候选路径,再由 DQN 结合物理状态选择合适路径。
4.2 结果分析
信号控制实验比较了基线 DQN 与朴素 TRIP 的性能。结果显示,TRIP 在 1000 步内的总等待时间明显低于基线,并且收敛速度更快。下图展示了平均等待时间随时间变化的曲线:
路线规划实验测量了训练过程的平均损失。TRIP 的损失收敛更快且稳定,最终损失比基线低 60% 左右。图6展示了平均损失曲线:
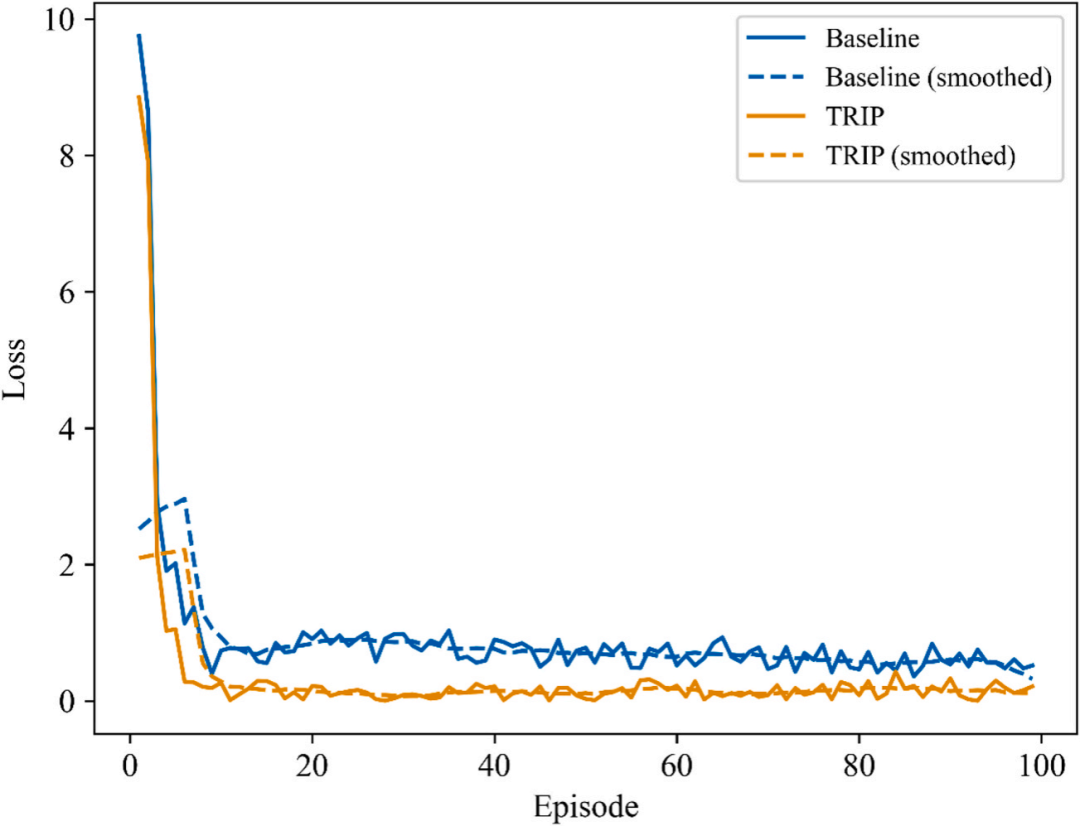
作者指出,TRIP 的改进得益于引入优先经验回放与双 Q 学习,以及 GNN 对道路拓扑的嵌入,并结合注意力机制聚焦拥堵路段。这些技术保证了模型的长期稳健性并提升路径规划的精度。
五、结论与创新亮点
5.1 核心结论
提出双状态空间理论,为交通系统构建了统一的物理–语义状态表示,并通过可学习映射保证了跨模态一致性与可解释性。 构建双状态编码与融合方法,利用 Transformer 模型实现物理与语义信息的深度融合。 设计分层渐进协同决策机制,模拟专家由宏观到微观的推理过程,实现宏观优化与微观调整的结合。 通过实验验证了 TRIP 在信号控制和路线规划方面的优越性,表明该框架能够提高交通系统效率、稳定性和安全性。
5.2 创新与展望
理论创新:首次从测度论视角提出交通系统的双状态空间定义,解决了连续空间与离散语义的统一表示问题,为后续模型研究提供了基础。 方法创新:提出跨模态对齐、渐进式推理和分层决策的全流程框架,提出五种 LLM 与 MDP 融合策略,可推广到其他复杂系统。 实用价值:在 SUMO 环境中验证了框架的有效性,显示出在实时信号控制和路径规划中的应用潜力。未来可拓展到多车辆协同、事件管理等更复杂场景,并在边缘计算环境下实现轻量化部署。
综上,TRIP 框架为智能交通管理提供了一种全新的思路。它在理论上弥合了物理与语义的鸿沟,在方法上实现了大语言模型与世界模型的协同,在实践上展示了提升系统效率和安全性的潜力。未来研究可在模型精度、多目标优化和部署效率等方面进一步深化。
文章须知
链上镖师团队:常文婕(AEIC)、祁园园、汪朝杰、王一航、张仁义(EIC)、张晓乐
原文链接:https://doi.org/10.1016/j.trc.2025.105260
原文链接见文末,或扫下方交流群二维码。群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请翻阅扫描最新文章的二维码)。



