交通场景指令调优的新范式:基于Traffic-IT的多模态模型增强方法
大模型如何理解路况?
想象一辆自动驾驶车辆在雨雾交加的深夜穿行城市,前方出现施工和行人同时穿越。当驾驶员依赖的多模态大模型只接受过常规图片和文本训练时,它可能看见路障,却忽略了湿滑路面;或是识别了车辆,却未能判断行人意图。这种矛盾凸显了 通用模型与复杂交通场景之间的落差 ,也暴露出 自动驾驶与智慧交通系统对场景认知的高要求 。
我们不禁要问:如何让大模型真正读懂交通环境中的每一个细节?现有多模态大模型缺乏 交通场景专用的高质量数据 ,能否通过构建 专属数据集 提升其理解力?
论文摘要
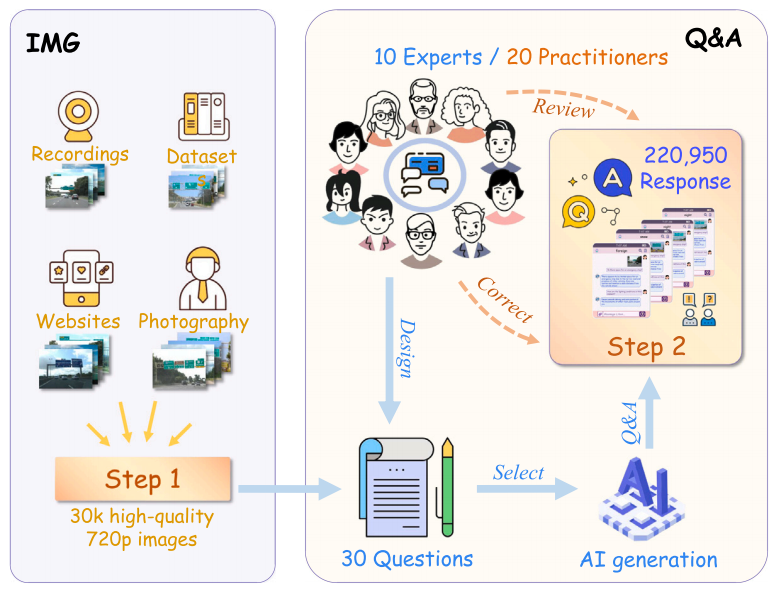
论文指出,现有多模态大模型往往训练于通用图文数据,对特定交通场景的适应性差。为此,作者提出了Traffic‑IT数据集,涵盖 30 000 张交通图像和 220 950 组问答对。该数据集在天气、地点、时间等维度提供了丰富的交通场景,问题不仅关注视觉描述,还包含驾驶策略等决策信息。数据收集采用 “采集—提问—改进” 三步法:先从行车记录仪、网络公开数据等渠道收集高质量图像;后由专家设计30类问题,并利用 GPT‑4 为每张图像生成6–10个回答;最后由20名交通领域从业者审核答案,确保准确性和完整性。
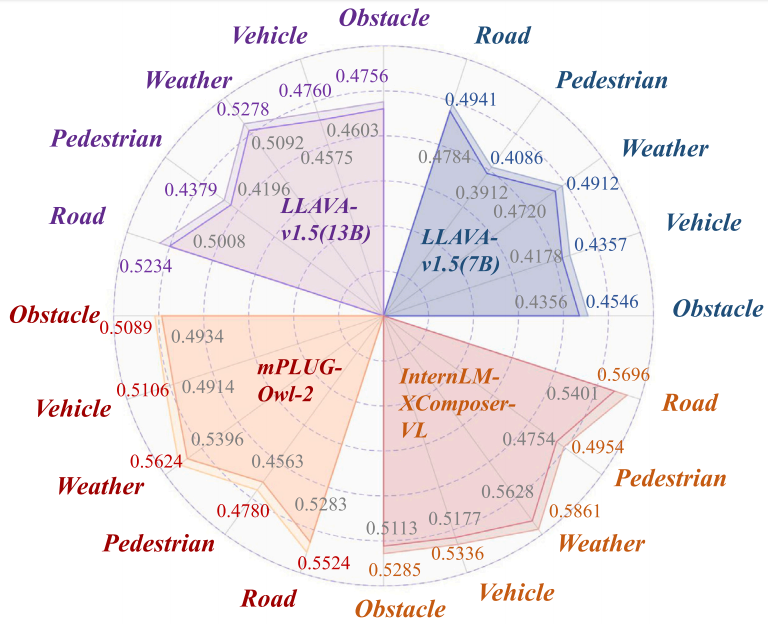
实验中,作者将 Traffic‑IT 用于微调 LLaVA、mPLUG‑Owl‑2 和 InternLM‑XComposer‑VL 等模型,并使用余弦相似度、ROUGE‑L 和 GPT‑4 打分三种指标进行评估。结果显示,经过 Traffic‑IT 微调后,模型在障碍物、车辆、天气、行人和道路状况五类问题上均有显著提升,最高提升幅度超过 5%。
一、研究背景与问题
1.1 交通场景理解的重要性
智能交通系统需求:随着城市交通智能化,自动驾驶和智能基础设施需要对道路状况做出实时、准确的决策。然而,现有模型针对某一场景训练,难以迁移至新环境。 方法局限:传统研究关注车道检测、路面分割等局部任务。这些方法通常依赖昂贵的高精地图或针对单一任务的数据,缺乏对整体场景的理解能力。 新范式出现:多模态大模型 (MLLMs) 通过联合编码图像和文本,在其他领域展现出强大的泛化能力。但缺少交通专用大规模指令数据集限制了它们在交通领域的应用。
1.2 多模态大模型的局限
通用多模态模型多数训练于开放图文对,缺乏对交通场景的结构化理解。 在真实道路环境中,各类天气、地理位置、时间段产生巨大差异,通用模型难以准确描述或做出合适决策。
二、Traffic‑IT 数据集构建
论文提出了一条完整的数据构建流程,将“采集—提问—改进”三阶段串联起来,解决了数据质量、问题设计和答案准确性问题。
2.1 数据收集——多源高质与多样化
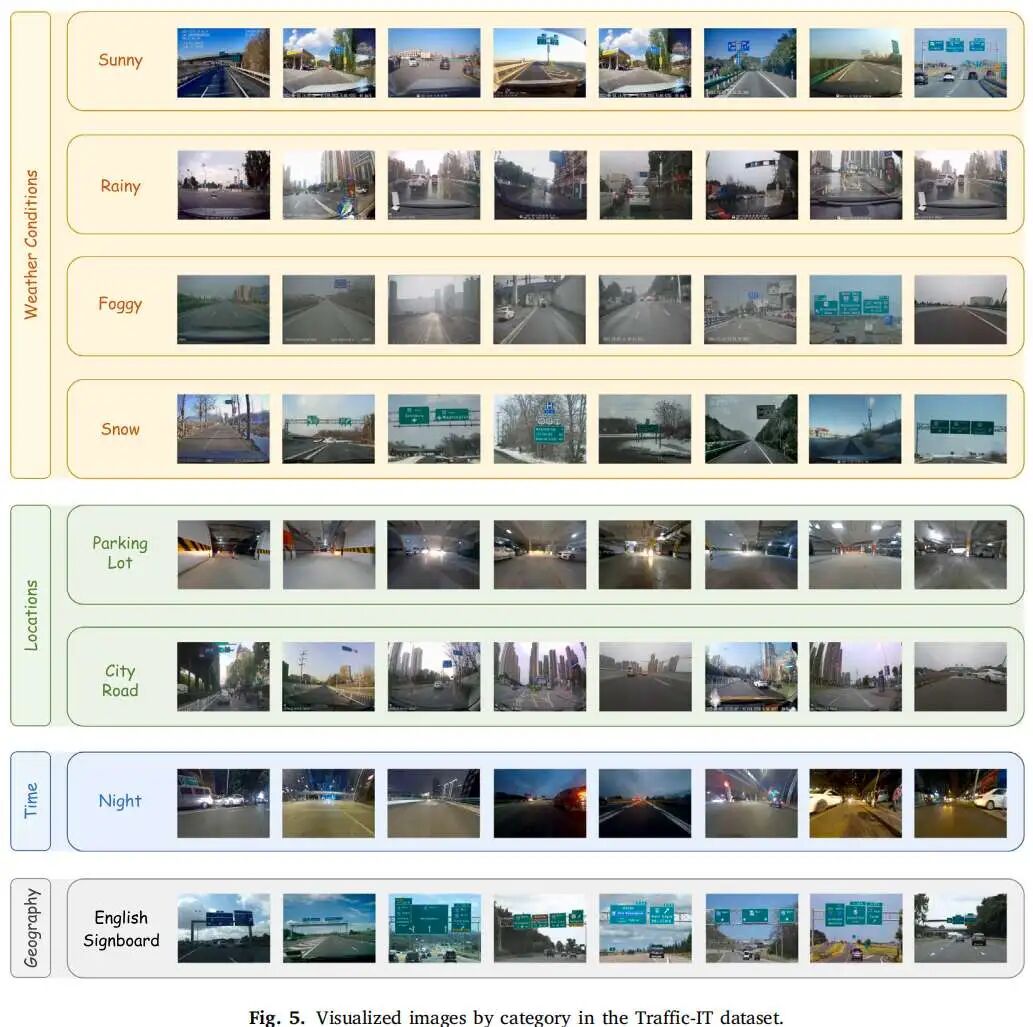
数据来源:从行车记录仪录制视频、开源图像网站、人工拍摄以及既有开源交通数据集四种渠道收集图像。 质量要求:筛选高分辨率、低噪声图像,并涵盖晴天、雨天、雾天和雪天等多种天气,以提升模型对真实交通环境的适应性。 场景多样性:覆盖北京、成都、墨尔本等国内外城市,涉及主干道、支路、街侧、天桥、隧道、乡村道路和停车场等多种道路类型。 数据规模:最终收集 30 000 张高质量图像,其中不仅包含白天夜晚的变化,还覆盖商业区、居民区、工业区、学校、医院等功能区域。
2.2 问题设计——从描述到决策
专家设计:由交通领域专家梳理出 30 种常见交通问题,确保问题覆盖驾驶员关心的关键因素。 问题类型:既包含描述性问题,如道路状况、障碍物、天气、车辆和行人等视觉信息,也有涉及预测性决策的问题,如是否需要减速、是否可以转弯、如何规划行驶策略。 问答生成:对每张图像随机抽取6–10个问题,利用 GPT‑4 生成初步回答。
2.3 答案优化——专家审核提升质量
人工审核:20位交通领域从业者对 GPT‑4 生成的所有问答进行逐条校对。 评价标准:审查过程关注“与图像内容一致性”“回答完整性与相关性”以及“语言清晰度”三项指标。 一致性检验:采用 Cohen’s κ 评估标注者一致性,值达到 0.80,说明标注可靠。 修订率:约10% 的问答需要修改,90% 可以直接使用。 结果规模:改进后的数据集中包含 220 950 组问答对,为模型提供了丰富的监督信号。
2.4 与现有数据集对比
规模与深度:虽然 Traffic‑IT 的图片数量略少于 NuScenes‑QA,但问答总数接近 22 万,远多于 SUTD‑TrafficQA。 回答形式:Traffic‑IT 采用开放式问答,答案由模型生成并经专家修订,而 NuScenes‑QA 多为模板化短答,SUTD‑TrafficQA 为选择题,这限制了决策解释。 场景维度:覆盖天气、时间、地域、道路结构和城市功能区等多维度,远高于其他数据集。 指令类别:围绕道路状况、障碍物、天气、车辆和行人五类指令,强调驾驶决策需求。
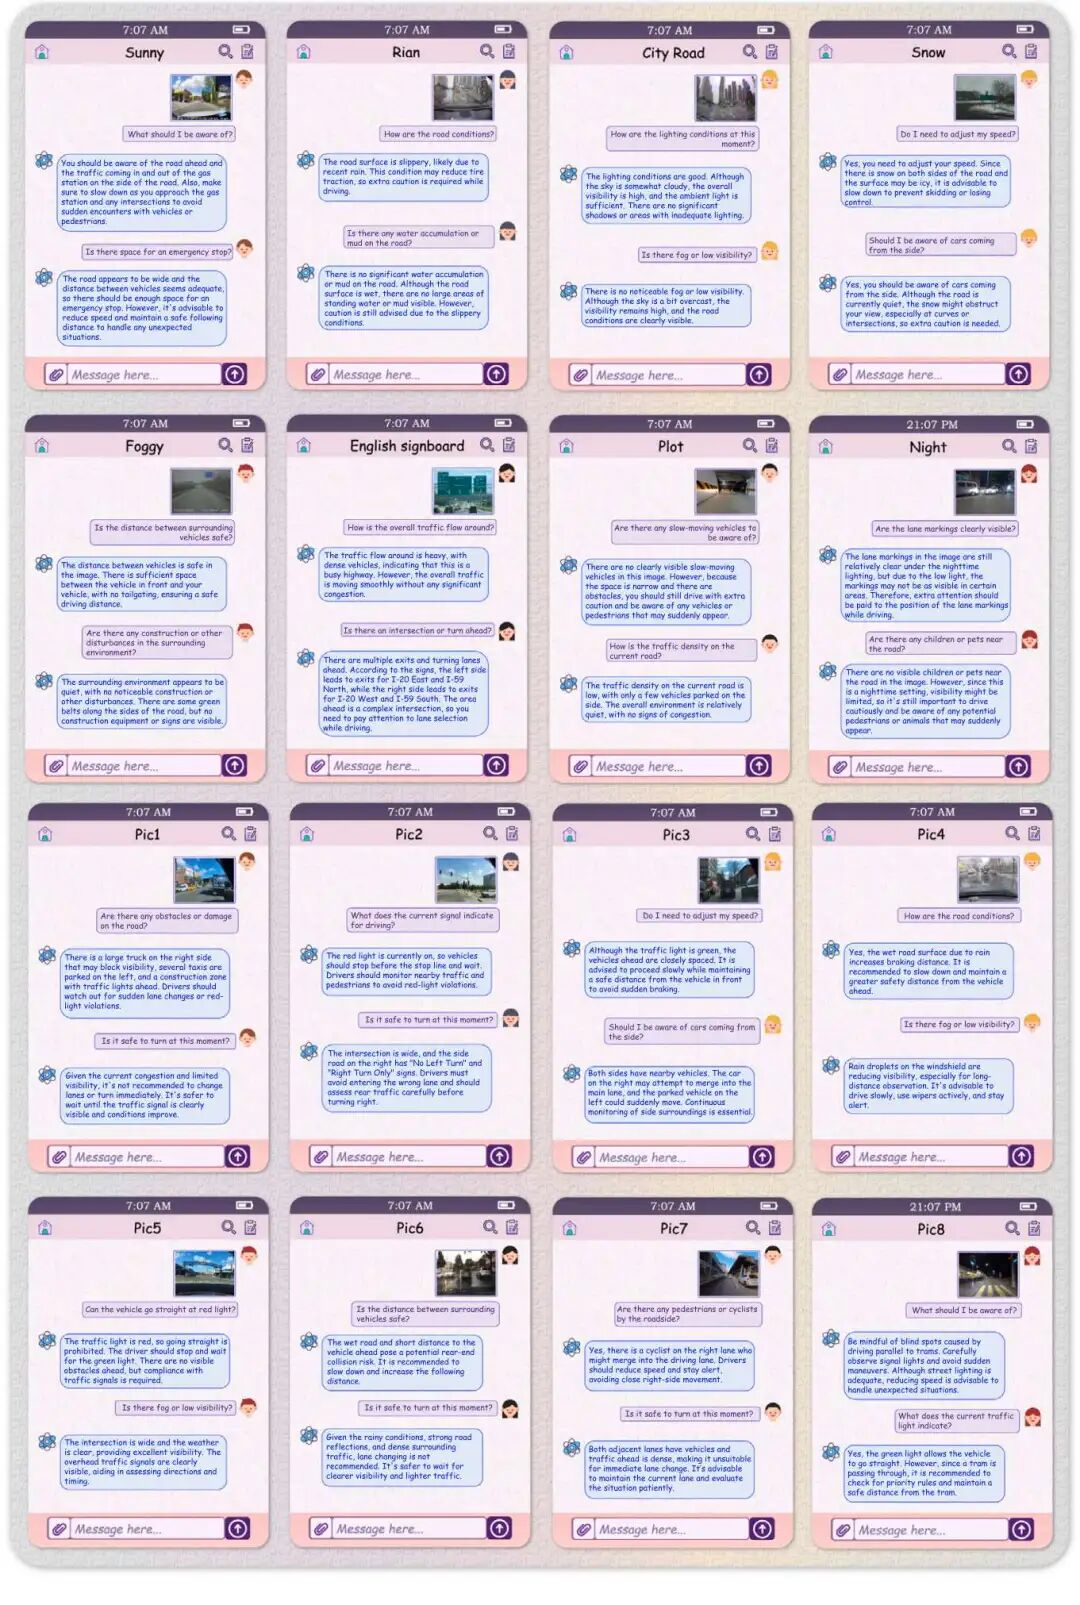
下图展示了 Traffic‑IT 数据集中图像与问答的可视化示例,每个对话框包含一张场景图片和对应的问题回答:
三、实验设计与结果
3.1 实验设置
模型选择:选用开源的 LLaVA‑7B、LLaVA‑13B、mPLUG‑Owl‑2 和 InternLM‑XComposer‑VL 作为基线模型。 训练方式:按照各模型官方设定进行微调,采用 Traffic‑IT 24 600 张图片为训练集,5 400 张图片为测试集。 评估指标:综合使用余弦相似度(Cosine Similarity)、ROUGE‑L 和 GPT‑4 直接打分三类指标。
3.2 性能评估指标
三种指标关注文本相似性和语义对齐度:
余弦相似度:将生成答案和真实答案转换为 TF‑IDF 向量,计算夹角余弦值其中 与 分别是生成答案与真实答案的向量。 ROUGE‑L:关注最长公共子序列长度,衡量序列重叠 GPT‑4 打分:直接利用 GPT‑4 比较生成答案与参考答案的语义一致度,按照 0–10 分量化,并给出简要理由。这种 AI 评分与人工评判高度相关,是对传统指标的有力补充。
3.3 结果分析
整体提升显著:Traffic‑IT 微调使模型在五类问题上平均提升 2.7%~5.9%,LLaVA‑7B 的行人识别提升 4.43%,LLaVA‑13B 的道路状况识别在余弦相似度上提升 5.83%。 模型对比:mPLUG‑Owl‑2 和 InternLM‑XComposer‑VL 在天气和道路条件问题上改善显著,最高提升达 5.90%。 雷达图展示:论文提供的雷达图直观显示五类指令的提升幅度,微调后的模型在各维度上均优于基线版本。
3.4 消融研究与讨论
数据规模影响:逐步增加训练样本数量(4000→24 600)可持续提升模型理解能力。 专家改进的重要性:未经过专家校对的数据集会导致模型表现波动大,证明人工改进环节不可或缺。 评分鲁棒性:引入 DeepSeek‑R1 评分验证,结果与 GPT‑4 高度相关,说明评估方法具有普适性。
四、创新点与未来展望
4.1 创新贡献
首个交通场景指令微调数据集:Traffic‑IT 面向多模态大模型设计,强调开放式问答与决策信息,是国内外首个针对交通场景的指令调优数据集。 完整的数据生成管线:提出采集—提问—改进三阶段流程,从源头保证数据质量与多样性,提供可借鉴的标准。 专家参与与多维覆盖:结合 GPT‑4 生成与专家审核,实现高质量问答;覆盖天气、地域、道路结构等丰富维度。 应用验证:实验证明 Traffic‑IT 显著提升多模态模型在交通场景的理解能力,为智能交通系统部署提供有力支持。
下图展示了数据集的构建流程:左侧代表多位专家制定问题框架,右侧是利用 GPT‑4 生成并校对问答的示意。
另一图展示了数据集中各类场景的图像示例,涵盖不同天气、道路类型和时间段,体现了数据的丰富性。
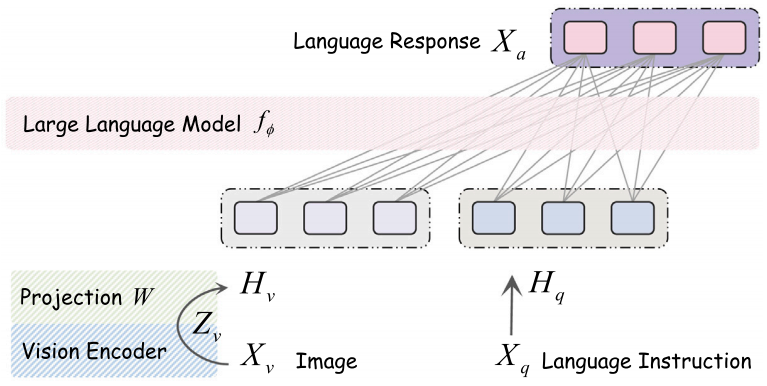
此外,为了介绍所用模型的结构,论文绘制了 LLaVA 架构示意图,展示了视觉编码器、投影矩阵和语言模型的协同工作。
4.2 局限与改进方向
场景罕见性:极端天气(如沙尘暴)或特定文化交通行为等场景仍不足。 标注偏差:初始问答由 GPT‑4 生成,可能引入语言模型或专家自身的偏见。 缺乏时序信息:目前数据集仅包含静态图像,未来需要扩展到视频以捕捉动态交通变化。 应用推广:作者建议在未来增加多语种注释,并探索模型实时部署于自动驾驶系统。
五、总结
Traffic‑IT 数据集的出现弥补了 多模态大模型在交通场景理解上的短板 。通过多源高质量图像收集、专家主导问题设计与人工审核答案,该数据集提供了覆盖广泛、内容丰富的 220 k 组问答对。这些指令不仅 描述场景 ,还 引导模型做出驾驶决策 。实验表明,利用 Traffic‑IT 微调后的 LLaVA、mPLUG‑Owl‑2 和 InternLM‑XComposer‑VL 在各类交通问答任务上均取得显著提升,验证了数据集的实用价值。未来,扩展罕见场景、视频数据和多语言注释将进一步提升该数据集的适用范围,并推动智能交通系统与自动驾驶技术的发展。
文章须知
推文编辑:单子叶
责任编辑:张仁义
原文链接:https://doi.org/10.1016/j.trc.2025.105325