动态交通决策中的适应性学习:基于LLMTraveler的人类行为演化分析
一 、研究背景与问题提出
1.1 路径选择模型的历史发展
路径选择的重要性 : 路径选择模型不仅用于理解个体出行行为,还支撑交通分配和拥堵管理。 路径层模型(Path‐based models) : 以多条备选路线为决策单元,常先生成可行路集,再在随机效用理论框架下建模。经典生成方法包括 k 短路、链路惩罚、链路删除和受约约束枚举等。多项式 Logit(MNL)模型是最常用的效用分配方式,但假设独立同分布误差的限制促成了扩展 Logit 模型的发展。 链路层模型(Link‐based models) : 通过递归 Logit 将决策拆分为链路级选择,使大网络中的路径生成问题更可控。动态递归 Logit 和深度逆向强化学习进一步解决了时间依赖和高维奖励函数的问题。 日常路由动态 (Day‑to‑Day, DTD) : 实际交通流呈现明显的日常波动,静态均衡难以解释其持续偏离用户平衡的现象。DTD 模型通过模拟驾驶者在多日中的学习与调整行为,能够嵌入预期、有限理性、展望理论、边际效用等行为假设。
1.2 ABM、强化学习与 LLM 的机遇
Agent‑Based Modeling (ABM) : ABM 擅长刻画个体行为及其局部交互产生的复杂宏观现象。但基于固定决策规则,难以体现行为在动态环境中的演化。 强化学习 (RL) : 自主学习策略无需预设规则,是建模 DTD 游戏的热门方法。然而 RL 依赖固定环境分布,泛化到新条件时需重新训练。 大语言模型 (LLM) 的潜力 : LLM 凭借 Transformer 架构和海量预训练数据,展示出模拟人类决策的能力。其 在上下文学习(ICL) 能在不更新参数的情况下,根据自然语言指令和示例生成合理响应,可形式化为其中 为预训练后的模型参数,Context 包含指令和范例。 应用挑战 : LLM 天然的下一个词预测任务与路径选择的学习过程存在差距,需要专门的提示设计与记忆机制才能呈现人类学习行为。此外,大模型计算开销高,轻量开源模型能否实现类似行为尚不清楚。
二、 LLMTraveler 方法及决策框架
2.1 LLMTraveler 架构与记忆系统
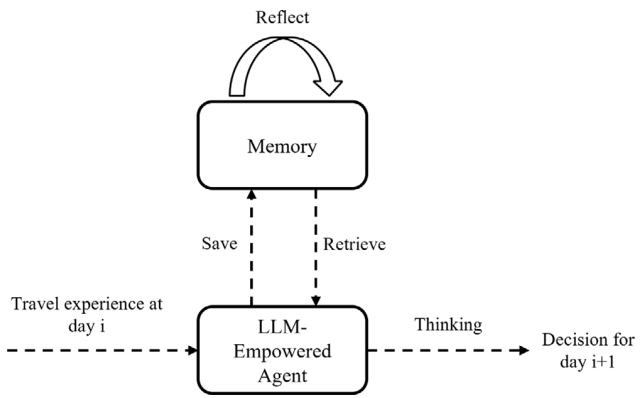
论文提出 LLMTraveler——一个嵌入大语言模型的智能出行代理,包含 LLM 核心和记忆模块。其框架如图 1 所示,代理在每天旅行后将经验存储到记忆中,并在次日决策前检索记忆。此记忆不仅包括历史路线与行程时间,还记录路线被选择的次数。通过循环结构实现从 接收信息→反思→决策 的学习闭环。
2.2 决策过程
LLMTraveler 的决策过程分三步:
接收并更新旅行信息 : 每日根据环境反馈(路线的旅行时间等)更新记忆。 反思过往选择 : 采用经验加权移动平均旅行时间 (EWMATT) 强调近期经验:
其中 为平滑参数, 为第 日观测的旅行时间。
调用 LLM 决策 : 从记忆中提取每条路线的 EWMATT 和选择次数,拼接旅客特征、任务描述及指导提示组成一个自然语言 Prompt,由 LLM 输出下一日选路及其理由。
2.3 提示设计
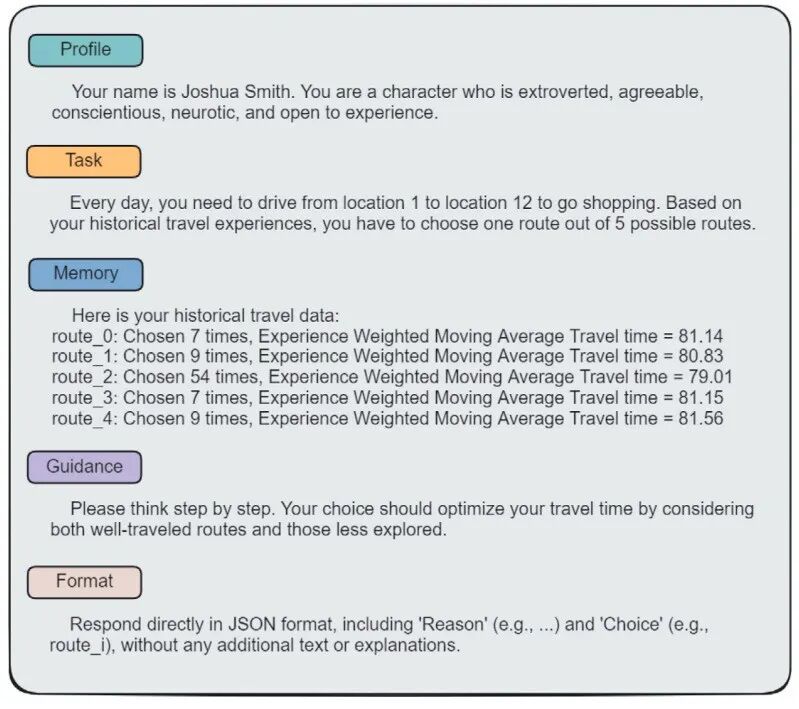
设计 Prompt 是能否逼真模拟人类决策的关键。模板包含:
旅客档案 : 随机生成姓名、性格(外向、随和、尽责、神经质、开放性等)、风险偏好和社会经济属性,用于赋予代理多样人格。 任务描述 : 指明要在数条路线中选择最优路线,并约束输出为 JSON 格式。 旅行经验 : 提供每条路线的 EWMATT 和选择次数,帮助 LLM 调用记忆。 思考引导 : 引导模型“逐步思考”,平衡已熟悉路线与少探索路线的权衡。 输出格式与解释 : 先要求给出理由再给出选择,增强解释性。
这一综合 Prompt 设计在图 2 中有所展示。
2.4 DTD 路径选择建模框架
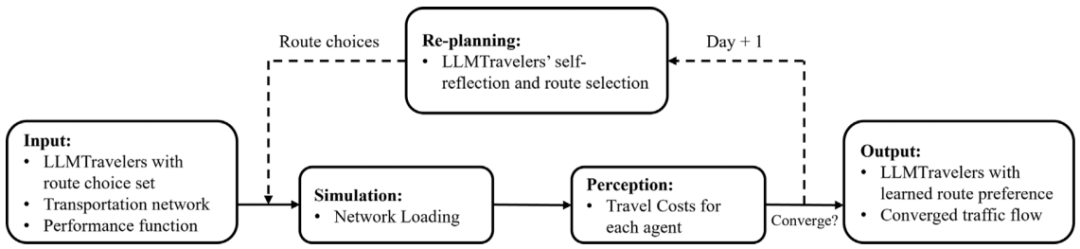
为模拟多日学习行为,作者构建了 DTD 路径选择建模框架,如图 3 所示。核心流程包括:
输入: 交通网络 (节点、边)、OD 需求和基于 k 短路算法得到的候选路线;行程时间由线性性能函数决定:
其中 为第 日链路 的行程时间, 为自由流时间, 为交通量, 为影响因子。
仿真循环: 每日 LLMTraveler 根据记忆选择路线,网络加载后计算每条链路的行程时间,旅客感知后更新记忆并在次日重新计划。循环直至达到预设天数或收敛。
三、单 OD 对实验:实验设计与结果
3.1 实验设置与评价指标
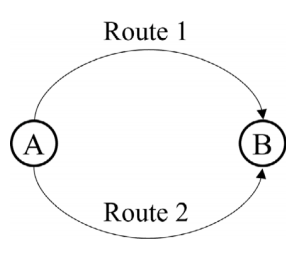
实验采用经典的两路线单 OD 网络(图 4)。16 名旅客每天在两条路中选择,旅行时间随着流量线性增长。设计五个场景,包括对称和非对称成本函数,以考察不同成本差异下的行为。
评价指标:
转换率 (Switching Rate) : 两条路线情况下,旅客从上一日路线 切换到另一条路线 的比例,记为 ,留在原路线的比例为 。 平均转换率 : 对于特定成本组合 ,计算所有对应天次的平均转换率
反映群体平均行为。
与对比模型 : 与完全理性选择模型(PRC)和多项 Logit 模型 (MNL) 比较。MNL 将效用设为 ;“MNL–0.3” 表示 。
3.2 行为规律与结果分析
3.2.1 总体旅行时间
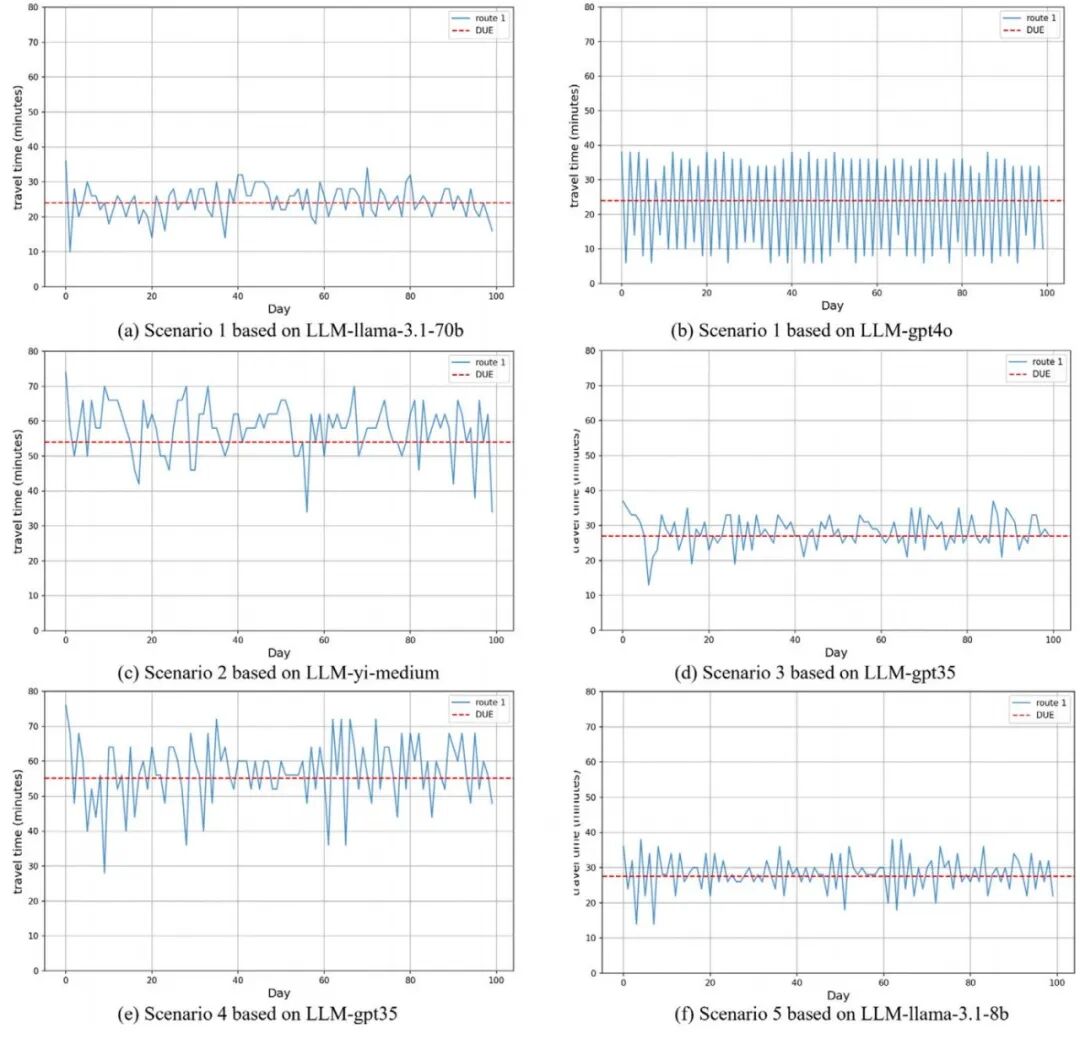
各 LLMTraveler 在五个场景的旅行时间走势如图 5 所示,均能接近动态用户均衡 (DUE);旅行时间波动随着成本函数敏感性增大而增大。
3.2.2 路径转换率与逻辑回归
实验采用逻辑回归拟合双选行为:
其中 为两条路线的旅行时间。拟合结果显示,多数 LLMTraveler 模型的参数显著,能够捕捉成本差异对转换率的影响。
3.2.3 行为模式
对照实验室数据,LLMTraveler 重现了三种路径转换规律:
成本差异越大,转换率越高,即便当前路线更优,也存在跳槽倾向;PRC 模型无法捕捉这一现象。 非对称网络中,两条路线在均衡点的转换率均在 (0,0.5) ,但与实验室数据不同,LLMTraveler 在两个方向上差异较小,显示出模型对两路线敏感性相近。 转换率不仅取决于成本差异,也受上一日选中路线特性影响,例如同样的 20 分钟差异,某方向的跳转率高于反向。 对比模型 : 相比 PRC 和 MNL,LLMTraveler 展现出带随机性的理性行为,能解释未完全趋于均衡的持续波动;同时生成路线选择理由,提高模型的解释性。
3.3 难点与挑战
提示与记忆设计 : 不同 LLM 对提示模板和记忆的敏感性不同,模型大小影响行为随机性。较大模型可能“过度自信”,降低探索。 统计显著性 : 部分模型(尤其是 LLM-gpt35 和 LLM-yi-medium)的逻辑回归系数在某些情景下 p 值大于 0.05,未达到显著水平。 在非对称网络的均衡点,转换率差异不足,表明模型还不能完全重现实验室观察。
四、多 OD 网络实验及拓展分析
4.1 OW 与 SiouxFalls 网络及数据设置
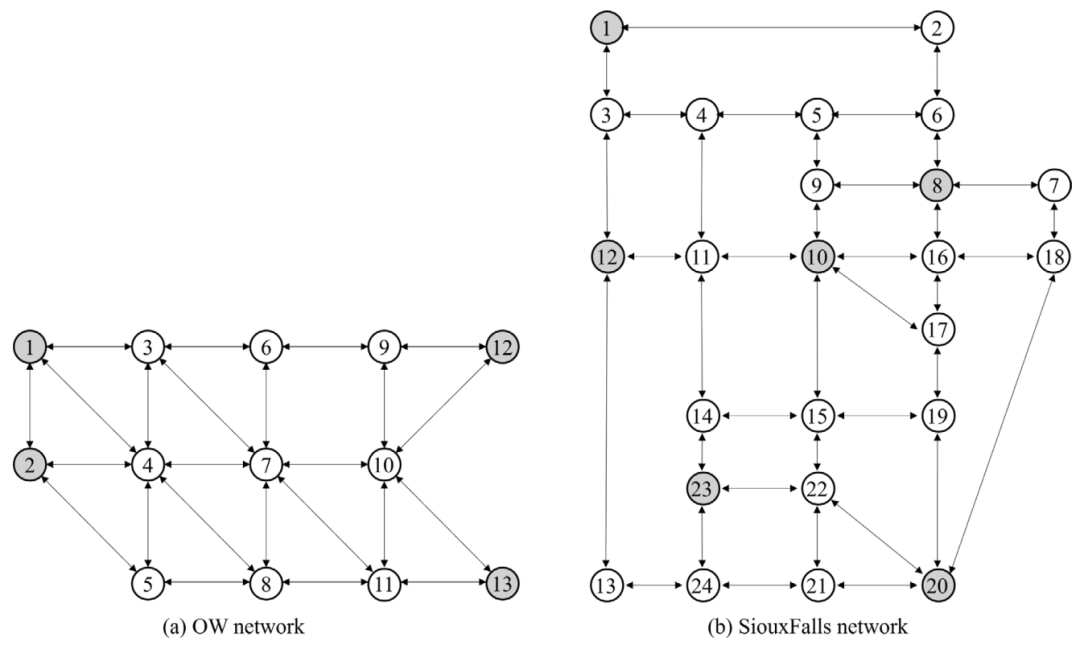
为检验 LLMTraveler 在复杂网络中的适用性,作者在四 OD 点的 Ortúzar–Willumsen (OW) 网络和更大规模的 SiouxFalls 网络上进行了实验。OW 网络有 13 个节点、48 条双向边,四个 OD 对共 1700 名旅客,采用线性性能函数 。每个 OD 对利用 k 短路法生成 5 条候选路线;为了减少计算量,一个 LLMTraveler 代表 名旅客 (测试 10/20/50),实验表明 的变化不影响收敛,故后续取 。
SiouxFalls 网络包含 24 个节点、76 条边和 30 个 OD 对,需求高达 18 万。为可行性,实验仅选取 6 个主要节点作为 OD 点,每个 OD 对 6000 人,且每个 LLMTraveler 代表 600 人,总计 300 名代理。
4.2 聚合层面行为
4.2.1 评价指标
平均旅行时间 : 所有旅客在同一日的平均行程时间。 日转换率 (Day Switching Rate, DSR) : 当日改变路线的旅客比例:
其中 为总旅客数, 为从第 日到 日换路的旅客数。
4.2.2 结果分析
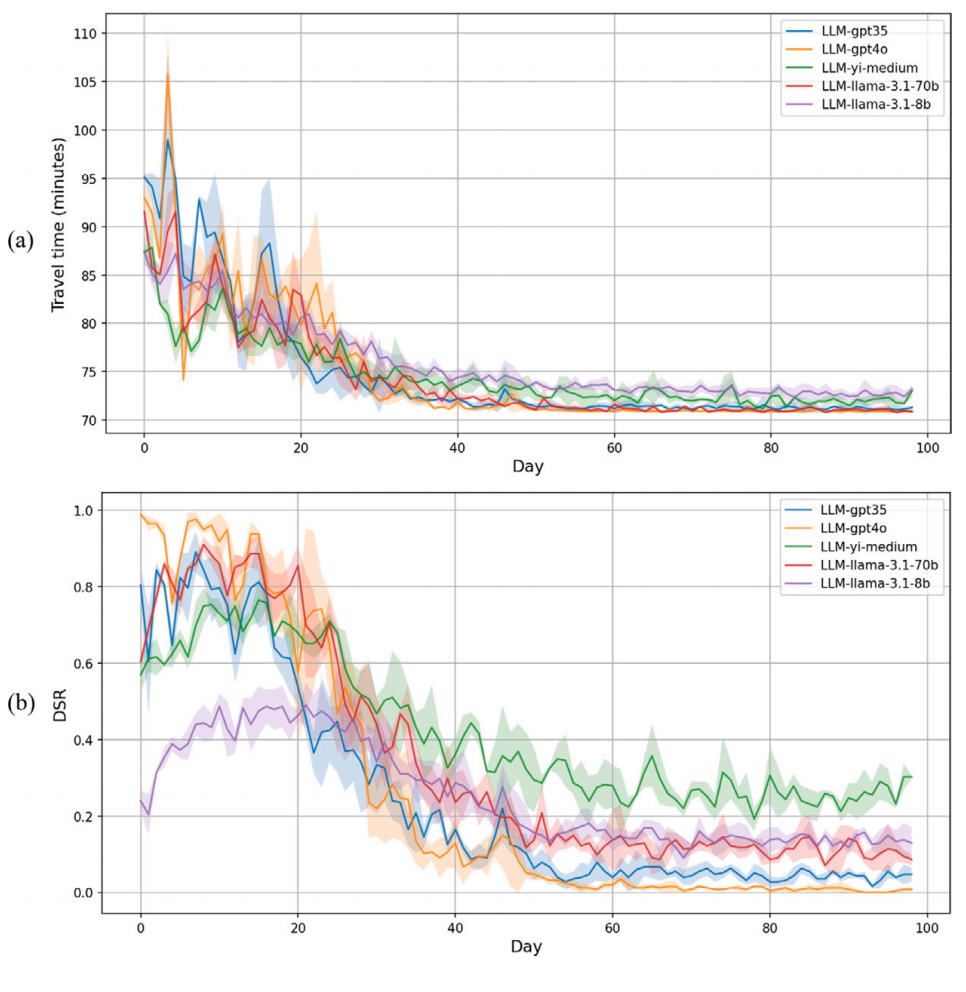
旅行时间与 DSR 走势 : 图 7 显示各 LLMTraveler 在 OW 网络上平均旅行时间迅速下降并趋近均衡值,但仍保持一定波动;DSR 初期升高后下降并趋于稳定,多数模型在第 100 日 DSR < 0.2。
4.2.3 学习阶段划分
作者将旅客学习分为三阶段:
探索阶段(1–20 日):缺乏经验,随机选择多条路线。 探索与开发并行阶段(21–60 日):在利用已知较优路线的同时尝试较少探索的路线。 开发阶段(>60 日):大部分时间选择 EWMATT 最低的路线,但仍保留少量探索,造成轻微波动。
4.2.4 模型大小影响
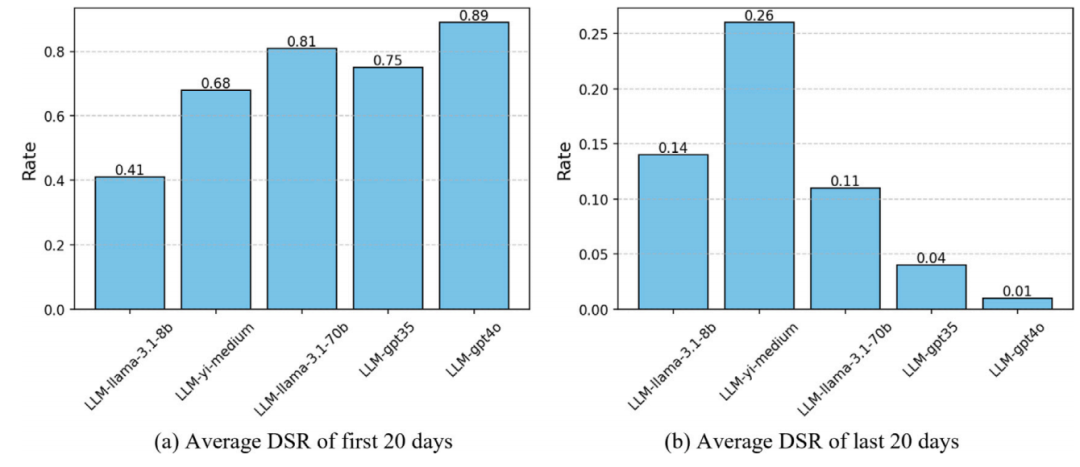
图 8 指出,前 20 日 DSR 随模型参数量增加而增大,而后 20 日 DSR 反而随模型大小减小。较大模型由于人类反馈微调,倾向于快速收敛并减少探索。开源小模型因随机性较大,在后期仍保持较高转换率。
4.3 个体层面行为与记忆
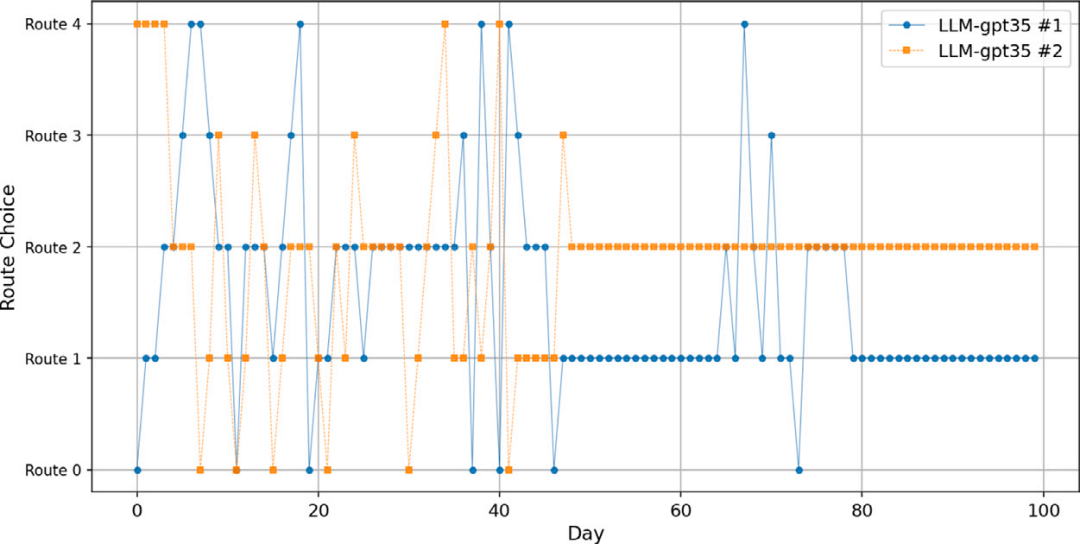
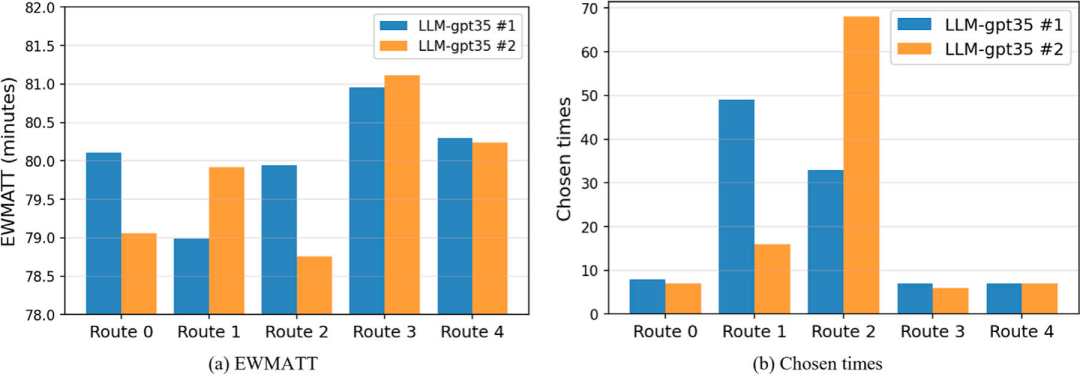
图 9、图 10 展示两名基于 GPT‑3.5 模型的代理在同一 OD 对上的学习路径。两名代理分别从不同起始路线出发,经历了相反的探索顺序,最终分别锁定不同的最优路线(路线 2 与路线 1),其记忆中路线的 EWMATT 和选择次数分布不同。这一现象说明:
个体代理的早期探索顺序会影响其长期偏好; 虽然对各路线的平均 EWMATT 差异很小,但选择次数差异很大,体现记忆塑造行为; 所有路线至少被尝试数次,符合现实旅客偶尔尝试新路线的现象。
4.4 与 MNL 与 RL 方法对比
在 OW 网络上比较 LLMTraveler、MNL 和强化学习 (RL) 方法:
收敛速度 : MNL 由于将所有经验聚合,初期收敛最快,但缺乏波动;RL 和 LLMTraveler 则在平衡探索与开发中展现更真实的逐日调整。 平均旅行时间 : 三者最终的平均旅行时间相近 (~71.1 分钟)。LLMTraveler 和 RL 在稳定后仍保持轻微随机性,使平均行程时间略低于 MNL。 学习效率 : LLMTraveler 在早期学习阶段的行程时间下降速度快于 RL,表明提示驱动的思考能加速策略形成。
4.5 路径数量影响的稳健性分析
作者通过改变每个 OD 对的候选路数 (=5、10、15) 检验鲁棒性。利用 Jaccard 相似度 衡量新增路线与最短路径的重叠:
结果表明增大 提供了更多结构多样的替代路线,但也增加学习时长。多数模型 或 时能达到更低的平均旅行时间,但如 GPT‑3.5 模型在 时反而退步,因为过度集中于少数路线,探索不足。
4.6 大规模网络验证
在 SiouxFalls 网络上,LLMTraveler 仍表现出稳定的日常适应性并比 RL 基线更快收敛,说明该方法具有一定的可扩展性。不过论文指出此研究主要关注行为演化而非大规模交通均衡,未来需要更多轻量模型和算法来提升可扩展性。
4.7 挑战与思考
模型尺寸与推理温度 : 大模型因 RLHF 调整,可能呈现过度自信、探索不足;推理温度等参数会影响探索–开发平衡。 提示设计适应性 : 不同 LLM 对 Prompt 模板反应不同,需针对模型特性定制提示,以避免集中于少数路线。 计算代价 : LLMTraveler 相比传统 ABM 更耗时,代理数与模型规模加剧计算负担。
五、讨论与结论
5.1 扩展性与应用场景
LLMTraveler 展现了在不同规模网络中的适用性。除了路径选择,它还能用于:
数据驱动行为建模 : 通过上下文提示,可在缺乏调查数据时生成合成出行响应,用于新政策预测。 政策仿真分析 : 模型能模拟实施拥堵收费、票价调整等干预前后的个体和系统反应。 集成优化框架 : LLMTraveler 可嵌入交通分配、服务调度或时刻表优化模型中,作为行为反馈模块。
5.2 可解释性与行为真实性
LLMTraveler 在输出中提供路线选择理由,反映其依赖 EWMATT 和选择次数进行权衡的思考过程。这些解释提高了透明度,但是否符合真实旅客的心理仍有待实证验证。未来可结合真实调查数据校准模型性格与行为偏好。
5.3 研究贡献与未来方向
论文首次将大语言模型引入日常路径选择建模,并提出 LLMTraveler 框架,创新点包括:
设计包含个性、记忆和思考引导的综合 Prompt,利用 ICL 能力模拟逐日决策行为; 构建 DTD 路径选择模型并在单 OD 与多 OD 场景中验证,发现其能复现实验室观察的多种行为规律,同时提供可解释的选择理由; 展示轻量开源 LLM 与大型闭源模型在表现上的差异,说明小模型在一定条件下也能有效模拟人类出行行为。
存在的局限包括仅针对路径选择的单一决策,缺乏对出行方式、出发时间等多维决策的集成;未考虑天气、事故等外部因素;以及计算效率需提高。未来可探索将 LLMTraveler 扩展到更多出行决策,利用轻量模型提高可扩展性,并结合实证数据提升行为真实性。
文章须知
推文编辑:单子叶
责任编辑:张仁义
原文链接:https://doi.org/10.1016/j.trc.2025.105307