
大语言模型融合安全交通决策:LLM驱动的交通事故风险建模与决策干预体系
一、研究背景与问题提出
交通事故始终是公共卫生的重要危机。美国 2022 年有 42 795 人死于交通事故——在发达国家中死亡率最高,并且长期呈上升趋势。现有方法大多基于统计学或单一模态的机器学习:宏观模型只能识别高危区域而不能解释具体“谁、何时、为何”;微观模型虽能预测特定情景,却难以融合文本、数值、图像与驾驶历史等多模态信息。此外,常见深度学习模型黑箱性强,缺乏可信度估计与解释能力,这限制了其在高风险决策中的应用。
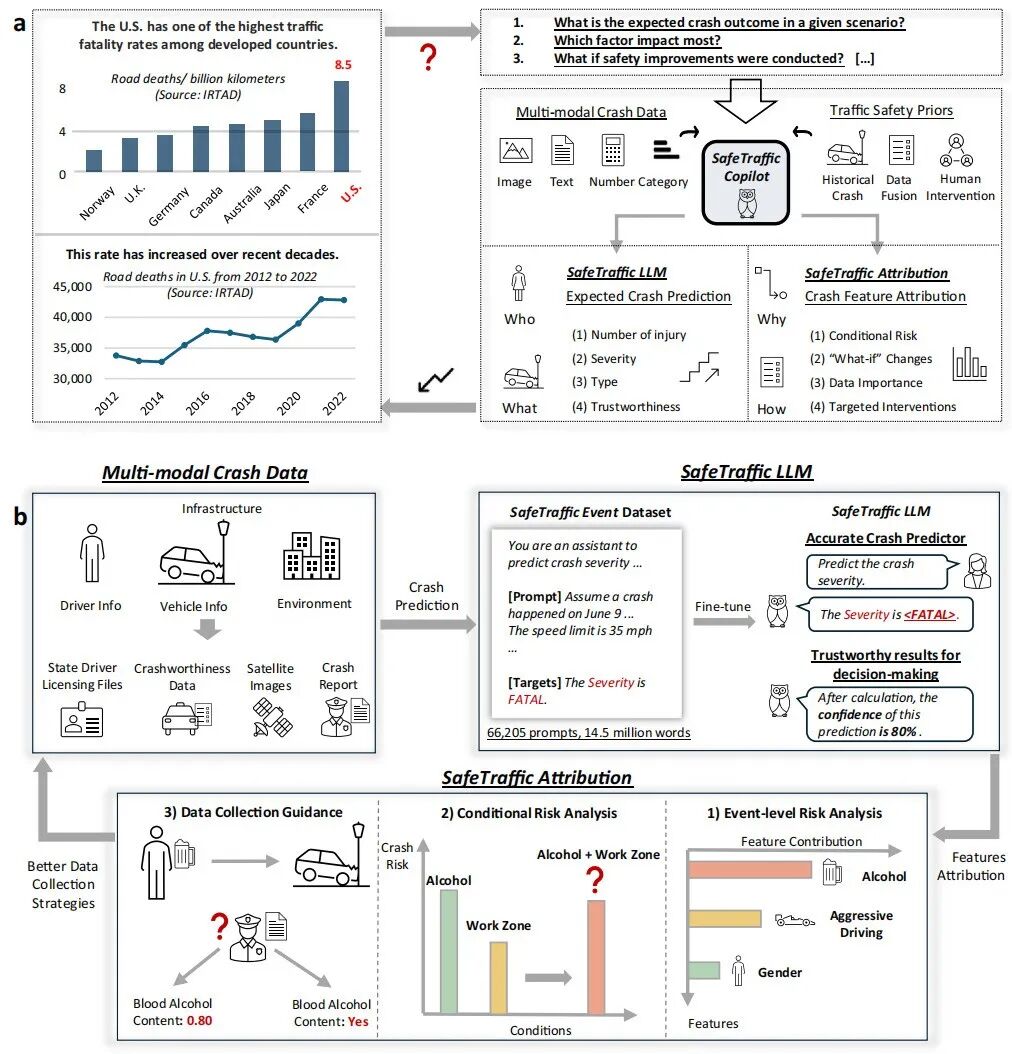
SafeTraffic Copilot 应运而生。该框架通过多模态信息融合和语言模型定制,将事件级交通事故预测转化为文本推理任务,既提供精准预测,又能解释风险因子及其组合,支持决策者开展“假如”分析和数据采集优化。图1 给出了项目的宏观背景与框架。
下图展示美国道路死亡率以及 SafeTraffic Copilot 的总体框架和任务流程,可见研究的目标是利用多模态数据与大模型完成事故预测与特征归因,服务决策改善。
二、SafeTraffic Copilot 框架与方法
2.1 整体架构与任务
SafeTraffic Copilot 的核心由两部分组成:SafeTraffic LLM 和 SafeTraffic Attribution。前者针对多模态事件数据进行预期事故预测,后者采用句子级 Shapley 值为模型输出提供解释和风险分析。框架回答三个关键问题:
预测问题: 在给定条件下的预期伤亡人数、伤害严重程度和事故类型。 风险归因: 哪些因素对结果贡献最大?风险因素在不同组合下如何变化。 干预评估: 改善某个因素(如禁止酒驾)后风险如何变化。
2.2 SafeTraffic Event 数据集构建
为适配语言模型,研究团队将原始多模态事故数据加工成文本化的 SafeTraffic Event 数据集,包含 66 205 条事故记录、约 1450 万词。数据来源包括 HSIS 事故数据库、州警察报告、驾驶人档案、车辆安全性数据以及卫星图像。
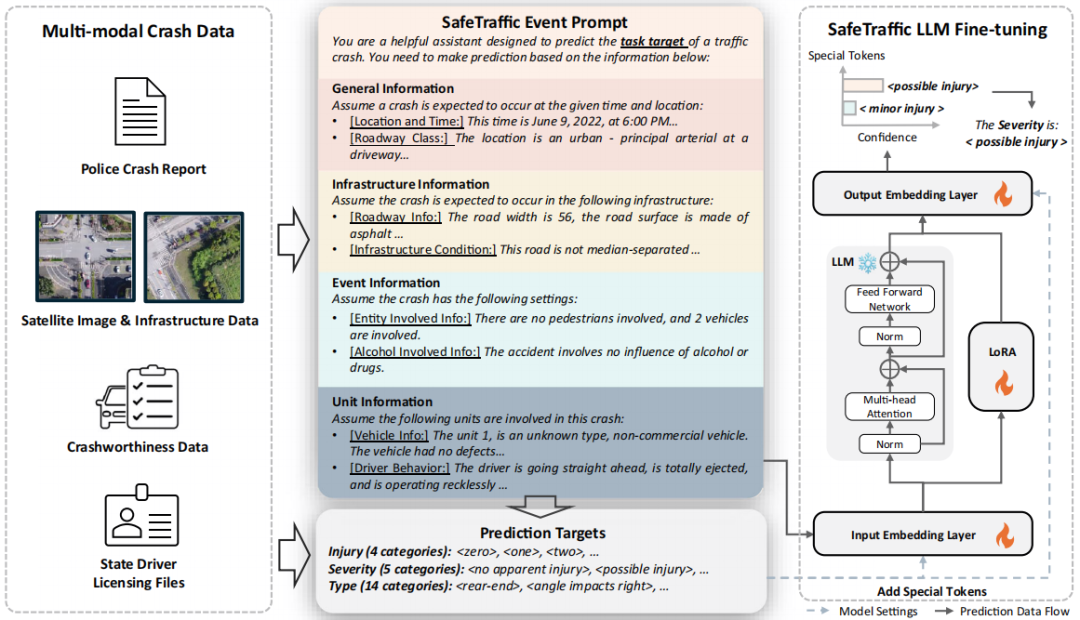
数据处理流程如图2所示(详细步骤在图7中呈现),主要包含四个内容段,每段约 100 字:
系统提示(System prompt): 提供任务说明与输出格式。 一般信息: 包含预测区域和道路类型的时间、地点信息。 基础设施信息: 静态信息如车道数、限速,以及动态条件如施工区、照明和路面状态。 事件信息: 涵盖涉及车辆数量及行驶方向等。 个体信息: 车辆与人员的详细特征,如车型、年份、气囊状态、驾驶者年龄及行为。
处理后数据集中,华盛顿州 2022 年数据 16 188 条、伊利诺伊州 42 715 条;其它州(缅因、俄亥俄、北卡罗来纳)约 7300 条用于跨州零样本测试。数据分割按 7:1.5:1.5 比例用于训练、验证和测试。
2.3 SafeTraffic LLM 模型设计与微调
研究者基于 Llama 3 系列语言模型(8B 和 70B 版本)构建专用的 SafeTraffic LLM。为了将分类任务转化为生成任务,他们在词表中加入特定目标的 特殊标记(如 <ZERO>、<FATAL>、不同类型的碰撞标签),并用 LoRA 技术进行低秩微调:仅更新插入层的低秩矩阵,减少计算资源消耗。模型训练使用交叉熵损失,并按照以下指标评估性能:
置信度评分:模型输出中各标签的概率最大值 。 阈值准确率:在置信度大于阈值 (t) 的样本中,准确率为 其中 为满足置信度阈值的样本数, 为其中预测正确的样本数。 精确率召回率 以及 F1 分数。
基线模型包括随机森林、XGBoost、决策树、CatBoost、逻辑回归、TabNet 和 BERT 等。此外在零样本评估中使用预训练的 Llama 3 模型和 Chain-of-Thought 推理作为对比。
三、模型评估与性能分析
3.1 整体性能
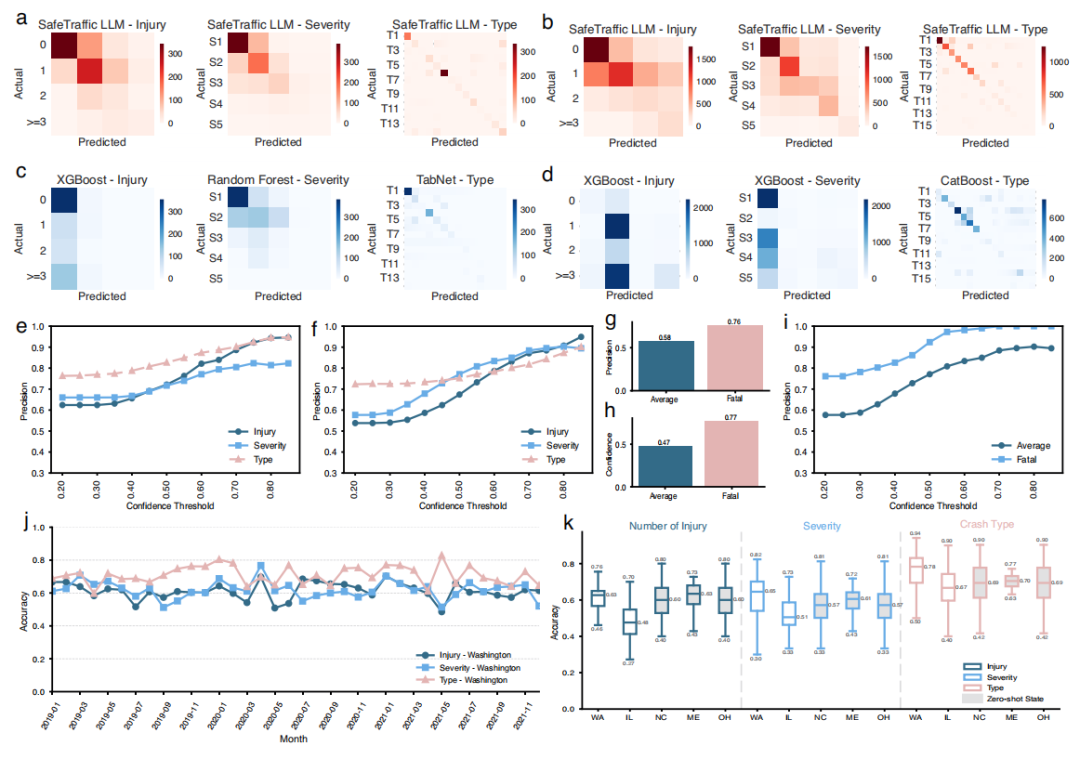
SafeTraffic LLM 在华盛顿和伊利诺伊数据上的表现显著优于基线:F1 分数平均提升 33.3%–45.8%。特殊标记使模型能精确预测伤亡人数、伤害程度和碰撞类型,且精度随置信度增加:当置信度超过 0.60 时,准确率超过 70%,Fatal 类别的精确率达到 95%。
模型预测分布更加平衡。图3展示了 SafeTraffic LLM 与传统模型的混淆矩阵和置信度曲线:LLM 在各类别上的预测较均匀,而传统模型偏向多数类别。置信度越高,准确率越高,印证了置信度作为可靠度量的作用。
3.2 泛化能力
在零样本场景中,模型在北卡罗来纳、缅因和俄亥俄数据上的平均 F1 分数分别为 0.576、0.613 和 0.593。县级评估显示,多数县的准确率与训练州差异仅在 10%–20% 范围内。时间泛化实验将模型训练于 2022 年华盛顿数据,在 2019–2021 年数据上测试,三个任务在 75% 以上月份中的准确率波动不超过 ±10%,表明模型随时间稳定。
四、SafeTraffic Attribution:特征贡献与风险分析
4.1 Shapley 值与特征归因方法
为了解释模型如何做出预测,研究者引入合作博弈论中的 Shapley 值。对于包含 个特征的模型,特征 的 Shapley 值为
其中 表示仅使用子集 特征训练模型得到的性能(如准确率)。
在训练阶段,团队将提示文本划分为系统提示、一般信息、基础设施信息、事件信息和个体信息四类,计算每一类的贡献。训练集结果显示:个体信息(车辆与驾驶者属性)对严重程度预测贡献最高,华盛顿和伊利诺伊分别占 31.4% 和 24.8%。在推理阶段,由于 LLM 输入序列长达约 500 个词,计算全局 Shapley 值复杂度过高且难以解释,因而提出 句子级贡献方法:先用标点将文本分割为句子,再使用 GPT-4o 将句子归类并计算各句对输出概率的边际贡献。其句子级贡献公式为
其中 是 LLM 输出的目标概率。
4.2 单个案例分析
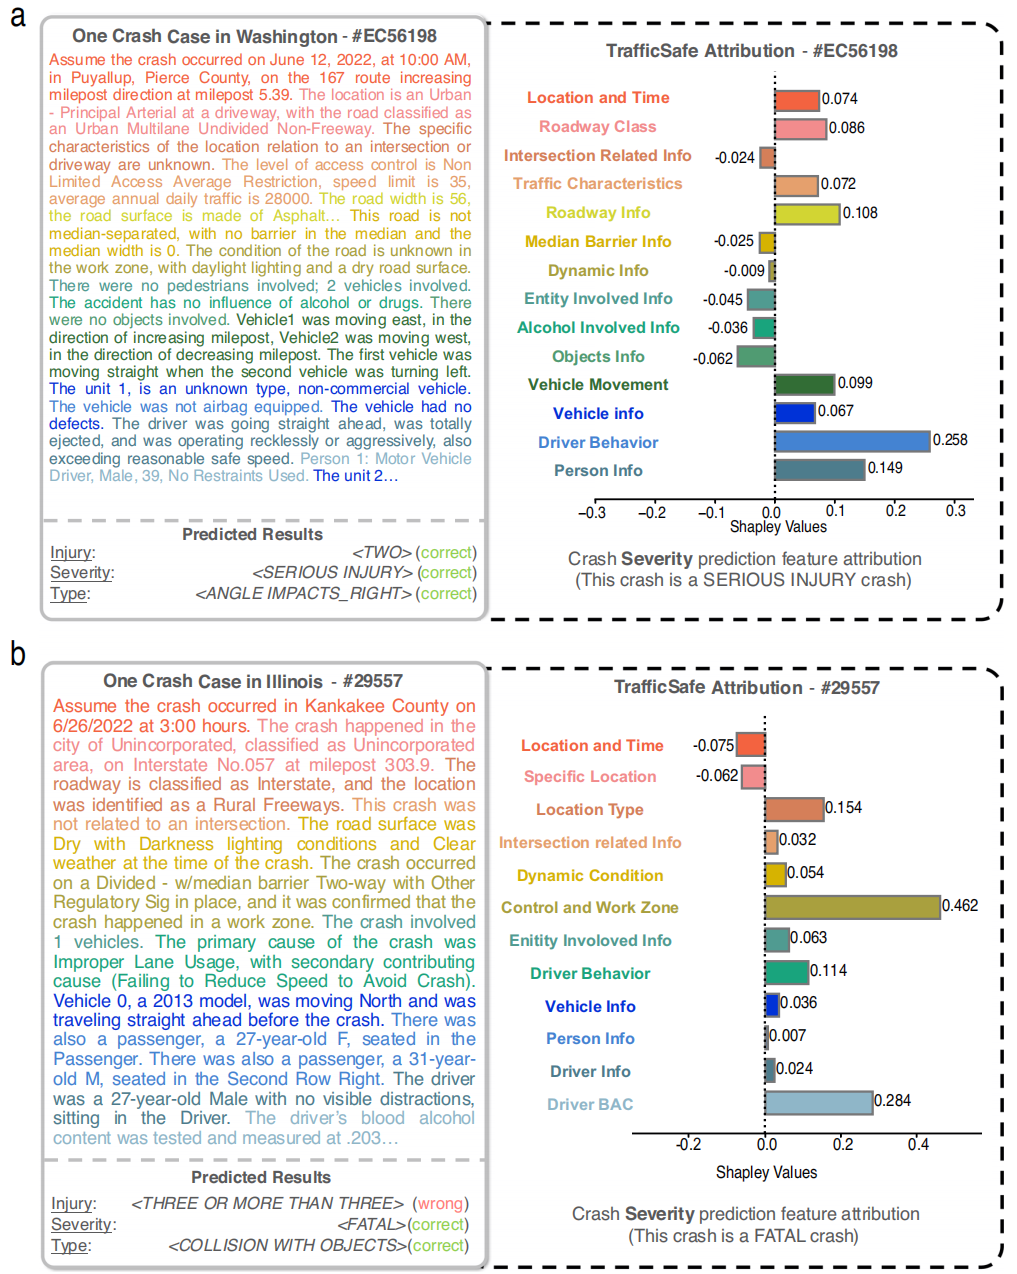
图4 展示了两个案例的句子级特征归因结果。左侧为华盛顿州的一起严重伤害事故,驾驶者鲁莽行驶(超速或超车)是主要风险因素,对预测的正贡献约 0.258,而白天光照条件降低了严重伤害概率。右侧为伊利诺伊州的一起致命事故,驾驶员血液酒精含量高(BAC≥0.08)和发生在施工区是主要促成因素,二者叠加使预测严重程度显著提高。
4.3 条件风险分析与高危组合
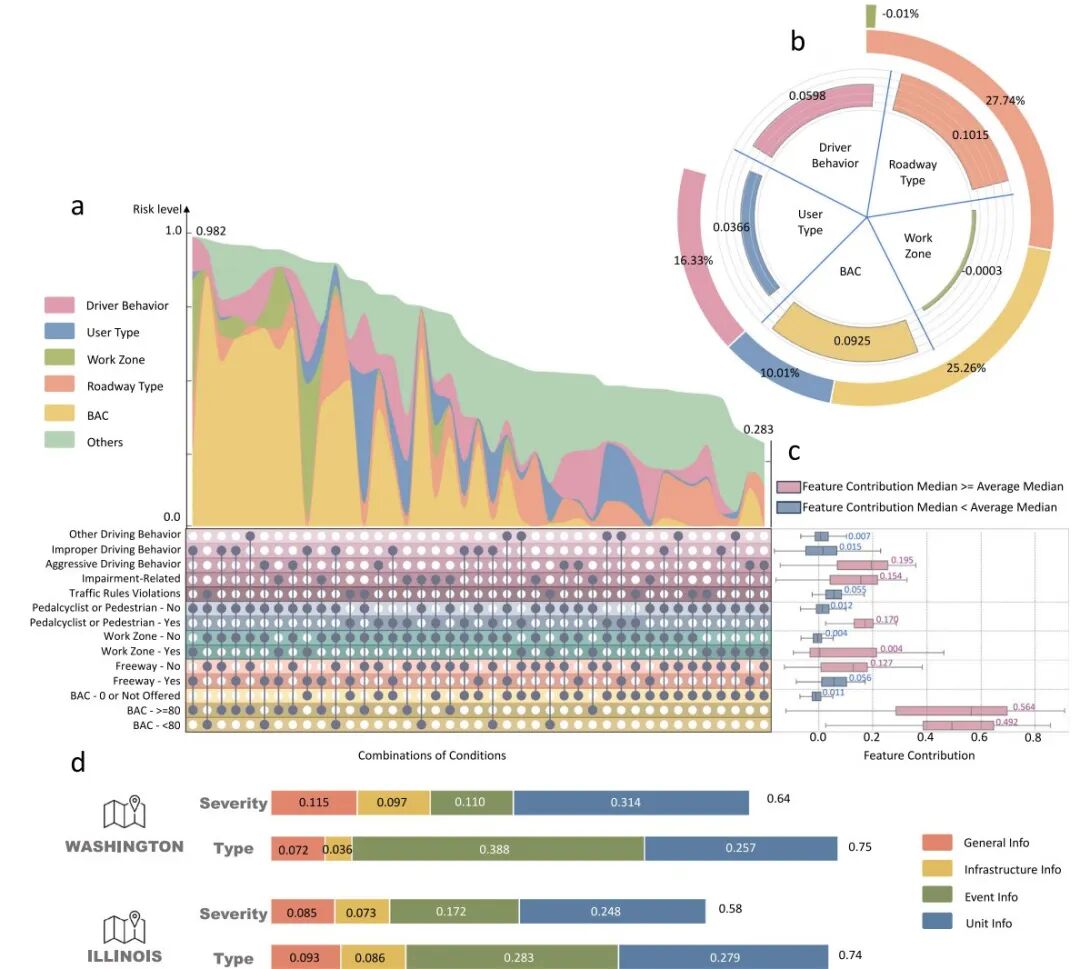
进一步地,研究者统计了重要因素及其组合对严重伤害和致死事故的贡献,如图5 所示。结果表明:
酒精影响(BAC) 是最强风险因素。驾驶者血液酒精含量超过 0.08 mg/dL 时,其对致死风险的贡献高达 0.45,远高于其他因素。 施工区 会显著提升风险。与在正常道路上饮酒驾驶相比,酒驾且位于施工区的事故严重等级平均升高 0.47,致死风险大约翻倍。 攻击性驾驶行为(急加速、抢道)使严重伤害风险几乎增加三倍,是道路行为类贡献最大的因素。 通过绘制风险组合图,发现多个风险因素叠加时风险水平呈叠加或乘性增加,如“酒精 + 施工区 + 行为不当”组合的风险最高。图中的弦图和箱线图同时给出了各因素总体贡献的中位数和四分位范围。
4.4 多模态信息融合效用
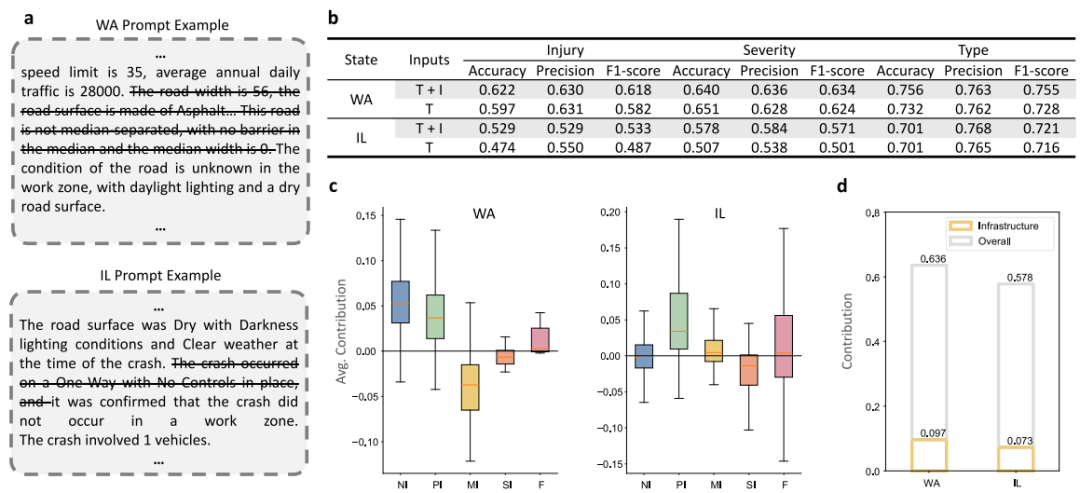
除了文本信息,研究团队探索了卫星图像与基础设施特征的作用。图6 对比了使用文本+图像(T+I)与仅用文本(T)的预测效果:在华盛顿数据集中,多模态输入的准确率、精确率和 F1 均明显高于仅文本输入,表明图像提供了路网结构和环境条件的补充信息;而在伊利诺伊数据集中,两种输入差异较小。句子级贡献分析亦显示,卫星图像段落在华盛顿州案例中的贡献中位数为 0.115,而在伊利诺伊州则较低。
五、方法实现与技术细节
5.1 数据映射与文本化流程
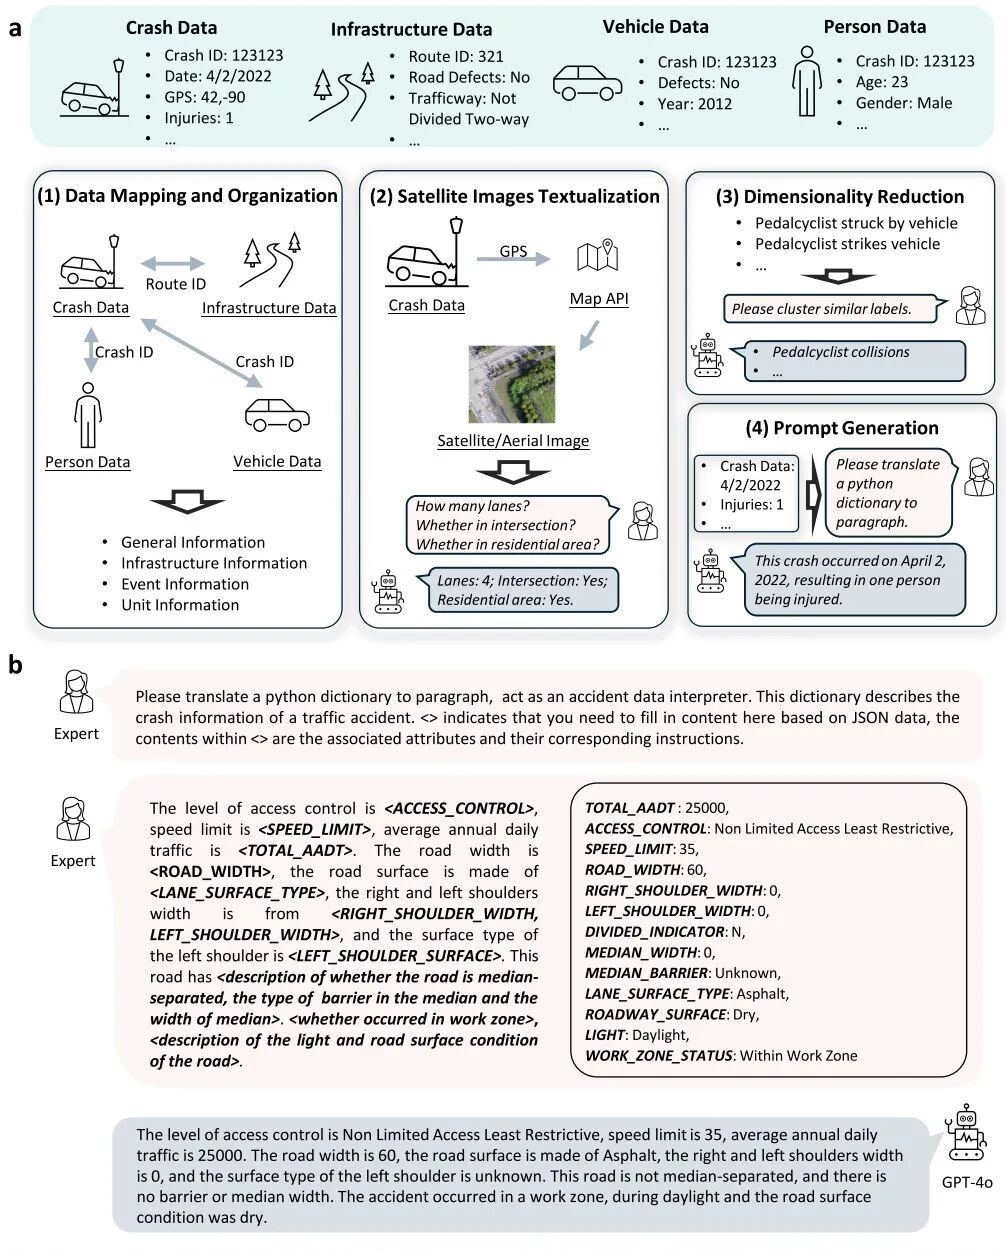
图7 展示了构建 SafeTraffic Event 数据集的具体流程,包括:
数据映射与整理: 将事故、基础设施、车辆和个人四类数据按 CrashID 和 RouteID 关联,整合为一般信息、基础设施信息、事件信息和个体信息四部分。 卫星图像文本化: 利用 Google Maps API 提取事发地点卫星图,识别车道数量、是否位于交叉口或居民区等,并由 GPT-4o 编写描述。 维度缩减: 使用专家标注和 GPT-4o 聚类合并相似分类,如将“骑自行车者撞车”与“被车辆撞击的骑自行车者”合并,减少类别数量并统一语义。 提示生成: 将数值对和键值对翻译成自然语言段落,形成最终的文本化提示模板。
5.2 LLM 微调与训练细节
在微调过程中,完整提示由系统提示、用户提示和目标提示组成。生成式任务通过拼接 <TARGET> 标记实现:给定输入 和目标标签 ,构造提示 并训练模型预测目标标记。LoRA 微调在每个 transformer 层中引入秩为 8 的低秩矩阵,搭配 4 位量化和分段冻结技术,使训练更高效。
数据划分时,针对严重伤害类别不平衡,采用重采样策略平衡训练集;华盛顿数据 16188 条均衡后拆分为训练、验证和测试;伊利诺伊数据同样处理。
六、困难与挑战处理
黑箱模型的可信度与解释性不足: 作者通过引入置信度评分和 Shapley 值归因框架,为每次预测给出可量化可信度及对输入的贡献分析。 生成式 LLM 不适合离散分类输出: 通过在词表中添加特殊标记并采用 LoRA 微调,成功将生成任务转化为预测任务,同时保持大模型的语言理解能力。 多模态数据融合难度大: 使用 AI-专家协作的文本化流程将结构化数据、图片和非结构化文本统一编码。 Shapley 值计算复杂度高且难以解释: 针对 LLM 输入长、上下文依赖强的特点,提出句子级采样估计,既降低计算量,又保持可解释性。 跨州特征异质性和缺失值: 通过模板转换、缺失补全和统一分类,将缅因等州的记录映射到伊利诺伊模板以支持零样本测试。
七、研究结论与管理启示
SafeTraffic Copilot 实现了事件级条件事故预测与解释的重大突破。其主要贡献包括:
准确性与稳定性显著提升。 使用 66 205 条多模态数据训练的 SafeTraffic LLM,在三项任务中 F1 分数平均提高 33.3%–45.8%,并在高置信度阈值下取得超过 80% 的准确率。模型在未知州和历史年份上的泛化能力良好。 可信度和解释性结合。 引入置信度评分与句子级 Shapley 归因,使模型成为可解释的高风险决策工具,指出高危因素(酒精、施工区、行为不当等)并量化其贡献。 条件风险分析与“假设”评估。 SafeTraffic Attribution 能模拟“如果禁止酒驾或改善工作区管理,风险将如何变化”,为政策制定提供证据。组合分析表明酒精与施工区联合作用可使严重事故概率近乎翻倍。 数据采集指导。 训练阶段归因显示,个体信息(车辆与驾驶人属性)对预测贡献超过 40%,提示在事故报告中优先记录相关细节有助于提升模型性能。
7.1 管理和政策启示
针对高危因素制定干预措施。 应加强酒后驾驶执法、施工区安全管理和驾驶行为教育,尤其关注酒精+施工区组合情形。 优化事故记录标准。 数据采集应重点记录驾驶者行为、车辆类型、酒精水平及是否位于施工区等关键字段,以支撑未来模型迭代。 推广事件级预测框架。 将宏观交通安全分析转向事件级,结合多模态信息和大模型推理,可为城市交通规划和保险精算提供精准风险评估。
7.2 未来展望
研究团队指出,未来可采用专用的多模态大模型或图像编码器进一步提高性能,并利用更广泛的州和国际数据进行泛化检验。此外,实时数据接入和线上部署也将使 SafeTraffic Copilot 从科学研究走向交通管理实践。
文章须知
推文编辑:单子叶
责任编辑:张仁义
原文链接:https://doi.org/10.1038/s41467-025-64574-w


