
基于多智能体强化学习的列车协同控制:能耗与时效的双目标优化方法
一、研究背景与问题提出
随着城市轨道交通运营规模的持续增长,列车运行能耗成为地铁公司降低成本、促进可持续发展的重要议题。大量研究表明,通过合理的时刻表优化和再生制动能量回收可以显著降低牵引电能消耗。然而,在实际运行中,不可预测的乘客上下车时间和站内拥堵等扰动会使列车站停时间(dwell time)不可避免地偏离计划值,导致时刻表难以实时调整、能量回收无法充分利用。为解决这一问题,论文提出面向地铁系统的深度多智能体强化学习(DMARL)框架,研究目标是在站停扰动下优化列车时刻表和运行曲线,使净牵引能耗最小化。
论文主要关注以下问题:
传统固定时刻表方法难以应对随机扰动; 现有算法普遍依赖离线训练数据,对实时应用适应性不足; 能量回收和再利用受限于列车间牵引–制动时间的重叠,如何通过协同控制增强能量交换?
作者选取上海地铁1号线早高峰运行环境,构建包含牵引能耗、再生能量和运行约束的模型,并设计多智能体算法在在线环境中不断学习实现实时优化。
二、列车时刻与运行机制建模
2.1 时刻模型与扰动假设
假设列车共 列,列车间间隔为 。第 列车在首站的计划发车时间为
在第 站的计划发车时间为
其中 为区间运行时间, 为站停时间。若第 站出现站停扰动 (如乘客拥堵),则实际站停时间变为 。整条线路所有列车完成运行所需时间为
其中 为第 列车到达终点站的时间。
2.2 列车动力学及能量模型
列车牵引受力由牵引力 、制动力 和阻力 组成。牵引力模型为分段函数:
制动力模型为
阻力符合Davis公式 。牵引功率为 ,制动回收功率为 。再生能量可供其他列车利用的部分为 ,其中 表示电网吸收系数。系统总净能耗为
即牵引能量减去回收能量。
优化目标:在满足时刻约束和安全间隔条件下,最小化净牵引能耗 。
2.3 能量回收原理
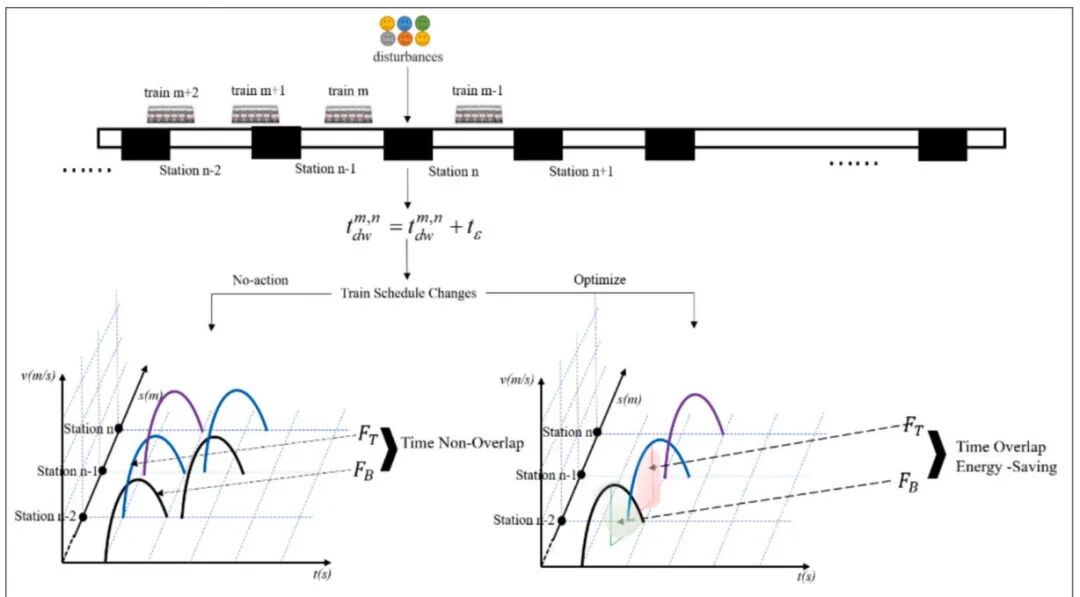
当前列车在制动阶段将机械能转换为电能并反馈至电网,若邻近列车正处于牵引阶段,其牵引功率可由该再生能量部分供给,实现能量再利用。下图展示了牵引–制动曲线重叠前后能量回收情况,其中左图为未优化策略,右图通过调整时刻使牵引与制动重叠,增大再生能量利用面积。
下图示意能量回收原理:
三、深度多智能体强化学习框架
为应对在线扰动和列车协同控制,作者提出分布式多智能体深度强化学习框架,每列车对应一个智能体,采用Actor–Critic结构实现连续动作输出。
3.1 状态与动作表示
第 个智能体在时刻 的状态 包含本列车当前区间序号、局部环境中前后列车的区间序号和站停状态,以及自身上一时刻的站停时间 。状态向量维度随选定的局部观测窗口而变化。
智能体的动作 由两个连续变量组成:
滑行速度 :在当前区间设置的目标速度,用于控制牵引或制动时间; 站停时间 :在当前站点的停站时长调整值。
动作通过 Actor 网络输出,并约束在允许范围内。
3.2 奖励设计
奖励函数以节能为目标,比较“未采取控制措施”(No‐Action)与 DMARL 方法的能耗差值:
即如果通过控制降低了净能耗,则奖励为正,否则为负。这种相对奖励设计促进各智能体协同利用回收能量,从而更积极调整速度和站停时间。
3.3 网络结构与训练机制
DMARL 模型采用如下结构:
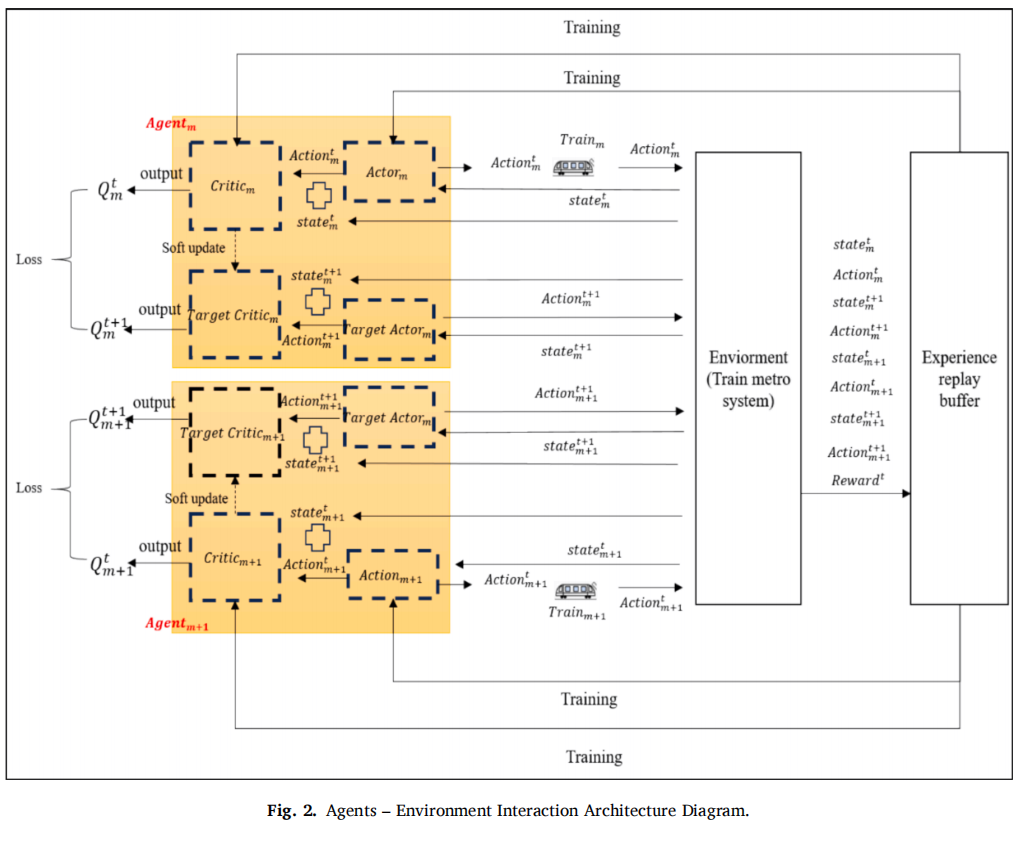
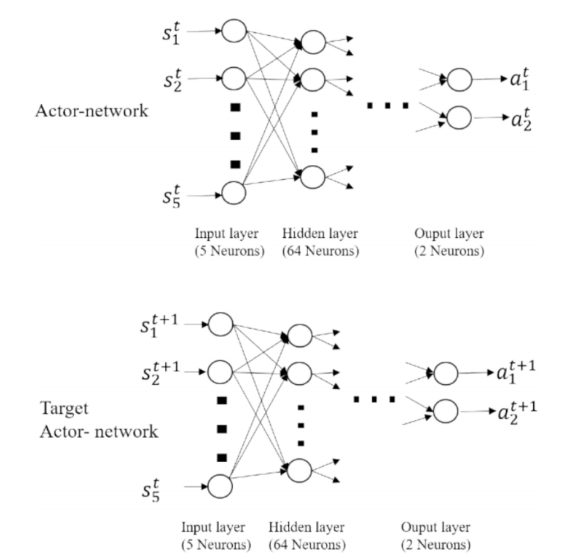
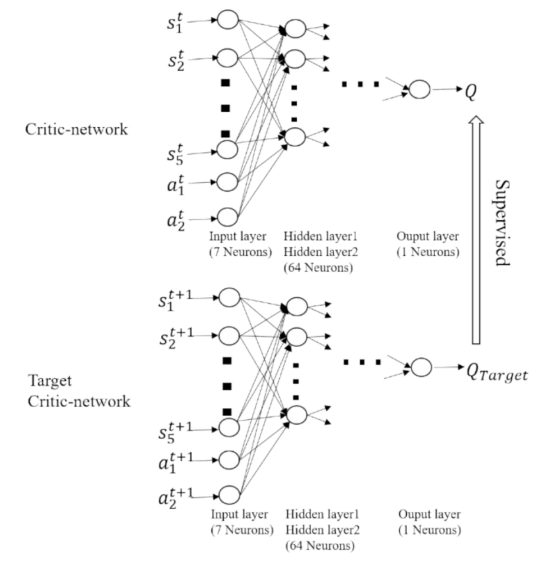
Actor–Critic 网络:Actor 网络根据状态输出连续动作,Critic 网络评估当前策略的 Q 值。 目标网络(Target Networks):为稳定学习,引入延迟更新的目标 Actor 和目标 Critic 网络。 软更新机制:通过指数滑动平均更新目标网络参数,平衡学习速度和稳定性。 经验回放池:存储交互样本批次,打破样本相关性,提升训练效率。
下图为一列智能体与环境交互的架构,其中黄色部分表示智能体的 Actor 和 Critic 网络模块,右侧为环境(列车系统)和经验回放池:
3.4 系统部署与协同机制
由于列车间数据交换需实时、稳定地进行,作者提出将 Actor–Critic 网络部署在车辆端,通过邻近列车之间的信息共享实现协同(如速度曲线、站停时间等),如图所示:
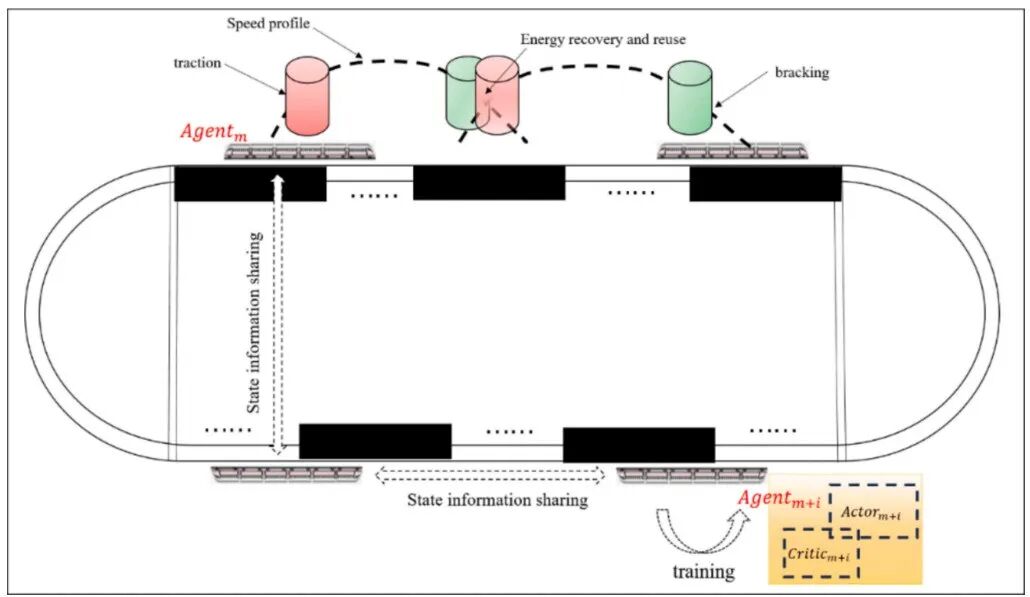
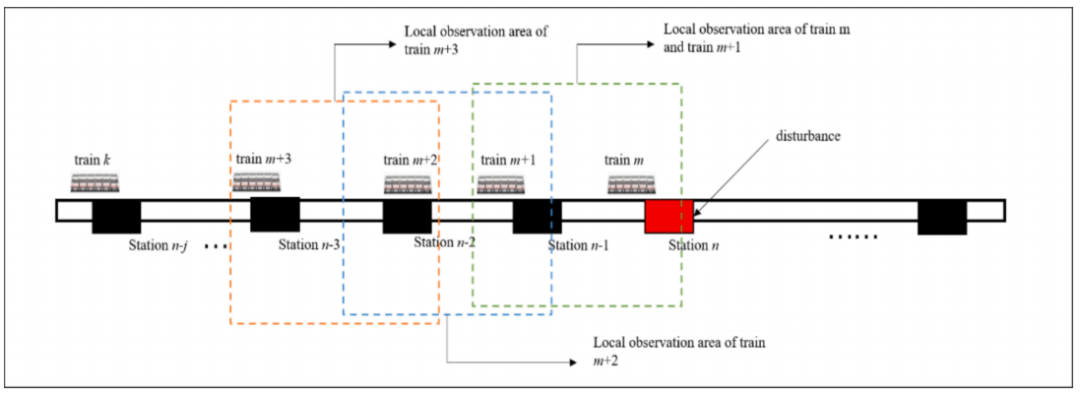
局部环境观测范围的划分如图4所示,每个智能体仅需感知有限数量的前后列车,降低了状态维度并保障了训练效率:
Critic 网络和目标 Critic 网络的结构示意分别如图所示,输入层包含状态和动作信息,输出层为估计的 Q 值或目标 Q 值,采用两层64神经元隐藏层实现非线性特征提取:
四、案例分析:上海地铁1号线实验
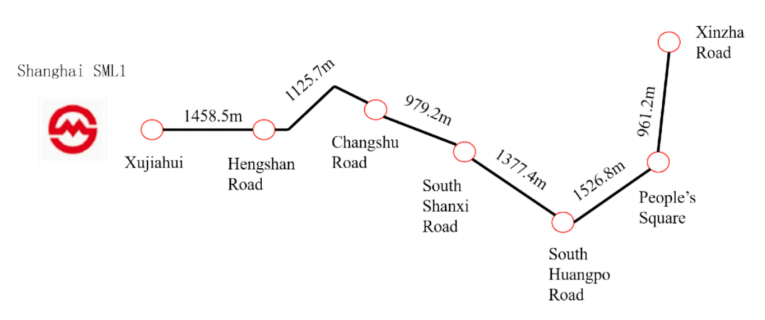
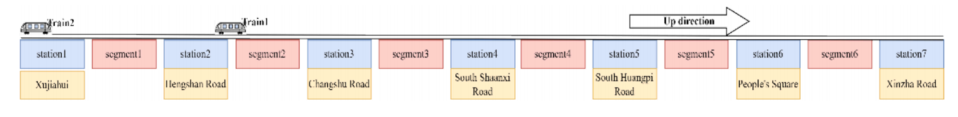
作者选择上海地铁1号线徐家汇至莘庄路段共7个站作为研究对象。下图展示各站间距离与名称:
4.1 双列车系统的时刻表优化
首先考虑两列车协同运行的场景,图8为两车系统示意。当站点出现停站扰动时(例如第3站乘客大量拥堵),DMARL 通过调整站停时间和滑行速度使两列车的牵引–制动过程尽量重叠,实现能量回收与再利用。
表格比较了 IGA、DRLA 和 DMARL 等算法下两列车运行时间的优化结果(文中表6、表7)。DMARL 不仅明显减少牵引能耗,还能在不增加总运行时间的情况下缩短总停站时间。
4.2 算法训练收敛与性能对比
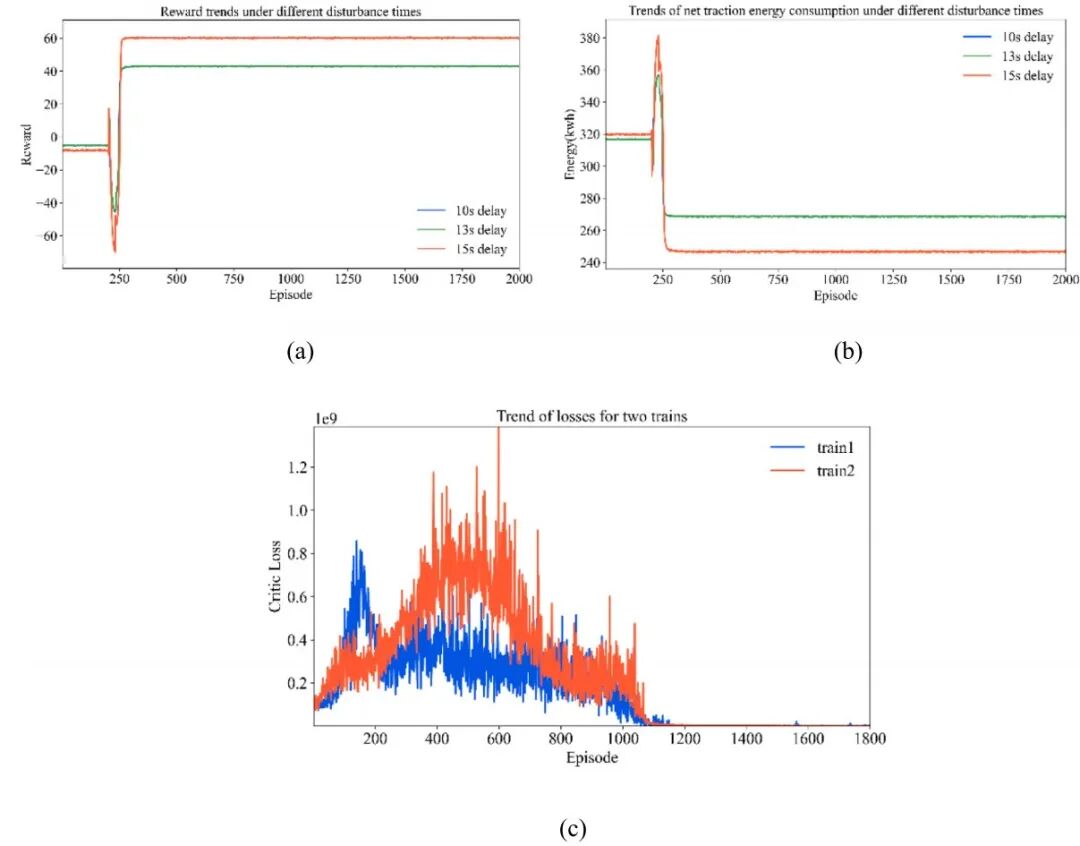
收敛性与稳定性 图9展示了 DMARL 在不同停站扰动时间下的训练过程,(a) 为奖励曲线,(b) 为净牵引能耗曲线,(c) 为Critic网络损失曲线(取自 Fig.9),可以看到各曲线在250~500集左右开始收敛,损失逐渐下降到很小的波动范围,表明算法稳定。
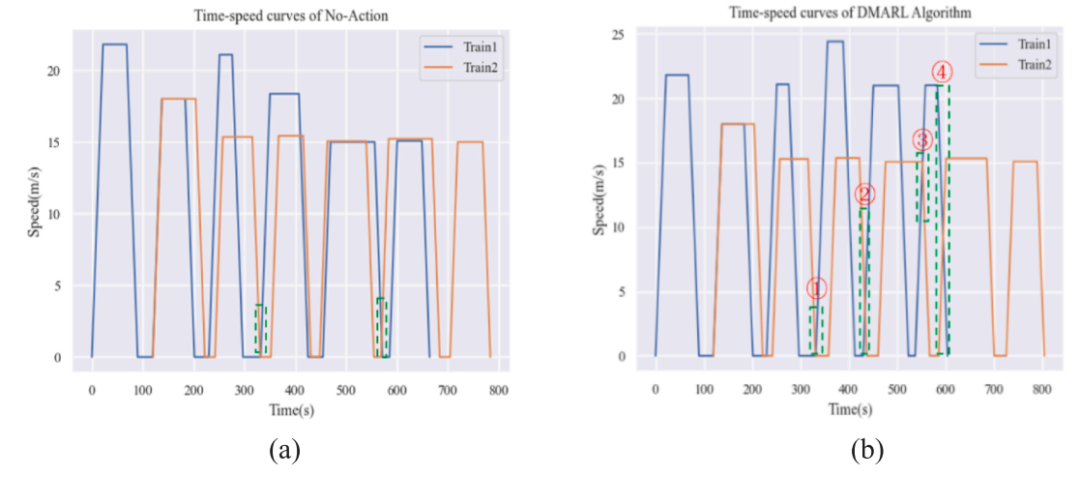
时间–速度曲线 图10比较了不采取控制措施和 DMARL 算法下两列车的速度曲线,通过适当缩短部分区间的滑行时间并延长其他区间的滑行时间,DMARL 使两列车制动–牵引曲线出现更多重叠,利用再生能量、降低牵引功率。
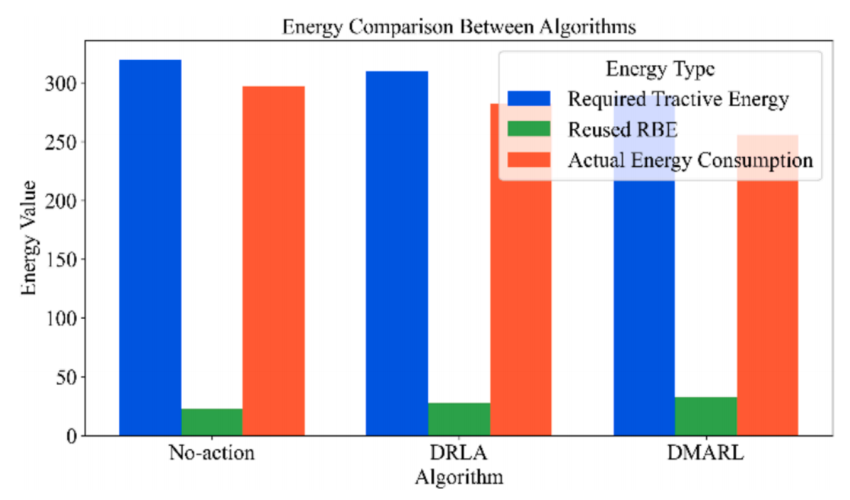
能量消耗对比 论文比较了No‐action、DRLA和DMARL三种算法的能耗组成:牵引能量、再生能量利用和净能耗。图11显示,DMARL的牵引能量最低,实际净能耗减少了14.11%,比DRLA算法进一步降低9.48%。
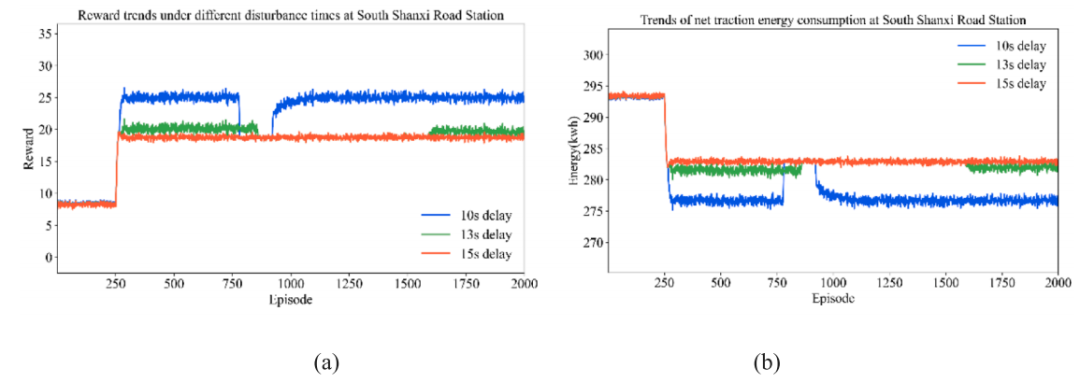
扰动站点鲁棒性 当特定站点(南山西路)发生随机停站扰动时,DMARL方法的奖励和净牵引能耗变化如图12所示。不同扰动幅度下曲线最终都趋于稳定,证明算法具有良好的鲁棒性。同时DMARL节能率仍达到6.2%。
4.3 三列车与五列车系统的扩展
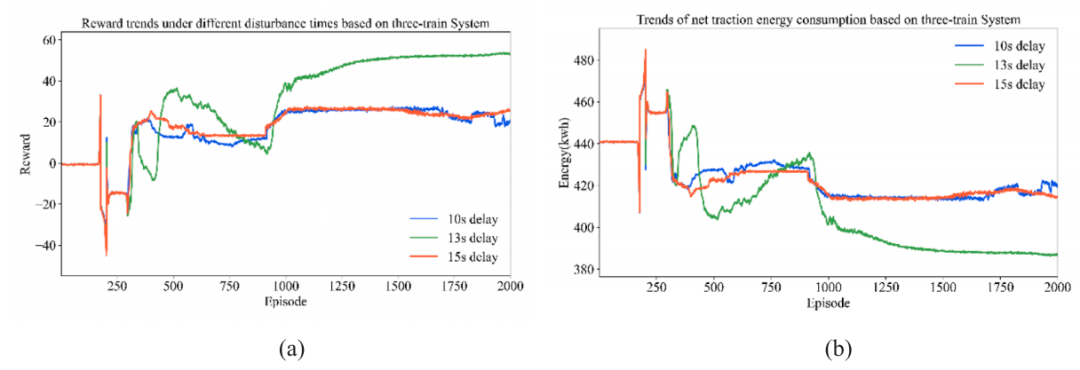
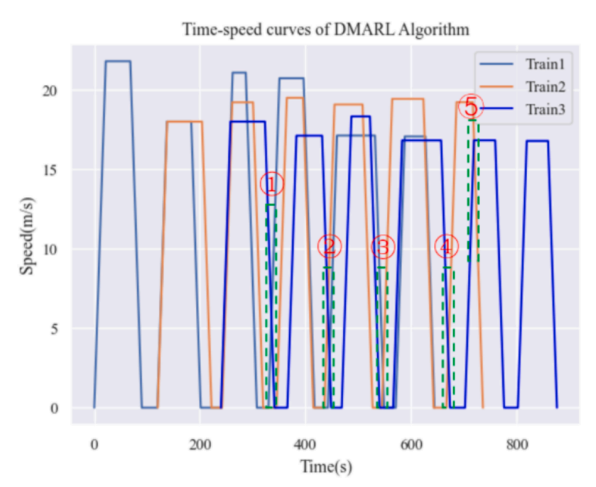
为检验算法的扩展性,作者进一步研究了三列车和五列车系统。在三列车系统中,第3列车需考虑前两列车状态才能决策,状态空间更大。图13为不同扰动下三车系统的奖励与能耗曲线,表明训练约1000集即可收敛。图14展示三列车系统中DMARL算法优化后的速度曲线,前三列车协同实现再生能量利用。
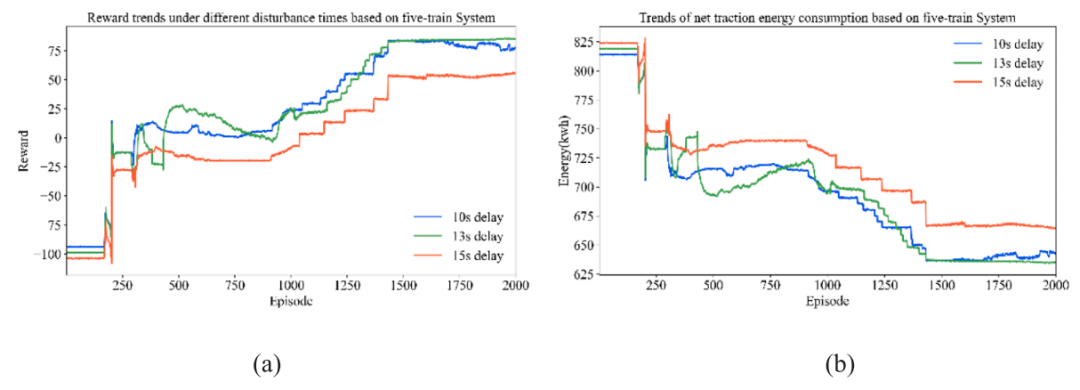
对于五列车系统,图15给出了奖励和净能耗随训练次数变化的趋势。最终DMARL的平均能耗比不采取控制措施下降约11%,比DRLA方法下降3.5%。
五、关键技术细节与难点处理
时刻重排与安全约束 DMARL必须保证列车间最小间隔满足安全要求;算法通过定义合法动作范围和约束奖励函数避免产生不合理时刻表。 连续动作与网络稳定 传统强化学习多用于离散动作,本文通过DDPG结构处理连续动作,并结合目标网络、经验回放和软更新提升学习稳定性。 实时性与分布式部署 考虑到列车通讯延迟和计算能力,作者提出将Actor–Critic网络部署在列车端,使用有限长度的局部观测区域降低状态维度,如图3所示。这种分布式架构降低了实时运算压力。 奖励稀疏问题 利用相对能耗差作为奖励能有效引导训练,但当再生能量较少时奖励信号易变弱。为此作者采用逐步奖励机制,在episode内按区间分段计算局部能耗差,增加训练信号的频度。
六、结论与启示
本文针对城市轨道交通在停站扰动条件下的在线时刻表节能优化问题,提出了一个分布式多智能体深度强化学习框架。通过构建牵引–制动机械模型、再生能量模型并引入连续动作控制,DMARL能够在在线运行中实时调整列车速度和站停时间,使牵引能耗显著降低。实证研究表明,与传统遗传算法(IGA)、深度确定性策略梯度(DDPG)以及深度强化学习自动时刻表算法(DRLA)相比,DMARL在节能效率和收敛速度方面均表现优越,在两列车系统中节能率达到14.11%,在五列车系统中仍保持约11%的节能优势。
管理启示:
实时优化的重要性——在扰动环境下,提前规划的时刻表难以适配实际情况,引入在线优化能够显著提高能量利用效率。 协同调度机制——再生能量的充分利用需依赖多列车协同调节牵引–制动过程,建议运营方关注列车间信息共享与控制协同。 深度强化学习应用前景——分布式DMARL框架无需预先标注大量数据,在实际运营环境中通过交互自学习,具有良好的应用潜力。
未来研究可进一步考虑乘客舒适度、运营总耗时等多目标优化,并探索不同类型列车和线路的适应性。
文章须知
推文编辑:单子叶
责任编辑:弓仪长
原文链接:https://doi.org/10.1016/j.tre.2025.104180


