经验驱动的末端配送旅行商问题:融合描述性与预测性分析的配送经验建模
一 研究背景与问题提出
1.1 经验驱动旅行商问题的背景
最后一公里配送具有路线复杂、信息不完备等特点,驾驶员往往并不严格遵循最短路径,而是基于个人经验在实时交通与停车条件下调整线路。传统旅行商问题(TSP)求解最短环路,但在末端配送场景中,单纯以距离或时间为唯一目标无法反映实际操作偏好。2021 年亚马逊举办了 Last-mile Routing Challenge,鼓励利用真实数据挖掘驾驶员经验以生成更优路线。论文所用数据包含 6112 条历史执行路线,涵盖 898 415 个客户停点,平均每条路线约 146 个停点,服务时间和行驶时间在秒级范围内。
1.2 问题定义与目标
作者提出的经验驱动旅行商问题(Experience-Driven Traveling Salesman Problem, ED-TSP)旨在学习配送员的隐性偏好,使得通过优化算子 生成的路线与历史高质量路线相似。 定义实例集 ,每个实例 包含距离矩阵、行驶时间、客户包裹数量、包裹尺寸、客户分区及时间窗等特征。 设优化算子为 ,执行路线为 ,评分函数 用于衡量生成路线与历史路线的差异。
传统 TSP 仅以距离为权重产生解 ,而驾驶员会将其修改为 ,体现了操作经验的偏好。 ED-TSP 的目标是通过学习过渡权重矩阵 ,使得优化器在 下生成的路线更接近历史经验路线。具体而言,最小化平均损失的数学模型为:
其中外层优化最小化平均评分,内层优化器 在修改后的权重矩阵下求解 TSP。由于评分函数可能非线性且不可微, 的学习成为难点。
二 数据与特征工程
2.1 数据集描述
论文使用的亚马逊挑战数据包含五个主要城市(洛杉矶、波士顿、芝加哥、西雅图、奥斯汀)及其周边共 17 个配送站。6112 条执行路线按照专家评级分为高、中、低质量,其中高质量路线进一步细分为单次访问高质量(High-SV)和多次访问高质量(High-MV)。车辆容量为 110、117 和 150 立方英尺,平均装载率 74.2%。共交付 1 457 175 个包裹,约 7.8% 具有时间窗要求。
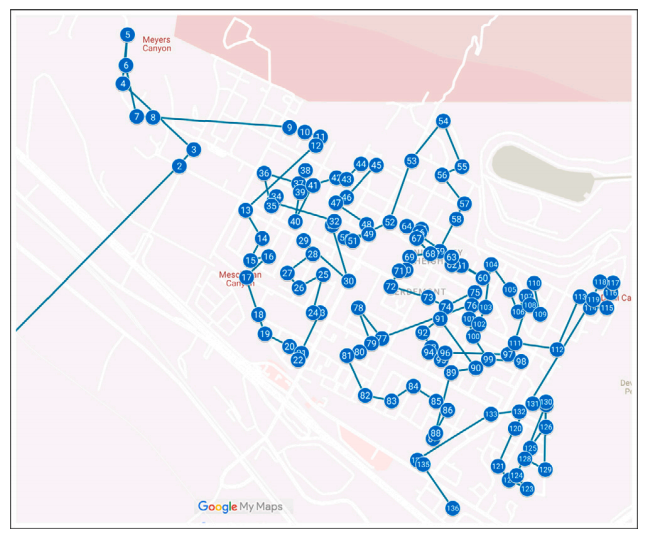
下图展示了论文使用的实际执行路线示例“RouteID_62955f5e-57a2-4425-bfe6-6989d8dae565”。各节点按访问顺序用蓝色圆标示,蓝色连线表示车辆行驶路线,可见停点数量众多、路径跨越多个住宅区,直观体现了最后一公里配送的复杂性。
2.2 特征选取与描述性分析
特征分为路线级、停点级和包裹级,包含配送站编码、日期、车辆容量、坐标、客户分区 (Zone ID)、行驶时间矩阵、包裹尺寸和时间窗等信息。作者通过描述性分析和专家经验选择对性能影响显著的特征。例如,客户分区反映地理聚类关系,包裹尺寸反映装载难度,距离/时间矩阵反映交通条件。为了减小待学习参数维度,特征将用于分解过渡权重矩阵。
三 方法论
3.1 过渡权重矩阵与 ED-TSP 模型
在经典 TSP 中,距离矩阵 直接作为优化器输入;然而在经验驱动场景下,需要构建替代的过渡权重矩阵 来反映驾驶员偏好。 过渡权重矩阵是对所有节点对 的权重赋值,权重越大越不倾向选择该转移。即使仅有 100 个节点,也需要学习约 个元素,直接学习将导致维度过高。
受到奇异值分解(SVD)与主成分分析(PCA)的启发,作者提出基于特征的矩阵分解方法。通过一组特征影响矩阵 描述每个特征 对转移的影响,以及对应的节点特征指示矩阵 表示实例 中节点在特征空间中的所属关系。
定义如下:
:实例 中节点到特征 各水平的指示矩阵; :特征 的影响矩阵, 为该特征的水平数; :辅助矩阵,用于捕捉剩余的未知偏好。
则过渡权重矩阵的分解形式为:
其中 表示元素乘 (Hadamard 积),从而将多特征信息逐级放大。通过这一分解,模型不再直接学习 个元素,而是学习各特征的 ,显著降低维度。
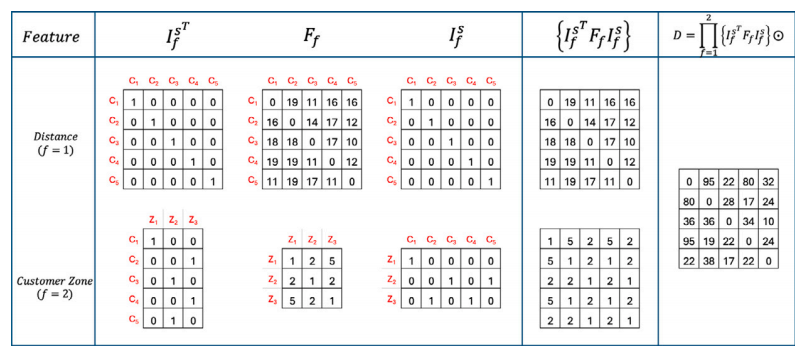
图 2 展示了特征影响矩阵分解示例,其中第一行为距离特征,第二行为包裹尺寸特征。 通过对两个特征的影响矩阵按行列扩展并相乘,可得到过渡权重矩阵 。
3.2 得分函数与评分指导坐标搜索 (SGCS)
为了评价学习出的权重矩阵生成的路线质量,需要定义评分函数 。在亚马逊挑战中,评分函数结合顺序偏差与编辑距离,后者计算将生成路线转换为执行路线所需的插入、删除、替换操作数,结果乘以对应节点的距离权重。评分值越小表示生成路线越接近历史高质量路线。
对于共享特征(例如客户分区),作者进一步定义加权评分矩阵 ,用于衡量某个特征水平间的过渡在历史数据中的平均得分。记特征 的水平为 和 ,令 为在历史路线中观察到从水平 到水平 的实例集合,则:
该矩阵为 SGCS 算法提供了类梯度信息:若某过渡的平均得分较差,则说明此过渡在高质量路线中不常出现,应当增加其权重以抑制出现;反之则降低权重。评分指导坐标搜索 (Score Guided Coordinate Search, SGCS) 利用 中的排序信息,在每次迭代中选择若干权重进行微调,通过优化器生成新路线并更新最优解,其伪代码给出了完整流程。
3.3 标签指导特征影响矩阵 (LFIM) 与 R+LFIM
对于某些特征,尤其是分区等类别特征,直接使用历史样本的转移次数来更新权重可能更为简单有效。作者定义标签指导特征影响矩阵 (Label-guided Feature Impact Matrix, LFIM)。设设特征 中水平 到 的历史转移次数为 ,则对应的 更新为:
其中 为允许变化的最大转移次数,控制更新幅度。该方法无需迭代即可直接利用历史标签信息更新权重矩阵,类似于一种基于经验频次的规则方法。
为了兼顾规则方法 RFIM 和 LFIM 的优点,作者提出组合方法 R+LFIM:先以规则方法构建基础权重矩阵,然后利用 LFIM 调整曾出现过的转移权重,填补经验空白。该方法在训练和测试数据上取得了显著提升。
四 实验设计与结果分析
4.1 实验设置
研究采用 80% 训练、20% 测试划分,并针对各配送站分别评估算法表现。基线方法为专家规则构建的 RFIM;比较对象包括 SGCS、LFIM 和 R+LFIM。评分越低表示生成路线与高质量路线更接近。实验在 High-SV 路线集上调参并通用性测试。超参数包括 SGCS 的迭代次数、步长及批量修改数量等(最佳参数为 ), LFIM 的 设为 5。
4.2 SGCS 与 RFIM 比较
SGCS 在训练集上相对 RFIM 带来约 8.2% 的平均改进,但在测试集上整体表现略有下降(约 1.5%)。部分站点如 DCH3、DCH4 在测试集上仍有显著提升(-10.5% 和 -8.1%),说明 SGCS 能够捕捉某些特定站点的偏好,但对未见过的数据泛化能力不足。
4.3 LFIM 与 RFIM 比较
LFIM 依赖于历史数据中出现的转移频次,当未观察到某个转移时无法提供信息,因此训练和测试性能波动较大。实验结果显示 LFIM 在训练集上的平均得分反而比 RFIM 高出约 3.4%,在测试集上则显著恶化 48.8%。这表明仅依据标签频次更新可能导致过拟合。
4.4 R+LFIM 整合方法
R+LFIM 将规则基础矩阵与 LFIM 的数据驱动更新相结合,既保留专家知识,又利用标签信息弥补未知转移。结果显示, R+LFIM 在训练集和测试集的加权平均得分分别下降至 0.0108 和 0.0299,相比 RFIM 提升 70.1% 和 22.5%。因无需迭代,该方法计算效率高,成为本文的最佳算法。
4.5 综合性能分析
作者进一步分析 R+LFIM 生成路线与执行路线在多个维度上的相似性。例如,统计生成路线与历史路线中相邻停点顺序一致的比例,平均达到 64.65%。另一指标为节点顺序偏差,大部分偏差位于 1–5 名之间,极端偏差通常与逆向访问路线有关,但逆向顺序在评分中仅轻微惩罚。此外,还比较了考虑与不考虑时间窗的优化器对 R+LFIM 的影响(表 12),结果显示引入时间窗对平均得分影响较小,证明方法具备灵活性。
五 讨论与启示
5.1 方法优势与局限
优势:
有效性与泛化性:通过结合描述性规则与预测性算法, R+LFIM 在测试集上显著提升了路线相似度,并兼顾未见数据的泛化能力。 解释性:特征分解使每个特征的影响矩阵 易于解读,用户可直观了解哪些转移受到鼓励或惩罚。同时, SGCS 使用的加权评分矩阵提供了类梯度信息,可解释调整方向。 灵活性:框架允许根据需要更换评分函数,如作者在其他实验中使用均方误差等指标。
局限性:
分解方法假设不同特征独立,并顺序学习各特征,可能忽略特征间相互作用; SGCS 对参数敏感,测试集泛化不佳; LFIM 对数据依赖性强,容易过拟合。
5.2 管理与实践启示
经验数据的重要性:论文证明充分利用历史高质量路线可以显著提升算法性能,因此企业应重视数据采集与保存,特别是驾驶员实际路线及其上下文信息。 融合专家知识与数据驱动:规则方法提供初始可解释的权重矩阵,结合数据驱动的调整能兼顾可解释性与性能,建议在其他运输优化问题中推广类似策略。 特征工程的关键作用:通过特征分解降低模型维度,方便快速迭代及解释。管理者在实施路线优化时应重点考虑可解释且可采集的特征,如客户区域、包裹尺寸、服务时间等。 算法灵活部署: R+LFIM 不依赖复杂迭代,适合在实务中快速部署。若有更多数据,可考虑结合 SGCS 进一步提升表现,但需注意泛化能力。
六 结论
本文针对末端配送中的经验驱动旅行商问题,提出了结合描述性分析与预测性优化的统一框架。通过将过渡权重矩阵分解为特征影响矩阵,并提出评分指导坐标搜索与标签指导方法,显著降低了学习维度并提升了生成路线与历史高质量路线的相似度。实验在亚马逊 Last-mile Routing Challenge 数据集上验证了该框架的有效性,其中 R+LFIM 方法在测试集上相对规则方法提升 22.5%。未来可进一步探索多特征交互建模、考虑实时交通信息以及推广至车辆路径问题的其他变体。
文章须知
推文编辑:单子叶
责任编辑:弓仪长
原文链接:https://doi.org/10.1016/j.trb.2025.103172


