城市出行服务的公平调度优化:一种结合离线求解与在线学习的双阶段数据驱动方法
原文链接见文末,或扫文末交流群二维码,每日实时更新推文与原文。
一、研究背景与问题提出
网约车运营是以乘客通过移动应用即时呼叫车辆的运输服务。调度中心需要在请求到达的瞬间决定是否派车及选派哪辆车。传统派单规则(如最近或最早到达车辆)贪婪且仅关注效率,在拥挤城市交通中容易对低密度区域的乘客产生地理不公平。 研究表明,发达城市的网约车服务存在明显的空间差异,偏远地区或低收入区域乘客的服务质量较低。不公平的服务可能导致这些区域的乘客减少使用,从而影响平台长期收益。 公平性与效率的平衡不仅是公益机构关注的目标,也越来越受到商业平台的重视。本文提出一种在线网约车派单问题,旨在在快速响应乘客请求的同时最大化效率和地理公平性。
研究的主要贡献为:
提出一种从离线最优解中提取信息指导在线决策的通用方法。 针对网约车公平派单提出新的混合整数线性规划(MILP)模型,并将其静态解转化为在线策略。 在多种系统设置下进行模拟试验,比较所提出策略与多种派单规则的表现,展示其在效率与公平性之间更好的折衷。
二、文献回顾与问题定位
2.1 动态路由与网约车关系
网约车问题是动态运输问题的一种特殊形式,与动态拨号客运(Dial-a-Ride)和动态揽件配送问题密切相关。 现有研究主要关注效率指标,如收入最大化或服务数量最大化,而很少考虑乘客公平性。
2.2 网约车公平性研究
现有文献更多关注司机收入的公平性,而对于乘客公平性尤其是地理公平的研究较少。 部分研究采用线性规划或参数化方法在效率和公平之间加权,但通常假定请求集合已知或车辆离线,这与本文的实时决策场景不同。
2.3 派单问题解决方法
常见方法包括多行程算法 (MSA)、回溯式鲁棒优化以及价值函数近似等。 这些方法往往要么需要未来请求信息,要么侧重车辆最短空驶时间,忽视了公平性。本文在离线模型基础上通过数据驱动方式生成在线政策,填补了这一空白。
三、问题建模与指标
3.1 系统描述
服务区域划分为若干不重叠的地理分区,每个请求从起点 到终点 ,在离散时间 随机到达。 每个请求有到达时间 和过期时间 ,过期后乘客离开。乘车不允许拼单。 车辆集合为 ,每辆车有空闲时间 和位置 。车辆可服务多个请求,服务结束后停留在目的地,直到分派新请求。 给定请求 ,可服务车辆集合 ,系统需要在请求到达时即刻选择其中一辆车或拒绝服务。
3.2 效率与公平性指标
效率:在整个服务期内被服务请求数量之和 ,其中 为车辆 是否服务请求 的二元变量。 将请求按地理特征划分为 个群体 。群体 的请求总数为 ,被服务请求数为 ,其满足率为 。 Gini 系数衡量群体满足率的不均衡性,公式为:
其中 。
综合目标:追求高效率和公平性,将效率与公平性相乘得到
目标是最大化 的期望值。
四、静态问题建模与 MILP 解法
4.1 含选择性拒绝的静态模型
为利用最优解指导在线决策,作者首先将动态问题转化为拥有全局信息的静态问题。基于 Bertsimas 等人的离线出租车路由模型,通过以下修改得到适用于在线环境的 MILP:
顺序约束:同一车辆按请求到达顺序服务,不能提前执行未来请求。 不能提前出发:车辆从先前请求的目的地驶向后续请求的原点,起始时间不早于后续请求到达时间。 目标函数:最大化综合指标 ,既考虑效率也考虑公平。 决策变量包括首个请求变量 、相邻请求连接变量 、服务指示变量 以及取件时间 ;约束保证每个请求最多服务一次、每辆车仅有一个首请求,且服务时间不超过过期时间。
该模型允许在已有车辆可行的情况下拒绝部分请求(选择性拒绝),从而在全局最优下平衡未来服务机会。
4.2 不含选择性拒绝的静态模型
为模拟在线场景中“有车必接”的情况,作者进一步扩展模型,增加额外变量和约束,确保如果存在可服务车辆则必须接受请求。该模型计算量更大,实验表明其效果与含选择性拒绝模型类似,因此实测阶段采用前者。
五、在线决策策略与参考集构建
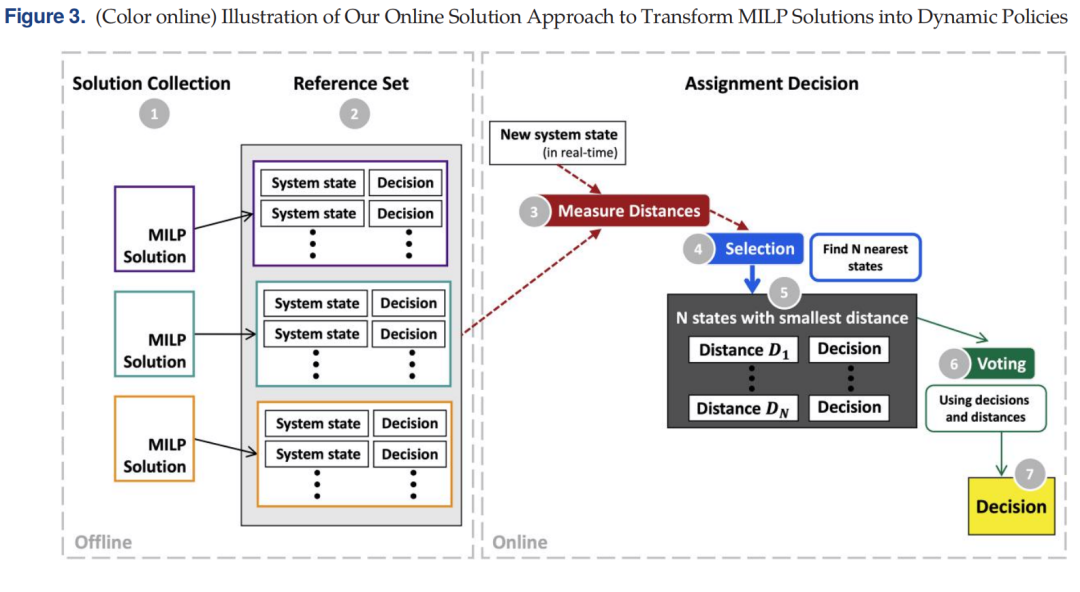
5.1 离线阶段:构建参考集
多实例求解:首先使用 MILP 在多组随机实例上求解静态问题,获得车辆指派方案。
状态定义:系统状态由三个部分组成:
地理分布:各区域内可用车辆数量。 时间向量:针对每个区域,若有车辆能服务当前请求,则记录该车辆到达的空闲时间;否则记录下一辆车空闲时间。 请求信息:当前请求的原点位置(区域内具体坐标)。 降维处理:将分区合并成更大的“区域”,用上述向量构成简化状态,同时记录 MILP 给出的派车区域作为“标签”。
训练集构建:重复上述过程,汇聚所有实例的(状态,决策)对,形成离线参考集,相当于一个监督学习的数据集。
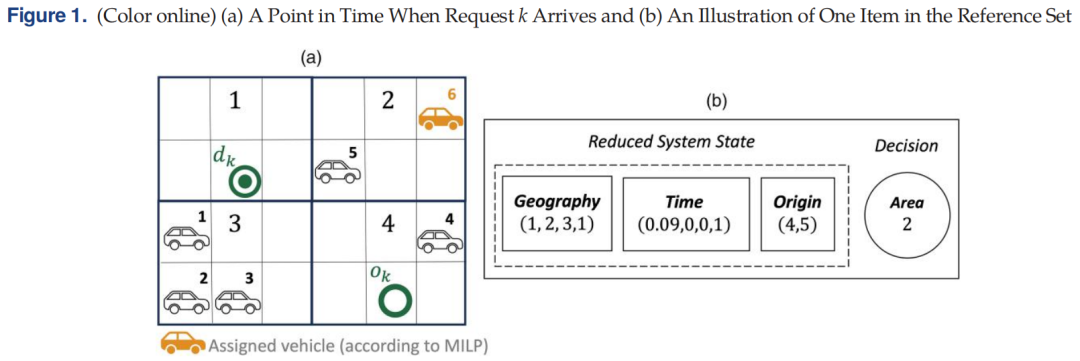
下图展示了参考集项的构建,左图为请求到达时的城市布局,右表为相应的简化状态与决策。
5.2 在线阶段:最近邻决策与投票机制
面对真实运营中的新请求:
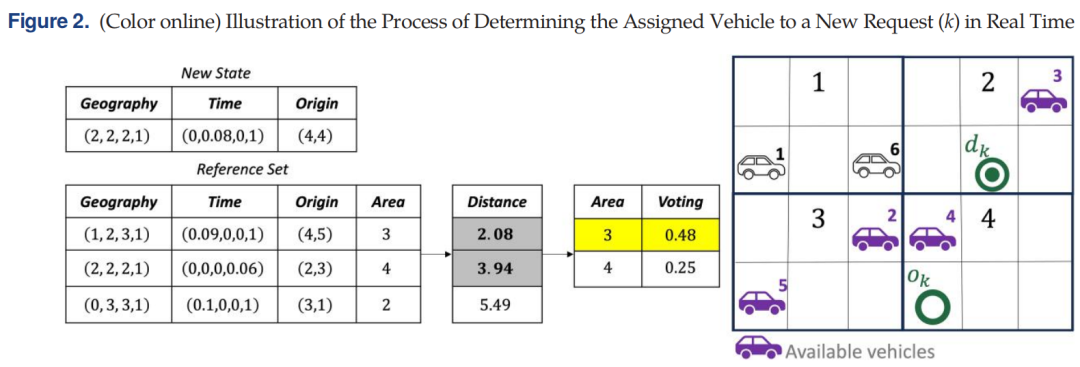
实时状态编码:根据车辆分布和请求信息实时计算当前简化状态。 距离度量:定义新状态与参考集状态的距离(考虑地理、时间和请求起点差异),选出距离最近的 个参考状态。 可行性过滤:仅保留那些推荐区域中存在可用车辆的参考状态,以保证派单可行。 投票决策:对选出的最近 个状态,依据其距离及对应的派车区域进行加权投票,得票最高的区域被选为当前派车区域。然后在该区域可用车辆中应用车辆级规则(如最早到达)确定具体车辆。
下图展示了实时决策流程:从新状态计算距离,选择最近参考状态,并通过投票确定派车区域。
完整的离线和在线流程通过流程图进一步展示。左半部分为离线求解收集参考集,右半部分为在线距离计算和投票派单。
六、模型求解与实验设计
6.1 城市网络与需求生成
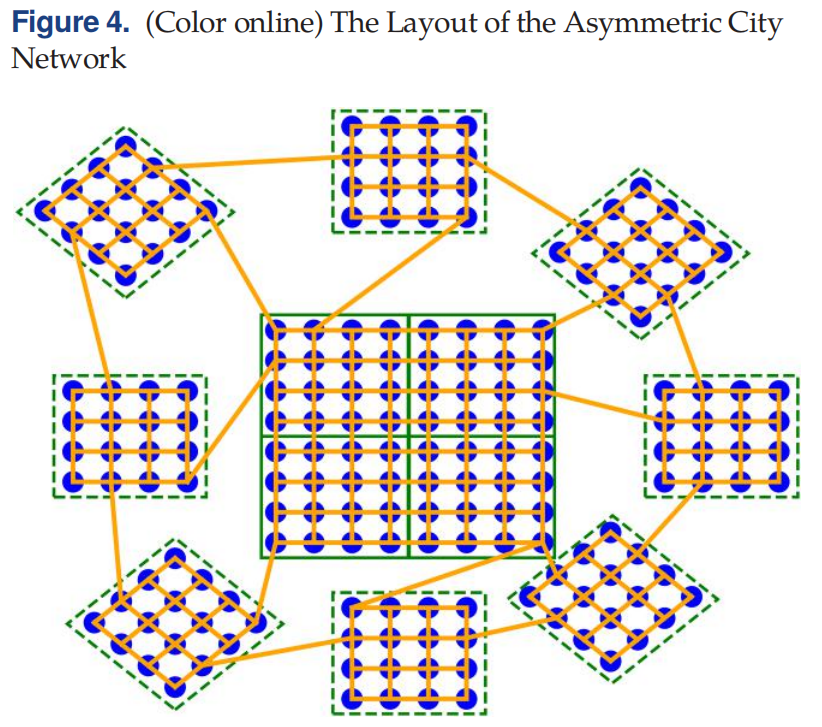
基础网络包含 192 个区域单元和 640 条双向道路,划分为 12 个较大的“区域”:4 个城市中心区(实线框)和 8 个郊区(虚线框)。 每个区域含 16 个单元,区域内行驶速度较慢,区域间及城市中心周边行驶速度较快;平均路程时间 7.6 分钟,最长 18 分钟。 请求到达遵循伯努利过程,每秒以概率 到达,平均每 40 分钟约有 60 个请求;车辆数量为 15 辆。 出发和到达分布:有四分之一的请求在城市中心内部、四分之一从中心到郊区/反向、四分之一在郊区之间;由于郊区单元数量是中心的两倍,中心区请求频次约为郊区的两倍。
6.2 其他派单规则
为评价数据驱动策略,作者与四类常用派单规则进行比较:
| 车辆级规则 | ||
| 车辆级规则 | ||
| 车辆级规则 | ||
| 区域级规则 | ||
| 区域级规则 |
作者的数据驱动策略可视为区域级规则:首先决策派车区域,然后在区域内按照最早到达规则选车。
七、实验结果分析
采用 Python 语言模拟多种系统设置,并比较不同派单策略在综合指标 、效率 及公平性 方面的提升(相对 EA)。以下图表选自论文的主要结果。
7.1 基础系统 (System 1)
数据驱动策略用 142 个 MILP 解构建参考集时已取得明显优势;扩展到 1 000 个 MILP 解进一步提升,但增幅有限。与贪婪派单相比,综合指标提升约 1.4% – 1.16%,效率提升 0.65% – 0.91%,公平性提高 0.44% – 0.47%。
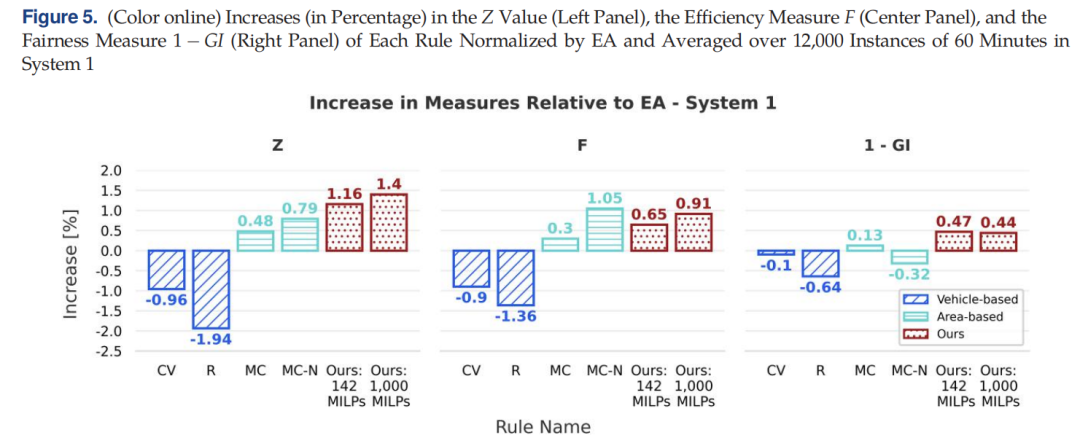
图中蓝色柱表示车辆级规则 (CV、R),青色柱表示区域级规则 (MC、MC‑N),红色柱为数据驱动策略。数据驱动策略在效率与公平性上均显著超越其他规则。
7.2 参考集规模影响
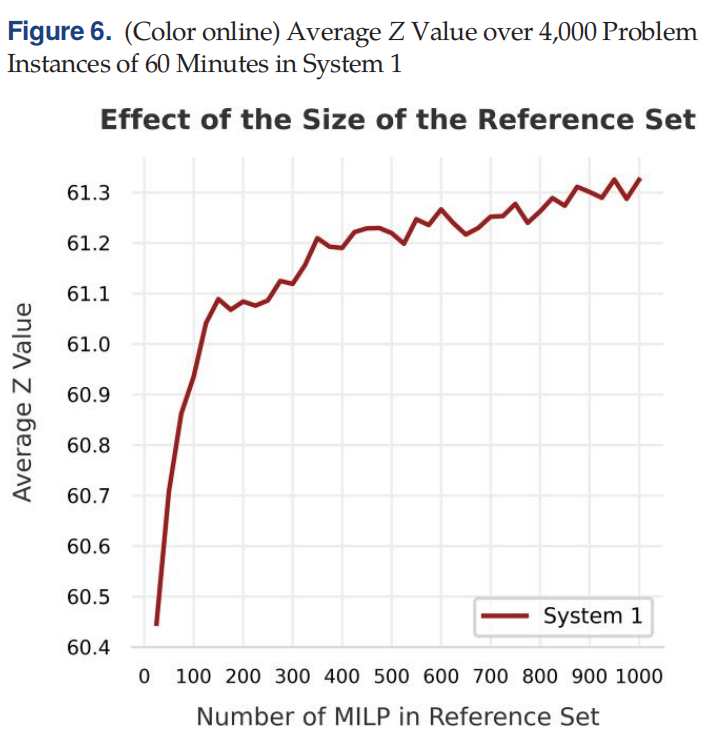
增加参考集中的 MILP 解数量能提升策略质量,尤其在前 200 个解时增长明显。当 MILP 解数量达到约 500 个后,平均综合指标趋于平稳。
7.3 变体系统
System 2:更远郊区与长过期时间。数据驱动策略在效率与公平性提升方面继续保持领先。
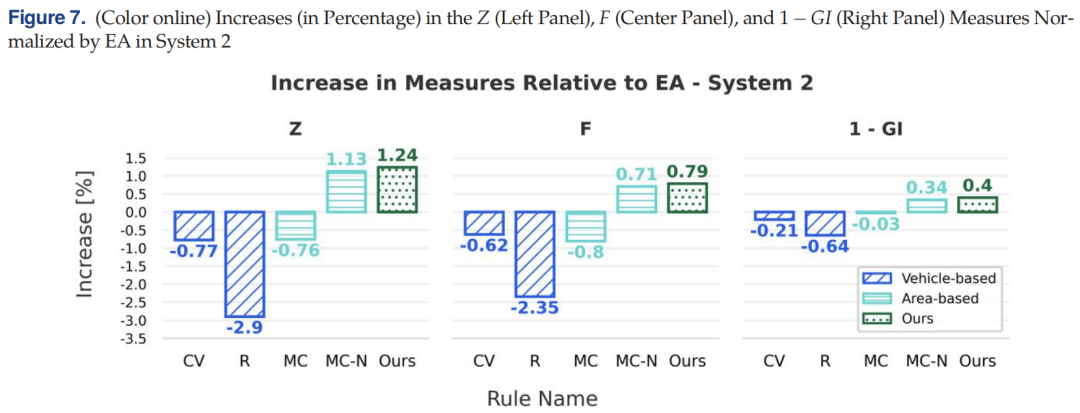
图7 System 2 实验结果 System 3:请求到达概率翻倍。在更繁忙的系统中,传统规则的性能明显恶化,而数据驱动策略仍能提升综合指标 1% 左右。
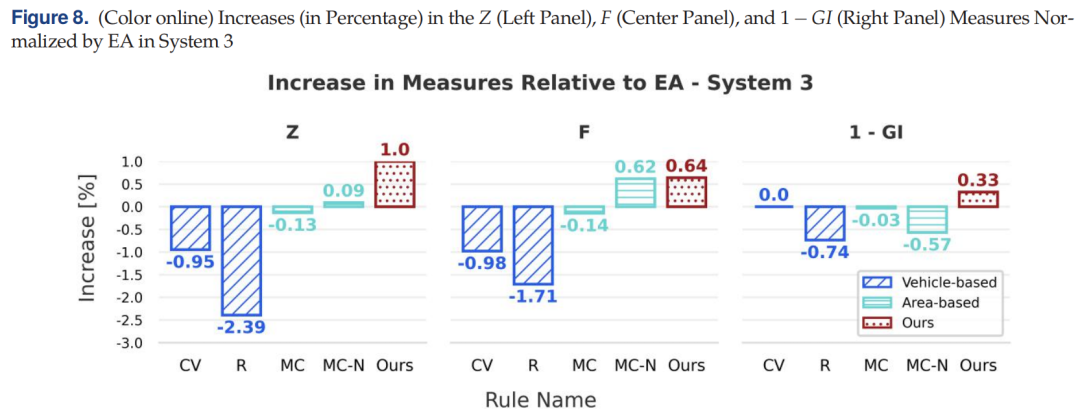
图8 System 3 实验结果 System 4:10 小时长时间运行。将调度周期延长到 10 小时,数据驱动策略在效率和综合指标上保持优势,在公平性方面与 MC‑N 相当。
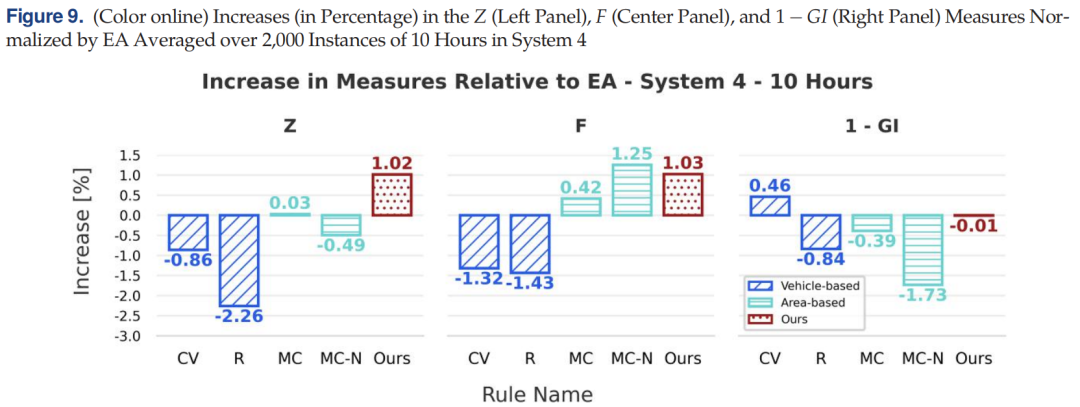
图9 System 4 (10 小时) 实验结果 System 5 与 System 6:对称网络与其他参数变化。作者还比较了基本系统与完全对称的网络结构,发现网络几何对策略效果影响较小。
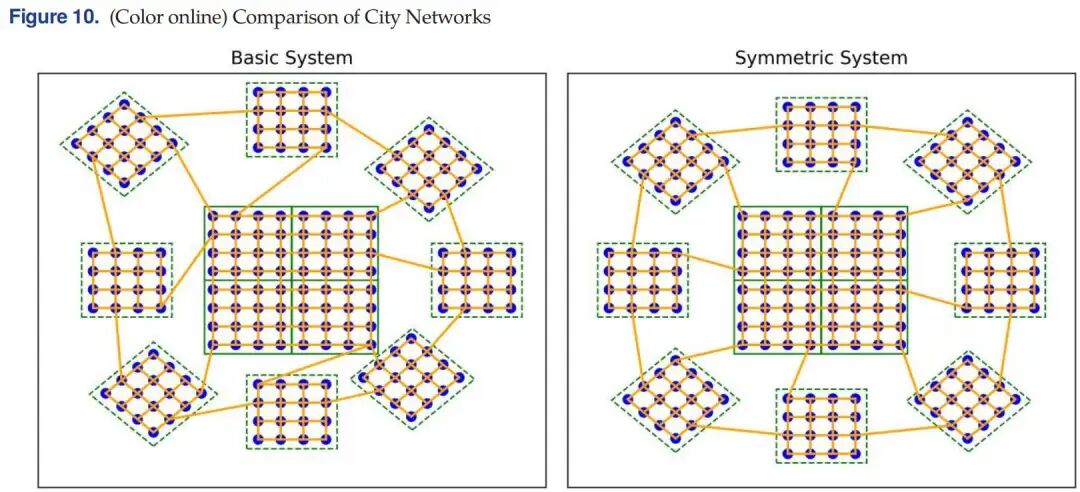
图10 基本系统与对称系统网络布局对比
7.4 等候时间与拒绝率分析
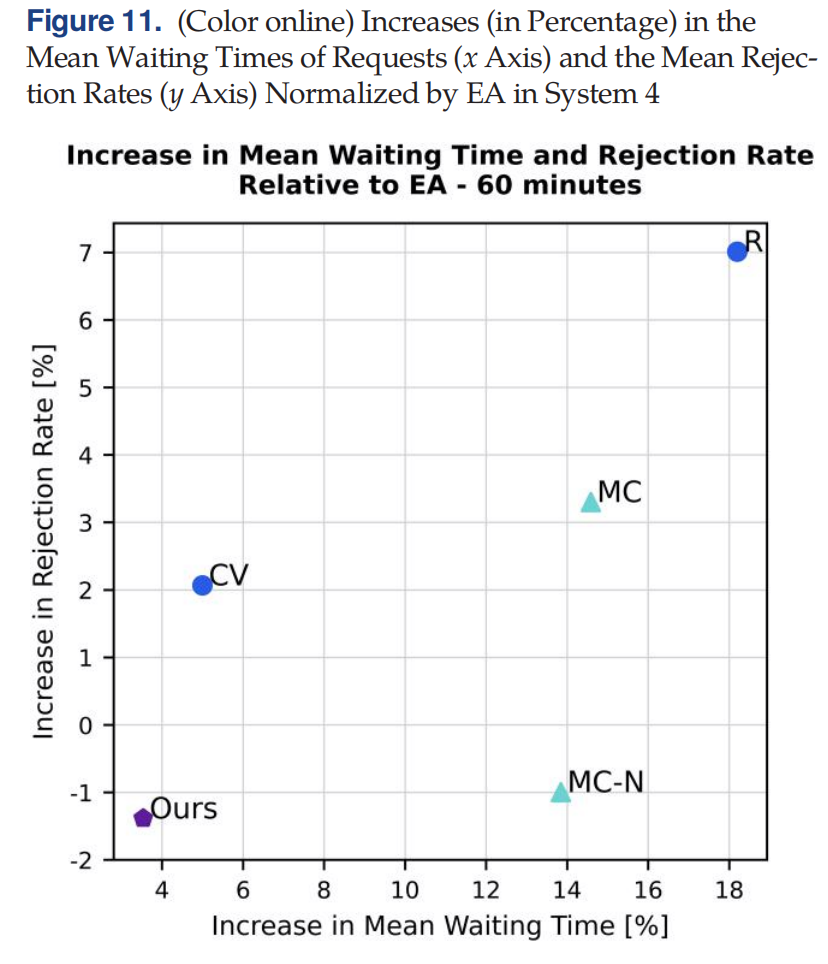
对 60 分钟实例分析各策略的平均等待时间和拒绝率。图中横轴为等待时间增幅,纵轴为拒绝率增幅。数据驱动策略位于左下角,兼顾较低等待时间和较低拒绝率。
7.5 长期系统对比
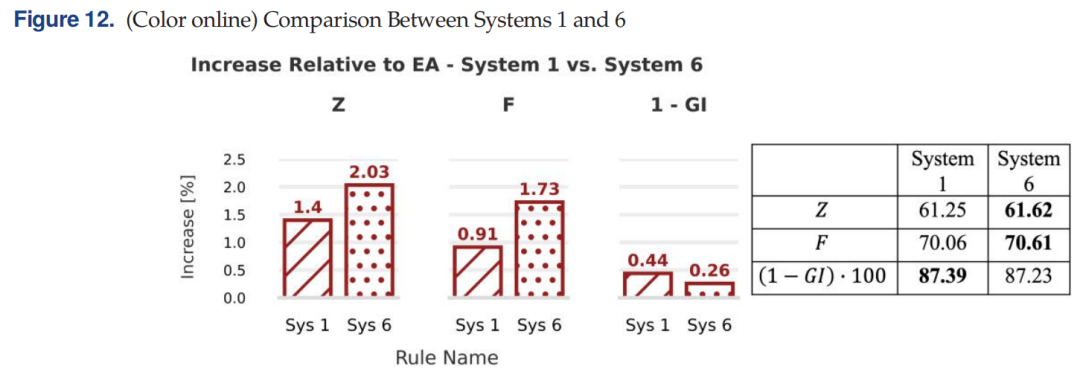
比较 System 1 和 System 6(修改参数后的系统)在数据驱动策略下的提升幅度。System 6 的综合指标提升更明显,说明在系统参数改变时数据驱动策略依然具有良好适应性。
八、结论与管理启示
新颖方法:本文提出利用静态 MILP 解构建参考集并通过距离与投票实现实时派单的新框架,将离线优化与在线决策有效结合。这种框架对其他具有静态解模型的实时问题也适用。 公平性提升:通过引入群体满足率及 Gini 系数,制定了可在效率和公平之间权衡的目标函数,使偏远区域的乘客受到更多关注。 高效可行:实验表明,在不同系统设置和需求水平下,数据驱动策略普遍优于传统车辆级或区域级规则,尤其在繁忙或异构网络中优势更大。 参考集大小:增加参考集的规模可以提升策略性能,但收益递减;实际应用中可根据计算资源和性能要求选择合适规模。 扩展潜力:未来研究可探索动态学习权重、考虑价格因素以及多用户共享等复杂场景,同时测试该方法在真实运营数据上的表现。
文章须知
推文编辑:Ninaday、单子叶
责任编辑:弓仪长
原文链接:https://doi.org/10.1287/trsc.2023.0068
以下是我们的微信交流群二维码,欢迎大家进群,群内实时更新推文及原文 pdf,方便专家学者随时获取(若二维码失效,请扫描最新文章的二维码):