信号化路网:基于解析CVVL模型的车辆位置实时估计
原文链接见文末,或扫文末交流群二维码,每日实时更新推文与原文
一、研究背景与问题提出
1.1 城市信号化路网与车辆位置估计挑战
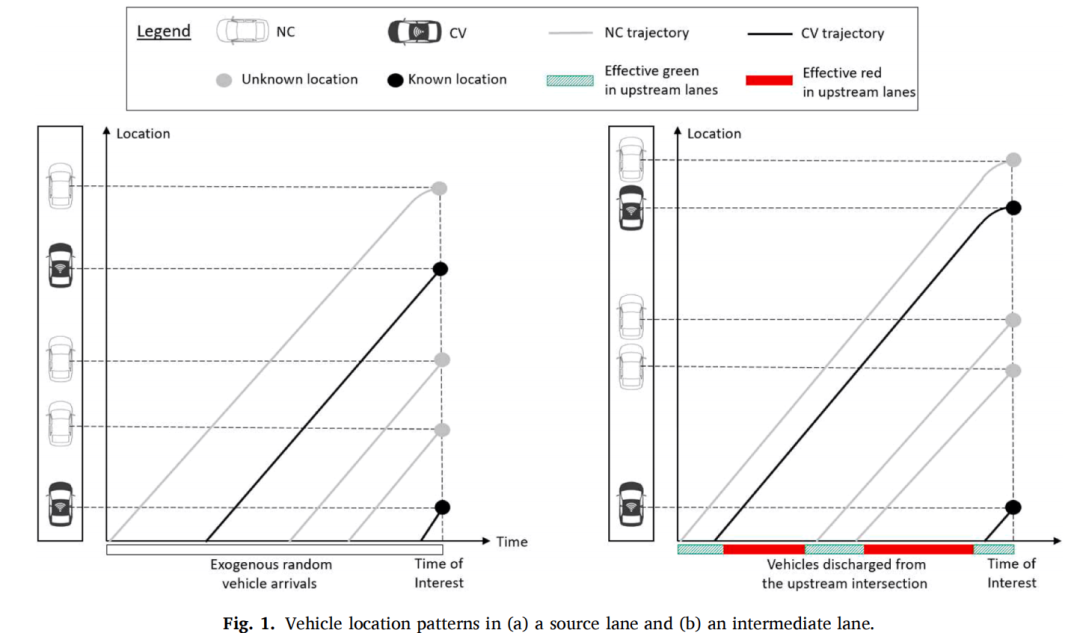
在现实道路网络中,信号化入口车道可分为两类:源车道位于网络边界,其车辆到达呈外生随机性;中间车道位于两相邻路口间,接收上游路口排放车辆,因此出现明显车队(platooning)现象。 部分连接环境下,只有部分车辆能提供实时轨迹(CV),其余为非连接车辆(NC)。已知CV的位置后,需要估计未观察到的NC位置,这对车辆到达模式、旅行时间估计和自适应信号控制非常关键。 针对源车道随机均匀分布与中间车道车队聚集分布的差异,作者提出分而治之的车联网车辆定位模型(CVVL),包含CVVL‑S(源车道)和CVVL‑I(中间车道)两个子模型。
下图展示了源车道随机分布与中间车道车队分布的差异,有利于理解模型为何要区分两类车道。
1.2 模型假设与基础参数
CVVL模型基于以下核心假设:
混合假设:CV 和 NC 在车道中充分混合,每辆车是 CV 的概率为 ,NC 的概率为 。 队列假设:两辆停止的 CV 之间(或停止 CV 与停止线之间)的 NC 速度为0,NC 在该区间呈均匀分布。 匀速假设:若区间内至少有一辆 CV 在运动,则 NC 速度沿区间呈线性变化,NC 在该区间内均匀分布。 扩散假设:在同一车队中,车辆的空间扩散比相同;换言之,若观测到的 CV 偏离其巡航速度对应的位置,则同车队的其他车辆共享相同的放散或收缩比例。
此外,模型依赖三个基本输入:平均到达率 、平均 CV 渗透率 以及持留车辆数 。这些参数可通过最大似然估计等方法从部分 CV 数据推断。
二、模型设计与方法
2.1 CVVL‑S子模型:源车道NC总量估计
在源车道中,车辆到达呈外生随机性。NC 总数量由两部分构成:巡航条件下的期望 NC 数量和红灯期间的持留 NC 数量。作者提出以下命题:
设平均到达率为 、平均 CV 渗透率为 、持留车辆总数为 、持留 CV 数为 、巡航速度为 、车道长度为 ,则任一时间的 NC 总数 为:
第一项为道路在无信号时的期望 NC 数,第二项为红灯造成的额外持留 NC 数。
2.2 CVVL‑S子模型:源车道NC空间分布
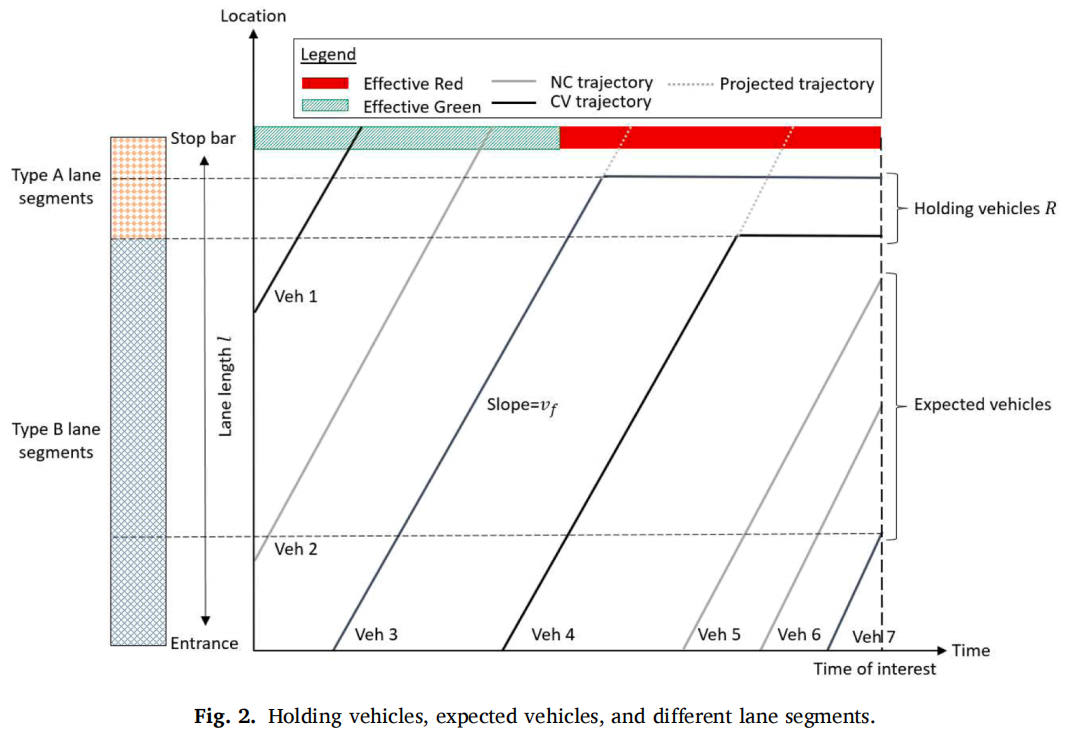
为了确定 NC 的空间位置,车道根据观察到的 CV 位置划分成若干区段,分为两种类型:
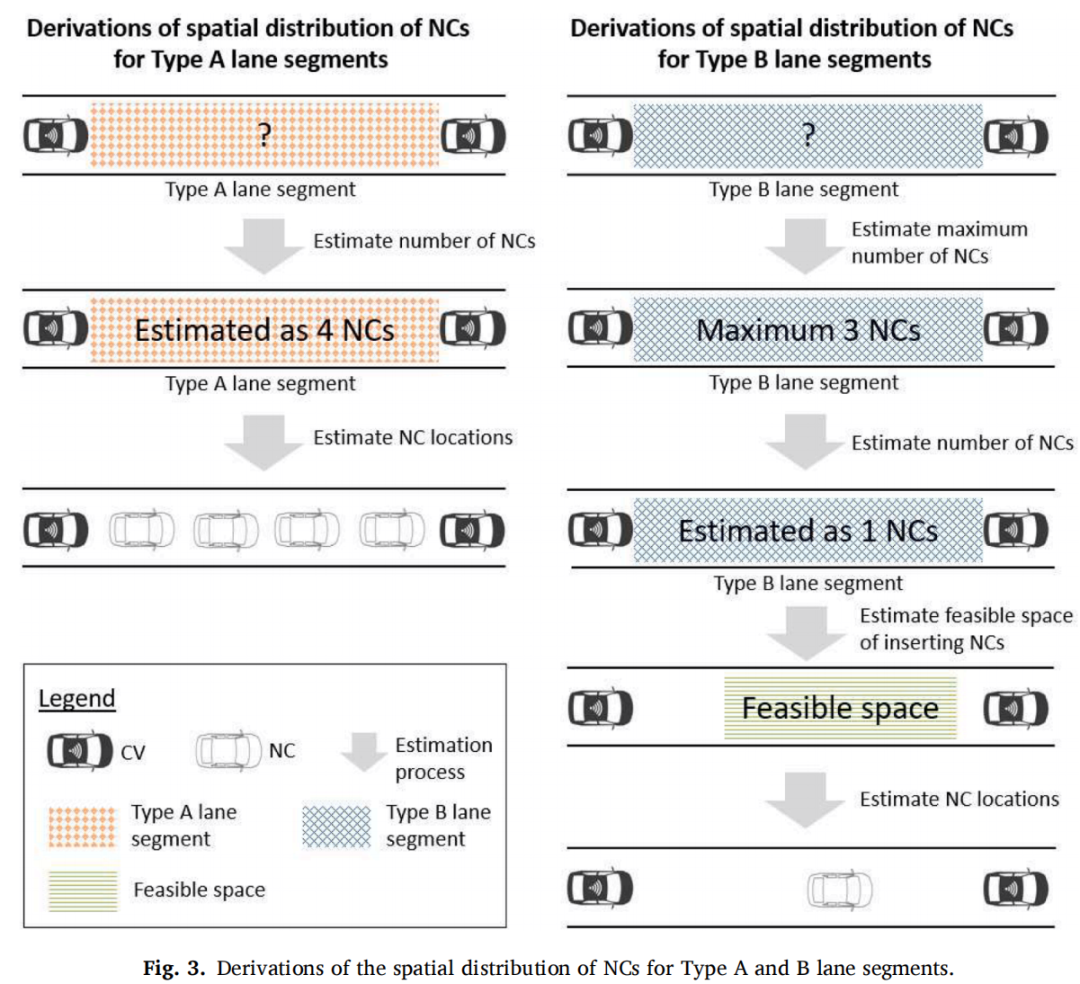
A型区段(队列区段):由两辆停止的 CV 或停止 CV 与停止线围成;假设 NC 静止且均匀分布。 B型区段(行驶区段):由两辆移动或至少一辆移动的 CV 围成;NC 沿线性速度梯度均匀分布,插入间距受最小安全时距 限制。
对 A 型区段,第(i)段内 NC 的数量为:
其中 与 为两端 CV 或停止线的位置, 为有效车辆长度。NC 具体位置按均匀间隔计算。
对 B 型区段,NC 数量 通过最大可插入车数 加权分配,计算过程需综合剩余 NC 总数、最小时距和 CV 速度差异;随后根据线性速度函数确定 NC 的速度和位置。
下图展示了 A 型与 B 型区段内 NC 位置推导流程:
2.3 CVVL‑I子模型:中间车道车队识别
中间车道接收来自多个上游车道按信号时序排放的车辆,因此可能形成多个车队。CVVL‑I 模型将问题分解为三步:
识别候选车队(CP):根据上游车道的有效绿灯时间段,将下游车道划分为多个 CP,每个 CP 以车队的起止位置为界。若 CP 内无 CV,则采用假设的巡航速度推算边界;若有一个 CV 则利用该 CV 的平均速度校正边界;若有两辆以上 CV,则使用观察到的 CV 位置与速度建立方程确定边界。 估计各车队车辆数:利用平均到达率、平均渗透率及转向比例估计每个 CP 中总车辆数,进而得到NC数量。 确定 CP 内 NC 空间分布:根据 CVVL‑S 模型中 A、B 型区段分布规则,对每个 CP 内部再次划分区段并分配NC。
下图展示了不同情况下 CP 边界的识别方法。
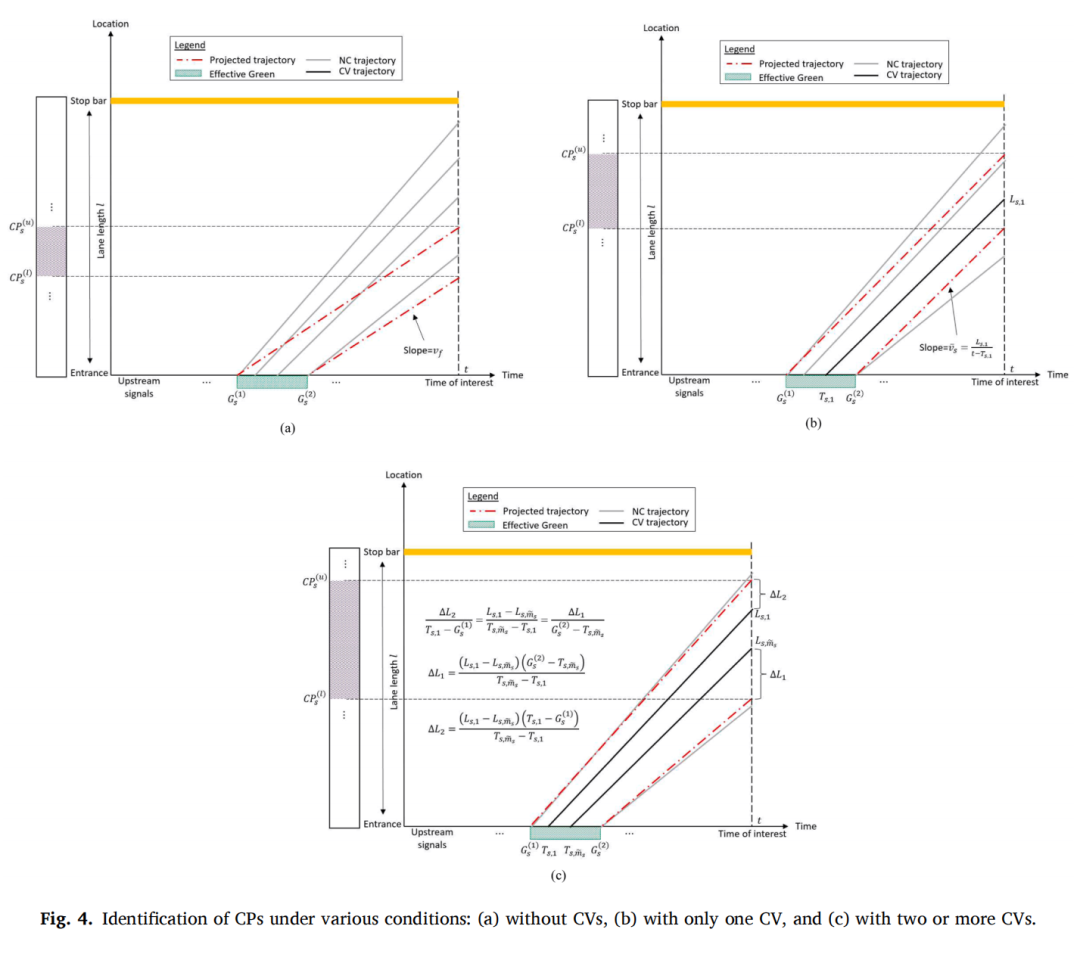
其中,(a)无 CV 时,采用巡航速度推算车队边界;(b)有一辆 CV 时,用该 CV 平均速度校正边界;(c)有两辆以上 CV 时,利用它们的位置和速度估计边界。
2.4 CVVL‑I子模型:车队车辆数量估计与NC分布
CP 识别后,需要推断每个车队的车辆总数和NC数。作者提出以下步骤:
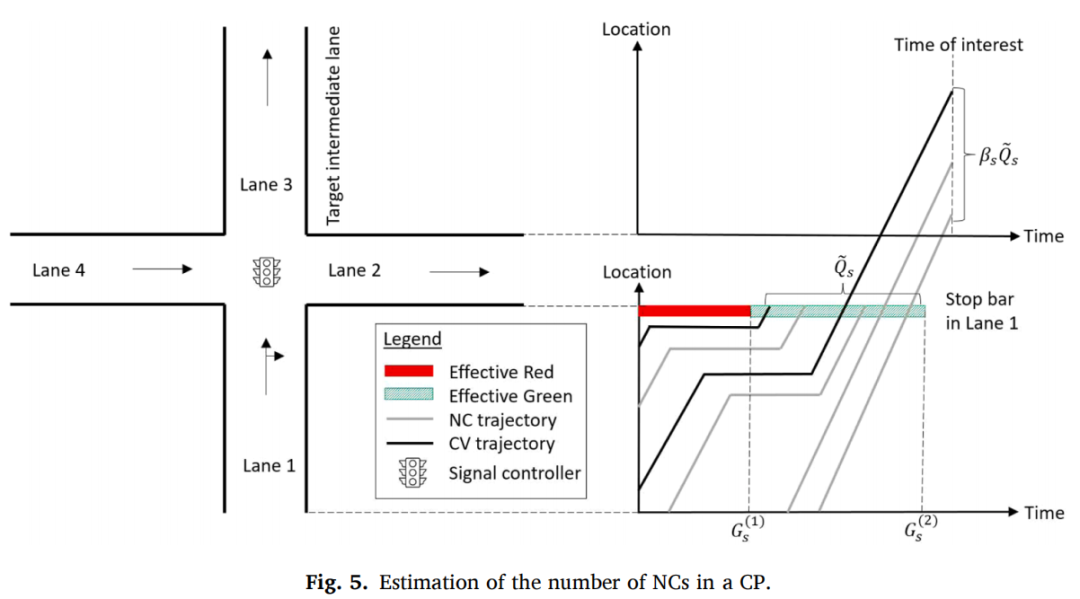
车辆总数估计:将每个上游车道的平均到达率乘以有效绿灯持续时间得到新到达车辆数,再结合持留车辆数推算车队中总车辆数。 NC数估计:总车辆数减去观察到的 CV 数得到 NC 数,若有转向比例,则需按照转向比例分摊至各 CP。 NC分布:在每个车队内部再次应用A型和B型区段划分及分配规则,确定 NC 具体位置。
下图为 NC 数估计算法的示意,其中考虑了各上游车道车辆进入中间车道后在车队中的分布,利用平均到达率和转向比例推算各CP车辆数。
三、实验设计与结果分析
3.1 仿真网络设置与评估指标
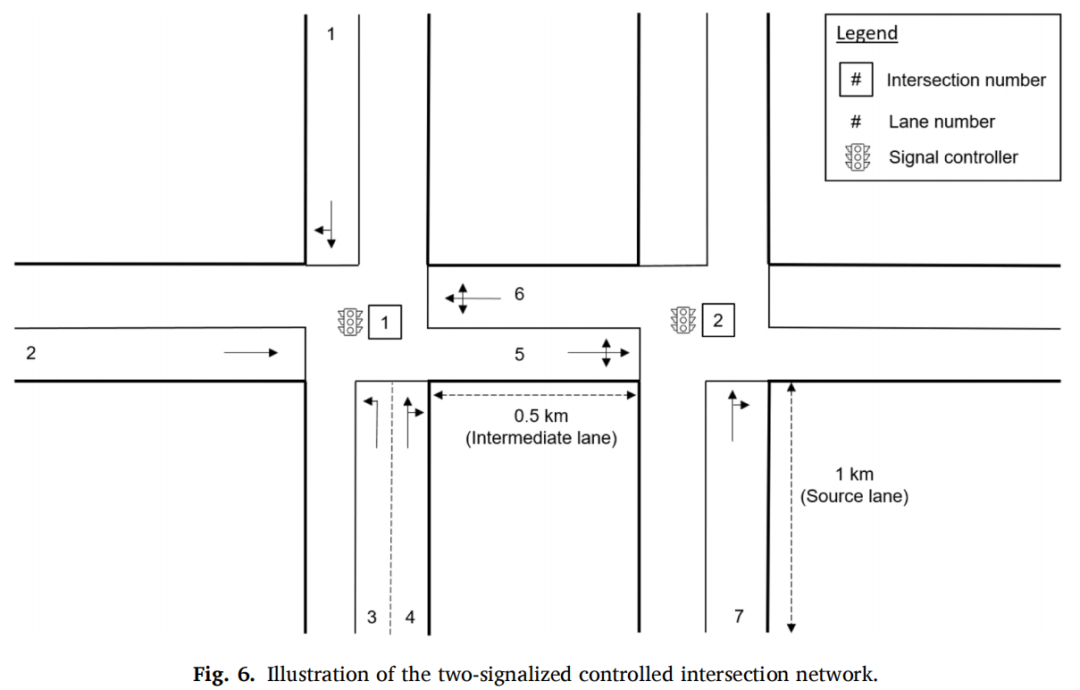
仿真网络:采用 VISSIM 构建两路口信号控制网络,7号车道为源车道、5号车道为中间车道,入口间距约152 m,交叉口信号周期为65 s,含有效红绿时间等参数。 评估指标:以 精确率(Precision)、召回率(Recall)和F1分数衡量 NC 位置估计准确性。
3.2 CVVL‑S子模型仿真结果
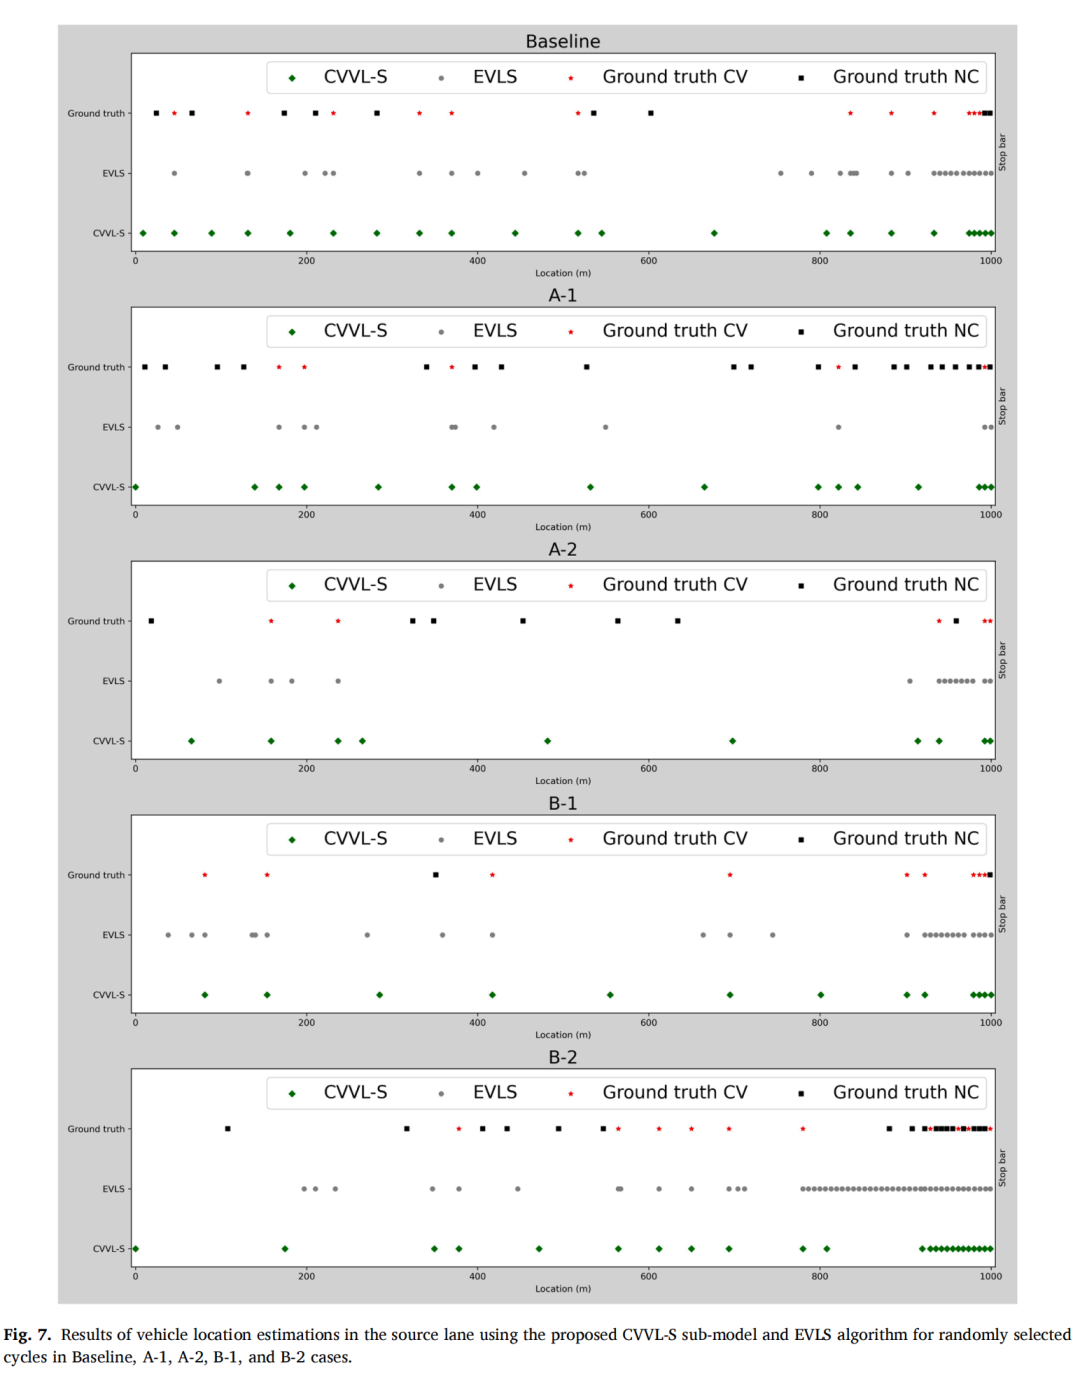
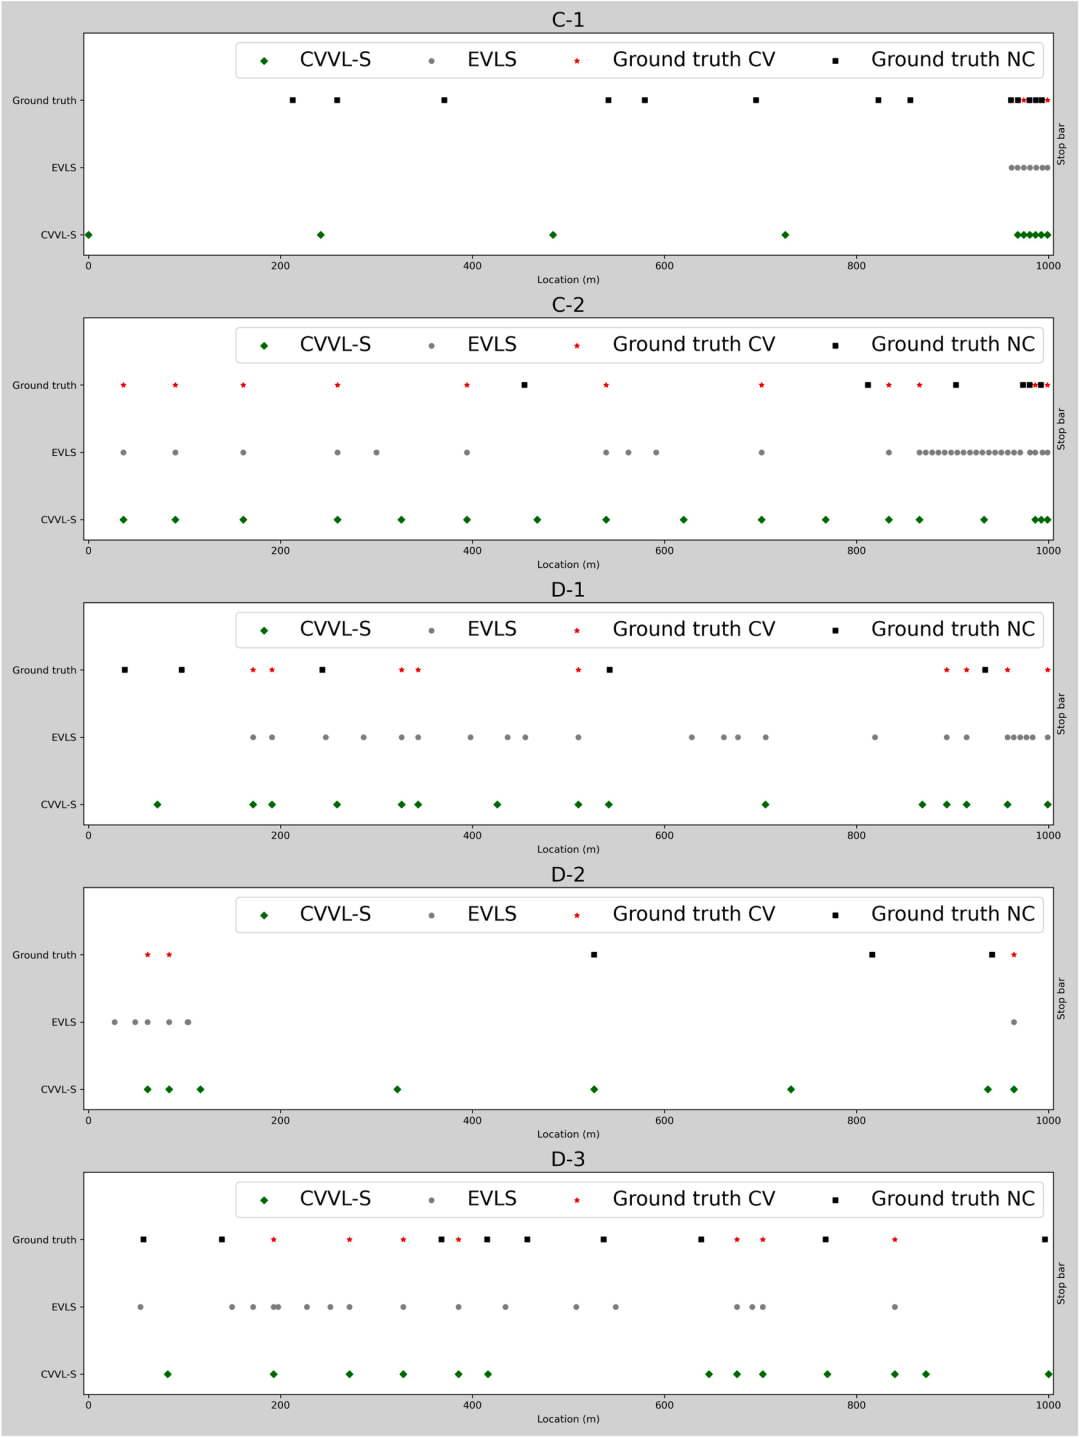
针对源车道(7号车道),作者比较了 CVVL‑S 与基线方法 EVLS 在不同渗透率、信号时长和车流条件下的表现。主要发现如下:
CVVL‑S 在所有场景中都显著提升精确率和召回率,最多提升45%。 对于低渗透率情形(10%~20%),由于 NC 占比高,CVVL‑S 改进幅度更大。 F1 分数提升范围为4%~34%,验证了解析方法对随机到达环境的适应性。
图7、图8分别展示了不同渗透率和信号配置下 CVVL‑S 与 EVLS 的对比结果,CVVL‑S 显著优于 EVLS。
3.3 CVVL‑I子模型仿真结果
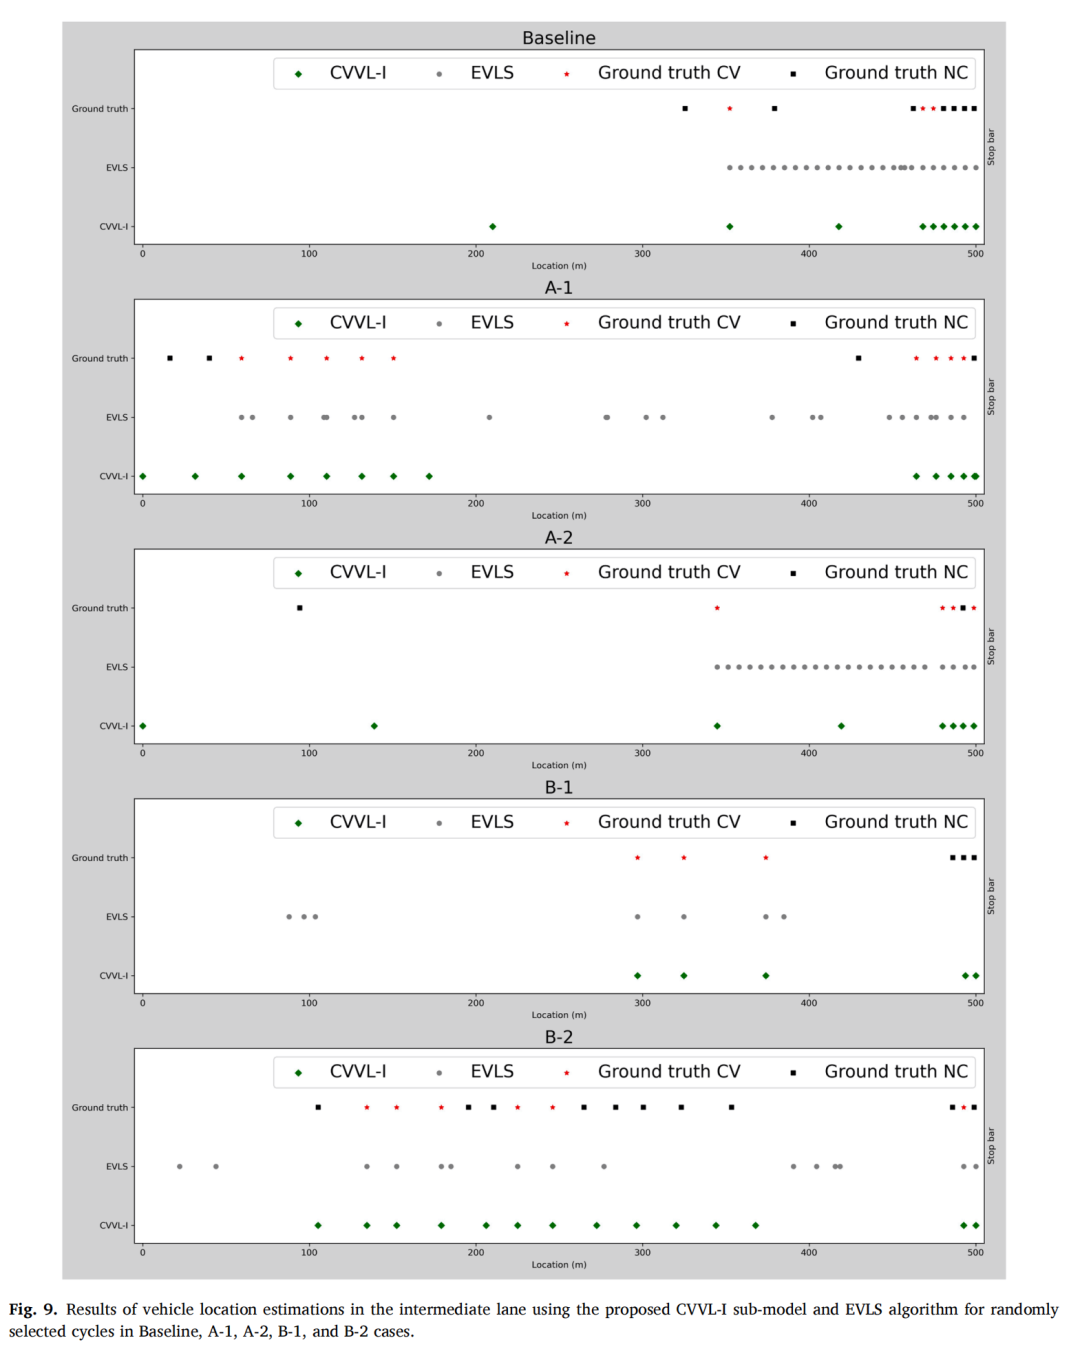
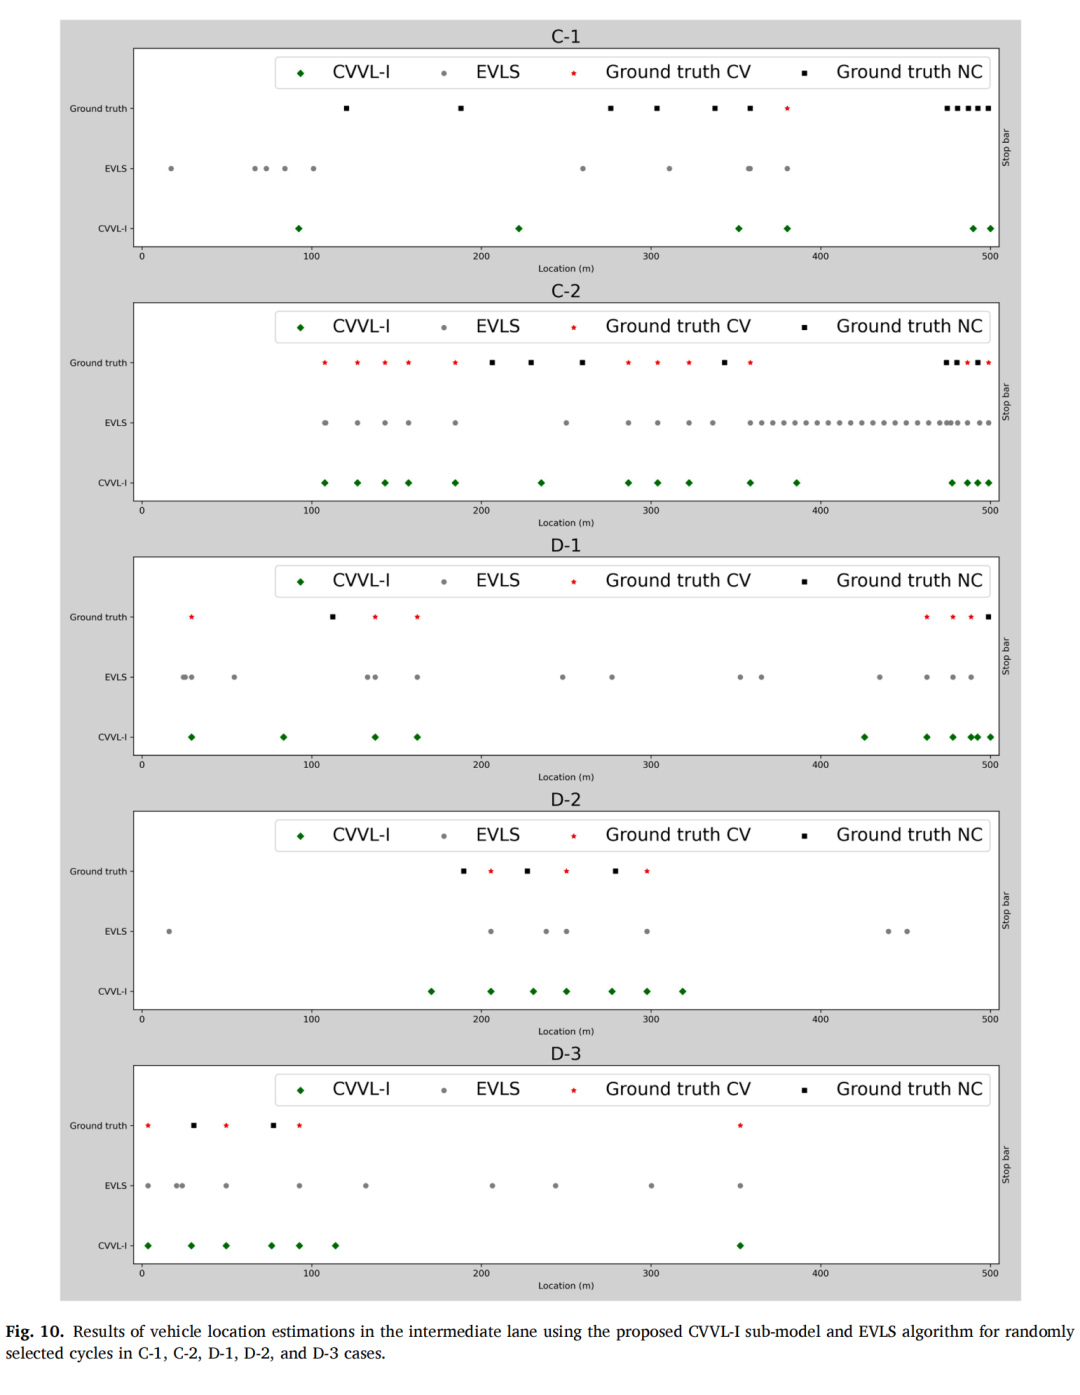
对于中间车道(5号车道),CVVL‑I 与 EVLS 在多车队情况下进行比较。结果表明:
CVVL‑I 在精确率上提升0%~37%,召回率提升0%~26%,F1分数提升4%~20%。 当车队数量增多或信号周期长时,EVLS 易误判车队边界,CVVL‑I 通过 CP 识别准确捕捉车队,优势明显。
下图为不同条件下的 CVVL‑I 与 EVLS 结果对比,CVVL‑I 在多车队情形下的优势明显,特别是低渗透率和复杂信号方案时。
3.4 NGSIM实证验证
为验证模型的实用性,作者在 NGSIM 数据集的亚特兰大桃树街四路口网络上进行实证测试。主要设置包括:道路长度127~132 m;信号周期55 s和100 s;分析两个时段(12:45–13:00和16:00–16:15)。
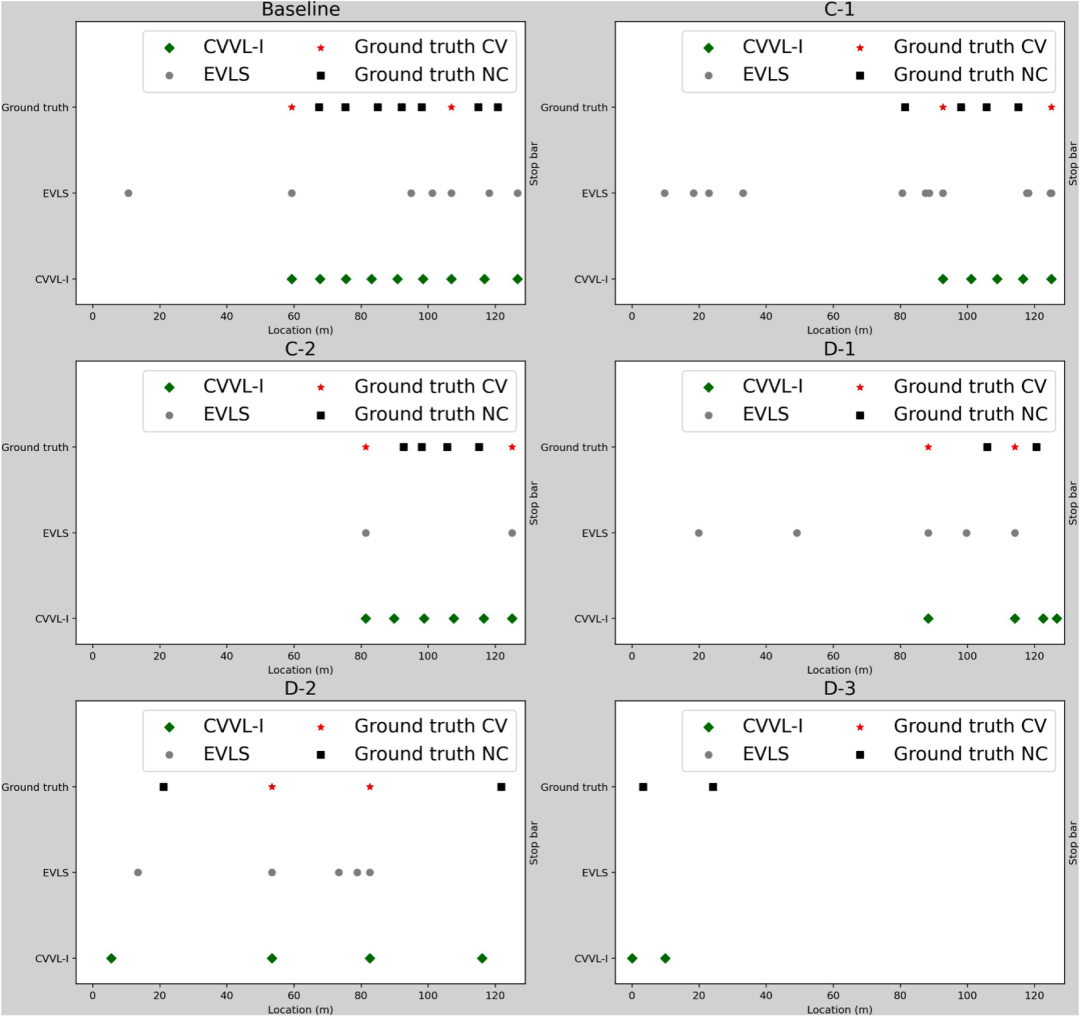
CVVL‑S 结果:在午后时段,CVVL‑S 对精确率和召回率提升约5%~30%;傍晚高峰期,由于道路拥堵和渗透率低,改进幅度更大。 CVVL‑I 结果:在中间车道,CVVL‑I 同样显著优于 EVLS,尤其是车队密集时。 综合结果证明,CVVL 模型能在实际复杂环境下提供可靠的 NC 位置估计。
下面的图11表示 NGSIM 网络的示意图,而图12~15展示了两个时段内源车道和中间车道的性能比较。
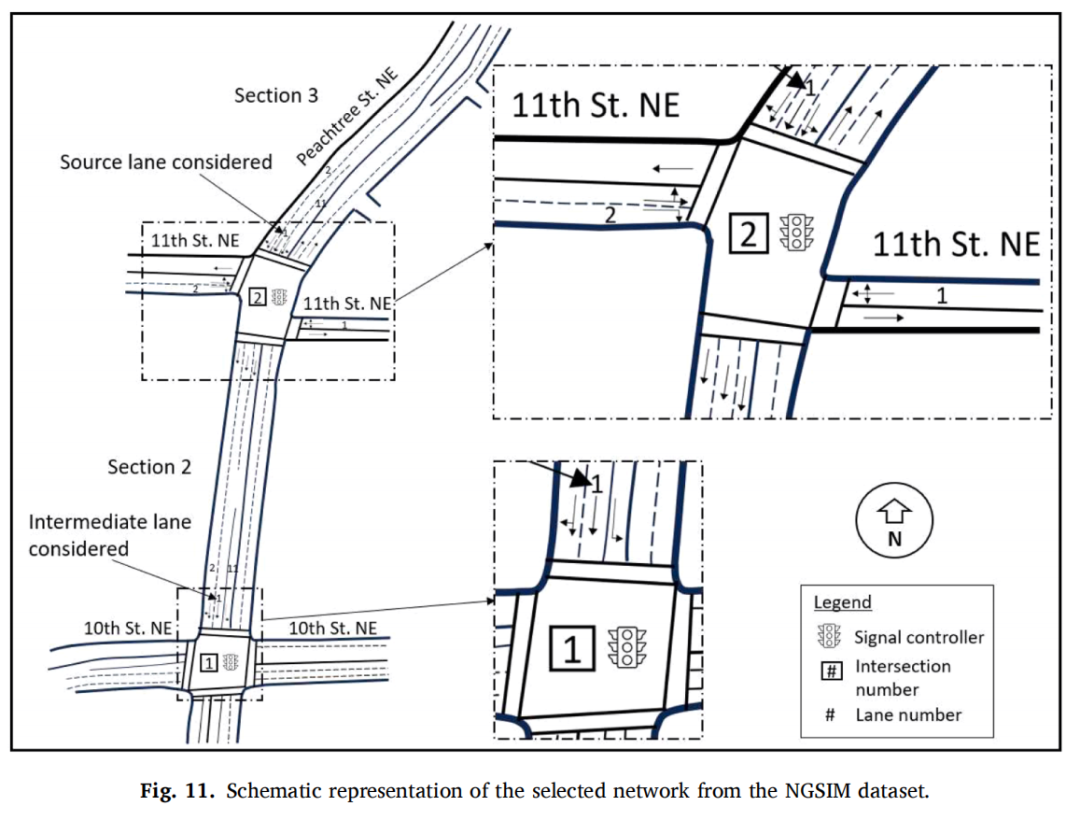
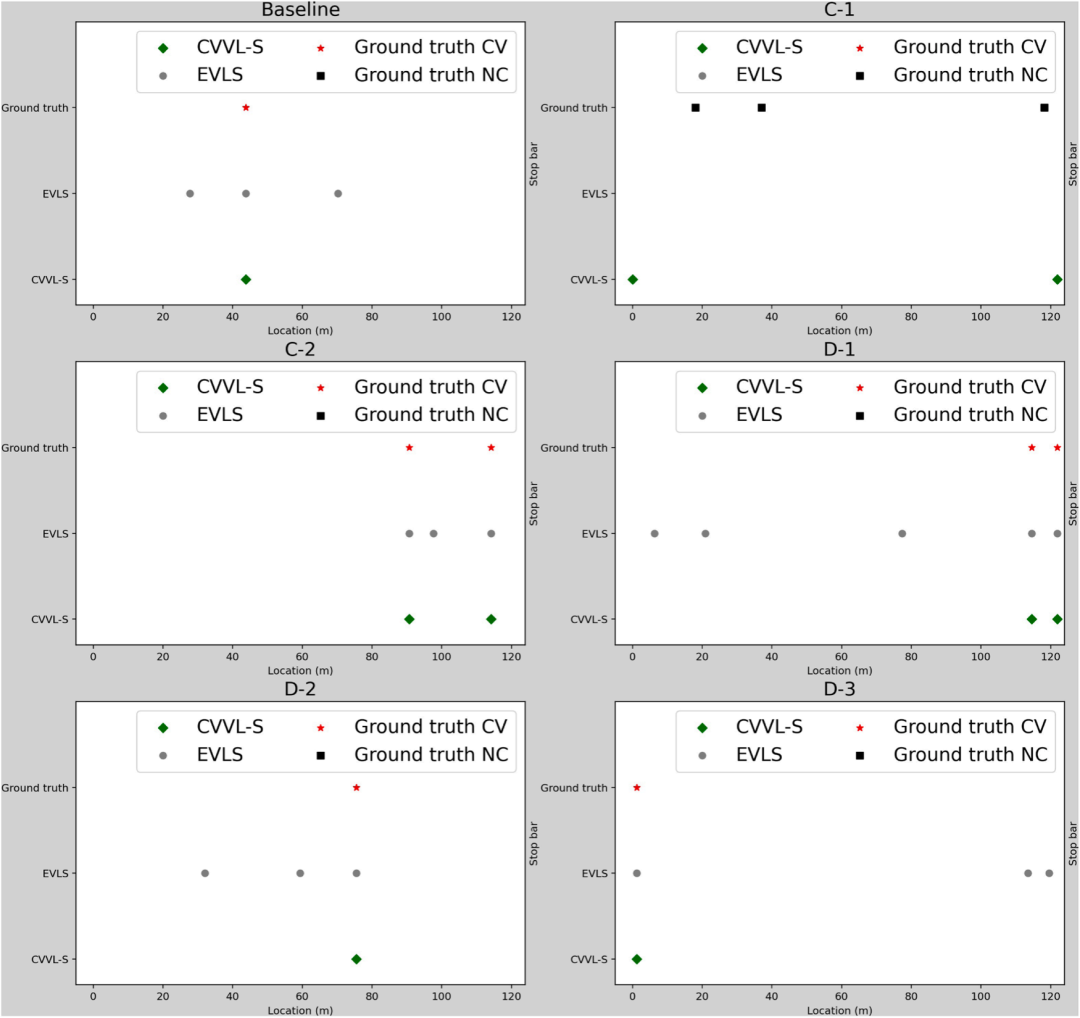
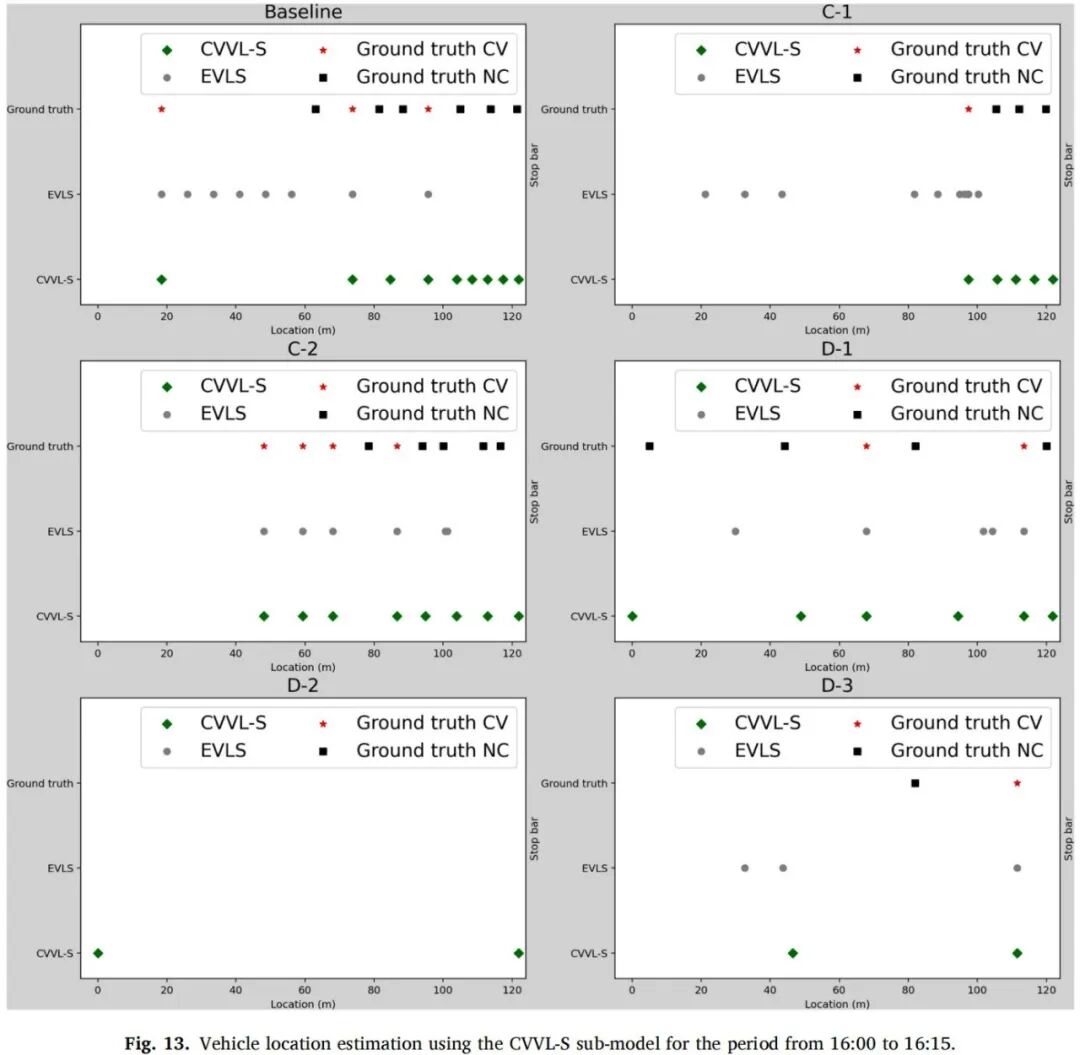
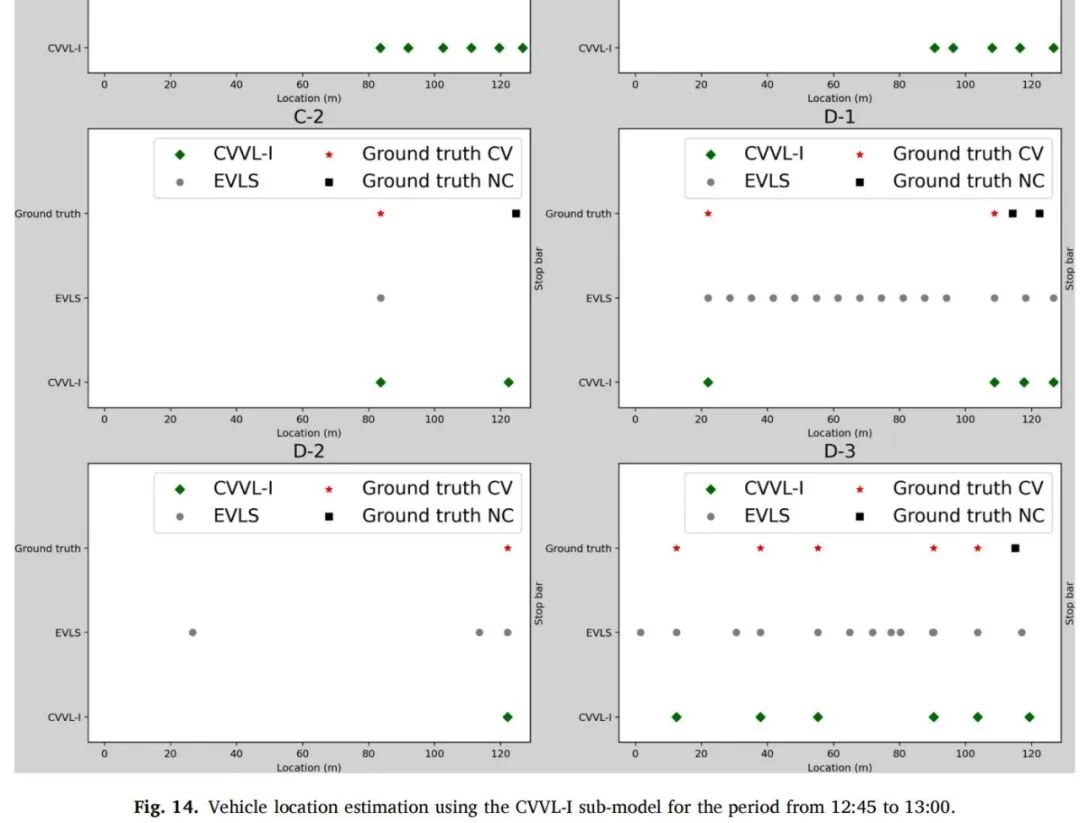
图14 NGSIM中间车道实验结果(12:45–13:00)
四、结论与启示
本文详细解读了《Real-time vehicle location estimation in signalized networks using partial connected vehicle trajectory data》一文,针对部分 CV 数据场景提出的CVVL模型在理论与实践中显示出显著优势。主要贡献包括:
模型针对性强:区分源车道和中间车道,分别提出 CVVL‑S 与 CVVL‑I 子模型,充分利用车辆到达模式差异。 解析方法可解释:通过假设和命题构建闭式解,明确指出 NC 总数计算公式与空间分布推导步骤,避免复杂的黑箱模型。 多源信息融合:结合 CV 轨迹、平均到达率、渗透率和信号时序,通过 CP 识别与加权分配精准估计车队内的 NC。 实验验证充分:仿真与 NGSIM 实证结果表明,CVVL 模型在精确率、召回率和 F1 分数上均显著优于基线 EVLS 方法。 适用性强:模型适用于任意信号时序、交通需求和 CV 渗透率,可为实时旅行时间预测和自适应信号控制提供可靠输入。
但作者也指出,模型依赖于平均到达率和渗透率的估计;未来可结合车联网基础设施动态更新这些参数。此外,对于极低渗透率或异常驾驶行为的情形,模型需要进一步完善。
原文链接:https://doi.org/10.1016/j.trb.2025.103292
以下是我们的微信交流群二维码,欢迎大家进群,群内实时更新推文及原文pdf,方便各位专家学者随时获取(如果二维码失效,请翻阅扫描最新文章的二维码):