多模态公共交通下多类型乘客需求的时空建模与预测:STDAtt-Mamba方法实证研究
原文及链接见文末
小编拙见:深度学习模型搭积木拼凑的风还是吹进了管科期刊 ,未来2-3年大有可为。参考其他深度学习的交叉领域发展趋势,管科物流方向今年末到明年初左右可能会大规模涌现杂交深度学习(各种注意力、塞机制,拼架构),明年下半年再开始一波因果学习辅助深度学习来拔高收割(弥补深度学习的黑盒现象)。
小编目前大三,正备考管综(做公众号纯是备考期间枯燥,又怕与管科物流前沿的方向脱节,故作阅读记录),面对未来的择校与导师选择颇为犹豫和迷茫。学生本科三年期间,科研与竞赛在深度学习与物流优化交叉方向有浅薄经验与成果积累,希望能在智慧物流、管科方向找到一位值得信赖、可以寄托未来6-7年科研生涯的导师(在方向上指点我,细节上信任我)。因公众号后台规则无法主动私信,若有不嫌弃小编资历的老师,非常欢迎直接通过公众号后台私信我,晚辈定会第一时间发送简历与自我介绍,恳请前辈们不吝赐教!
希望能在学术征途上与优秀的师长共成长,期待与您的相遇。谢谢!
一、研究背景与动机
公共交通系统服务的对象涵盖成年人、儿童、老年人、学生、失业者等多种群体,各群体的出行目的和时间规律差异显著。对于运营者而言,精准预测不同群体的乘客需求是提高营运效率、公平性和可持续性的重要前提。然而现有方法往往针对整体客流进行建模,无法同时捕捉不同群体在 空间(站点分布)和时间(小时/日/周周期) 上的复杂动态,从而限制了需求预测的准确性。
深度学习模型在时空预测领域取得了进展,但仍有显著局限:
RNN/LSTM/CNN:难以学习长距离依赖或缺乏时空融合能力。 GNN:依赖消息传递机制,主要关注局部邻域,难以捕捉远程依赖且需要构建图结构。 Transformer:自注意力可建模长依赖,但复杂度为 ,对长序列效率低。 Mamba:一种状态空间模型,能高效捕捉长序列依赖,但只能处理时间序列,无法融合空间信息。
针对这些问题,作者提出 STDAtt‑Mamba 模型,通过动态融合空间和时间信息,并利用稀疏注意机制与 Mamba 状态空间模块相结合,实现高效、可解释的多类型乘客需求预测。
二、数据集与问题定义
1. 数据集概述
论文使用澳大利亚昆士兰州 Go Card 电子票务系统 2021–2023 年的数据,覆盖巴士、铁路和轮渡三种交通方式,涉及 1.582 million 名独立乘客。为了建模不同群体的需求,作者选取出现次数最多的九种乘客类型:成人、老年人、退休人员、高校学生、儿童、青少年、求职者、学校通勤者和 Gold Repatriate。三种交通模式的数据规模如下:
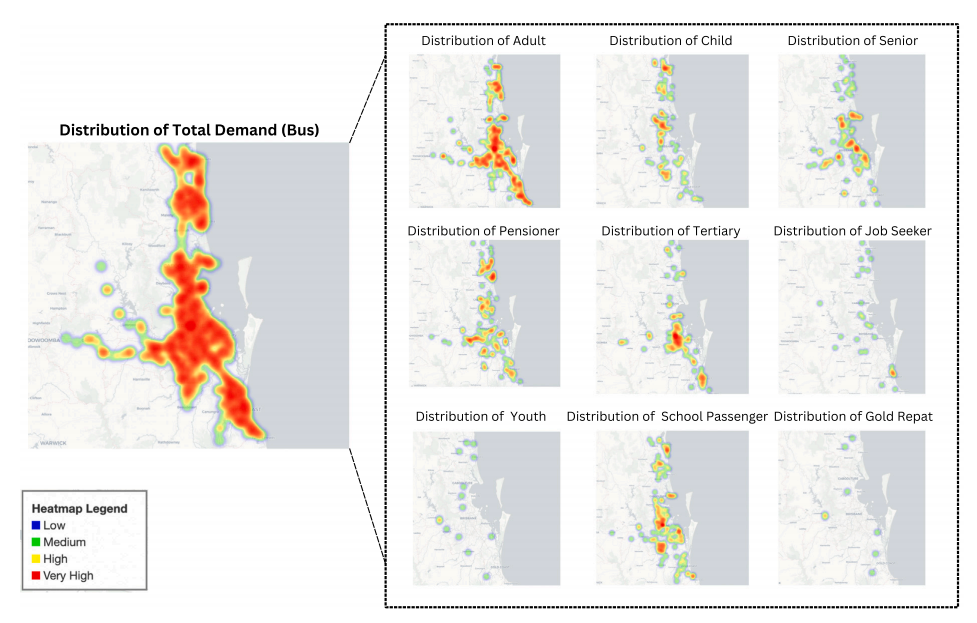
下图展示了巴士乘客需求在 9 类群体上的空间分布热力图,可见不同群体呈现完全不同的热点区域,其中成人和学生群体集中在布里斯班市区和走廊沿线,而老年群体更集中于生活区周边:
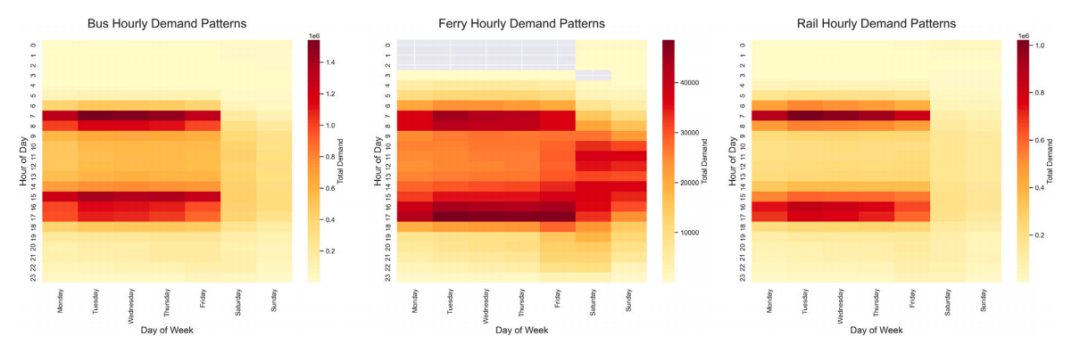
论文还分析了需求的时间异质性。图 2 展示了巴士、轮渡和铁路的按周—时刻的需求热力图,可见通勤模式下早晚高峰非常明显,而轮渡需求总体较低且变化较平缓。
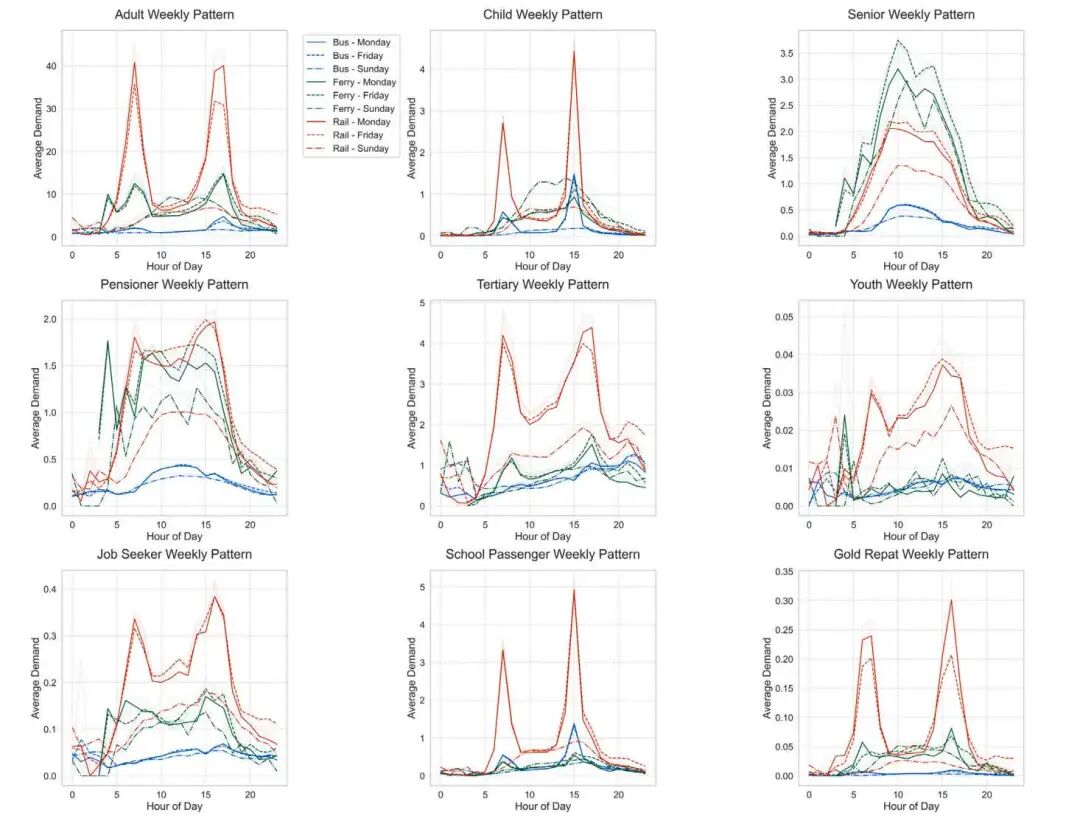
进一步将时间划分到每个乘客群体,周内需求呈现更复杂的模式。例如图 3 显示成人、儿童、老年人等九类乘客在一周内各小时的平均需求,成人及学生在周一至周五的早晚高峰最为突出,而老年人和退休人员的需求则分布在白天中间时间段。
2. 问题定义
令 表示交通方式集合(巴士、铁路、轮渡), 为站点数, 为乘客类型数, 为时间步数。对于模式 ,在时间步 的需求矩阵为 ,整个时间序列输入为
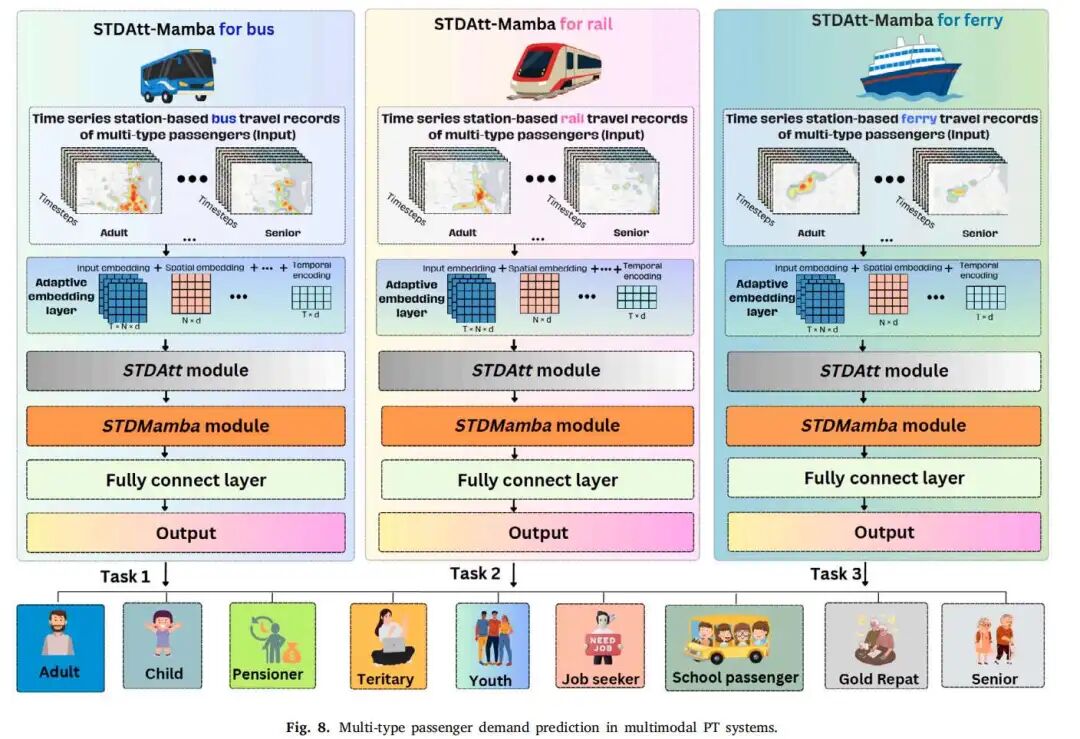
模型需要利用过去 个时间步的需求序列预测未来 个时间步(如 12 h、24 h 或 7 天)的需求 。由于包含多种交通模式,论文采用多任务学习框架,将每个交通方式视为一个任务,在共享模型参数的前提下输出各自的预测。
三、STDAtt‑Mamba 模型结构与技术细节
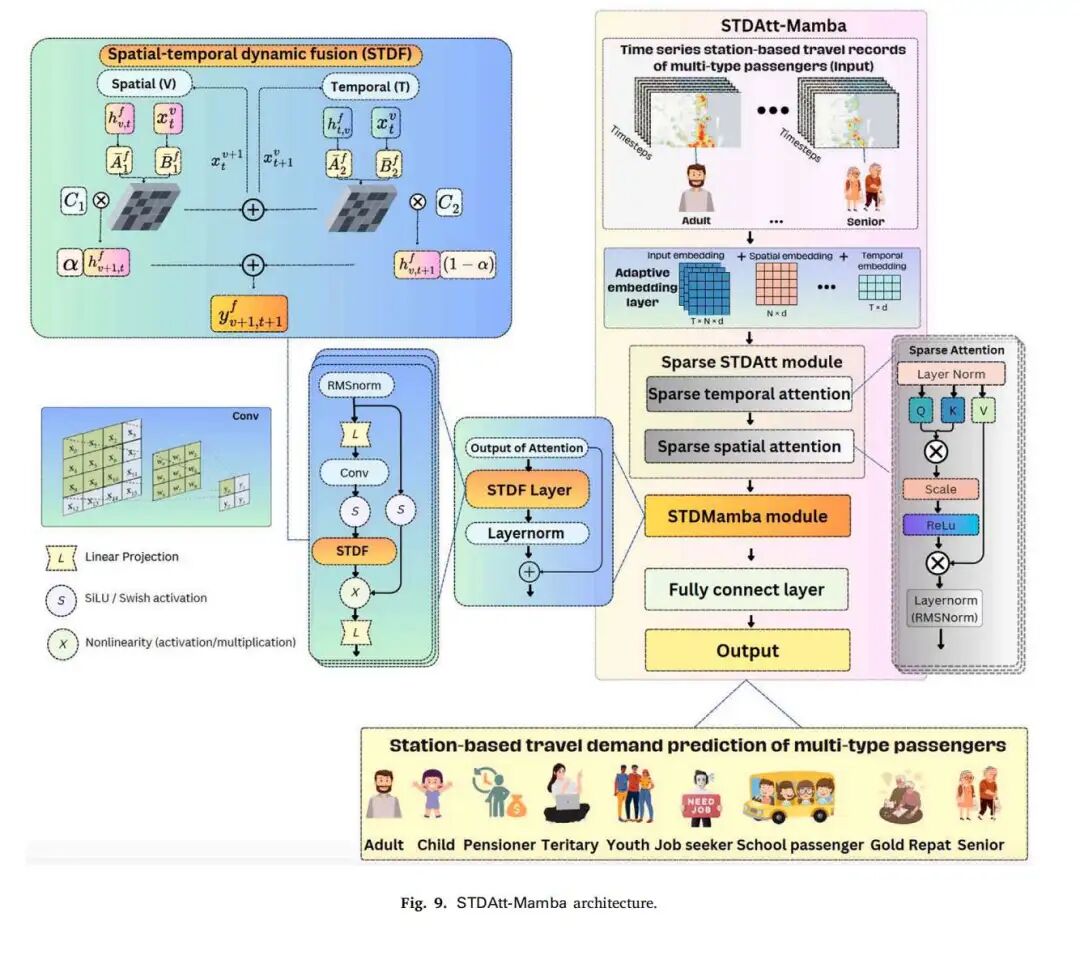
STDAtt‑Mamba 由三个关键模块组成:自适应嵌入层、空间–时间动态注意 (STDAtt) 模块和 空间–时间动态 Mamba (STDMamba) 模块。整体架构如图 4 所示。
1. 自适应嵌入层
输入的原始数据 是一个三维张量(时间、空间、乘客类型)。作者使用全连接层将其映射为特征嵌入 。随后将星期几和一天中的时间分别编码为,通过重复扩充到空间维度得到。此外引入一个共享的可训练适应性嵌入 ,综合得到最终嵌入:
自适应嵌入可以学习不同乘客群体和不同时间段的特征,有助于多任务模型的共享。
2. STDAtt 模块:稀疏时空注意机制
由于公共交通需求的时空关联往往集中在特定时间段或站点,作者设计了稀疏注意机制,在时间和空间维度分别学习重要依赖关系。
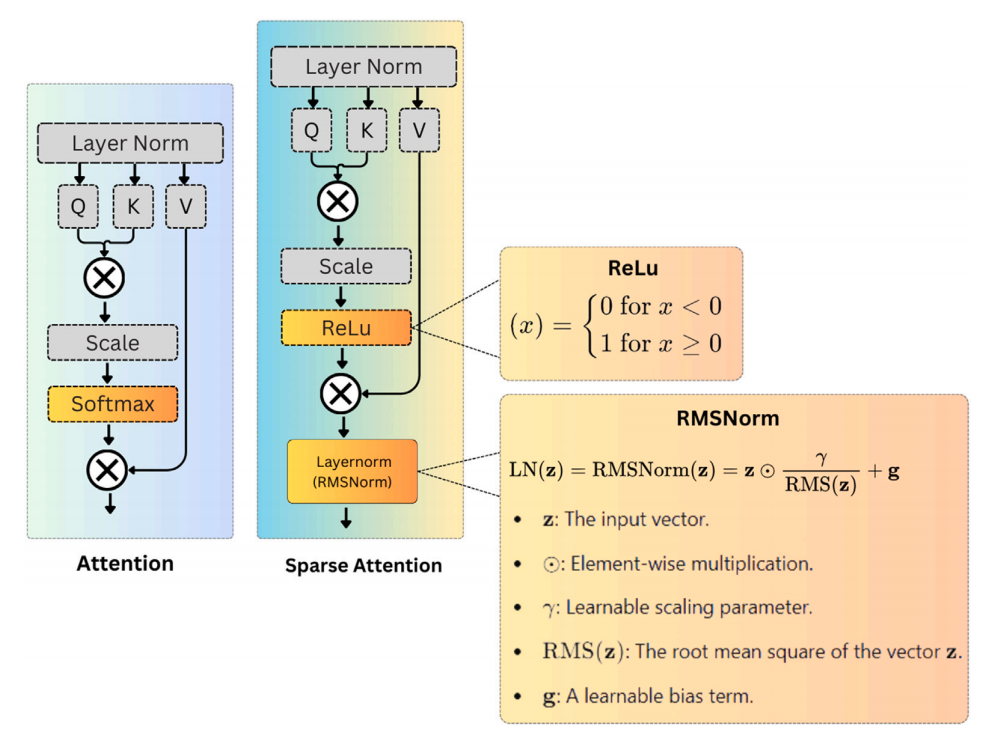
稀疏时间注意:对每个站点 的时间序列 计算查询 、键 、值 ,使用缩放点积并通过 ReLU 激活使注意权重非负:
ReLU 使得只有显著的时间步获得注意权,从而实现稀疏性。同理,在空间维度对各时间步的站点输入 计算稀疏空间注意权重:
STDAtt 模块最终输出融合了时间和空间关系的表示 。
值得注意的是,作者将标准自注意力中使用的 Softmax 换成 ReLU 和 RMSNorm,显著降低了计算开销并强化了稀疏性,这一点在图 5 中通过对比标准注意与稀疏注意进行了示意说明:
3. STDMamba 模块:双路径空间–时间状态空间模型
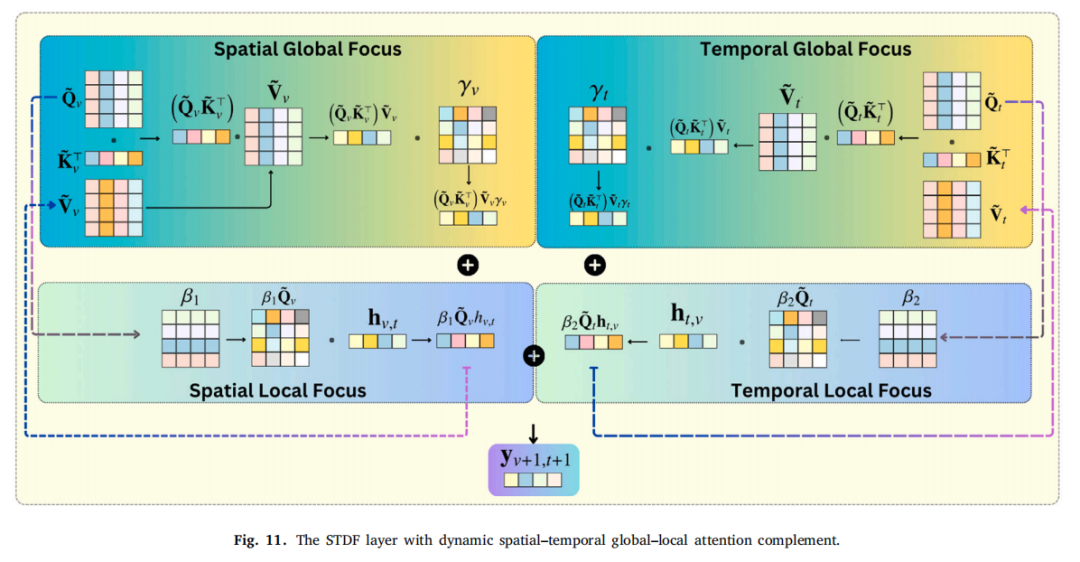
Mamba 是一种选择性状态空间模型,能以线性复杂度捕捉长距离依赖,但原始设计仅针对时间序列。作者将其扩展到空间维度,并在 STDF(空间–时间动态融合)层 中融合两个“时间”维度——时间 和站点索引 。连续形式的双路径状态空间模型可写成:
离散化后,更新公式为:
最终输出按可训练权重 融合空间路径和时间路径:
这种双路径结构能分别建模局部和全局依赖,为理解模型提供了直观解释:STDAtt 捕获长距离全局模式,STDMamba 捕获局部动态,并通过 STDF 层综合。图 6 给出了四种注意视角:空间全局、时间全局、空间局部和时间局部,展示了动态融合过程。
4. 输出与训练
经过多层 STDMamba 堆叠后,通过前馈网络输出未来 个时间步的需求 。作者采用多任务学习,各交通方式共享嵌入和部分参数,不同任务使用独立的全连接头输出各自的多乘客类型需求。
四、实验设计与结果分析
1. 实验设置
预测指标:选择平均绝对误差 (MAE)、均方根误差 (RMSE) 以及平均绝对百分比误差 (MAPE) 评估各模型。 对比基线:包括传统时间序列模型(ARIMA、SARIMA、VAR、SVR)、深度学习模型(HI、GWNet、DCRNN、AGCRN、STGCN、GTS、MTGNN、GMAN、PDFormer、STNorm、STID、STAEFormer、ST‑MambaSync)以及两个多任务模型 MTGNN、MT-STNet。 多任务学习:使用 8:1:1 划分训练、验证和测试集,预测未来 12h、24h 和 7d 的需求。
2. 主要结果
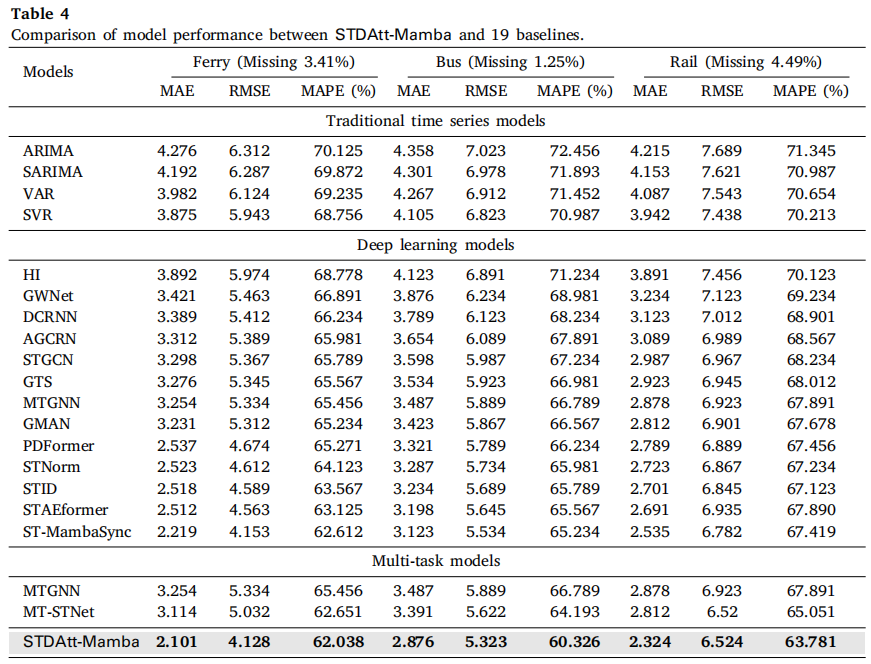
表 4 比较了 STDAtt‑Mamba 与 19 个基线模型在三种交通方式上的表现。结果表明 STDAtt‑Mamba 在所有指标上均取得最佳成绩。例如,在巴士模式下,STDAtt‑Mamba 的 MAE=2.876,显著低于 ST‑MambaSync(3.123)和 STAEFormer(3.198);MAPE 仅为 60.326%,比其他模型低 3–5 个百分点。作者指出,图卷积模型由于仅捕捉局部关系,难以处理长距离依赖;Transformer 模型虽然对长序列表现更好,但复杂度高且缺乏空间动态融合;Mamba 提供高效的序列建模,但缺乏空间建模能力。STDAtt‑Mamba 融合稀疏注意力与 Mamba,实现了全局与局部的互补。
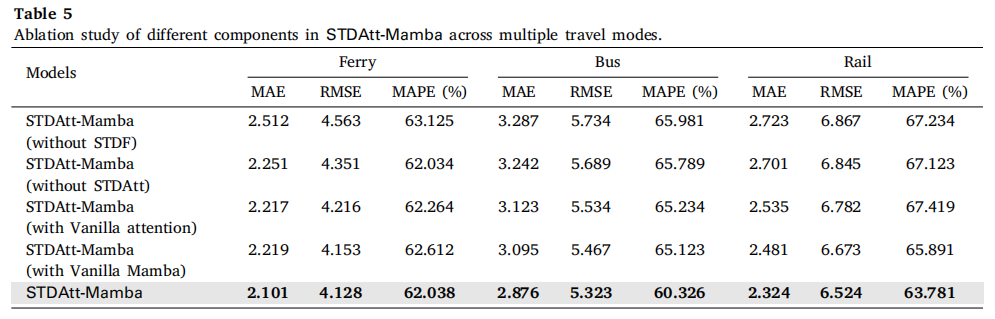
此外,表 5 的消融实验验证了各组件的重要性。去掉 STDF 层或 STDAtt 模块都会导致明显的性能下降,其中删除 STDF 层(仅采用 STDAtt 和 STDMamba 线性堆叠)使 ferry 数据的 MAE 从 2.101 提升到 2.512,说明动态融合对捕捉时空交互至关重要。将稀疏注意替换为普通注意或将 Mamba 替换为 vanilla Mamba 同样会劣化模型。
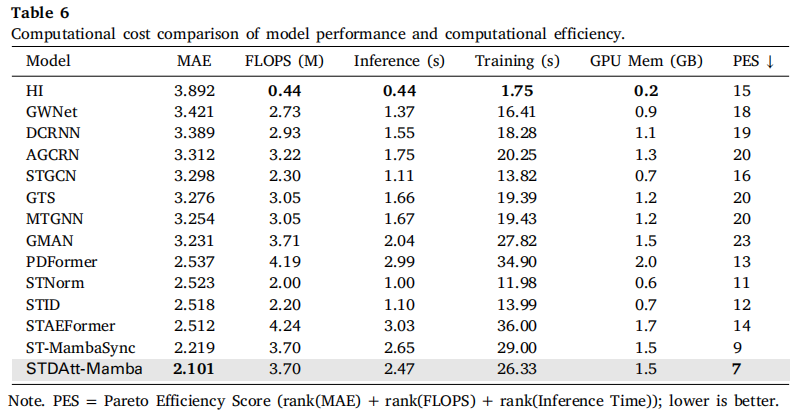
为了衡量模型效率,作者在表 6 中比较了计算成本,计算推理时间、训练时间及 GPU 显存占用,并用 Pareto 效率得分 (PES) 综合衡量。STDAtt‑Mamba 的 PES = 7,为所有模型中最低,说明在精度和效率之间取得最佳权衡。
3. 多任务学习优势
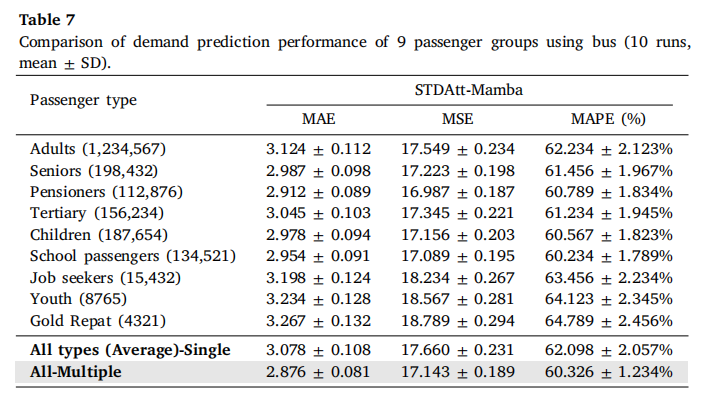
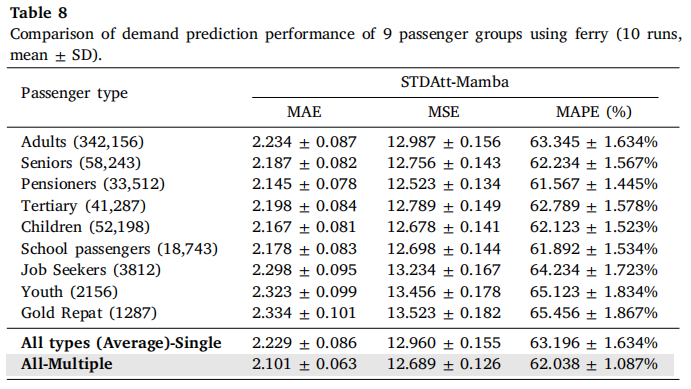
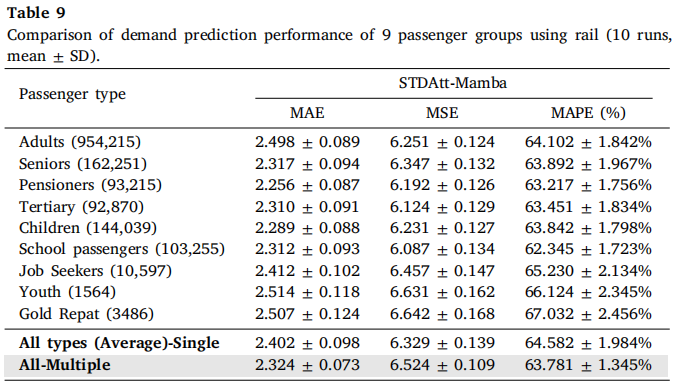
作者将 STDAtt‑Mamba 用于单任务(只预测单一交通模式)和多任务(同时预测三种模式)两种设置,并在巴士、轮渡、铁路上分别比较 9 个乘客类型的误差(表 7–9)。多任务模型对九种乘客类型的平均 MAE 和 MAPE 均低于单任务模型,尤其是在样本较少的群体(如 Gold Repat、Youth 等)上提升明显,说明共享知识有助于减少过拟合并提升泛化能力。
4. 预测曲线与空间结果可视化
论文还提供了多种可视化分析。
图 14–16 比较了 STDAtt‑Mamba 与 ST‑MambaSync、STAEFormer 在不同预测范围(12h、24h、7d)内的曲线,STDAtt‑Mamba 能更好地跟踪真实需求,特别是准确捕捉到尖峰和谷底。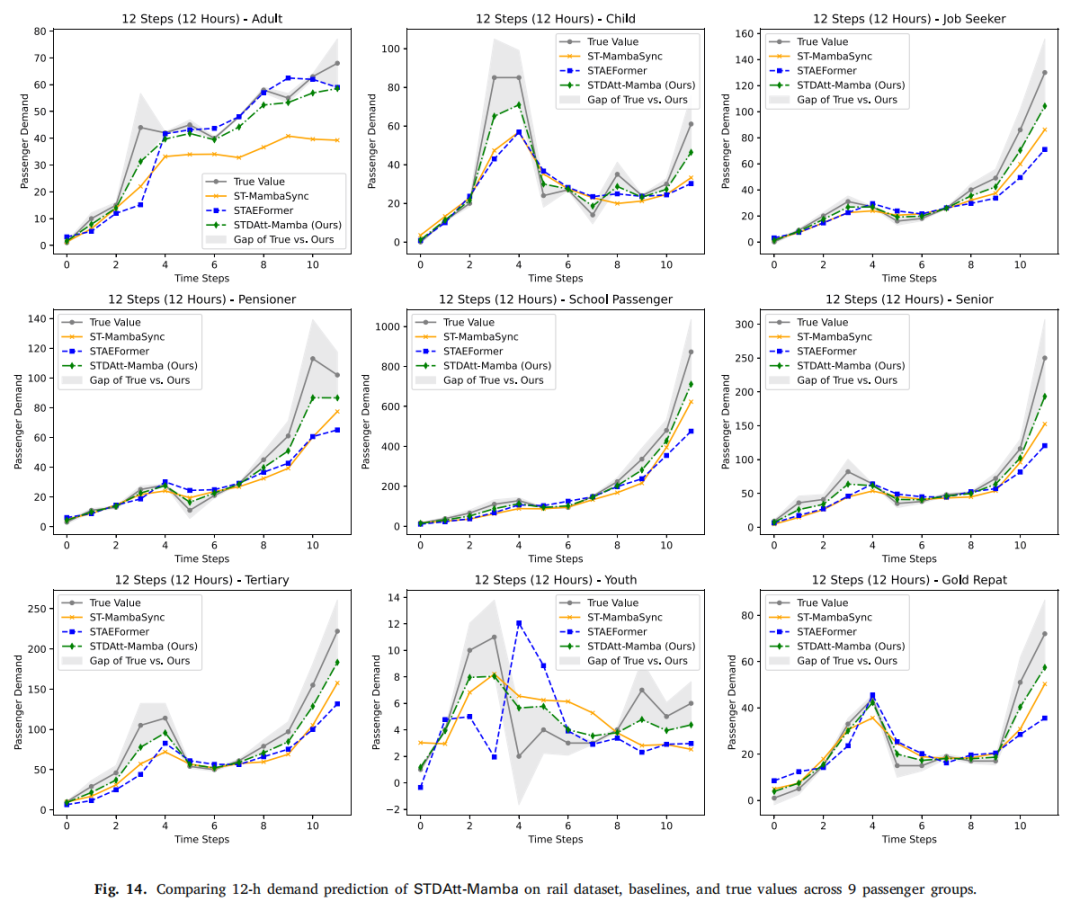
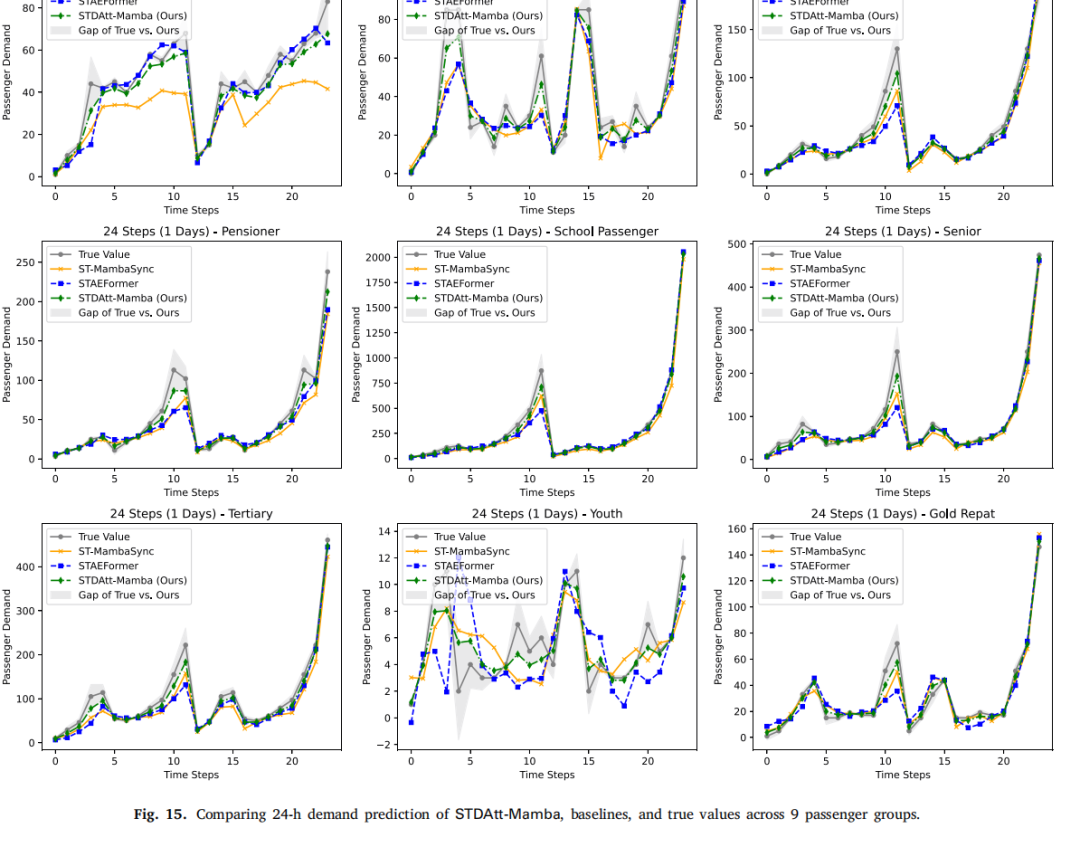
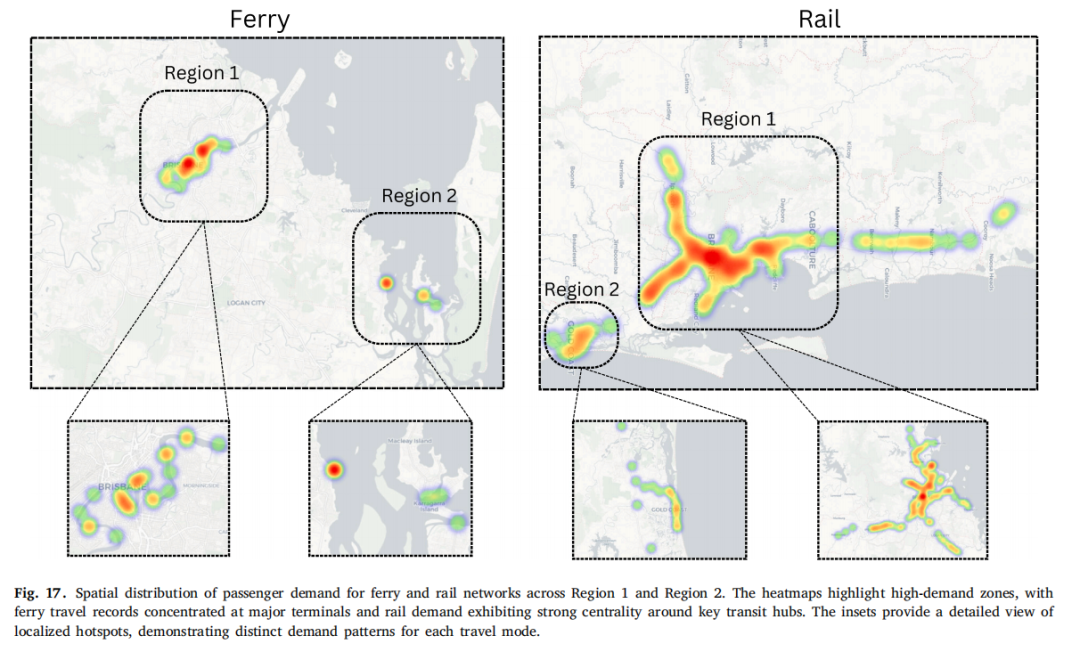
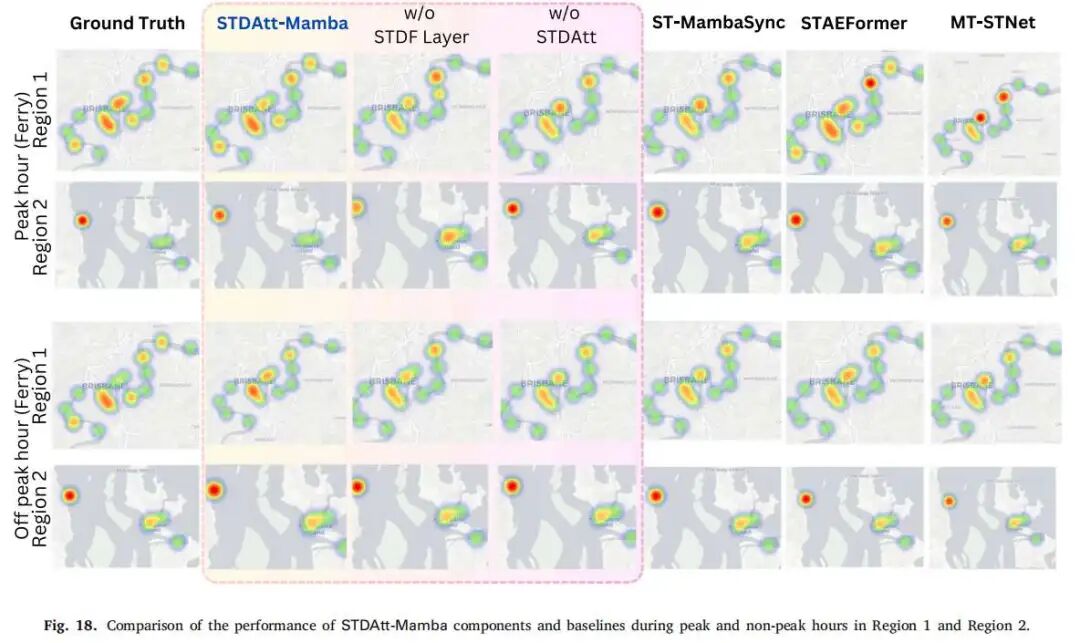
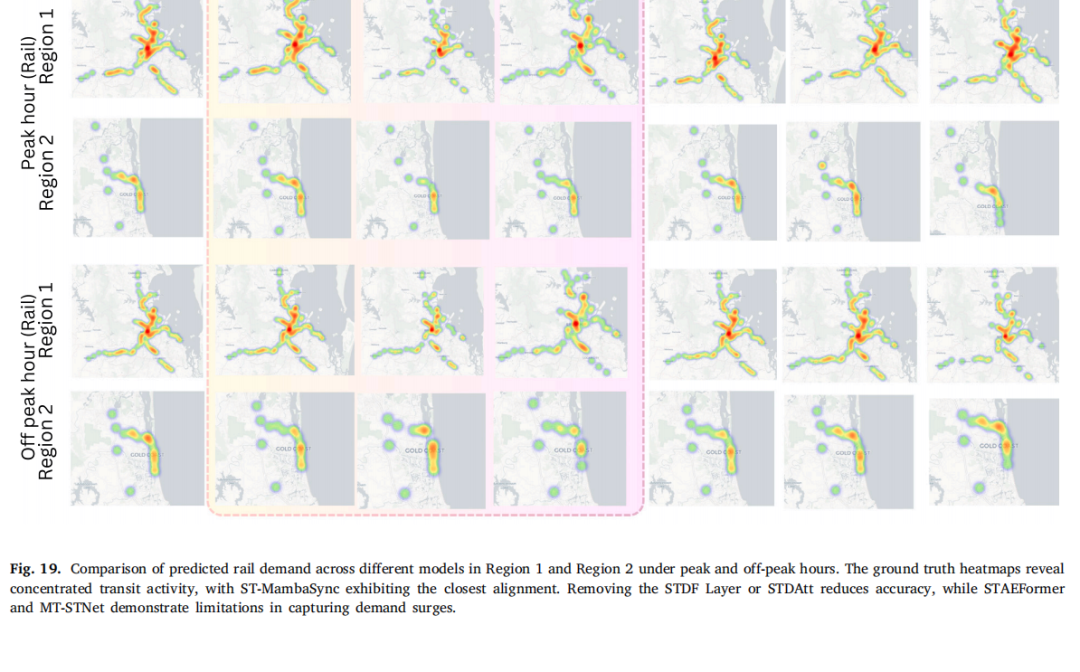
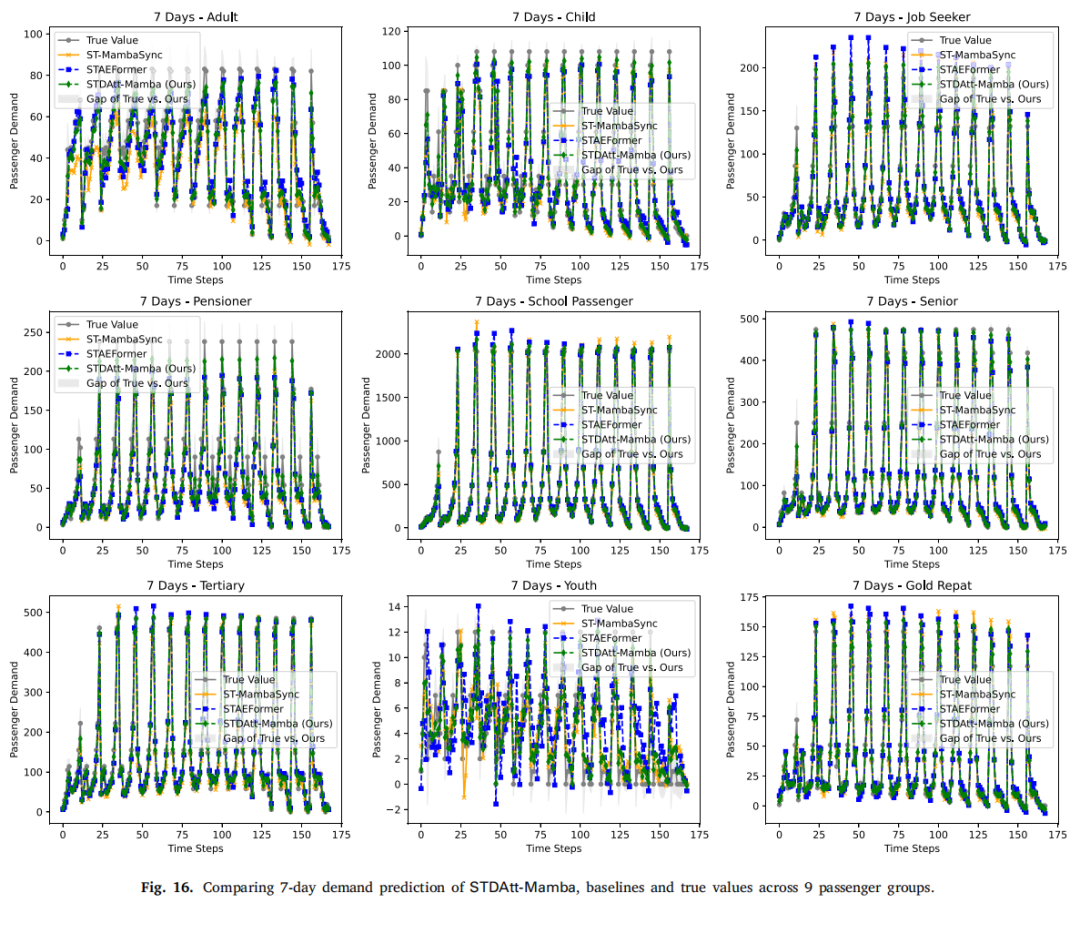 图 17–19 展示了在不同区域 (Region 1、Region 2) 的空间预测热力图,STDAtt‑Mamba 与真实分布几乎一致,而去掉 STDF 或 STDAtt 的版本则出现热点位置偏移或过度平滑。这些结果说明模型不仅在数值指标上领先,而且预测结果更接近现实分布。
五、结论与展望
论文针对多乘客类型需求预测提出了 STDAtt‑Mamba 模型,主要贡献包括:
提出多任务时空预测框架:首次将 Mamba 状态空间模型扩展到时空双通道,通过 STDF 层 动态融合空间与时间,配合 稀疏注意力 捕捉长程依赖,实现高效、可解释的预测。 稀疏注意与局部状态空间互补:STDAtt 模块用 ReLU 激活实现稀疏全局注意,抑制无关信息;STDMamba 模块专注于局部动态,两者的互补使模型能同时处理长期趋势和短期波动。 多任务学习提升小样本群体预测:同时预测巴士、铁路和轮渡能共享跨模式特征,提高对少数群体(如 Gold Repat)的预测准确度。 大规模实证验证:在 1.58 million 乘客、三种交通模式的真实数据上,STDAtt‑Mamba 在 MAE、RMSE、MAPE 指标上均明显优于 19 个基线模型,并且在计算效率上达到较好的平衡。
未来研究方向
作者指出未来可探索以下方向:① 将模型扩展到更多交通方式或其他出行数据(如出租车、共享单车),验证其泛化性;② 结合图学习方法自动构建站点关系图,实现端到端训练;③ 研究不确定性估计和决策支持,使模型输出能指导运力调度和定价策略;④ 进一步优化模型结构,提高实际部署效率。


