考虑服务取消行为的网约车派单策略与定价方案
原文链接见文底
一、研究背景
网约车平台(如 Uber、Lyft 或滴滴)通过移动应用撮合乘客和司机,但平台在派单时需要综合考虑接车距离、订单奖励、司机评分、安全行为、乘客偏好以及实时路况等多种因素。如果派单策略效率低下,乘客或司机可能取消服务。另一方面,隐私法规限制了平台对乘客服务价值和司机保留收益率的了解。这种缺乏信息的环境意味着初始匹配存在不确定性,需要考虑双方取消的可能。
全球多地已经出台了《欧盟通用数据保护条例》(GDPR)、中国数据安全法和美国《数据隐私保护法案》等法律,进一步限制个人信息采集。因此,平台无法准确获知乘客愿意支付的单价或司机的最低期望收入,只能依据统计分布进行决策。这些现实问题使得研究在信息受限情况下的派单策略与定价具有重要意义。
下图展示了论文中的一项统计:分别分析了 Uber 机场–市区线路以及新加坡众包配送平台的取消率,可见取消行为普遍存在。
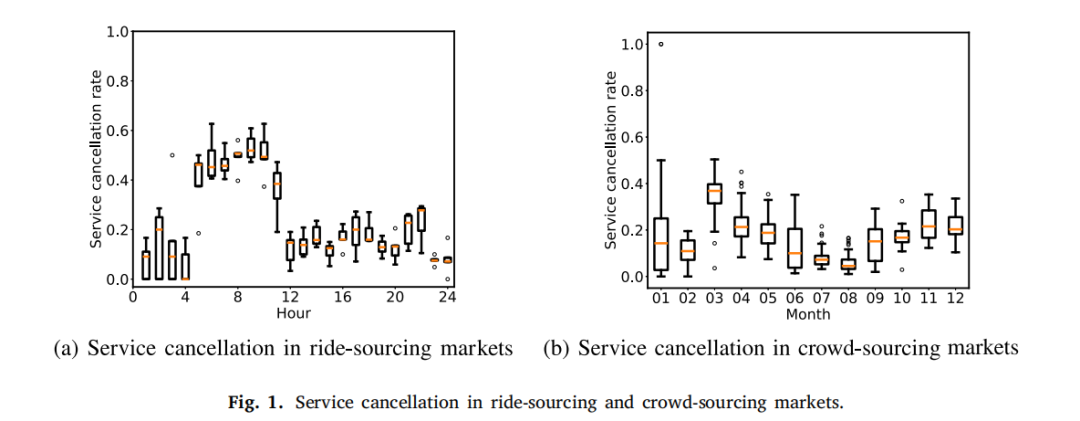
图1:乘客/司机取消率的示例。左图为 Uber 机场到市区线路 2016 年的取消率箱线图;右图为新加坡某众包配送平台 2021 年各月取消率统计。
二、论文试图解决的问题
论文关注的是:在隐私受限、乘客/司机可能取消订单的情况下,平台如何制定派单策略与定价方案以最大化平台收益,并兼顾匹配效率与乘客满意度。具体而言,作者指出:
传统平台会选择最近司机或基于经验的贪婪派单,但这种策略忽视了未来的取消风险; 不同的定价结构(线性、超线性或次线性)会影响乘客与司机对匹配结果的接受程度,从而改变匹配概率; 由于缺乏对乘客价值和司机保留收益率的精准信息,平台在派单阶段面临分布不确定性(distributional ambiguity)问题。
论文的目标是提出一套考虑取消行为的派单–定价模型,量化不同定价函数对匹配概率、平台收益和派单顺序的影响,并提供可行的算法解决方案。
三、模型与方法
1. 两阶段决策框架
作者构建了一个两阶段模型来描述整个匹配流程(见图2):
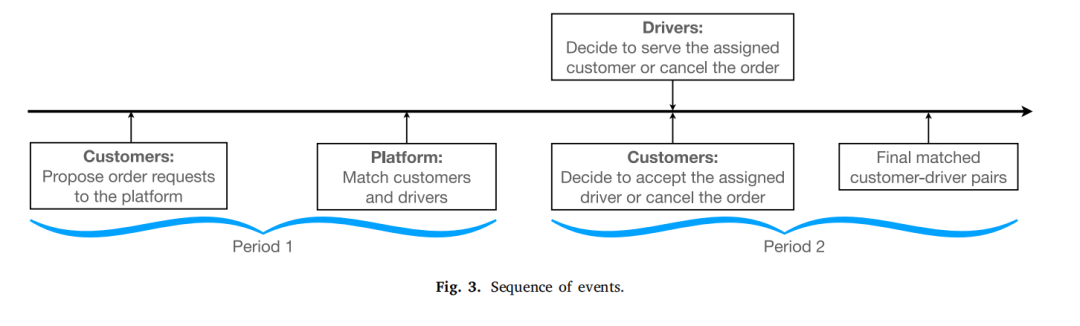
图2:两阶段决策流程示意。第一阶段,乘客根据预估价格决定是否发出订单请求;平台根据乘客的起终点信息将订单匹配给可用司机;第二阶段,司机和乘客在看到具体的接送信息后选择接受还是拒绝,只有双方都接受才能形成最终匹配。
在第一阶段,乘客对每单位距离的服务估值在 [0, v̄] 上服从某一累积分布 F(⋅),平台只能获取该分布而不能获知具体值。乘客的服务盈余为V_i(d_i) = v_i ⋅ d_i - p(d_i),其中 d_i 为行程距离,p(d_i) 为平台对该行程的定价函数。当盈余非负时乘客才会下单。平台在接单阶段通过决策变量 x_ij ∈ {0, 1} 将乘客 i 分配给司机 j;由于对双方的私人信息未知,平台无法保证初始匹配必然成立,这给下一阶段带来随机性。
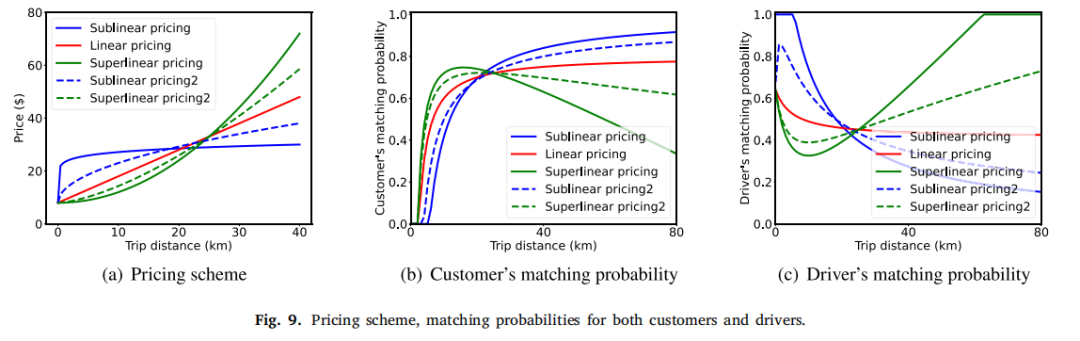
第二阶段,乘客根据实际接送时间和费用决定是否接受匹配。作者证明,乘客接受服务的概率取决于价格函数 p(⋅) 的二阶导数:
若定价函数凹(或线性、次线性),则匹配接受概率随行程距离增加而增长; 若定价函数凸(超线性),则匹配接受概率随着行程距离呈倒U型:当距离较短时接受概率上升,超过某一阈值后下降。
类似地,司机的收益为W_j = p(d_i)/β + t_ij − c_j (其中 β 是司机平均速度,t_ij 是接载时间,c_j 是司机的保留收益率),司机接受匹配的概率由支付函数 w(⋅) 决定。
2. 平台优化模型与定价策略
平台的目标是最大化预期收益,其决策变量是匹配矩阵 x_ij。作者将该问题表述为一个随机优化模型:
其中 z_ij ∈ {0, 1} 表示第二阶段匹配成功与否,L 是取消带来的惩罚。约束条件保证每个乘客和每个司机最多参与一次匹配。
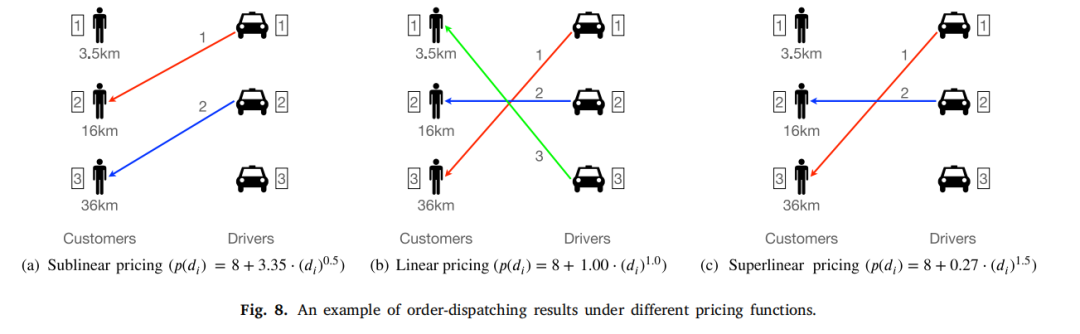
定价方面,论文考虑了基于距离的幂函数定价模型:p(d) = p_0 + α d^θ,其中 p_0 为起步价,α 为系数,指数 θ = 1 表示线性定价,θ < 1 表示次线性定价,θ > 1 表示超线性定价。
3. 贪婪近似算法
优化模型实质上是一个带权二分匹配问题。传统的匈牙利算法或整数规划能得到精确解,但在数以万计的乘客和司机规模下计算代价高,难以满足实时派单需要。为此,作者设计了一种贪婪近似算法:
根据计算得到的每一对乘客–司机的收益权重 R_ij排序;依次选择权重最大的未覆盖边 (i,j)进入匹配集合,并将对应的行和列标记为已覆盖。
该算法的时间复杂度为 O(n^2 log n),并保证至少达到最优解的 1 − 1/e ≈ 0.632 的收益。作者利用滴滴出行成都真实数据(2016年11月1日8:00–9:00)进行验证,100位乘客和100位司机的匹配中,贪婪算法在不同定价方案下的收益与精确算法相比差异不大且运行速度明显提高。
四、论文的难点与应对策略
1. 私人信息缺乏导致的分布不确定性
在隐私法规约束下,平台无法获知具体乘客价值与司机保留收益率,只能根据统计分布做决策。作者通过假设多种分布(均匀、单峰、双峰)并推导接受概率的解析形式,从而绕开了对精确分布的依赖。
2. 派单模型的随机性和高维度
匹配成功取决于乘客和司机的独立接受行为,两阶段决策导致模型复杂。论文利用二阶段建模与概率乘积法,将随机匹配问题转化为确定性权重矩阵,简化了优化求解。
3. 计算复杂度高
传统算法在大规模平台上计算慢。作者提出的贪婪近似算法不仅具有理论近似界限,还在真实数据上验证了其性能,满足了实时派单需求。
4. 定价策略与匹配策略的耦合
不同定价函数会影响乘客/司机接受概率,进而改变最优派单顺序。通过构建幂函数定价模型并与匹配概率联动分析,论文得出在不同定价结构下的派单规律,提供了明确的决策依据。
五、主要结论与启示
1. 匹配概率与收益模式
在线性定价下,行程距离越长,乘客和司机更可能接受匹配,平台收益也越高;在次线性或超线性定价下,中等距离的订单具有更高的匹配概率和收益。
2. 定价混合策略的价值
数值实验表明,将次线性、线性与超线性定价组合用于不同距离段,可以在短途、中途和长途订单上同时获得更高收益。
3. 匹配策略改变
传统的最短距离或最近司机贪婪策略未必最优。当考虑取消行为时,平台在非线性定价下应优先匹配中等距离订单而非长距离订单。
4. 贪婪算法的实用性
论文的贪婪近似算法在实际数据上表现良好,是大规模实时派单的可行方案。
5. 单峰分布最有利
当乘客价值与司机保留收益率服从单峰分布时,平台获得的总体收益最高,这为定价设计和市场调控提供了理论依据。
六、对行业的启示
加强数据分析与定价分类:平台应根据行程距离和时间设计灵活的定价方案,线性定价适用于鼓励长途订单,次线性或超线性定价可刺激不同距离段的需求。 考虑取消行为:取消行为不仅影响用户体验,还会降低平台收益。模型证明在定价设计时纳入取消概率能够优化派单策略,从而减少损失。 应用快速近似算法:在面对海量订单时,应采用近似算法进行实时匹配,同时定期验证其性能;贪婪算法提供了理论保证和实践效果。 隐私保护与运营效率平衡:未来的智能出行平台需要在严格的数据隐私政策下运用统计方法和机制设计,减少对个人信息的依赖,同时提升运营效率。
通过上述解读,可以看出该论文从理论模型、算法设计到真实数据验证,系统地分析了隐私受限环境下的网约车派单与定价问题。其研究成果为学术界提供了分析框架,也为平台运营和政策制定者提供了有价值的参考。
https://doi.org/10.1016/j.trb.2025.103266


